
La precisión de Spatial AI mide si un sistema con contexto de ubicación interpreta la solicitud, identifica los lugares correctos, utiliza datos actuales y autorizados, calcula correctamente la geografía, clasifica únicamente opciones elegibles, explica la evidencia y ejecuta solo acciones válidas. Una respuesta fluida todavía puede enviar a alguien a la sucursal equivocada. Una sola puntuación del modelo no puede demostrar todo eso. El benchmark debe poner a prueba, antes de producción, el trabajo que el producto promete realizar.
Las secciones siguientes separan la cadena de decisión, las puertas que un promedio puede ocultar, los casos de fallo que conviene preparar de antemano y la diferencia entre un benchmark de investigación y una evaluación de producto. Como lectura relacionada, consulte Spatial AI fundamentada en datos empresariales y Un piloto empresarial de Spatial AI. Una negativa correcta puede ser más precisa que una recomendación plausible.
Aspectos esenciales de la precisión de Spatial AI
- Puntúe la cadena: intención, grounding, elegibilidad, cálculo espacial, ranking, explicación, acción y resultado.
- Compruebe los hechos fuera del modelo: identidad del lugar, horarios, inventario, permisos y rutas pertenecen a sistemas autorizados.
- Incluya los casos difíciles: solicitudes ambiguas, desactualizadas, no autorizadas e intencionadamente irresolubles.
- Mantenga las puertas separadas: una puntuación alta en una capa de bajo riesgo no debe compensar un fallo de permisos.
- Vincúlelo al trabajo: los casos offline y los resultados de producción responden preguntas distintas. Se necesitan ambos.
¿Qué significa la precisión de Spatial AI?
Un cliente puede preguntar qué tienda cerca de su ruta de regreso a casa todavía tiene un artículo y estará abierta cuando llegue. Esa frase contiene varios problemas independientes: qué quiere la persona, qué tiendas existen, si el inventario está actualizado, si los horarios encajan con la hora de llegada, qué sucursales puede alcanzar realmente la ruta, qué reglas de negocio eliminan a un candidato y cómo deben clasificarse y explicarse las opciones restantes. Una frase final bien redactada no demuestra que cada paso sea correcto. La evaluación debe separar las capas, porque un fallo de resolución de lugares no se corrige reescribiendo un prompt de ranking, y un feed de inventario obsoleto no se corrige cambiando el modelo de lenguaje.
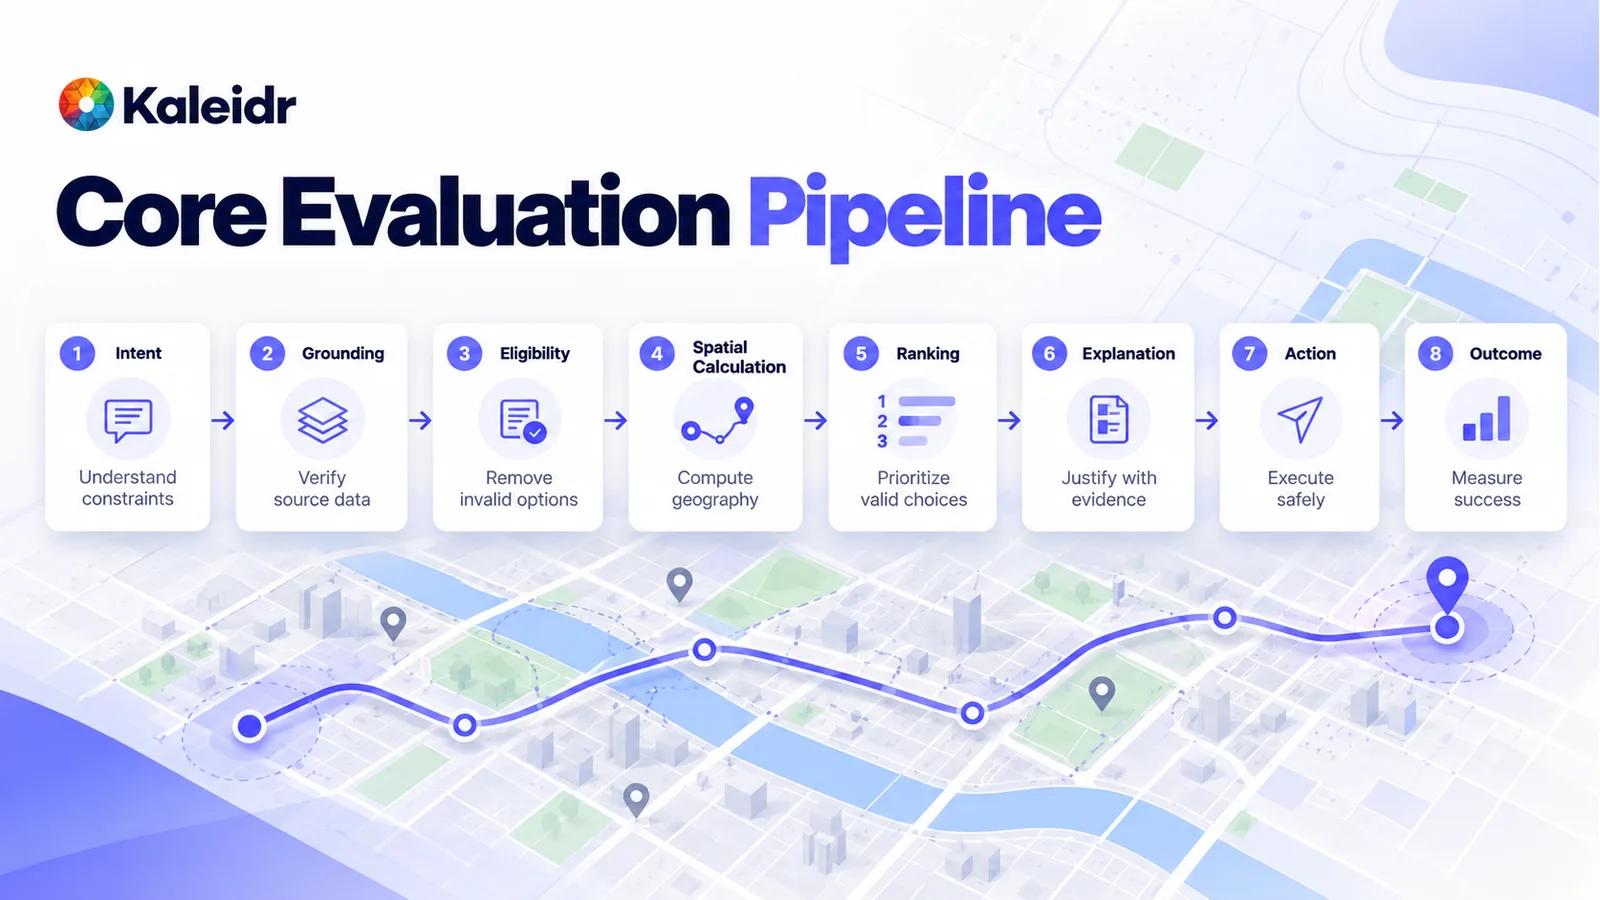
Evalúe la cadena en orden: entender las restricciones, verificar la fuente, descartar opciones no válidas, calcular la geografía, clasificar lo que queda, justificarlo con evidencia, actuar solo cuando la acción esté permitida y medir si el trabajo se completó.
¿Por qué una sola puntuación no es suficiente?
Un porcentaje general es fácil de comparar y también fácil de utilizar mal. Una scorecard ilustrativa puede mostrar un 92 % general, mientras que la intención está en 99 %, el enrutamiento en 98 %, la explicación en 96 % y la autorización en 75 %. Esas cifras son un ejemplo, no un resultado de Kaleidr. El promedio puede seguir pareciendo sólido mientras el sistema expone o actúa sobre datos a los que la persona no debería acceder. Las dimensiones críticas necesitan sus propias puertas de producción. Un rendimiento excelente en una tarea de bajo riesgo no debe compensar un fallo de permisos, un destino no válido, una acción no admitida o una disponibilidad inventada.
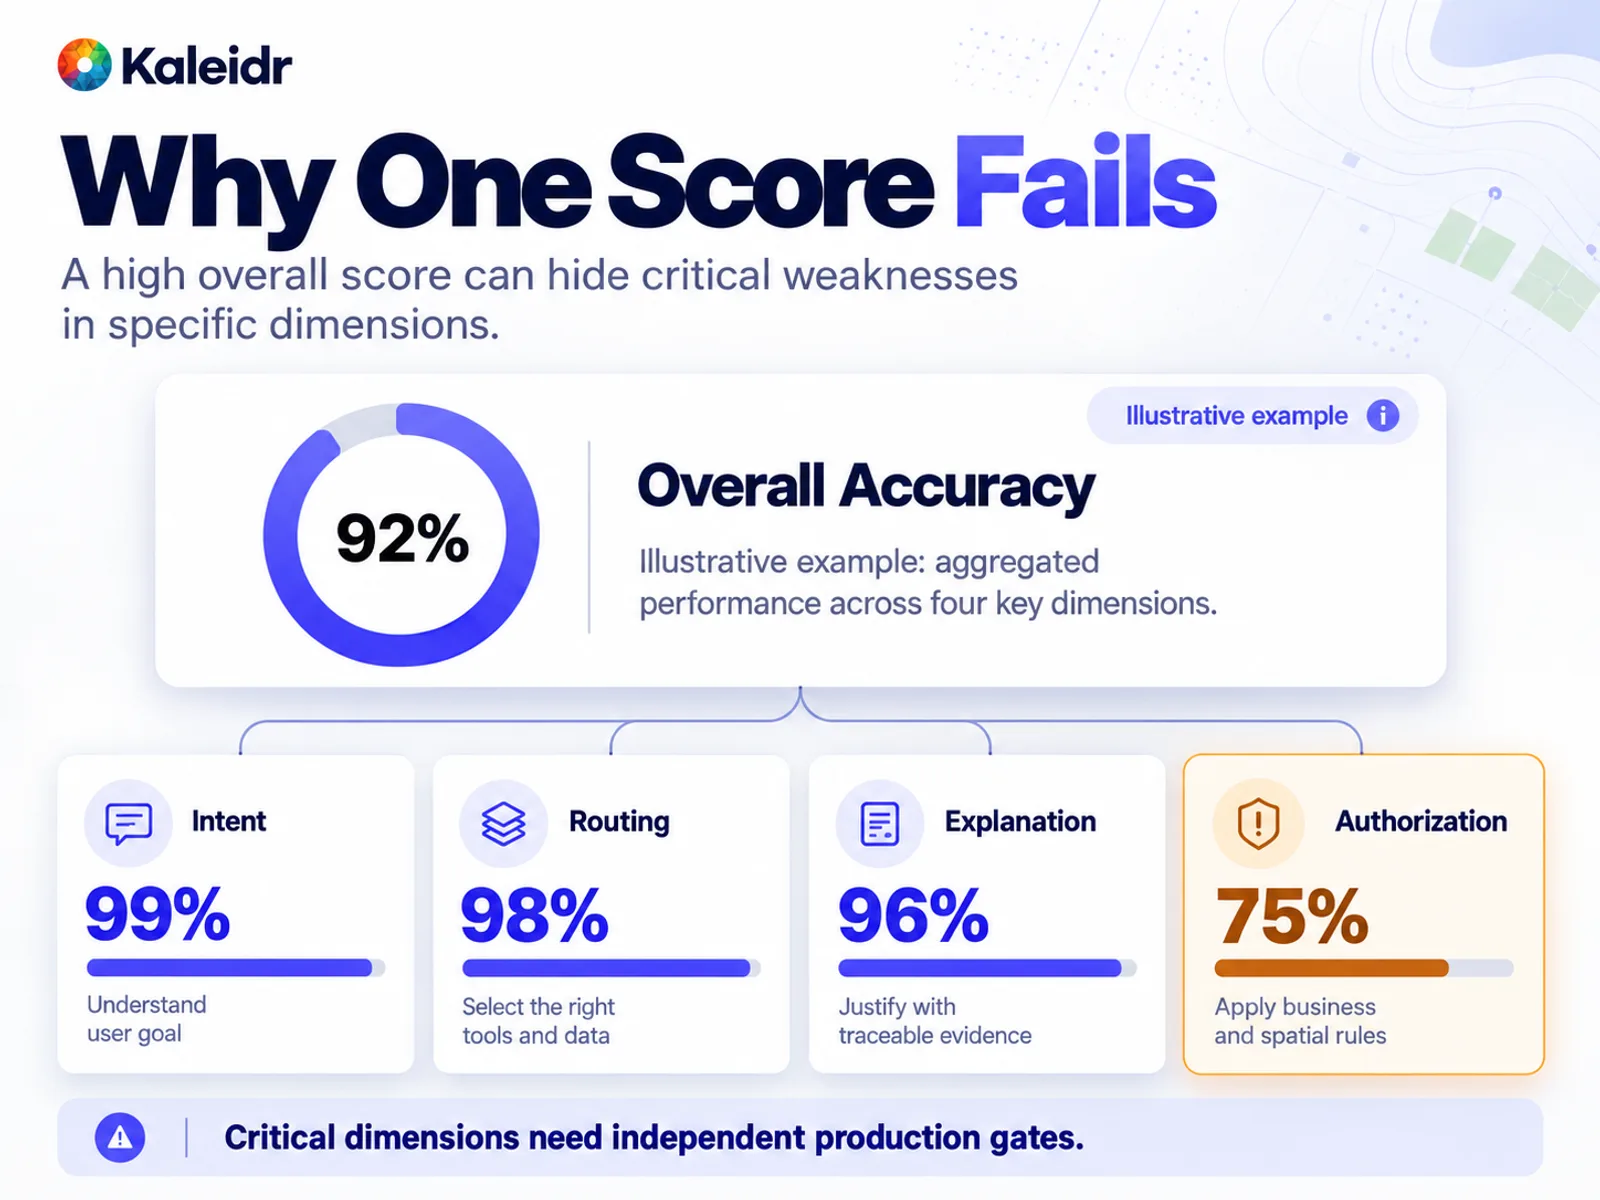
Una puntuación general alta puede ocultar una puerta débil. Los porcentajes de esta figura son un ejemplo ilustrativo, no rendimiento medido de Kaleidr.
El playbook del AI Risk Management Framework de NIST indica que la medición debe comenzar por los riesgos más significativos y que los riesgos que no se vayan a medir deben documentarse. La misma página del playbook señala que AI RMF 1.0 se está actualizando y que el playbook se revisará posteriormente (NIST, 2026). El borrador público inicial del marco TEVV-Athlon de NIST, NIST AI 200-2, anunciado el 7 de agosto de 2026 con comentarios abiertos hasta el 6 de octubre de 2026, describe la evaluación como evidencia de que un sistema cumple objetivos individuales u organizativos, utilizando mediciones adaptadas a esas necesidades, incluido el impacto en el mundo real (NIST, 2026). El documento es un borrador abierto a comentarios. No es una lista de controles de Kaleidr. Para un producto con contexto de ubicación, el contexto relevante es la decisión geográfica que el producto realmente toma.
¿Cómo deben probarse la intención, el lugar y la elegibilidad?
La intención va primero. Una solicitud de una cafetería accesible en silla de ruedas entre un hotel y un recinto, abierta antes de las 7 a. m., no significa «cafeterías cerca del hotel». Guarde para cada consulta de prueba la interpretación estructurada esperada: categoría, relación geográfica, origen, destino, accesibilidad y hora. Después mida la extracción de restricciones, las restricciones inventadas por el sistema y las restricciones que omitió. Un sistema que acierta la categoría pero ignora la ventana temporal no ha interpretado la tarea.
El lenguaje de lugares es ambiguo. Springfield, Terminal 2, Main Street y «nuestra tienda de Austin» pueden nombrar más de una entidad. Incluya ciudades duplicadas, nombres de sucursal idénticos, múltiples terminales, lugares renombrados, abreviaturas, nombres multilingües, barrios sin un límite rígido y direcciones sobre una frontera administrativa. Puntúe identificadores canónicos de lugar, no coincidencias de texto en el nombre. La cafetería equivocada a una manzana y un destino en la ciudad incorrecta son ambos errores, pero no tienen la misma gravedad.
La elegibilidad pregunta si un lugar puede siquiera considerarse. El ranking pregunta qué posición debe ocupar un lugar válido. Una sucursal puede ser el pin más cercano y seguir estando cerrada, sin stock, fuera del área de servicio, completamente reservada o prohibida por política. Esos candidatos deben salir del conjunto antes de clasificar lo que queda. La precisión de elegibilidad es el número de lugares elegibles devueltos dividido por todos los lugares devueltos. En un flujo de trabajo de alto riesgo, unas pocas recomendaciones no elegibles pueden importar más que la calidad media del ranking. Inventario, horarios, permisos y políticas permanecen en los sistemas que los controlan. Spatial AI fundamentada en datos empresariales establece la misma separación para el propio producto.
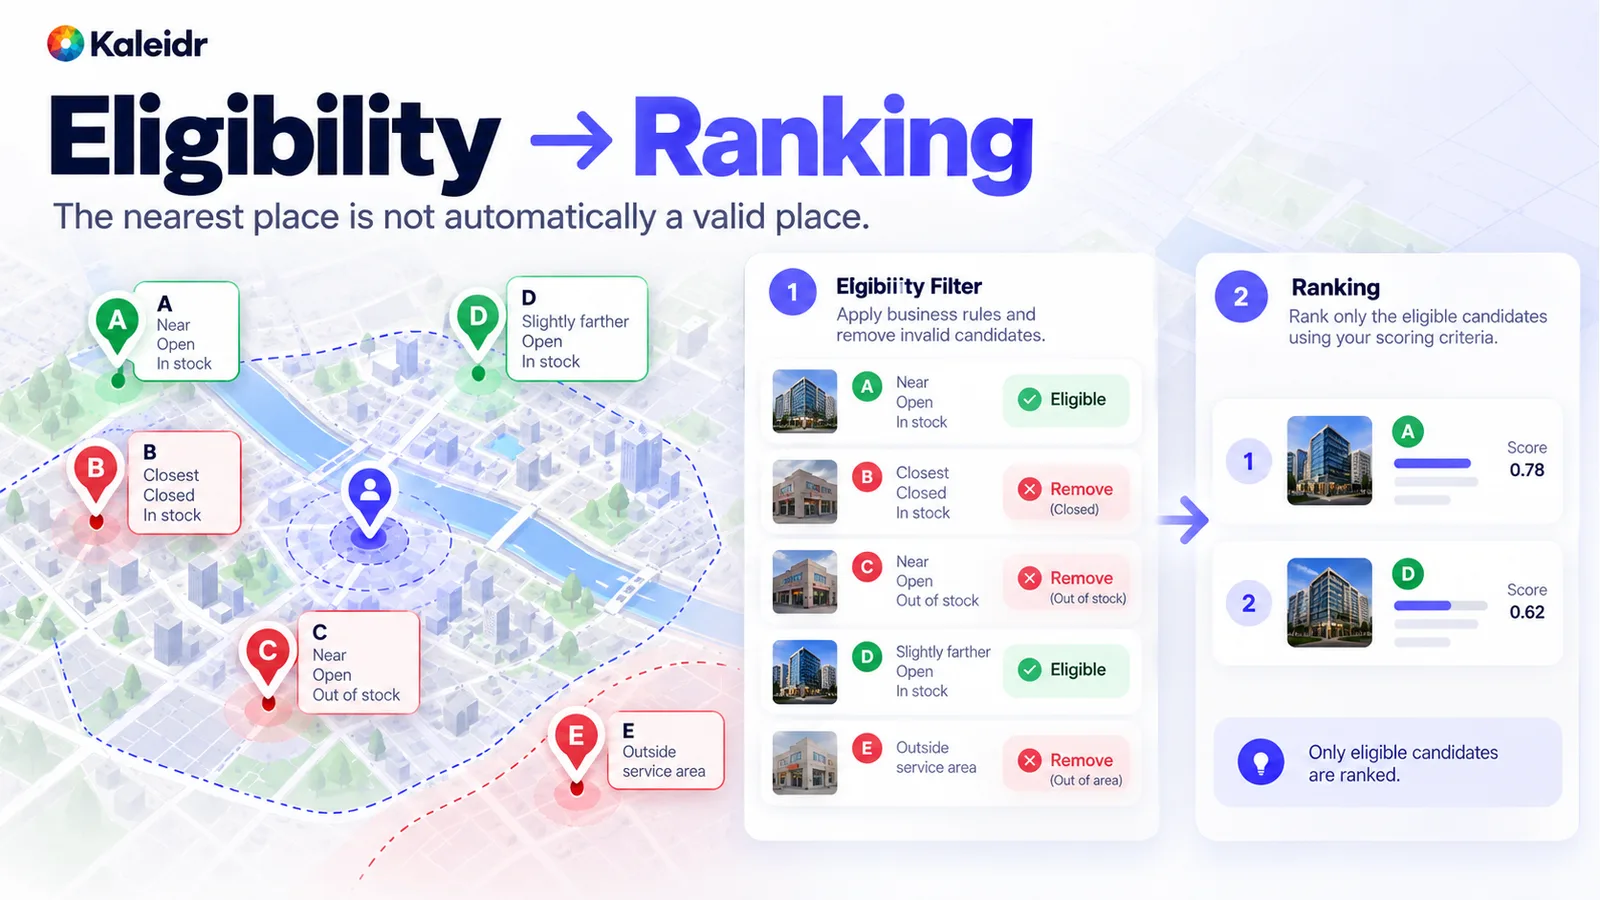
Filtre primero por elegibilidad. El lugar más cercano no es automáticamente un lugar válido.
¿Cómo deben comprobarse la geografía y la actualidad?
Un modelo de lenguaje no debería ser la fuente de verdad para un cálculo que puede realizar un motor espacial. Punto dentro de polígono, distancia de ruta, tiempo de viaje, pertenencia a un área de servicio, contención y orden a lo largo de una ruta pertenecen a esa categoría. Construya la respuesta esperada a partir de datos geográficos autoritativos y una herramienta de confianza, y luego compare el resultado de la aplicación con esa respuesta. La coincidencia exacta sirve para «¿está este punto dentro de este polígono?» y «¿devolvió el sistema la sucursal con ID 172?». Una tolerancia predefinida sirve para coordenadas, tiempo de viaje estimado y límites dibujados a resoluciones distintas. No decida después de ejecutar la prueba que un resultado incorrecto estaba lo bastante cerca.
La actualidad es una cuestión distinta de la corrección histórica. Las coordenadas y la identidad de una sucursal pueden ser estables mientras cambian los horarios, el inventario, el tráfico y los cierres. Mida la proporción de decisiones tomadas con datos fuera del umbral de actualidad y la proporción de campos sensibles al tiempo que incluyen una hora de actualización conocida. La ausencia de datos no es el mismo hecho que «no disponible». Un sí o un no expresado con seguridad sobre un estado desconocido es un fallo, incluso cuando el lugar en sí existe.
¿Cuándo es «sin resultado» la respuesta correcta?
Un cliente puede pedir una ubicación a menos de diez minutos que tenga un artículo después de las 9 p. m. cuando no existe ninguna. Un sistema débil relaja la restricción en silencio y devuelve una sucursal a veinte minutos. Un sistema fundamentado indica que ninguna opción verificada cumple todas las condiciones. Los benchmarks deben incluir tareas deliberadamente irresolubles y después medir tanto la tasa correcta de «sin resultado» como la tasa de recomendaciones falsas. GeoBenchX, un benchmark de 2025 de agentes que llaman herramientas en tareas geoespaciales de varios pasos, incluye tareas resolubles e intencionadamente irresolubles para medir la precisión de rechazo (Krechetova and Kochedykov, 2025). Ese trabajo evalúa agentes de investigación. GeoBenchX no puntúa Kaleidr, y un equipo de producto debe seguir creando casos irresolubles para su propio trabajo.
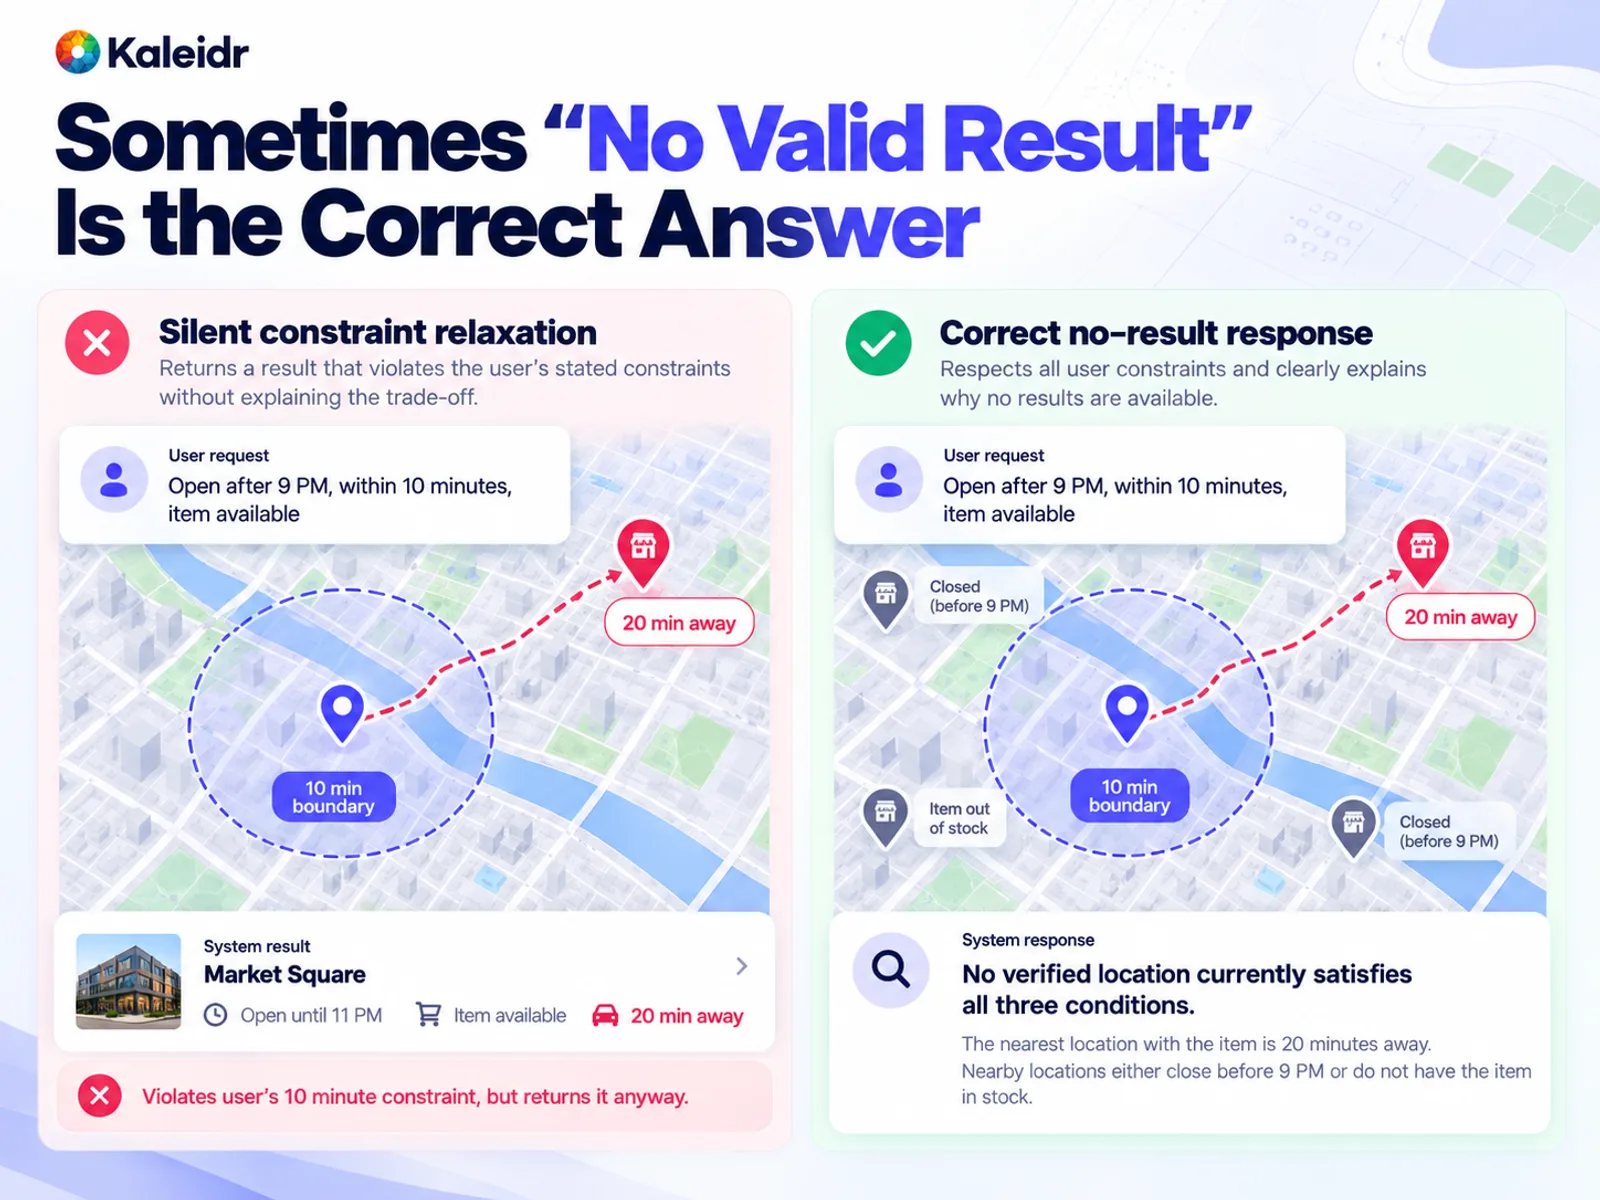
A veces no existe un resultado válido, y esa es la respuesta correcta. Devolver un lugar fuera del tiempo o la distancia indicados es una recomendación falsa, no una alternativa útil.
¿Cómo deben puntuarse el ranking, la explicación y las acciones?
Clasifique solo después de eliminar los candidatos no válidos. Lo más cercano no es automáticamente lo mejor. El tiempo de viaje, el desvío de ruta, la disponibilidad, la accesibilidad, el precio, la ventana de apertura y la prioridad de negocio pueden formar parte del objetivo si el producto así lo define. Entre las medidas útiles se encuentran la frecuencia con la que el primer resultado es aceptable, la frecuencia con la que aparece una opción aceptable entre los primeros K resultados, el acuerdo con un orden revisado por humanos o definido por política y el arrepentimiento respecto de la mejor opción elegible conocida. No trate el engagement como calidad del ranking. Vincule el orden con la acción que el cliente necesitaba realizar.
Una explicación como «abierto hasta las 10 p. m., artículo disponible, seis minutos adicionales en la ruta» solo es precisa si cada afirmación puede rastrearse hasta evidencia que el sistema realmente utilizó. Compruebe la identidad del lugar, la afirmación de disponibilidad, el horario, si realmente se calculó una ruta y si el texto coincide con la decisión de ranking. Un párrafo pulido puede seguir siendo incorrecto. Uno breve y torpe puede ser correcto. Mida las afirmaciones verificadas sobre el total de afirmaciones factuales de la explicación.
Las acciones forman parte de la respuesta. Mover el mapa, añadir un marcador, solicitar una ruta, cambiar un filtro o iniciar una reserva puede estar mal aunque la frase sea correcta. Mida si la acción pertenece al vocabulario de la aplicación, si el objetivo y los parámetros son correctos y si la persona tenía permiso para ejecutarla. Una frase correcta acompañada de la acción de mapa equivocada sigue siendo una interacción fallida.
¿Qué casos de fallo deben formar parte del benchmark?
Un conjunto compuesto únicamente por ejemplos limpios que el equipo ya sabe resolver sobreestimará la fiabilidad. Incluya nombres ambiguos, sucursales duplicadas, direcciones en el borde de un área de servicio, solicitudes irresolubles, una tienda que acaba de cerrar, inventario que no coincide con el lugar, un pin cercano que dispara el desvío de la ruta, una hora de cierre anterior a la llegada, una instalación privada que el usuario no puede ver, un nombre local distinto del nombre en inglés, horarios desconocidos, una fuente pública que contradiga datos de primera parte, texto recuperado que intente dirigir al modelo y un servicio de routing o datos empresariales caído. El objetivo es reproducir las decisiones que producción realmente tendrá que afrontar.
El texto recuperado que intenta dirigir al modelo es un caso de prompt injection. OWASP describe LLM01:2025 Prompt Injection como entrada del usuario o recuperada que cambia el comportamiento del modelo de formas no deseadas, incluida la influencia sobre una decisión crítica, y señala que la generación aumentada por recuperación no elimina por completo la debilidad (OWASP, 2025). Coloque ese caso en la familia de seguridad del conjunto de pruebas, junto a permisos, en lugar de tratar la seguridad como un apéndice posterior.
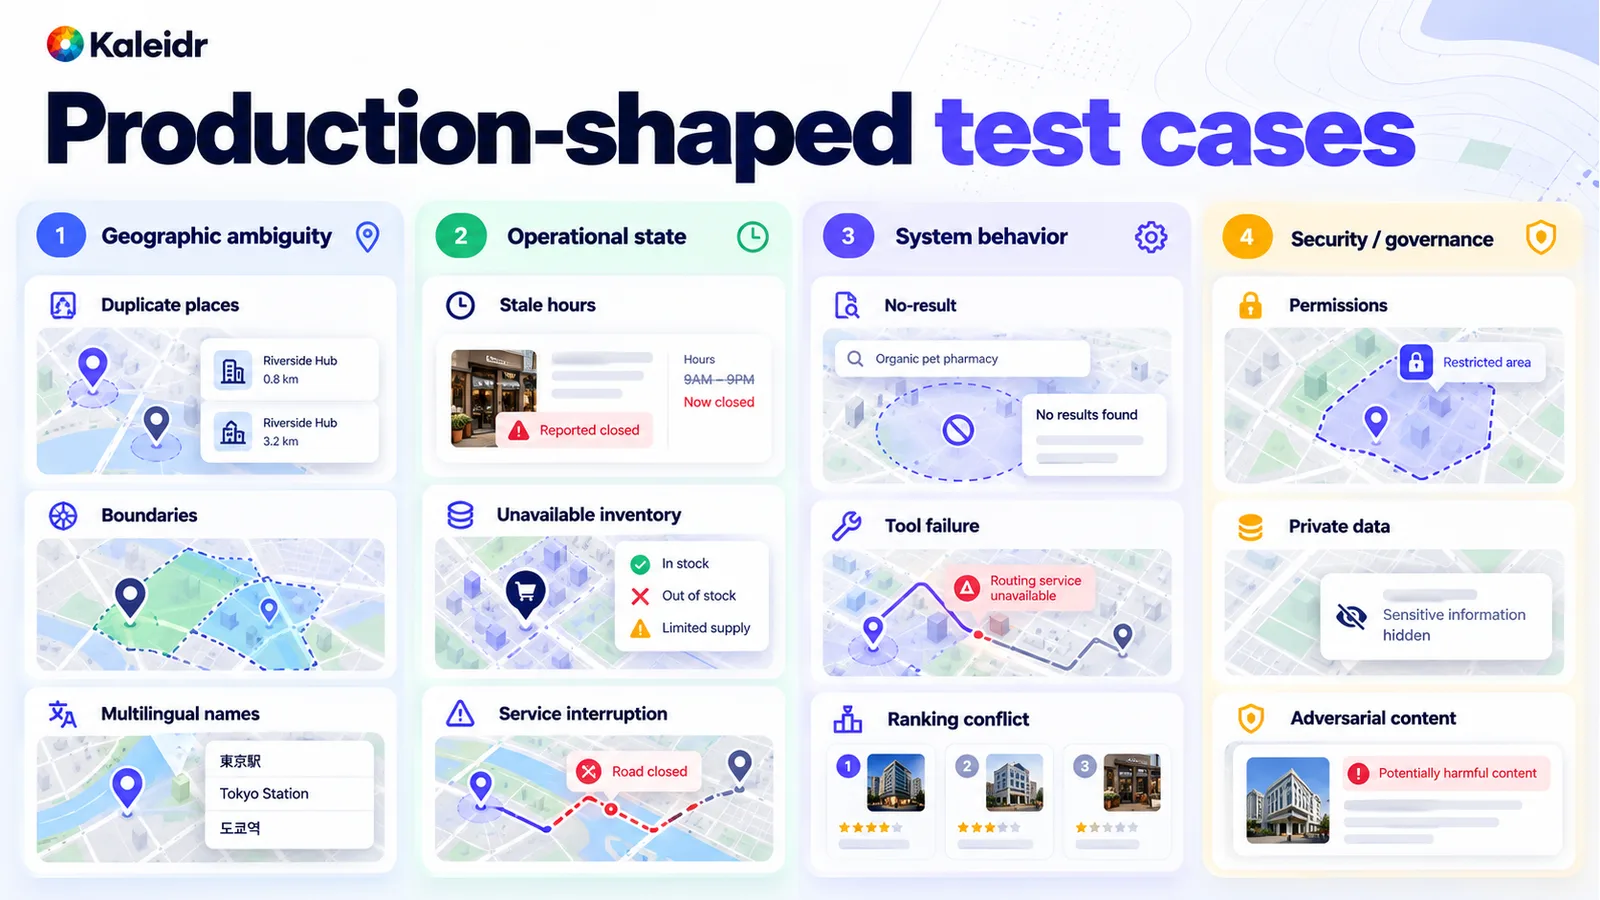
Los casos con forma de producción cubren ambigüedad geográfica, estado operativo, comportamiento del sistema y seguridad. Un benchmark que los omita sobreestimará la fiabilidad.
¿Por qué debe existir la verdad de referencia antes de ejecutar la prueba?
Cada caso necesita suficiente verdad registrada para definir qué significa «correcto»: la consulta, el contexto del usuario, las fuentes autorizadas, la intención esperada, las restricciones obligatorias, los lugares canónicos, el conjunto elegible, la relación espacial esperada, el mejor resultado, las alternativas aceptables, la acción esperada, el motivo por el que «sin resultado» es correcto, la tolerancia y la gravedad si el sistema se equivoca. Escriba ese registro antes de ejecutar el sistema. Adaptar la clave de respuesta a lo que produjo el modelo no es una evaluación.
GISAgentBench, un benchmark de 2026 procedente de profesionales con 349 tareas GIS de varios pasos, sostiene que muchos benchmarks de agentes GIS carecen de salidas de verdad de referencia y utilizan en su lugar señales sustitutas como similitud de código, coincidencia de trayectoria o un modelo juez, que pueden considerar correcto un flujo de trabajo parecido aunque el resultado no lo sea. Cada tarea de GISAgentBench incluye un archivo exacto de salida de verdad de referencia (Pothuri et al., 2026). Utilice código o un registro autoritativo siempre que la pregunta sea determinista: coordenadas, contención, ID canónico, abierto o cerrado, permiso y qué acción API se ejecutó. Reserve la revisión humana, o una revisión asistida por modelo y calibrada, para preguntas realmente subjetivas, como si una explicación es comprensible. El evaluador debe corresponder al tipo de verdad que se está comprobando.
¿Cómo deben interpretar los equipos un resultado segmentado?
Un promedio puede ocultar una geografía débil. Desglose los resultados por país, mercado, idioma, cobertura urbana y rural, proveedor de datos, categoría de lugar, densidad de sucursales, complejidad de la consulta y tipo de ruta. Suponga que la tasa global de resultados válidos es del 95 % y un mercado recién lanzado se encuentra en 78 %. Esa pareja de cifras es una ilustración hipotética, no una medición de Kaleidr. El promedio puede ser aritméticamente correcto y aun así ser la cifra equivocada sobre la que escalar. Examine dónde ocurren los errores y asigne cada caso fallido a una categoría: interpretación, resolución de entidad, grounding, elegibilidad, cálculo espacial, actualidad, ranking, explicación, acción, seguridad o recuperación. La categoría indica al equipo qué debe cambiar. Un fallo de routing no es un problema de explicación.
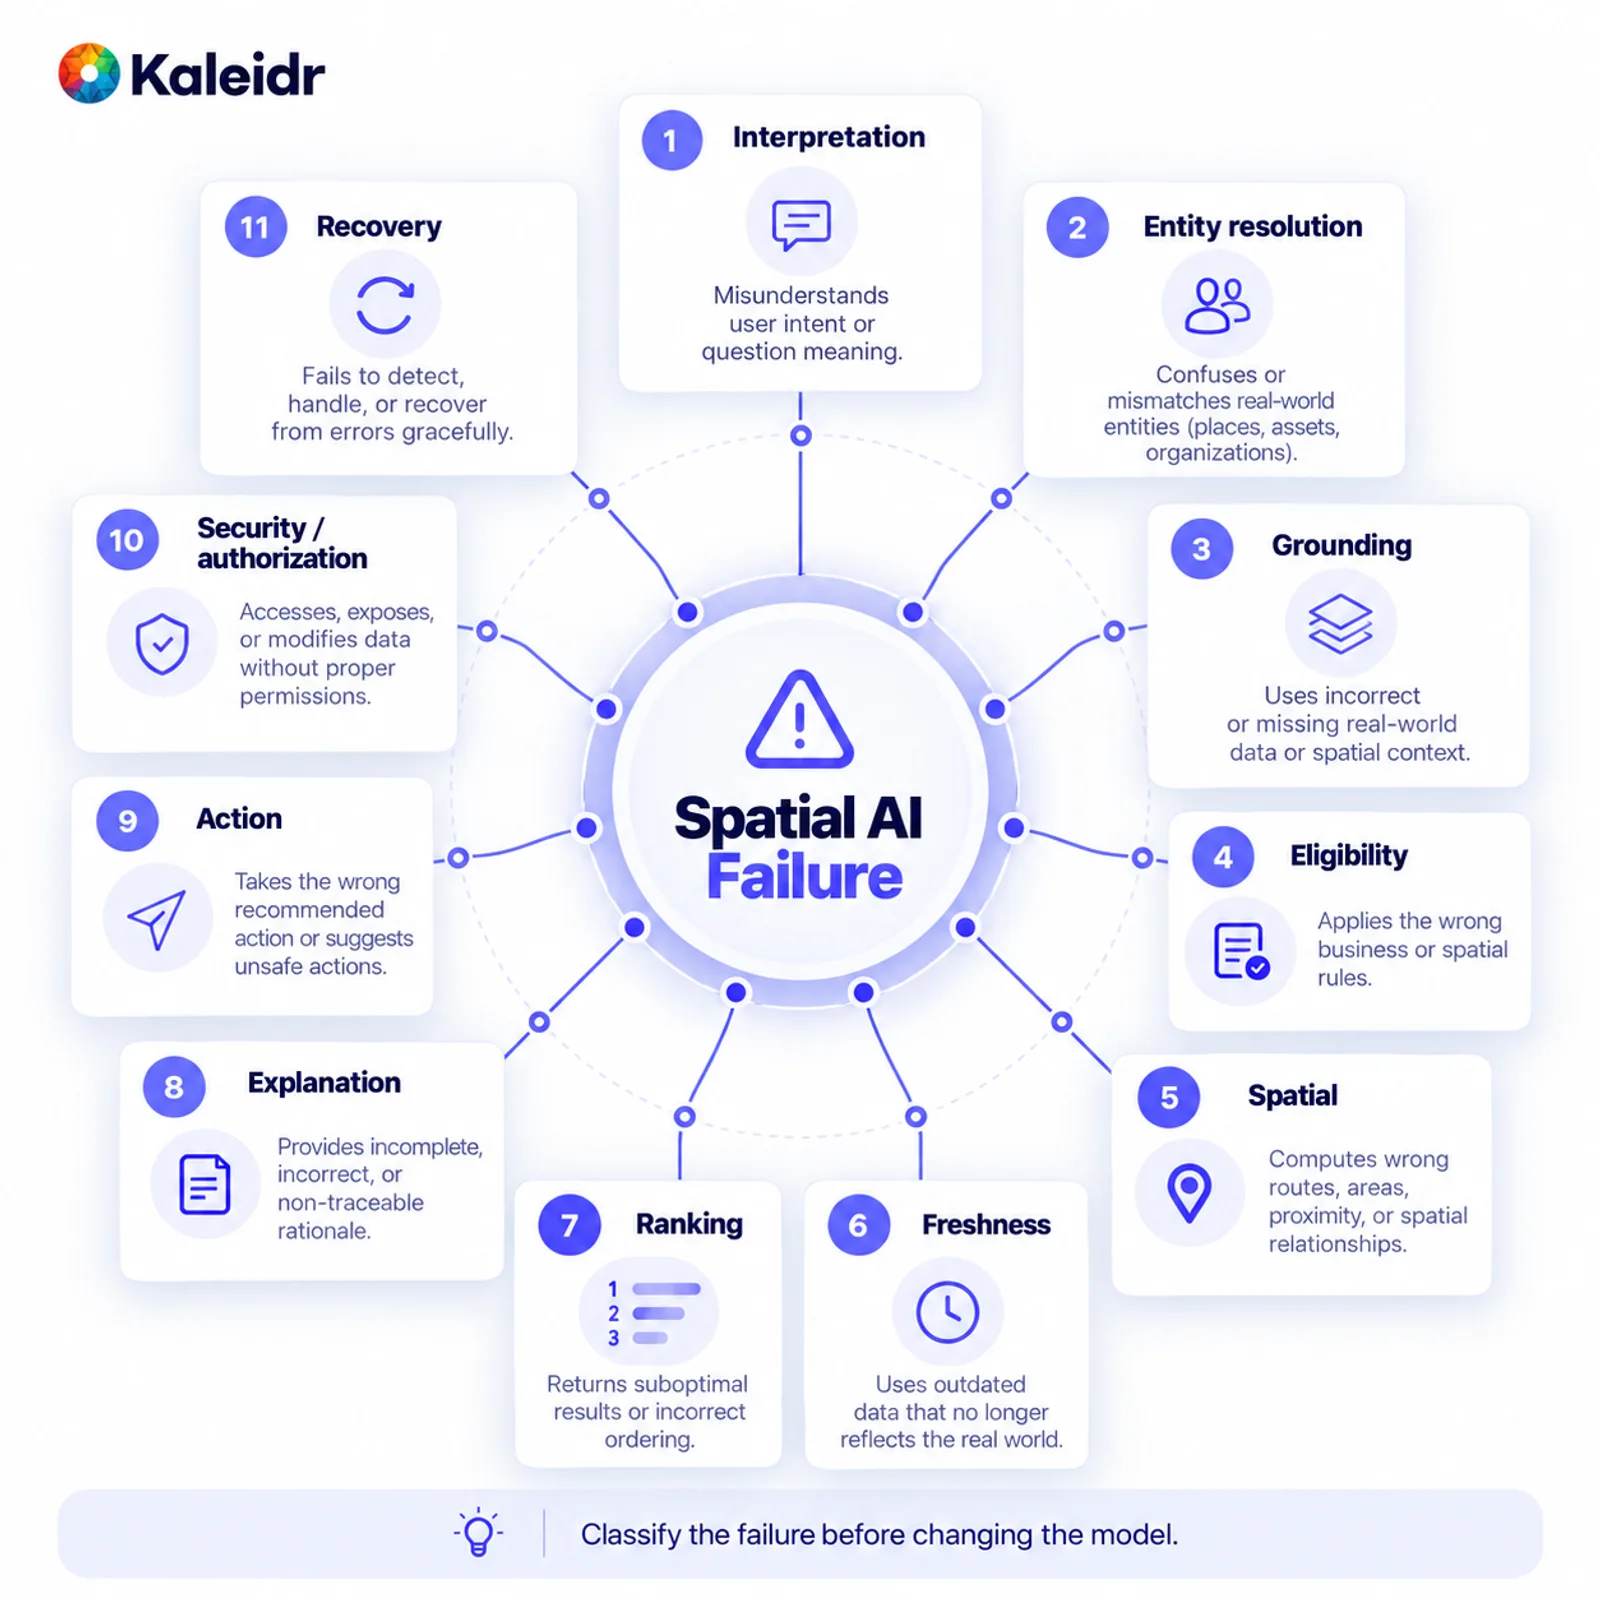
Clasifique el fallo antes de cambiar el modelo. Categorías separadas evitan que un fallo raro y grave desaparezca dentro de un promedio grande.
Las ejecuciones generativas también varían. Para casos importantes, registre el promedio, la peor ejecución observada y con qué frecuencia se repite el fallo. Una consulta que es segura nueve veces y falla una tiene un riesgo distinto de una consulta que devuelve siempre la misma respuesta segura. Repita el conjunto cuando cambien prompts, modelos, recuperación, ranking, proveedores de datos, herramientas o cobertura. La evaluación pertenece a la gestión de releases, no a un único informe previo al lanzamiento.
¿Qué debe incluir una scorecard de producción?
Asigne a cada dimensión su propia métrica y su propia puerta. La intención puede usar extracción de restricciones. La identidad del lugar puede usar precisión de lugar canónico. Autorización y seguridad pueden usar una tasa de acceso no autorizado que no tolere exposición de datos protegidos. Elegibilidad, cálculo espacial, actualidad, ranking, gestión de «sin resultado», explicación, acciones y resultado necesitan cada uno un umbral que el responsable del producto establezca antes de ejecutar la prueba. No copie un umbral universal de otra aplicación. Una sugerencia casual de restaurante y una decisión de routing con consecuencias de seguridad no comparten el mismo presupuesto de error.
| Dimensión | Métrica de ejemplo | Puerta de ejemplo |
|---|---|---|
| Intención | Precisión de extracción de restricciones | Definir para este producto |
| Identidad del lugar | Precisión del lugar canónico | Muy alta |
| Autorización | Tasa de acceso no autorizado | Ninguno tolerado para datos protegidos |
| Elegibilidad | Precisión de resultados elegibles | Muy alta |
| Cálculo espacial | Correcto dentro de una tolerancia predefinida | Definir para este producto |
| Actualidad | Proporción de resultados dentro de la ventana de actualidad | Definir para este producto |
| Ranking | Aceptación Top-1 o Top-K | Definir para este producto |
| Gestión de «sin resultado» | Tasa de rechazo correcto | Alta |
| Explicación | Tasa de afirmaciones respaldadas | Alta |
| Acciones | Tasa de acciones válidas y correctamente parametrizadas | Muy alta |
| Resultado | Finalización de la tarea dependiente de ubicación | Debe mejorar el trabajo previsto |
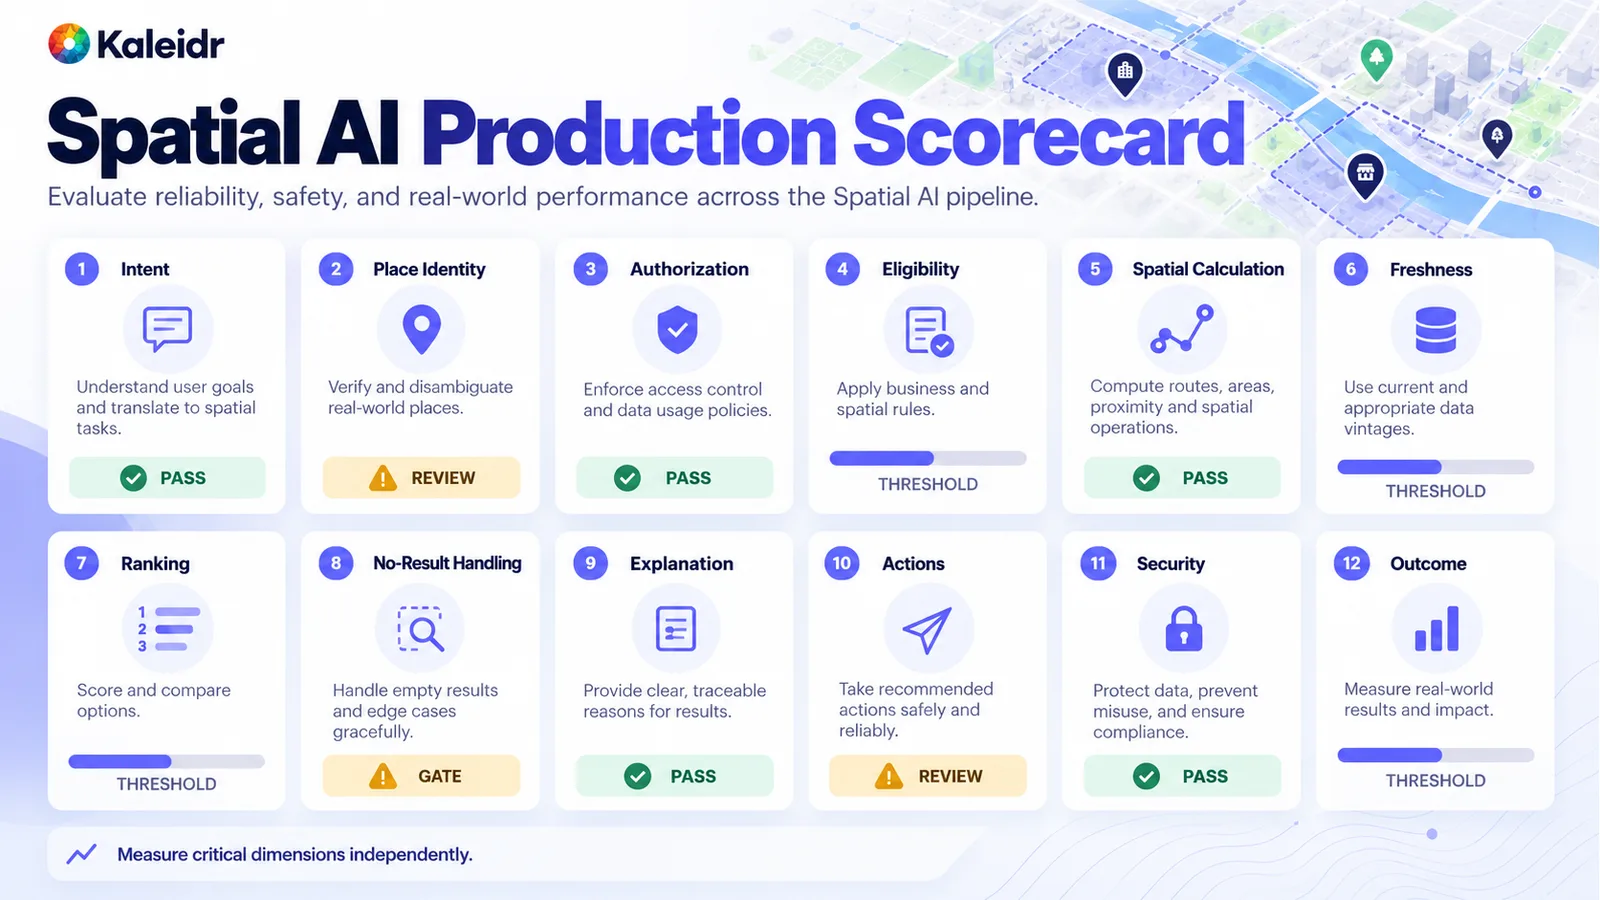
Mida las dimensiones críticas de forma independiente. Las etiquetas de estado de esta scorecard son marcadores de posición, no puntuaciones de benchmark de Kaleidr.
¿Cómo debe decidir un equipo si escala?
Utilice las puertas, no una puntuación combinada. Escale cuando los resultados válidos, fundamentados y espacialmente correctos se mantengan en condiciones similares a producción, las clases de error críticas estén controladas, alguien sea responsable de los datos operativos y mejore el resultado previsto. Itere cuando el trabajo sea valioso y una capa corregible siga siendo débil. Reduzca el alcance cuando el piloto mezcle demasiadas geografías, fuentes o trabajos para saber qué falló. Deténgase cuando el equipo no pueda nombrar datos autoritativos, no pueda controlar un fallo crítico, no pueda definir la tarea o no pueda demostrar una mejora frente al flujo de trabajo actual. Un piloto empresarial de Spatial AI es la prueba acotada. La scorecard convierte esa prueba en una decisión.
¿Dónde encaja Kaleidr en la evaluación?
Kaleidr Enterprise describe infraestructura de location intelligence con APIs de inferencia, sistemas de ranking, analytics y soporte de despliegue, incluidos chat, edición, tiles y viewers integrables que un host puede añadir junto a un mapa que ya opera (Kaleidr, 2026). La aplicación host conserva los sistemas empresariales que controla: inventario, permisos, estado del cliente, reservas y otros registros operativos privados. Las herramientas espaciales se encargan de los cálculos que pueden computarse. La capa del modelo de lenguaje interpreta la intención, coordina capacidades admitidas y explica resultados fundamentados. La página pública de Analytics de Kaleidr, titulada Map Engagement and Location Analytics, describe alcance, vistas, engagement, ubicación y actividad de la audiencia, sesiones e interacciones por mapa, comparación de lugares y patrones espaciales (Kaleidr, 2026). Esos informes describen comportamiento sobre mapas y lugares. Las reservas completadas, pedidos y leads cualificados permanecen en los sistemas host que registran esos resultados.
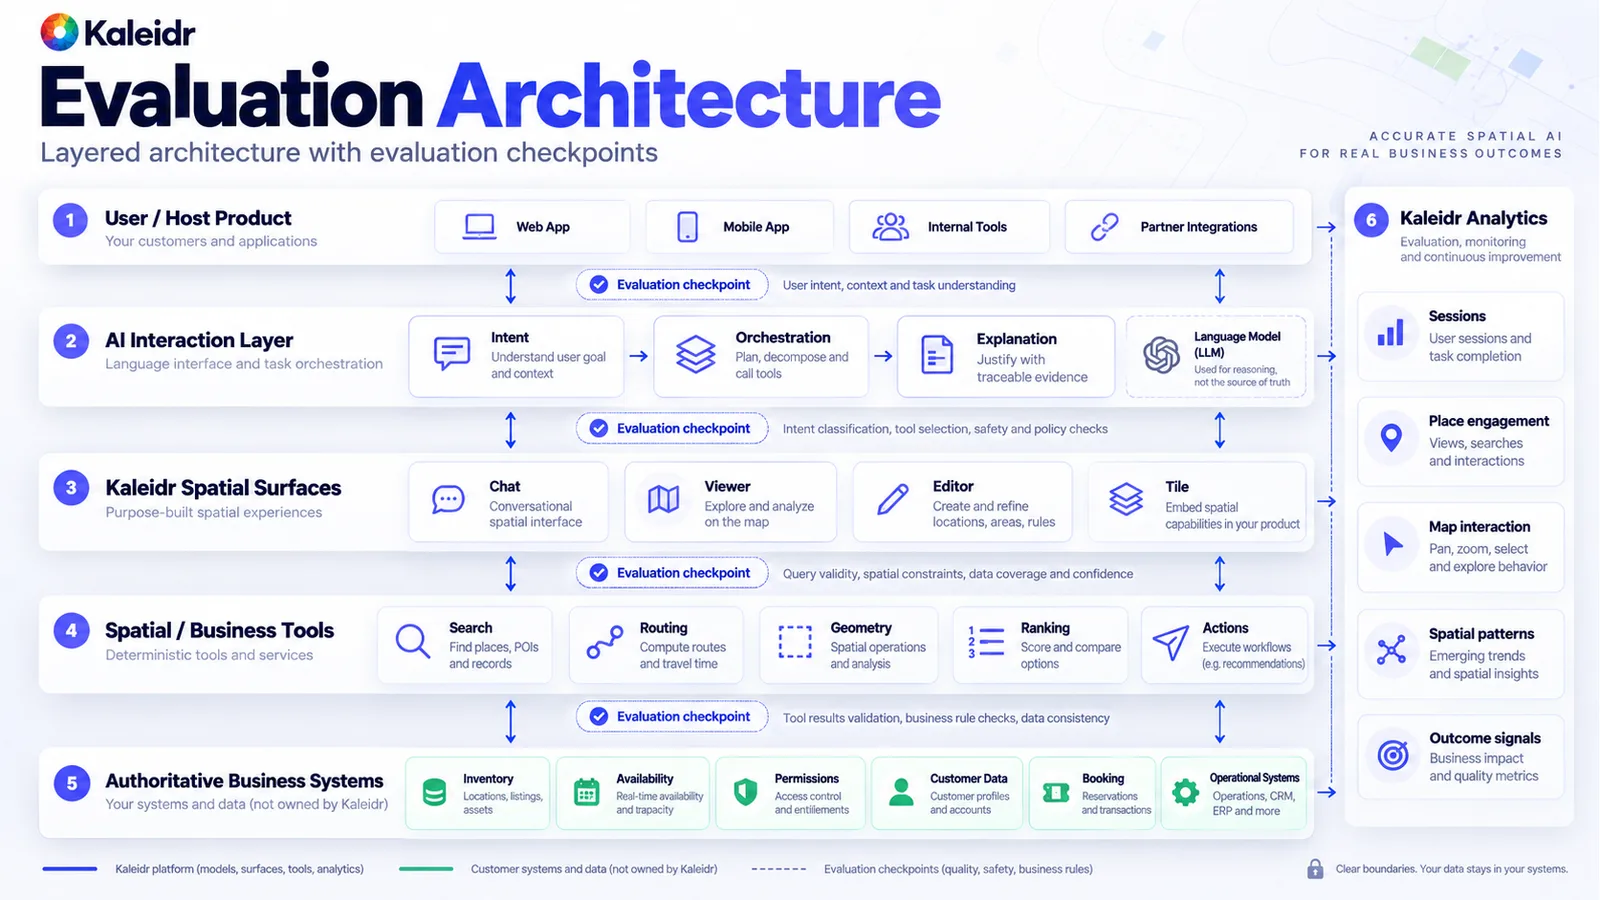
El modelo de lenguaje no es la fuente de verdad para inventario, permisos ni rutas. Los puntos de control entre capas muestran qué parte falló.
¿Qué errores ocultan un benchmark débil?
Las preguntas de camino feliz, sin ambigüedad, datos faltantes ni una solicitud irresoluble, sobreestiman la fiabilidad. Puntuar únicamente lo parecida que es la redacción a una referencia pasa por alto una decisión correcta expresada de forma distinta y recompensa un lugar equivocado escrito con el estilo de la referencia. Clasificar un conjunto que todavía contiene lugares no elegibles oculta el fallo de elegibilidad. Pedir al modelo que compruebe una distancia que el motor espacial puede calcular sustituye un cálculo por fluidez. Ignorar la actualidad trata el horario de ayer como si fuera el de hoy. Considerar más interacción con el mapa como precisión confunde interés con éxito y, a veces, con confusión. Cambiar una tolerancia después de ver los números no es un benchmark. Probar únicamente el modelo ignora recuperación, datos, herramientas, permisos, ranking e interfaz. El comportamiento de producción pertenece al producto ensamblado.
Los benchmarks de investigación siguen siendo útiles como sondas de capacidad. GeoBenchLLM, presentado en agosto de 2026 y aceptado en CIKM 2026, evalúa modelos de lenguaje en tareas relacionadas con geografía derivadas de datasets públicos, incluida comprensión geoespacial y temporal (Rodrigues et al., 2026). Los benchmarks de GeoAI suelen cubrir teledetección, flujos GIS, imágenes o tareas de modelos geoespaciales. Un benchmark de producto también puede necesitar grounding en datos empresariales, permisos, disponibilidad en vivo, ranking, acciones de mapa y el resultado del cliente. Ningún benchmark público puede sustituir el trabajo específico de todos los productos.
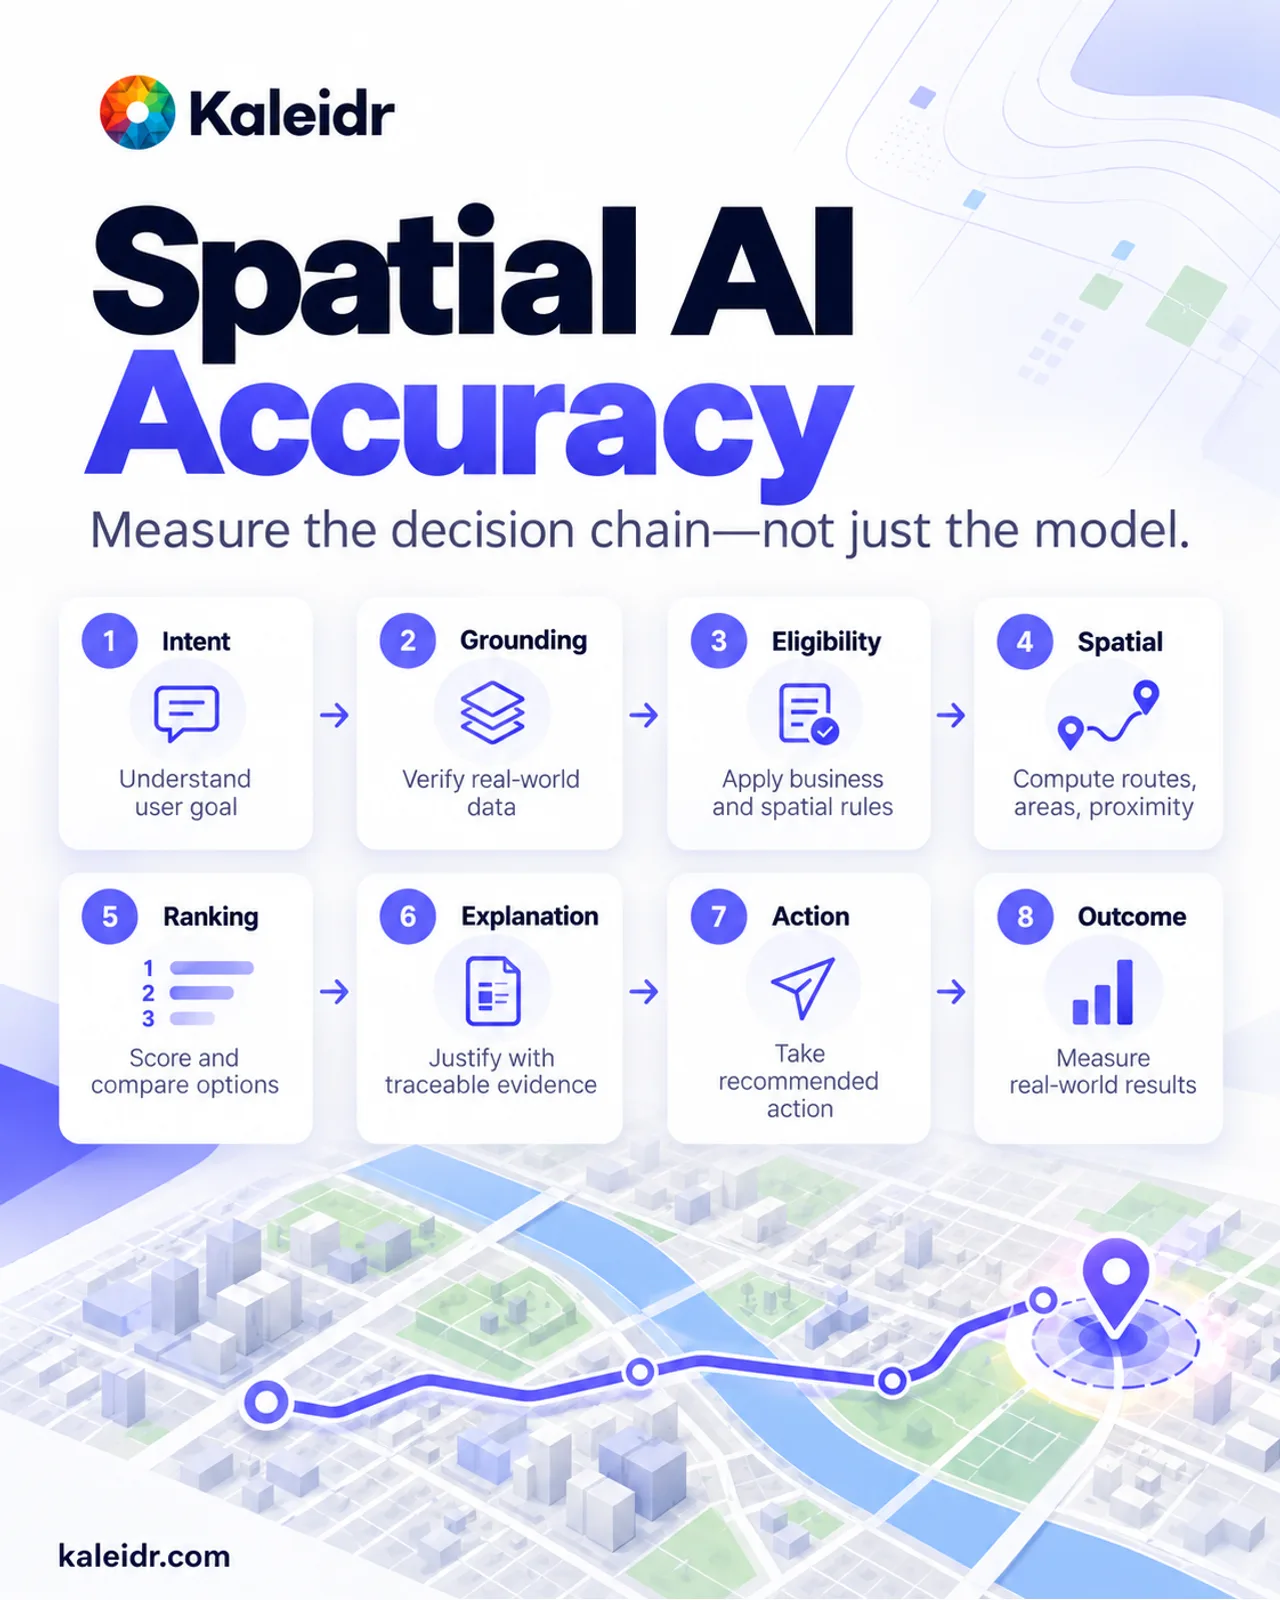
Mida la cadena de decisión, no solo el modelo. Las ocho etapas son el esquema de evaluación, no una puntuación reportada.
¿Cómo se convierte la evaluación en una puerta de release?
Construya el conjunto de pruebas antes de escalar. Incluya los casos de fallo. Mantenga la verdad determinista fuera del modelo de lenguaje cuando una herramienta o un registro puedan responder. Controle las dimensiones críticas con sus propias puertas. Repita la ejecución cuando cambie el sistema y conecte el resultado offline con el resultado de producción que el trabajo debía mejorar. La pregunta útil es si este sistema puede tomar la decisión dependiente de ubicación que promete el producto, con los datos, la geografía, los permisos y las acciones correctos, y si el equipo puede demostrarlo.
Explore Kaleidr Enterprise para añadir AI con contexto de ubicación junto a los sistemas que ya utiliza un producto y definir un piloto enfocado. Explore Kaleidr Analytics para ver cómo las audiencias usan los mapas y lugares de ese piloto. El host sigue siendo responsable del resultado empresarial y de la decisión de escalar.
Preguntas frecuentes
¿Cómo se mide la precisión de Spatial AI?
Mida las etapas de la decisión de ubicación: intención, resolución de lugares, autorización, elegibilidad, cálculos geográficos, actualidad, ranking, explicación, acción y resultado del usuario o del negocio. No reduzca esa cadena a una única puntuación del modelo.
¿Es lo mismo que la precisión del modelo de lenguaje?
No. Un modelo de lenguaje es solo un componente. Bases de datos de lugares, registros empresariales, motores espaciales, routing, ranking, permisos y estado de la aplicación pueden cambiar si el resultado es correcto o no.
¿Debe un modelo de lenguaje calcular distancias?
Utilice una herramienta geográfica o de routing cuando el producto necesite una distancia o una relación de viaje. El modelo puede decidir cuándo se necesita el cálculo y explicar el resultado. El servicio espacial realiza el cálculo.
¿Deben los benchmarks incluir preguntas imposibles?
Sí. Las tareas intencionadamente irresolubles muestran si el sistema devuelve una respuesta fundamentada de «sin resultado» en lugar de inventar un lugar o eliminar silenciosamente una restricción.
¿Con qué frecuencia debe ejecutarse la evaluación?
Ejecútela antes de producción y de nuevo cuando cambien modelos, prompts, proveedores de datos, ranking, herramientas espaciales, permisos o cobertura. Observe continuamente el comportamiento en producción. Un informe del día del lanzamiento no es un proceso de release.
¿Puede un benchmark comparar todos los sistemas?
Los benchmarks de investigación pueden comparar una capacidad declarada. La evaluación de producción debe reflejar el trabajo geográfico, los datos, los riesgos, las herramientas y el resultado de esa aplicación. Los benchmarks de GeoAI y los benchmarks de producto no son intercambiables.
Referencias
- National Institute of Standards and Technology. AI RMF Playbook, Measure. Notes that the AI RMF 1.0 is being updated and that the playbook will be revised afterward. Accessed September 29, 2026. https://airc.nist.gov/airmf-resources/playbook/measure/
- National Institute of Standards and Technology. The TEVV-Athlon Framework for Evaluating AI Systems. NIST AI 200-2, initial public draft. Announced August 7, 2026; comments through October 6, 2026. https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems
- Krechetova, Varvara, and Denis Kochedykov. GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks. arXiv:2503.18129, submitted March 23, 2025, revised October 22, 2025. https://arxiv.org/abs/2503.18129
- Pothuri, Abhinav, Zhe Jiang, Zelin Xu, and Di Yang. GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks. arXiv:2608.01645, submitted August 3, 2026. https://arxiv.org/abs/2608.01645
- Rodrigues, Rodrigo Ferreira, Karim Radouane, Jose G. Moreno, and Lynda Tamine. GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks. arXiv:2608.07411, submitted August 7, 2026. Accepted at CIKM 2026. https://arxiv.org/abs/2608.07411
- OWASP Gen AI Security Project. LLM01:2025 Prompt Injection. Accessed September 29, 2026. https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed September 29, 2026. https://kaleidr.com/enterprise
- Kaleidr. Map Engagement and Location Analytics. Accessed September 29, 2026. https://kaleidr.com/analytics
- Kaleidr. Grounded Spatial AI for Business Data. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- Kaleidr. An Enterprise Spatial AI Pilot Before Scaling. https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling
@misc{nist_rmf_playbook_measure_2026,
  title  = {AI RMF Playbook, Measure},
  author = {{National Institute of Standards and Technology}},
  year   = {2026},
  note   = {Accessed September 29, 2026. Page states the playbook will be updated after the AI RMF revision},
  url    = {https://airc.nist.gov/airmf-resources/playbook/measure/}
}

@techreport{nist_ai_200_2_2026,
  title       = {The TEVV-Athlon Framework for Evaluating AI Systems},
  author      = {{National Institute of Standards and Technology}},
  institution = {National Institute of Standards and Technology},
  number      = {NIST AI 200-2},
  year        = {2026},
  note        = {Initial public draft, announced August 7, 2026},
  url         = {https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems}
}

@misc{krechetova_geobenchx_2025,
  title  = {GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks},
  author = {Krechetova, Varvara and Kochedykov, Denis},
  year   = {2025},
  note   = {arXiv:2503.18129, revised October 22, 2025},
  url    = {https://arxiv.org/abs/2503.18129}
}

@misc{pothuri_gisagentbench_2026,
  title  = {GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks},
  author = {Pothuri, Abhinav and Jiang, Zhe and Xu, Zelin and Yang, Di},
  year   = {2026},
  note   = {arXiv:2608.01645, submitted August 3, 2026},
  url    = {https://arxiv.org/abs/2608.01645}
}

@misc{rodrigues_geobenchllm_2026,
  title  = {GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks},
  author = {Rodrigues, Rodrigo Ferreira and Radouane, Karim and Moreno, Jose G. and Tamine, Lynda},
  year   = {2026},
  note   = {arXiv:2608.07411, submitted August 7, 2026, accepted at CIKM 2026},
  url    = {https://arxiv.org/abs/2608.07411}
}

@misc{owasp_llm01_2025,
  title  = {LLM01:2025 Prompt Injection},
  author = {{OWASP Gen AI Security Project}},
  year   = {2025},
  note   = {Accessed September 29, 2026},
  url    = {https://genai.owasp.org/llmrisk/llm01-prompt-injection/}
}

@misc{kaleidr_enterprise_accuracy_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_analytics_accuracy_2026,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/analytics}
}