
Spatial AI の精度とは、位置情報対応システムが依頼を正しく解釈し、適切な場所を特定し、権限のある最新データを利用し、地理計算を正しく行い、適格な候補だけをランキングし、根拠を説明し、有効なアクションだけを実行できるかを測るものです。文章として流暢な回答でも、利用者を間違った店舗へ案内することはあります。単一のモデルスコアだけでは、こうした問題は見えません。本番投入前に、プロダクトが実際に約束している仕事そのものを benchmark で検証する必要があります。
以下では、意思決定チェーン、平均値では隠れてしまうゲート、事前に用意すべき失敗ケース、そして研究 benchmark とプロダクト評価の違いを分けて考えます。関連資料として、ビジネスデータにグラウンディングされた Spatial AI と Enterprise Spatial AI パイロット も参照してください。もっともらしい推薦より、正しい拒否の方が高精度なこともあります。
Spatial AI 精度評価の要点
- チェーン全体を採点する: 意図、grounding、適格性、空間計算、ランキング、説明、アクション、結果。
- 事実はモデルの外で確認する: 場所の同一性、営業時間、在庫、権限、ルートは信頼できるシステムが管理します。
- 難しいケースを含める: 曖昧、古い、未許可、意図的に解けない依頼。
- ゲートを分ける: 低リスク層の高得点で権限エラーを相殺してはいけません。
- 実際の仕事に結び付ける: オフラインケースと本番結果は別の問いに答えます。両方が必要です。
Spatial AI の精度とは何か?
顧客が「帰宅ルートの近くで、商品がまだ在庫にあり、到着時にも開いている店舗はどこか」と尋ねる場合を考えます。この一文には複数の独立した問題が含まれます。利用者が何を求めているのか、どの店舗が存在するのか、在庫は最新か、営業時間は到着時刻に合うか、そのルートから実際に到達できる支店はどこか、どの業務ルールで候補が除外されるのか、残った候補をどう並べて説明するのか。最後の文章が自然でも、それぞれのステップが正しいとは限りません。評価では各レイヤーを分離する必要があります。場所解決のミスは ranking prompt の書き換えでは直りませんし、古い在庫フィードは言語モデルを変更しても直りません。
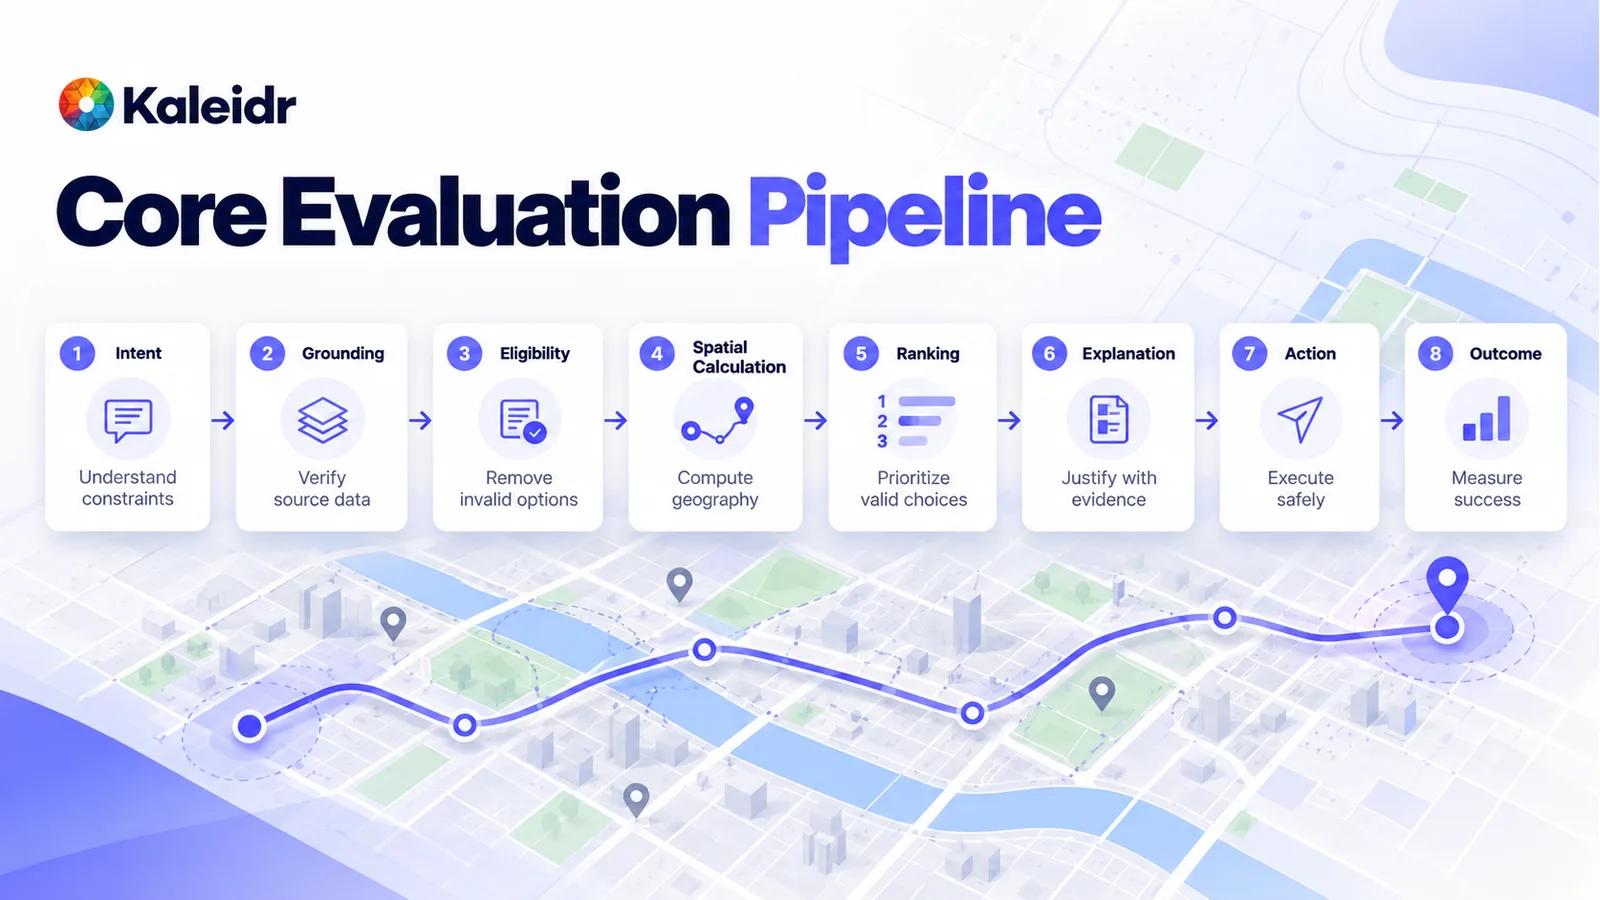
順番にチェーンを検証します。制約を理解し、ソースを確認し、無効な選択肢を除外し、地理を計算し、残った候補をランキングし、根拠で説明し、許可された場合だけアクションを実行し、その仕事が完了したかを測定します。
なぜ 1 つのスコアでは不十分なのか?
総合パーセンテージは比較しやすい一方で、誤用もしやすい指標です。たとえば、説明用の scorecard で総合 92% と表示されていても、意図 99%、ルーティング 98%、説明 96%、認可 75% という内訳かもしれません。これは例であり、Kaleidr の実測値ではありません。平均値は高く見えても、利用者がアクセスできないはずのデータをシステムが表示したり、アクションに使ったりする可能性があります。重要な次元には、それぞれ独立した本番ゲートが必要です。低リスク作業での高性能が、権限違反、無効な目的地、未対応アクション、架空の在庫情報を補ってはいけません。
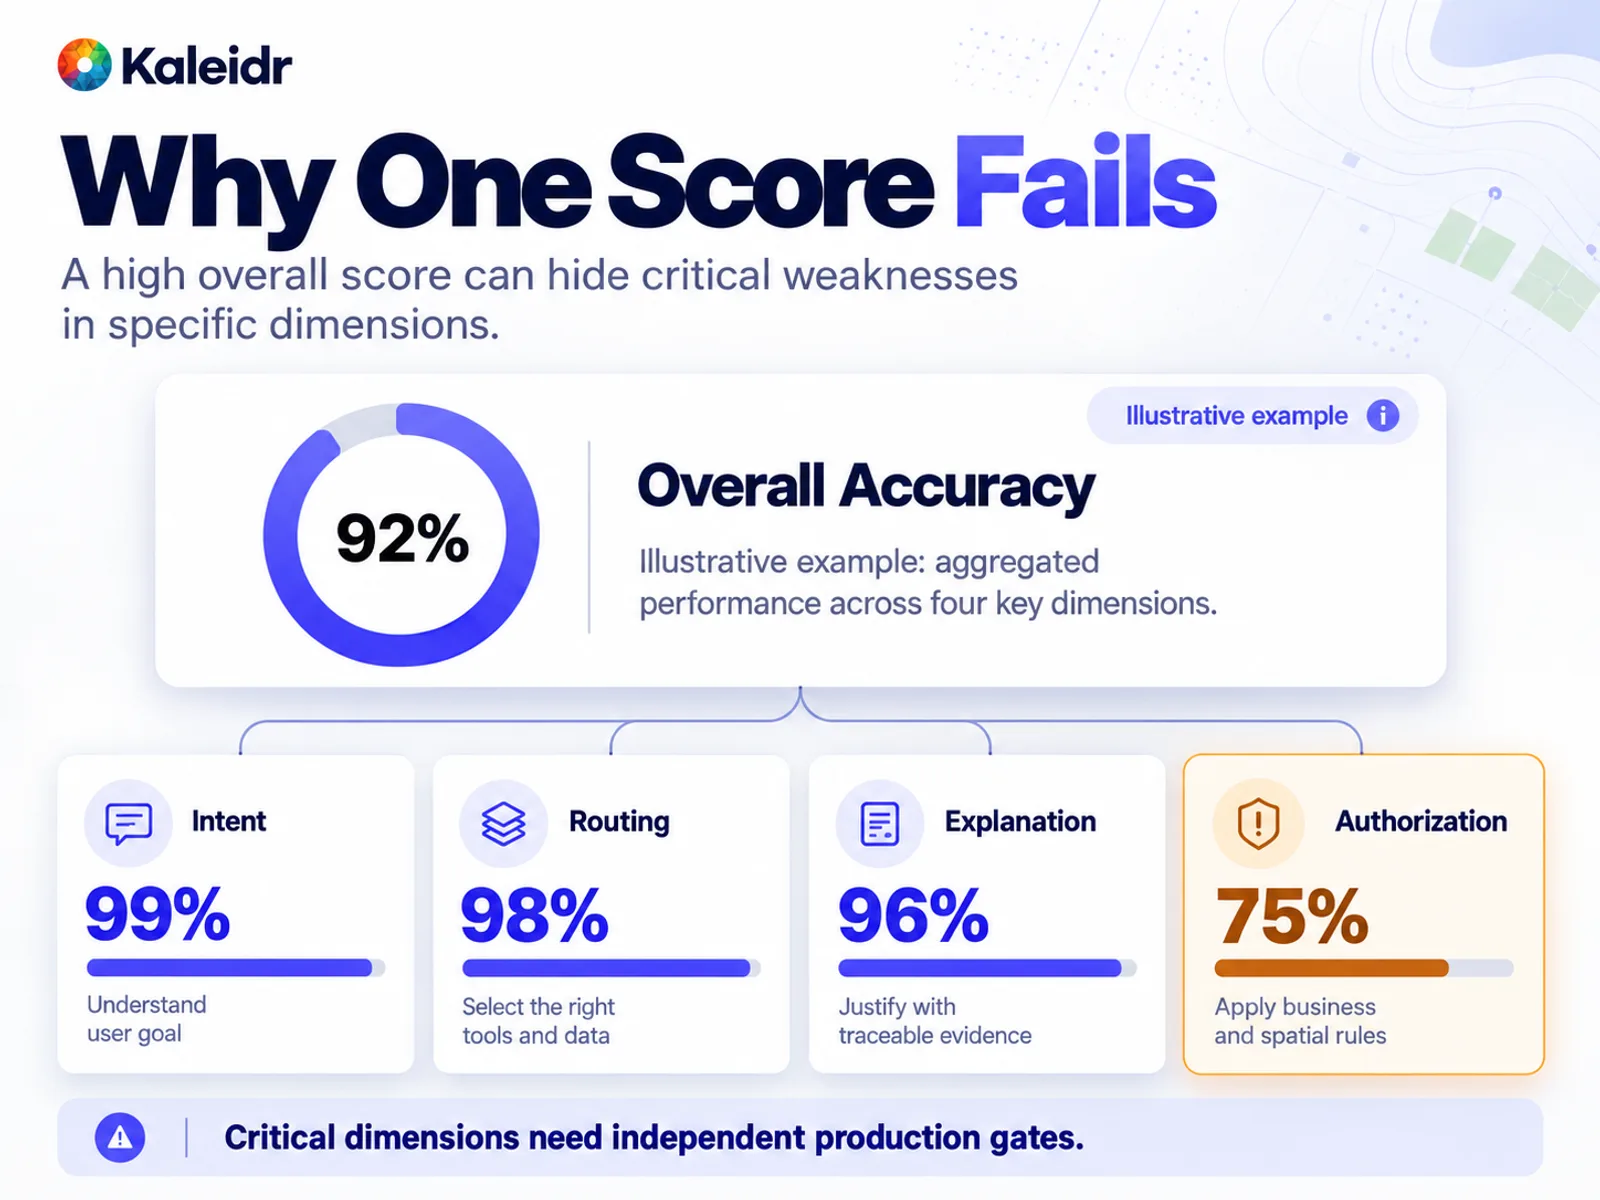
高い総合スコアでも弱いゲートを隠すことがあります。この図のパーセンテージは説明用の例であり、Kaleidr の実測パフォーマンスではありません。
NIST の AI Risk Management Framework playbook は、測定を最も重大なリスクから始め、測定しないリスクも文書化するべきだとしています。同じ playbook ページでは、AI RMF 1.0 が更新中であり、その後 playbook も改訂されると説明されています (NIST, 2026)。NIST の TEVV-Athlon framework、NIST AI 200-2 の初期公開ドラフトは 2026 年 8 月 7 日に発表され、2026 年 10 月 6 日までコメントを受け付けています。この文書は、個人または組織の目標をシステムが達成していることを示す証拠として評価を位置付け、現実世界での影響を含め、それぞれのニーズに合わせた測定を求めています (NIST, 2026)。これは意見募集用のドラフトです。Kaleidr の管理項目一覧ではありません。位置情報対応プロダクトにとって重要な文脈は、そのプロダクトが実際に行う地理的意思決定です。
意図、場所、適格性はどうテストすべきか?
最初は意図です。「ホテルと会場の間にあり、車いすで利用でき、午前 7 時前に開いているカフェ」という依頼は、「ホテルの近くのカフェ」と同じではありません。各テストクエリについて、期待される構造化解釈を保存します。カテゴリ、地理的関係、出発地、目的地、アクセシビリティ、時間です。そのうえで、制約抽出、システムが勝手に追加した制約、落とした制約を測定します。カテゴリは合っていても時間条件を無視したなら、タスクを正しく理解していません。
場所の言語表現は曖昧です。Springfield、Terminal 2、Main Street、「Austin の当社店舗」は、それぞれ複数の実体を指し得ます。同名の都市、同じ支店名、複数のターミナル、改名された場所、略称、多言語名、明確な境界がない地区、行政境界上の住所を含めてください。名前文字列の一致ではなく、canonical な場所 ID を採点します。1 ブロック先の別のカフェを選ぶことと、別の都市を目的地にすることは、どちらも誤りですが深刻度は同じではありません。
適格性は、その場所を候補として扱ってよいかを問います。ランキングは、有効な場所をどの位置に並べるかを問います。最寄りの pin でも、閉店、在庫切れ、サービスエリア外、満席、ポリシー上の対象外であれば候補に残すべきではありません。まずそれらを集合から除外し、その後で残りをランキングします。適格性 precision は、返された全場所のうち適格だった場所の割合です。高リスクな workflow では、少数の不適格推薦の方が平均的なランキング品質より重大なことがあります。在庫、営業時間、権限、ポリシーは、それらを管理するシステムに置き続けます。ビジネスデータにグラウンディングされた Spatial AI も同じ境界を示しています。
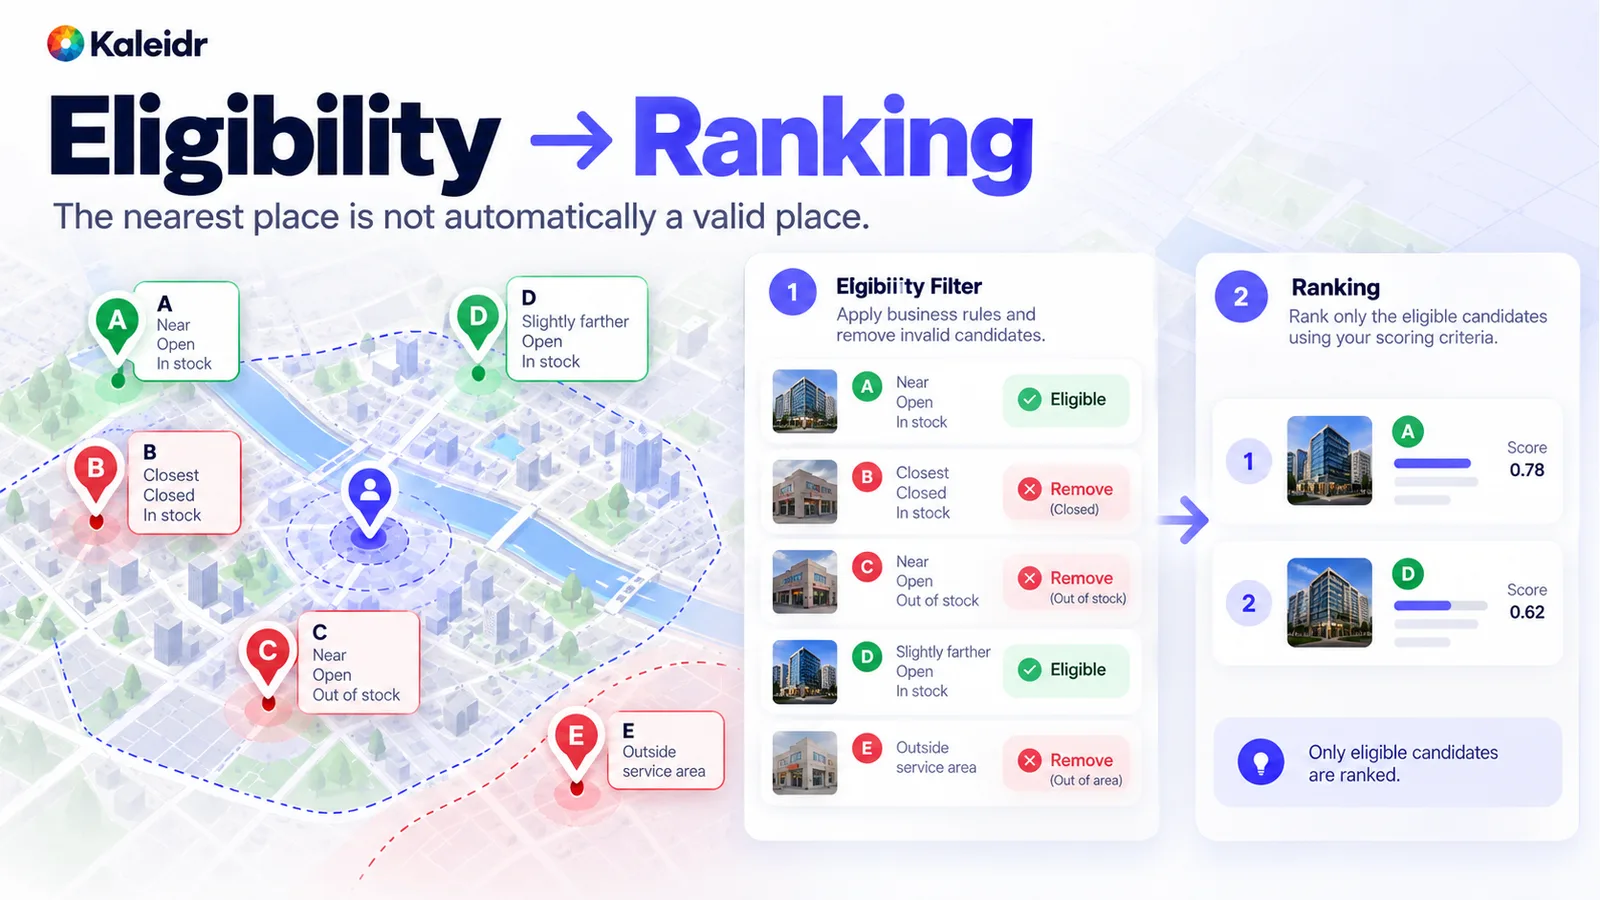
まず適格性をフィルタリングします。最も近い場所が自動的に有効な場所になるわけではありません。
地理とデータの鮮度はどう確認すべきか?
空間エンジンが計算できるものについて、言語モデルを source of truth にするべきではありません。point-in-polygon、ルート距離、移動時間、サービスエリア所属、包含関係、ルート上の順序などが該当します。信頼できる地理データとツールから期待結果を作り、アプリの結果と比較します。「この点はこのポリゴン内か」「システムは branch ID 172 を返したか」のような問いには完全一致が適しています。座標、推定移動時間、解像度の異なる境界には、事前定義した許容差を使います。実行後になってから「間違っているが十分近い」と基準を変えてはいけません。
鮮度は、過去時点で正しかったかとは別の問題です。座標や支店 ID は安定していても、営業時間、在庫、交通状況、休業情報は変化します。鮮度の閾値を外れたデータで行われた判断の割合と、更新時刻が既知の時間依存フィールドの割合を追跡します。データが欠けていることと「利用不可」であることは同じではありません。状態が不明なのに自信を持って「はい」「いいえ」と答えるのは、場所自体が実在していても失敗です。
「結果なし」が正しい答えになるのはいつか?
顧客が「10 分以内で、午後 9 時以降も商品がある場所」を尋ねても、その条件を満たす場所が存在しないことがあります。弱いシステムは制約を黙って緩和し、20 分先の支店を返します。grounded なシステムは、すべての条件を満たす確認済み候補がないと答えます。benchmark には意図的に解けないタスクを含め、「結果なし」を正しく返す率と誤推薦率を測定するべきです。2025 年の GeoBenchX は、多段階の地理空間タスクでツールを呼び出すエージェントの benchmark で、解けるタスクと意図的に解けないタスクの両方を含み、拒否精度を測れるようにしています (Krechetova and Kochedykov, 2025)。この論文が評価しているのは研究エージェントです。GeoBenchX が Kaleidr を採点しているわけではなく、プロダクトチームは自分たちの仕事に合った解けないケースを別途作る必要があります。
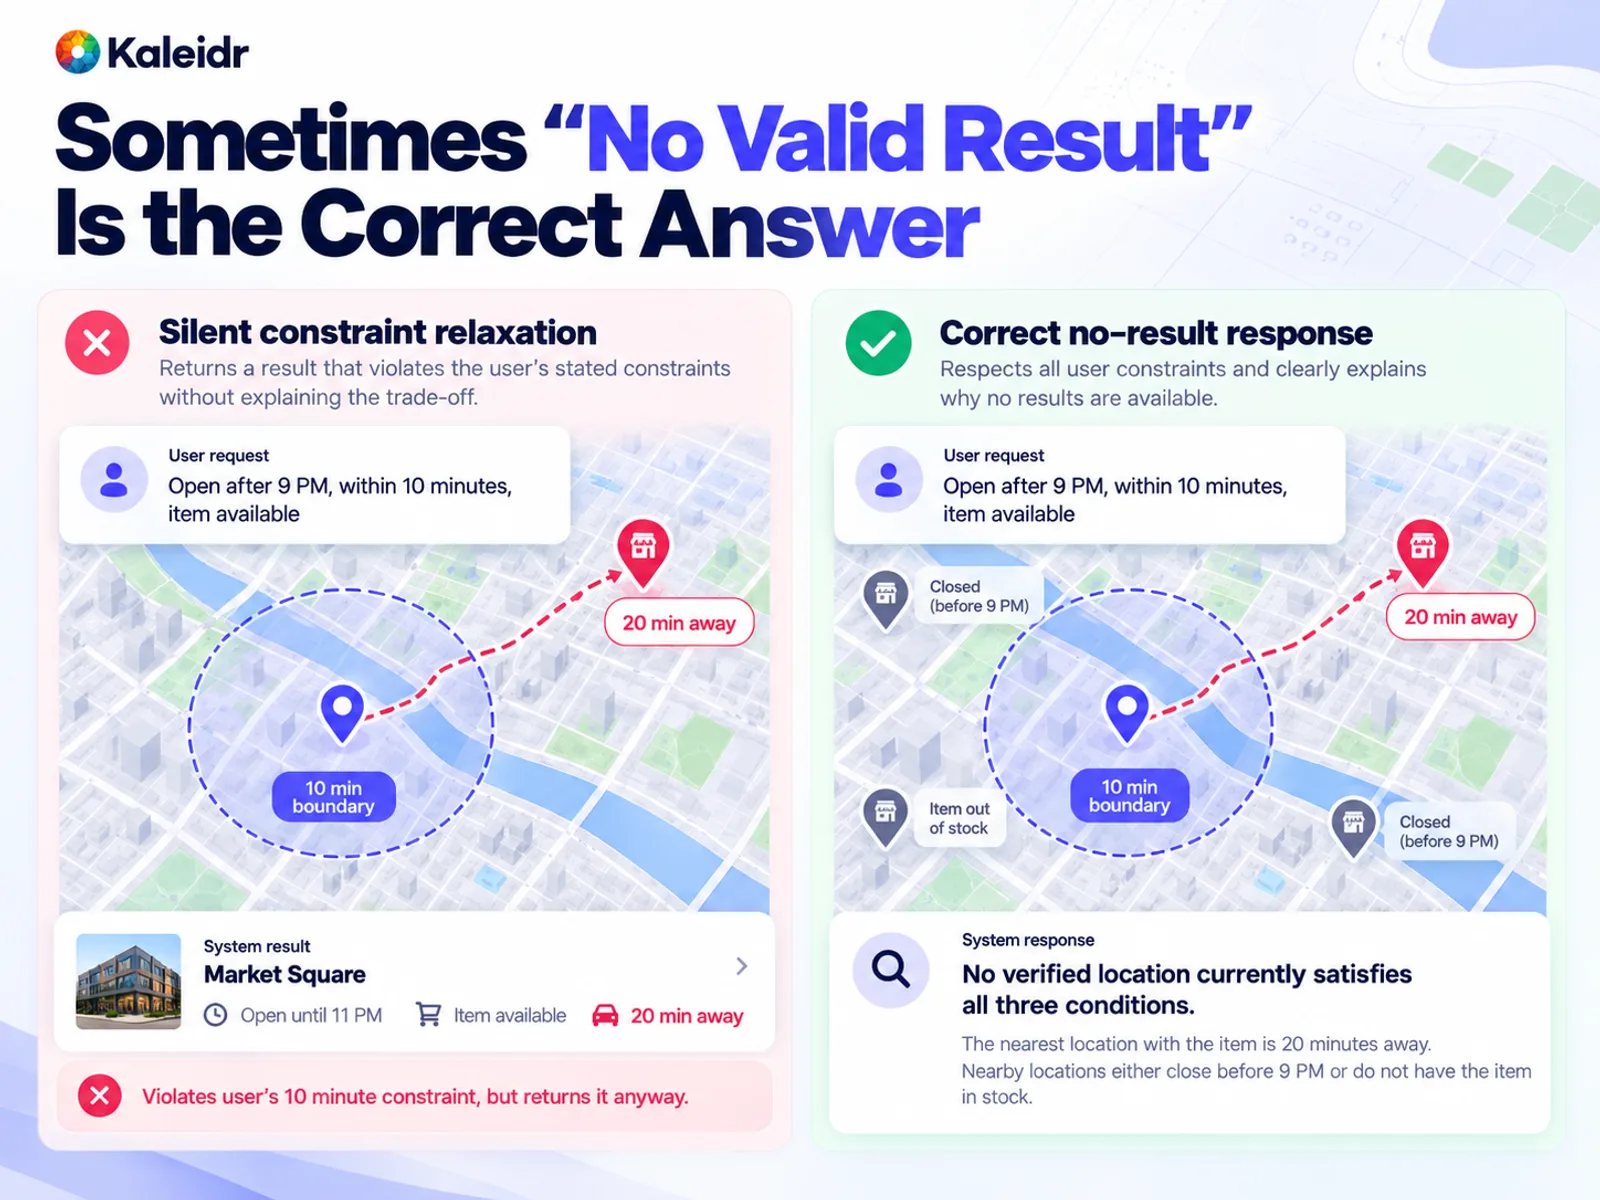
有効な結果が存在しないこと自体が正解の場合があります。指定時間や距離を外れた場所を返すのは、親切な fallback ではなく誤推薦です。
ランキング、説明、アクションはどう採点すべきか?
無効な候補を除外してからランキングします。最寄りが自動的に最良とは限りません。プロダクトの定義次第で、移動時間、ルート逸脱、在庫、アクセシビリティ、価格、営業時間帯、事業上の優先度を目的関数に含められます。役立つ指標には、1 位の結果が許容できる割合、上位 K 件に許容可能な候補が含まれる割合、人手レビューまたはポリシー順序との一致、既知の最良適格候補に対する regret などがあります。engagement を ranking quality とみなしてはいけません。順位を、顧客が必要としていた実際のアクションに結び付けます。
「22 時まで営業、在庫あり、ルートに 6 分追加」といった説明は、それぞれの文言がシステムが実際に使った証拠へ追跡できる場合にのみ正確です。場所の同一性、在庫の主張、営業時間、本当にルート計算が行われたか、文章がランキング判断と一致するかを確認します。よく書かれた段落でも間違うことはあります。短く不格好でも正しいことはあります。説明中の事実主張に対して、検証できた主張の割合を測定します。
アクションも回答の一部です。地図移動、marker 追加、ルート要求、filter 変更、予約開始は、文章が正しくても誤っている可能性があります。そのアクションがアプリの語彙に含まれているか、対象とパラメータは正しいか、利用者に実行権限があるかを追跡します。正しい文章に誤った地図アクションが付いていれば、そのインタラクションは失敗です。
benchmark に含めるべき失敗ケースは?
チームがすでに解き方を知っているきれいな例だけのテストセットでは、信頼性を過大評価します。曖昧な名称、重複支店、サービスエリア境界上の住所、解けない依頼、閉店直後の店舗、場所と一致しない在庫、近いが大きな迂回を生む pin、到着前に閉まる店舗、利用者が見られない私有施設、英語名と異なるローカル名、不明な営業時間、first-party データと矛盾する公開ソース、モデルを誘導しようとする取得テキスト、停止中の routing または業務データサービスを含めます。目的は、本番で実際に遭遇する意思決定を再現することです。
取得テキストがモデルを誘導しようとするケースは prompt injection です。OWASP は LLM01:2025 Prompt Injection を、ユーザー入力または取得入力によってモデルの挙動が意図せず変わり、重大な意思決定に影響する場合もある弱点として説明し、retrieval-augmented generation でも完全には解消できないとしています (OWASP, 2025)。このケースは権限と同じくテストセットのセキュリティ系に入れ、セキュリティを後付けの付録として扱わないでください。
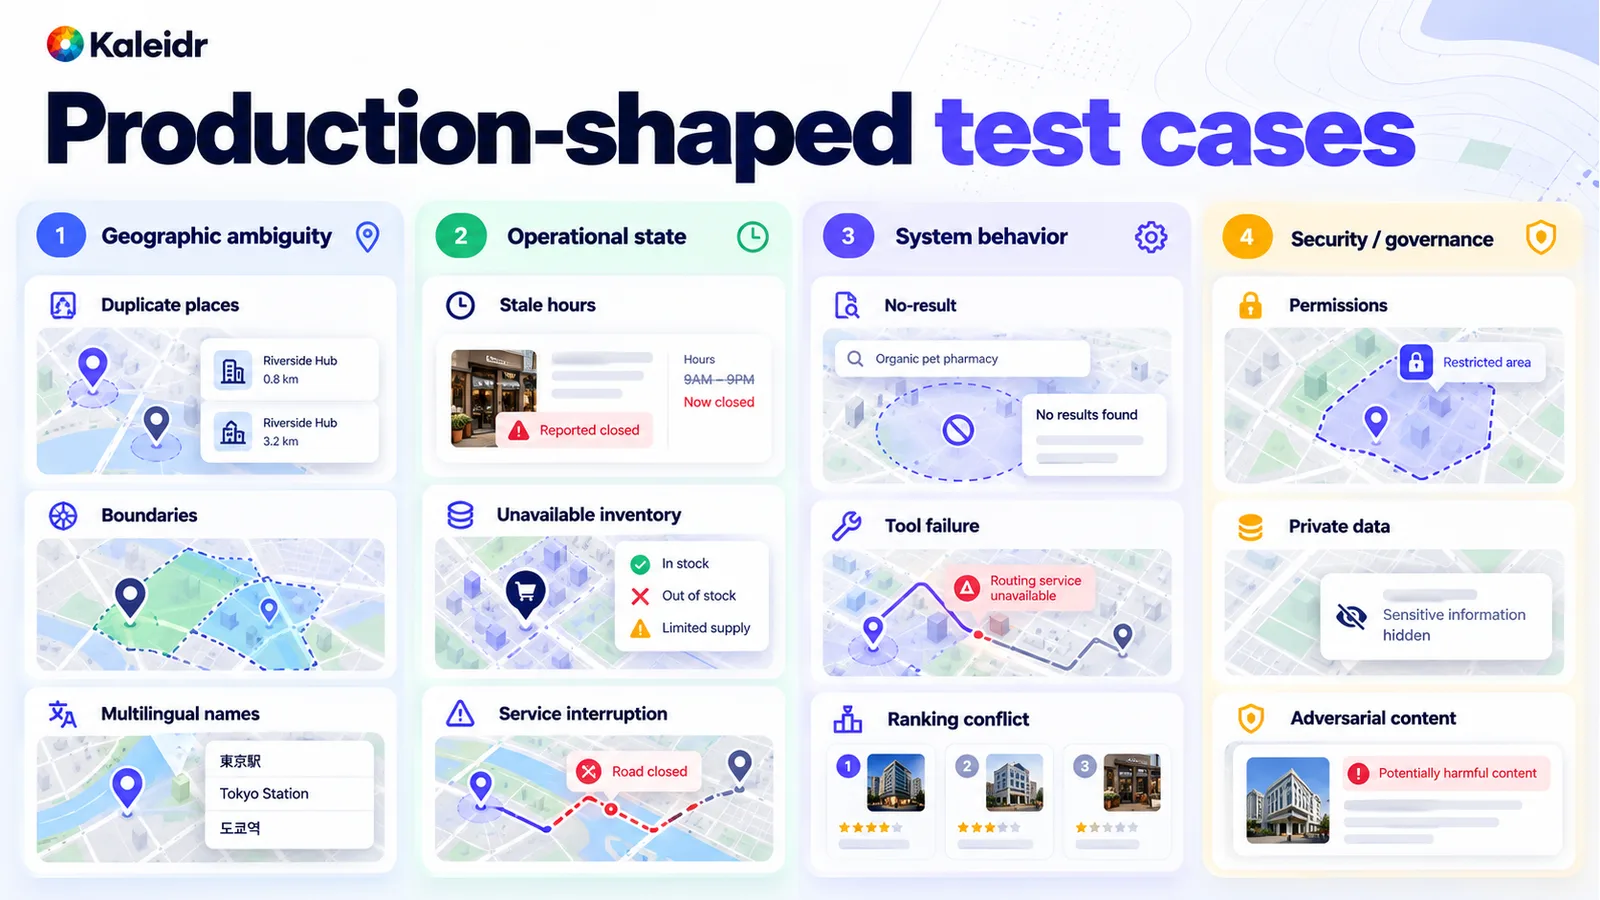
本番に近いケースは、地理的曖昧性、運用状態、システム挙動、セキュリティをカバーします。これらを省いた benchmark は信頼性を過大評価します。
なぜ実行前にグラウンドトゥルースが必要なのか?
各ケースには、何を「正しい」とするかを判定できるだけの記録済み truth が必要です。クエリ、ユーザーコンテキスト、許可されたソース、期待する意図、必須制約、canonical な場所、適格集合、期待する空間関係、最良結果、許容代替、期待アクション、「結果なし」が正しい理由、許容差、誤りの深刻度を含めます。システムを実行する前に記録してください。モデルの出力に合わせて答え合わせを変えるのは評価ではありません。
2026 年の GISAgentBench は、実務家由来の 349 件の多段階 GIS タスクからなる benchmark で、多くの GIS エージェント benchmark には ground-truth 出力がなく、代わりにコード類似度、軌跡一致、model judge のような代替信号を使っており、似た workflow を正解として扱ってしまう可能性があると論じています。GISAgentBench の各タスクには正確な ground-truth 出力ファイルがあります (Pothuri et al., 2026)。座標、包含、canonical ID、営業中か休業か、権限、どの API action が呼ばれたかなど、決定論的な問いにはコードまたは信頼できる記録を使います。説明が理解しやすいかなど、本当に主観的な問いだけを人手レビュー、または校正済みのモデル支援レビューに任せます。評価方法は、検証する truth の種類に合わせるべきです。
セグメント別の結果をどう読むべきか?
平均値は弱い地域を隠すことがあります。国、市場、言語、都市部/地方のカバレッジ、データプロバイダー、場所カテゴリ、支店密度、クエリ複雑度、ルート種別で結果を分けます。全体の valid-result rate が 95% でも、新規市場だけ 78% だと仮定します。この組み合わせは仮の例であり、Kaleidr の測定値ではありません。平均は数学的には正しくても、スケール判断に使うべき数字とは限りません。どこでエラーが起きているかを調べ、失敗ケースを解釈、entity resolution、grounding、適格性、空間計算、鮮度、ランキング、説明、アクション、セキュリティ、リカバリに分類します。分類が、チームに何を直すべきかを示します。routing のミスは説明の問題ではありません。
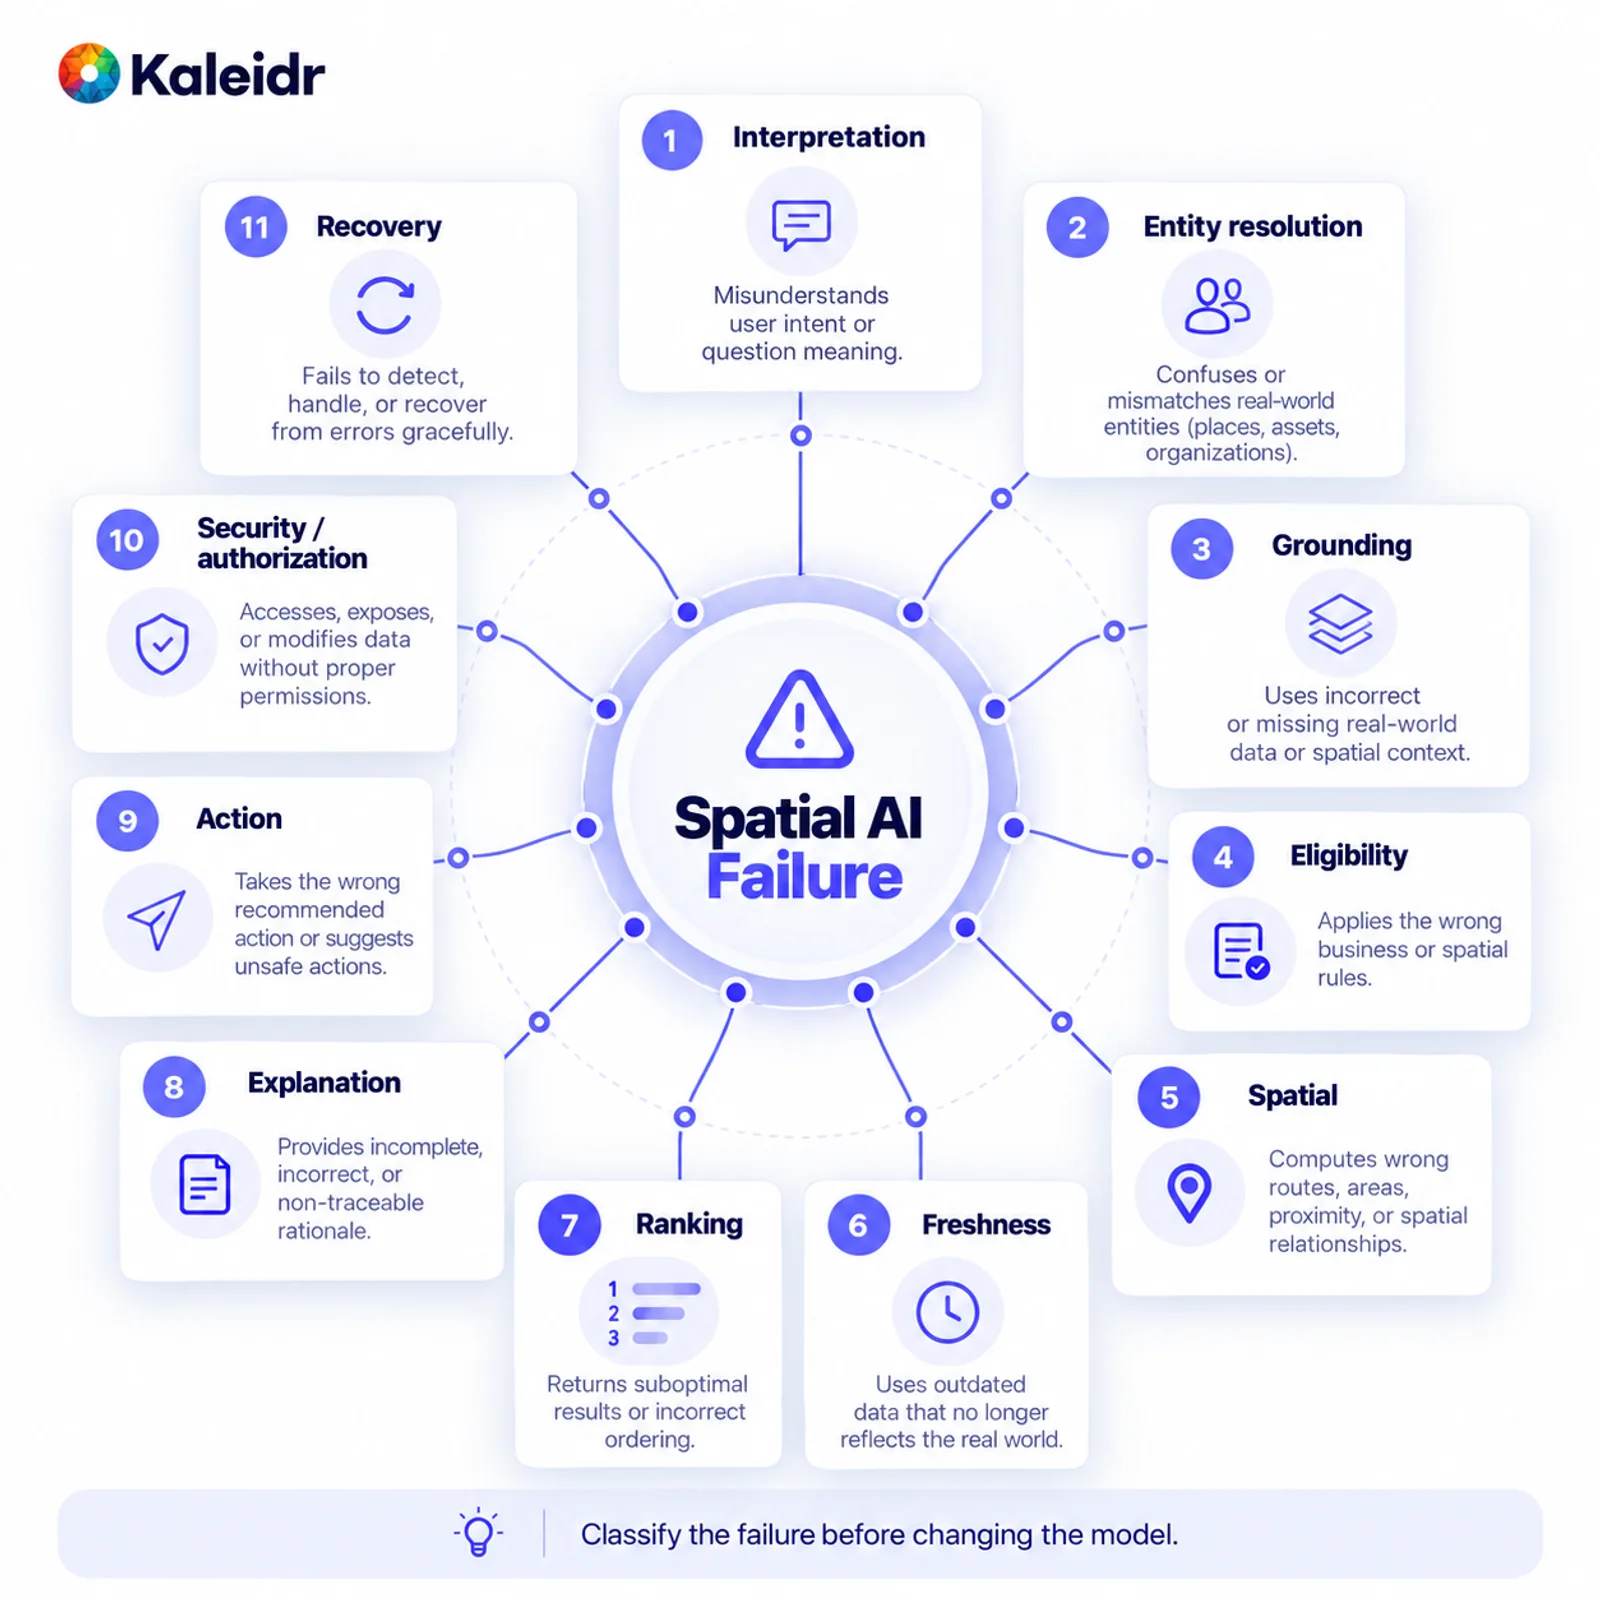
モデルを変える前に失敗を分類します。カテゴリを分けることで、まれでも重大な失敗が大きな平均値の中に消えるのを防げます。
生成系の実行結果もばらつきます。重要なケースでは、平均、観測された最悪の実行、失敗がどの程度繰り返されるかを記録します。9 回安全で 1 回だけ誤るクエリは、毎回同じ安全な答えを返すクエリとはリスクが異なります。prompt、モデル、retrieval、ranking、データプロバイダー、ツール、カバレッジが変わったらテストセットを再実行します。評価は一度きりのローンチ前報告書ではなく、release management の一部です。
本番 scorecard には何を入れるべきか?
各次元に独自のメトリクスと独自のゲートを持たせます。意図には constraint extraction、場所 ID には canonical-place accuracy を使えます。認可とセキュリティには、保護データについて一切許容しない unauthorized-access rate を使えます。適格性、空間計算、鮮度、ランキング、「結果なし」の処理、説明、アクション、結果にも、それぞれプロダクトオーナーが実行前に設定する閾値が必要です。他のアプリの普遍的な cutoff をコピーしてはいけません。気軽なレストラン推薦と、安全性に影響するルーティング判断では許容できる error budget が異なります。
| 次元 | 指標例 | ゲート例 |
|---|---|---|
| 意図 | 制約抽出精度 | このプロダクト向けに設定 |
| 場所 ID | canonical-place accuracy | 非常に高い |
| 認可 | 未許可アクセス率 | 保護データでは 0 を要求 |
| 適格性 | 適格結果 precision | 非常に高い |
| 空間計算 | 事前定義した許容差内で正しい | このプロダクト向けに設定 |
| 鮮度 | 鮮度ウィンドウ内にある結果の割合 | このプロダクト向けに設定 |
| ランキング | Top-1 または Top-K acceptance | このプロダクト向けに設定 |
| 結果なし処理 | 正しい拒否率 | 高い |
| 説明 | 根拠付き主張率 | 高い |
| アクション | 有効かつ正しいパラメータのアクション率 | 非常に高い |
| 結果 | 位置依存タスクの完了 | 意図した仕事を改善すること |
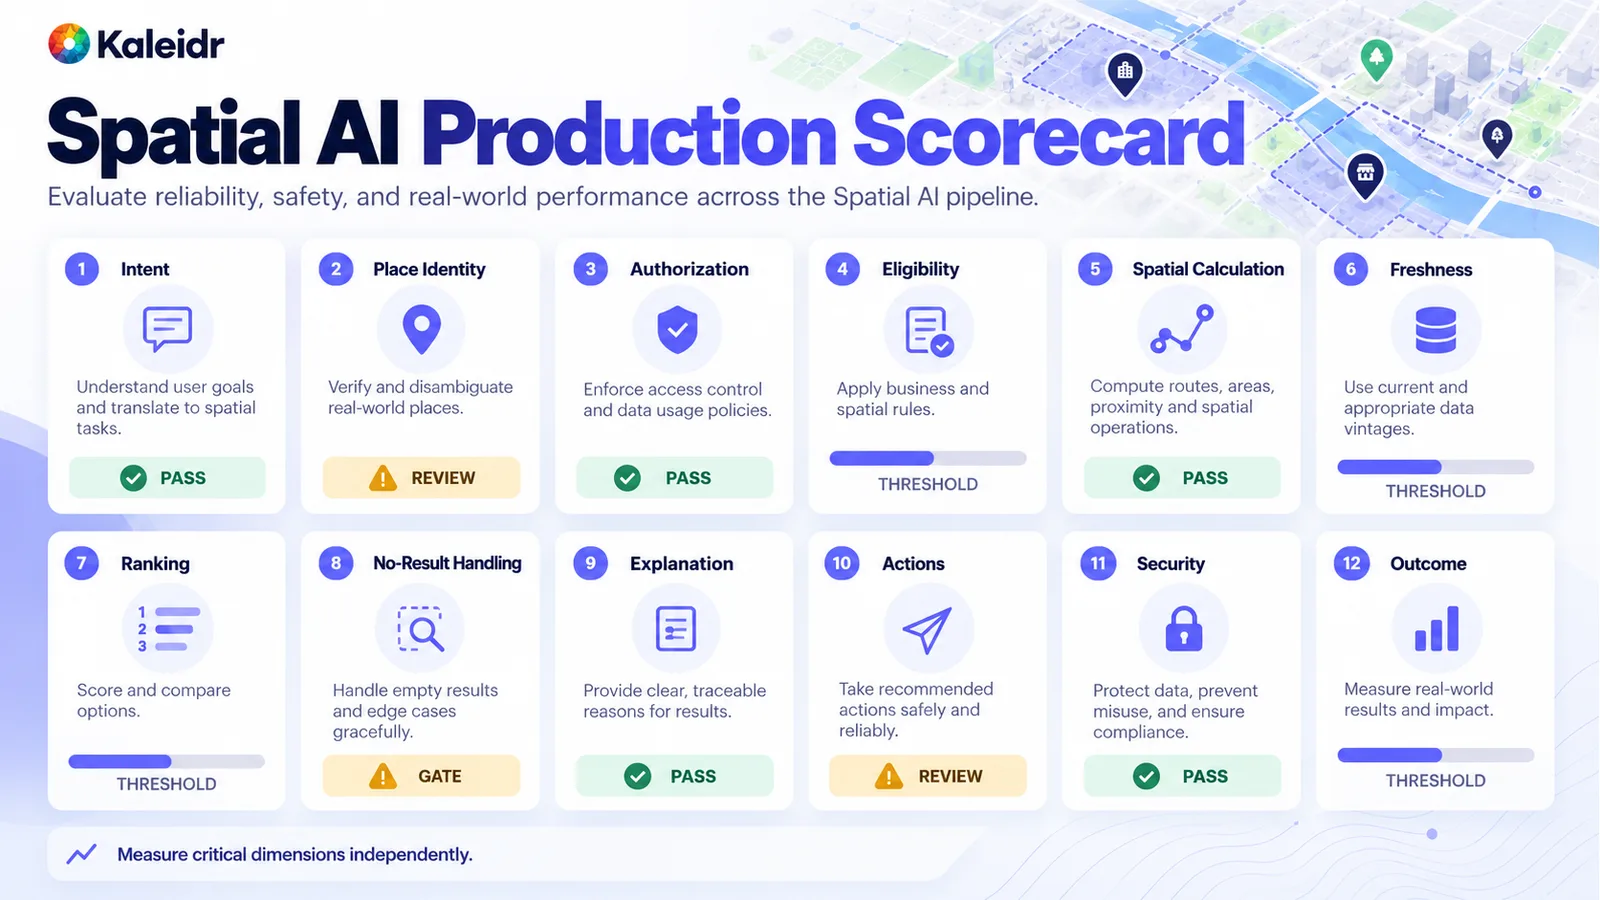
重要な次元は独立して測定します。この scorecard のステータスラベルは placeholder であり、Kaleidr の benchmark スコアではありません。
スケールするかどうかはどう判断すべきか?
混合した総合スコアではなく、ゲートを使います。本番に近い条件で、有効で grounded かつ空間的に正しい結果が安定し、重大エラークラスが管理され、運用データの責任者が明確で、狙った成果が改善したらスケールします。仕事自体には価値があり、修正可能なレイヤーが弱ければ反復改善します。地域、ソース、仕事を混ぜすぎて何が失敗したか分からないならスコープを絞ります。信頼できるデータを特定できない、重大な失敗を制御できない、タスクを定義できない、現行 workflow より改善したと示せない場合は止めます。Enterprise Spatial AI パイロット は限定されたテストです。scorecard が、そのテストを意思決定に変えます。
Kaleidr は評価のどこに位置するか?
Kaleidr Enterprise は、inference API、ranking system、analytics、deployment support を含む location-intelligence infrastructure を提供し、既存の地図の横に追加できる chat、editing、tiles、埋め込み可能な viewer も含むと説明しています (Kaleidr, 2026)。ホストアプリは、在庫、権限、顧客状態、予約、その他の非公開運用記録など、自社が所有する業務システムを保持します。空間ツールは計算可能な処理を担当します。言語モデル層は意図を解釈し、サポートされた機能を調整し、grounded な結果を説明します。Kaleidr の公開 Analytics ページ「Map Engagement and Location Analytics」では、reach、views、engagement、オーディエンスの場所と活動、map ごとの sessions と interactions、place comparison、spatial patterns を説明しています (Kaleidr, 2026)。これらのレポートは地図と場所の利用行動を示します。完了した予約、注文、qualified lead は、それらを記録するホスト側システムに残ります。
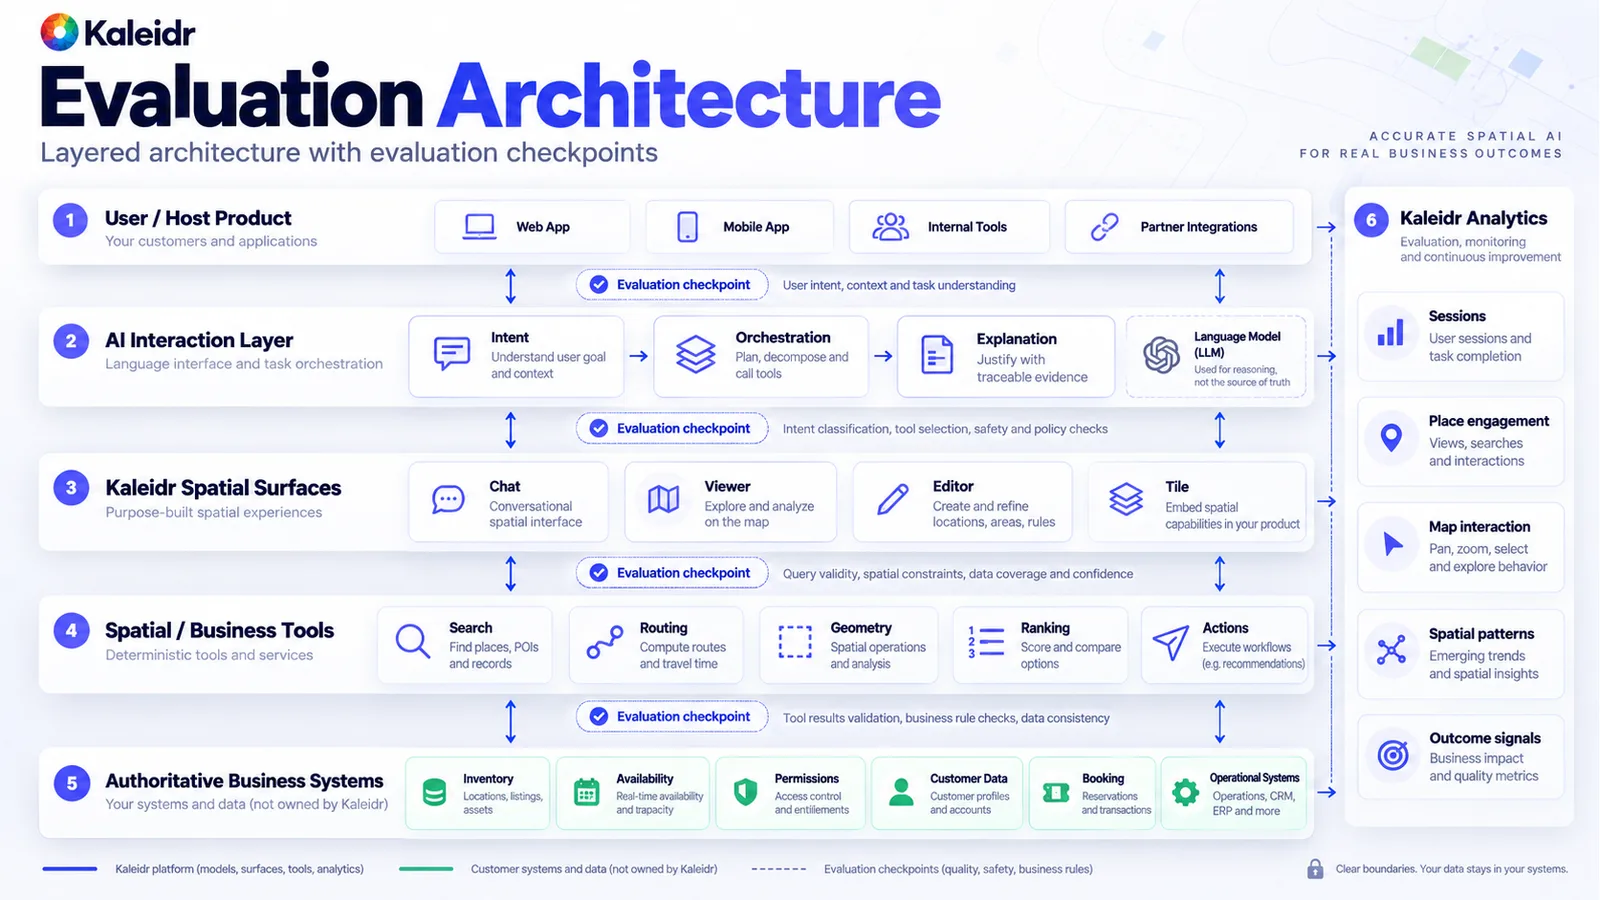
言語モデルは、在庫、権限、ルートの source of truth ではありません。レイヤー間のチェックポイントによって、どの部分が失敗したかを特定できます。
弱い benchmark を隠す誤りとは?
曖昧さ、欠損データ、解けない依頼を含まない happy-path 質問だけでは、信頼性を過大評価します。参照文と文章がどれだけ似ているかだけを採点すると、別の言い方で正しい判断をしたケースを落とし、参照文のスタイルで書かれた間違った場所を評価してしまいます。不適格な場所を含んだままランキングすると、適格性の失敗が隠れます。空間エンジンが計算できる距離をモデルに判定させるのは、計算を流暢さに置き換えることです。鮮度を無視すると昨日の営業時間を今日の営業時間として扱います。地図操作が増えたことを精度とみなすと、興味と成功、場合によっては混乱を混同します。数値を見たあとで許容差を変えるものは benchmark ではありません。モデル単体だけをテストすると、retrieval、データ、ツール、権限、ranking、interface を無視します。本番挙動は組み上がったプロダクト全体の挙動です。
研究 benchmark は能力の probe として引き続き役立ちます。2026 年 8 月に提出され CIKM 2026 に採択された GeoBenchLLM は、公開 datasets をもとにした geo-related task で言語モデルを評価し、geospatial および temporal understanding も含みます (Rodrigues et al., 2026)。GeoAI benchmark は、remote sensing、GIS workflow、imagery、geospatial model task を扱うことが多いです。一方、プロダクト benchmark では、業務データ grounding、権限、live availability、ranking、map action、顧客成果も必要になる場合があります。1 つの公開 benchmark だけで、すべてのプロダクトの仕事を代表することはできません。
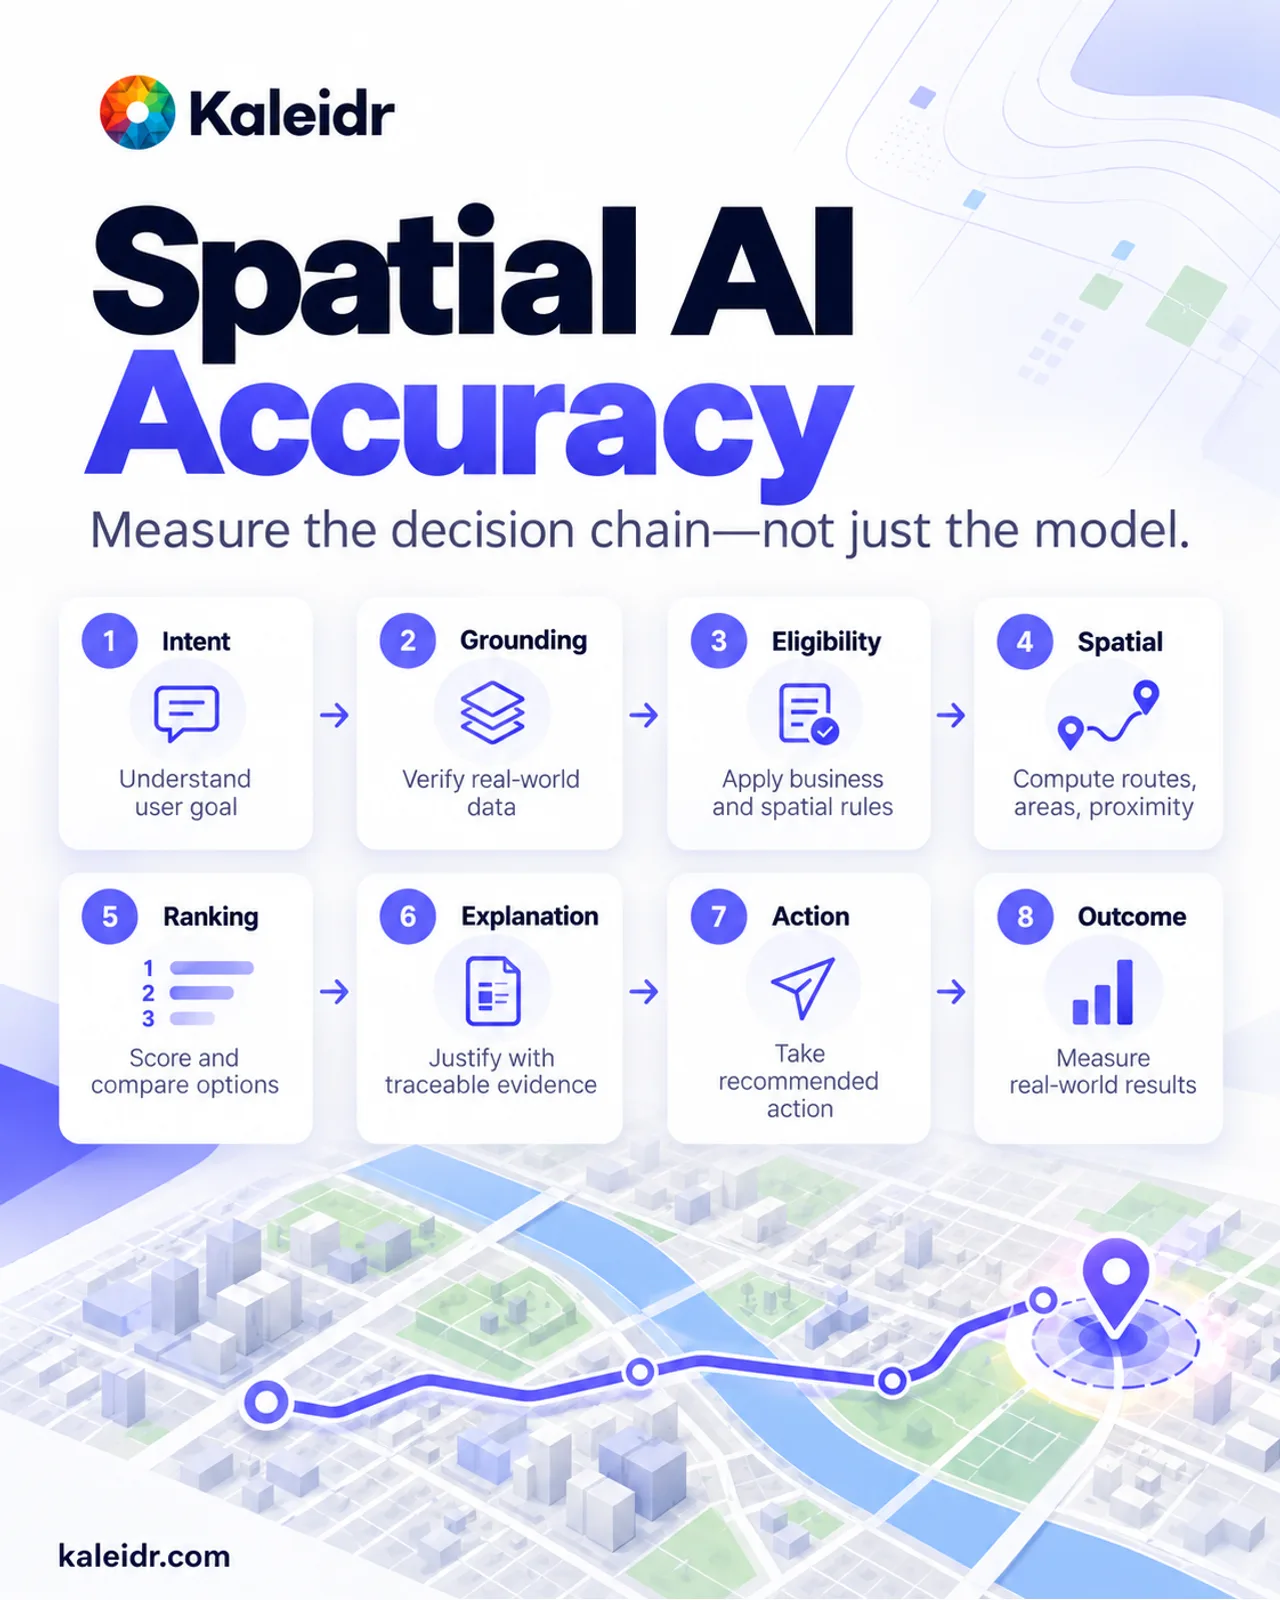
モデルだけではなく意思決定チェーンを測定します。8 段階は評価の構成であり、公表されたスコアではありません。
評価を release gate にするには?
スケールする前にテストセットを作ります。失敗ケースを含めます。ツールや記録で答えられる決定論的な truth は言語モデルの外に置きます。重要な次元はそれぞれ独立したゲートで追跡します。システムが変わったら再実行し、offline の結果を、本来改善すべき本番成果につなげます。問うべきなのは、このシステムが、正しいデータ、地理、権限、アクションを使って、プロダクトが約束する位置依存の判断を実行できるか、そしてチームがそれを証明できるかです。
Kaleidr Enterprise を見る と、既存システムの横に位置情報対応 AI を追加し、焦点を絞った pilot を設計できます。Kaleidr Analytics を見る と、その pilot で利用者が地図や場所をどう使っているか確認できます。業務成果とスケール判断の責任は引き続きホスト側にあります。
FAQ
Spatial AI の精度はどう測る?
位置意思決定の各段階を測定します。意図、場所解決、認可、適格性、地理計算、鮮度、ランキング、説明、アクション、ユーザーまたは業務成果です。このチェーンを 1 つのモデルスコアにまとめてはいけません。
言語モデルの精度と同じものか?
いいえ。言語モデルは 1 つのコンポーネントにすぎません。場所データベース、業務記録、空間エンジン、routing、ranking、権限、アプリケーション状態のすべてが、結果の正しさに影響します。
言語モデルが距離を計算すべきか?
距離や移動関係が必要なら、地理ツールまたは routing tool を使います。モデルは計算が必要なタイミングを判断し、結果を説明できます。実際の計算は空間サービスが行います。
benchmark に不可能な質問を含めるべきか?
はい。意図的に解けないタスクによって、システムが場所を捏造したり制約を黙って落としたりせず、grounded な「結果なし」を返せるかを確認できます。
評価はどのくらいの頻度で実行すべきか?
本番前に実行し、その後もモデル、prompt、データプロバイダー、ranking、空間ツール、権限、カバレッジが変わるたびに再実行します。本番挙動は継続的に監視します。ローンチ当日のレポートだけでは release process になりません。
1 つの benchmark で全システムを比較できるか?
研究 benchmark は、明示された能力を比較できます。本番評価は、そのアプリケーションの地理的仕事、データ、リスク、ツール、成果を反映する必要があります。GeoAI benchmark とプロダクト benchmark は互換ではありません。
参考文献
- National Institute of Standards and Technology. AI RMF Playbook, Measure. Notes that the AI RMF 1.0 is being updated and that the playbook will be revised afterward. Accessed September 29, 2026. https://airc.nist.gov/airmf-resources/playbook/measure/
- National Institute of Standards and Technology. The TEVV-Athlon Framework for Evaluating AI Systems. NIST AI 200-2, initial public draft. Announced August 7, 2026; comments through October 6, 2026. https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems
- Krechetova, Varvara, and Denis Kochedykov. GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks. arXiv:2503.18129, submitted March 23, 2025, revised October 22, 2025. https://arxiv.org/abs/2503.18129
- Pothuri, Abhinav, Zhe Jiang, Zelin Xu, and Di Yang. GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks. arXiv:2608.01645, submitted August 3, 2026. https://arxiv.org/abs/2608.01645
- Rodrigues, Rodrigo Ferreira, Karim Radouane, Jose G. Moreno, and Lynda Tamine. GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks. arXiv:2608.07411, submitted August 7, 2026. Accepted at CIKM 2026. https://arxiv.org/abs/2608.07411
- OWASP Gen AI Security Project. LLM01:2025 Prompt Injection. Accessed September 29, 2026. https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed September 29, 2026. https://kaleidr.com/enterprise
- Kaleidr. Map Engagement and Location Analytics. Accessed September 29, 2026. https://kaleidr.com/analytics
- Kaleidr. Grounded Spatial AI for Business Data. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- Kaleidr. An Enterprise Spatial AI Pilot Before Scaling. https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling
@misc{nist_rmf_playbook_measure_2026,
  title  = {AI RMF Playbook, Measure},
  author = {{National Institute of Standards and Technology}},
  year   = {2026},
  note   = {Accessed September 29, 2026. Page states the playbook will be updated after the AI RMF revision},
  url    = {https://airc.nist.gov/airmf-resources/playbook/measure/}
}

@techreport{nist_ai_200_2_2026,
  title       = {The TEVV-Athlon Framework for Evaluating AI Systems},
  author      = {{National Institute of Standards and Technology}},
  institution = {National Institute of Standards and Technology},
  number      = {NIST AI 200-2},
  year        = {2026},
  note        = {Initial public draft, announced August 7, 2026},
  url         = {https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems}
}

@misc{krechetova_geobenchx_2025,
  title  = {GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks},
  author = {Krechetova, Varvara and Kochedykov, Denis},
  year   = {2025},
  note   = {arXiv:2503.18129, revised October 22, 2025},
  url    = {https://arxiv.org/abs/2503.18129}
}

@misc{pothuri_gisagentbench_2026,
  title  = {GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks},
  author = {Pothuri, Abhinav and Jiang, Zhe and Xu, Zelin and Yang, Di},
  year   = {2026},
  note   = {arXiv:2608.01645, submitted August 3, 2026},
  url    = {https://arxiv.org/abs/2608.01645}
}

@misc{rodrigues_geobenchllm_2026,
  title  = {GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks},
  author = {Rodrigues, Rodrigo Ferreira and Radouane, Karim and Moreno, Jose G. and Tamine, Lynda},
  year   = {2026},
  note   = {arXiv:2608.07411, submitted August 7, 2026, accepted at CIKM 2026},
  url    = {https://arxiv.org/abs/2608.07411}
}

@misc{owasp_llm01_2025,
  title  = {LLM01:2025 Prompt Injection},
  author = {{OWASP Gen AI Security Project}},
  year   = {2025},
  note   = {Accessed September 29, 2026},
  url    = {https://genai.owasp.org/llmrisk/llm01-prompt-injection/}
}

@misc{kaleidr_enterprise_accuracy_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_analytics_accuracy_2026,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/analytics}
}