
Spatial AI 準確性衡量一個位置感知系統是否能正確理解需求、辨識正確地點、使用已授權且最新的資料、正確計算地理關係、只對符合資格的選項進行排序、說明證據,並且只執行有效操作。即使回答文字非常流暢,也可能把使用者帶到錯誤的分店。單一模型分數無法看出這些問題。因此,benchmark 必須在正式上線前,直接測試產品承諾完成的實際工作。
以下內容會分開討論決策鏈、單一平均分數可能掩蓋的各種 gate、值得事先建立的失敗案例,以及研究 benchmark 與產品評估之間的界線。延伸閱讀包括以商業資料為 Grounding 的 Spatial AI與企業 Spatial AI 試點。有時候,正確拒絕比給出一個看似合理的推薦更準確。
Spatial AI 準確性評估重點
- 評估整條鏈: 意圖、grounding、資格判定、空間計算、排序、說明、操作與結果。
- 在模型之外核對事實: 地點身分、營業時間、庫存、權限與路線應由具權威性的系統管理。
- 納入困難案例: 模糊需求、過期資料、未授權需求,以及刻意設計成無解的需求。
- 各 gate 分開判定: 低風險層的高分不能抵銷權限失敗。
- 連回實際工作: 離線測試案例與正式環境結果回答的是不同問題,兩者都需要。
Spatial AI 準確性是什麼?
顧客可能會問:回家路線附近,哪一家門市還有某件商品,而且自己抵達時仍然營業?這一句話裡包含多個彼此獨立的問題:使用者真正需要什麼、哪些門市實際存在、庫存是否最新、營業時間是否涵蓋抵達時間、哪些分店真的可以由該路線到達、哪些商業規則會排除候選地點,以及剩下的候選地點應該如何排序與說明。最後一句話寫得再自然,也不代表每一個步驟都正確。評估必須把這些層拆開,因為地點解析錯誤不能靠重寫 ranking prompt 修正,過期庫存來源也不能靠更換語言模型解決。
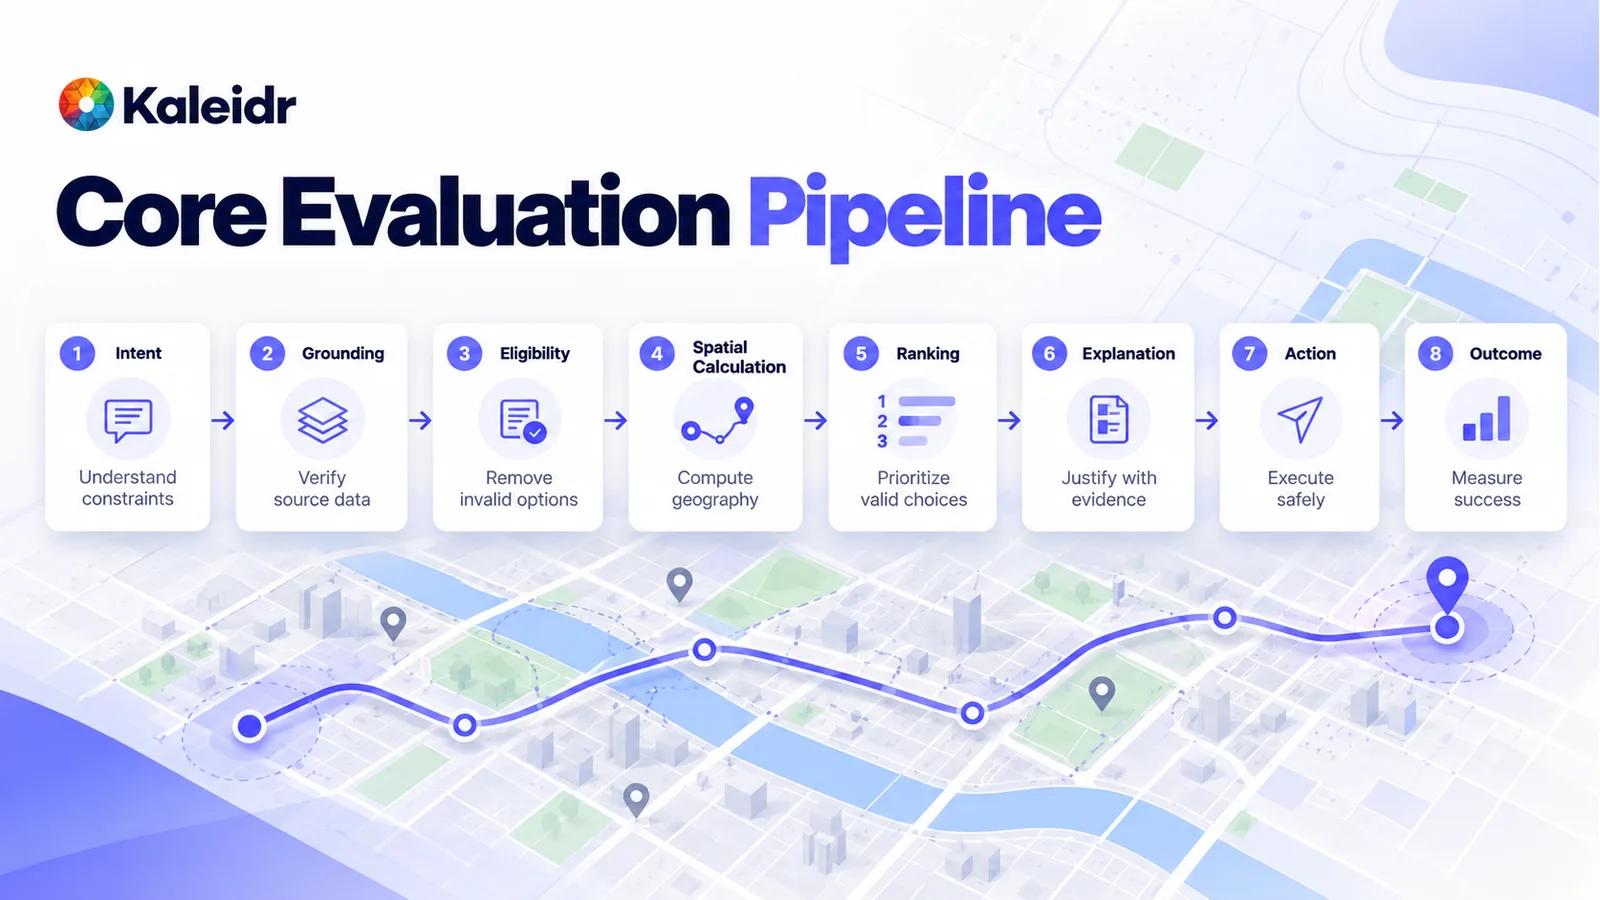
依序測試整條鏈:理解限制條件、驗證來源、移除無效選項、計算地理關係、排序剩餘候選項、以證據說明結果、只有在允許時才執行操作,最後衡量工作是否完成。
為什麼單一分數不夠?
整體百分比很容易比較,也很容易被誤用。示意 scorecard 可能顯示整體準確率 92%,但意圖辨識為 99%、路由為 98%、說明為 96%,授權卻只有 75%。這些數字只是示例,不是 Kaleidr 的實際結果。平均值仍可能看起來很好,但系統卻可能暴露使用者不該存取的資料,或根據這些資料執行操作。關鍵維度需要各自獨立的正式環境 gate。低風險工作上的優秀表現,不應抵銷權限失敗、無效目的地、不支援的操作或捏造的可用性。
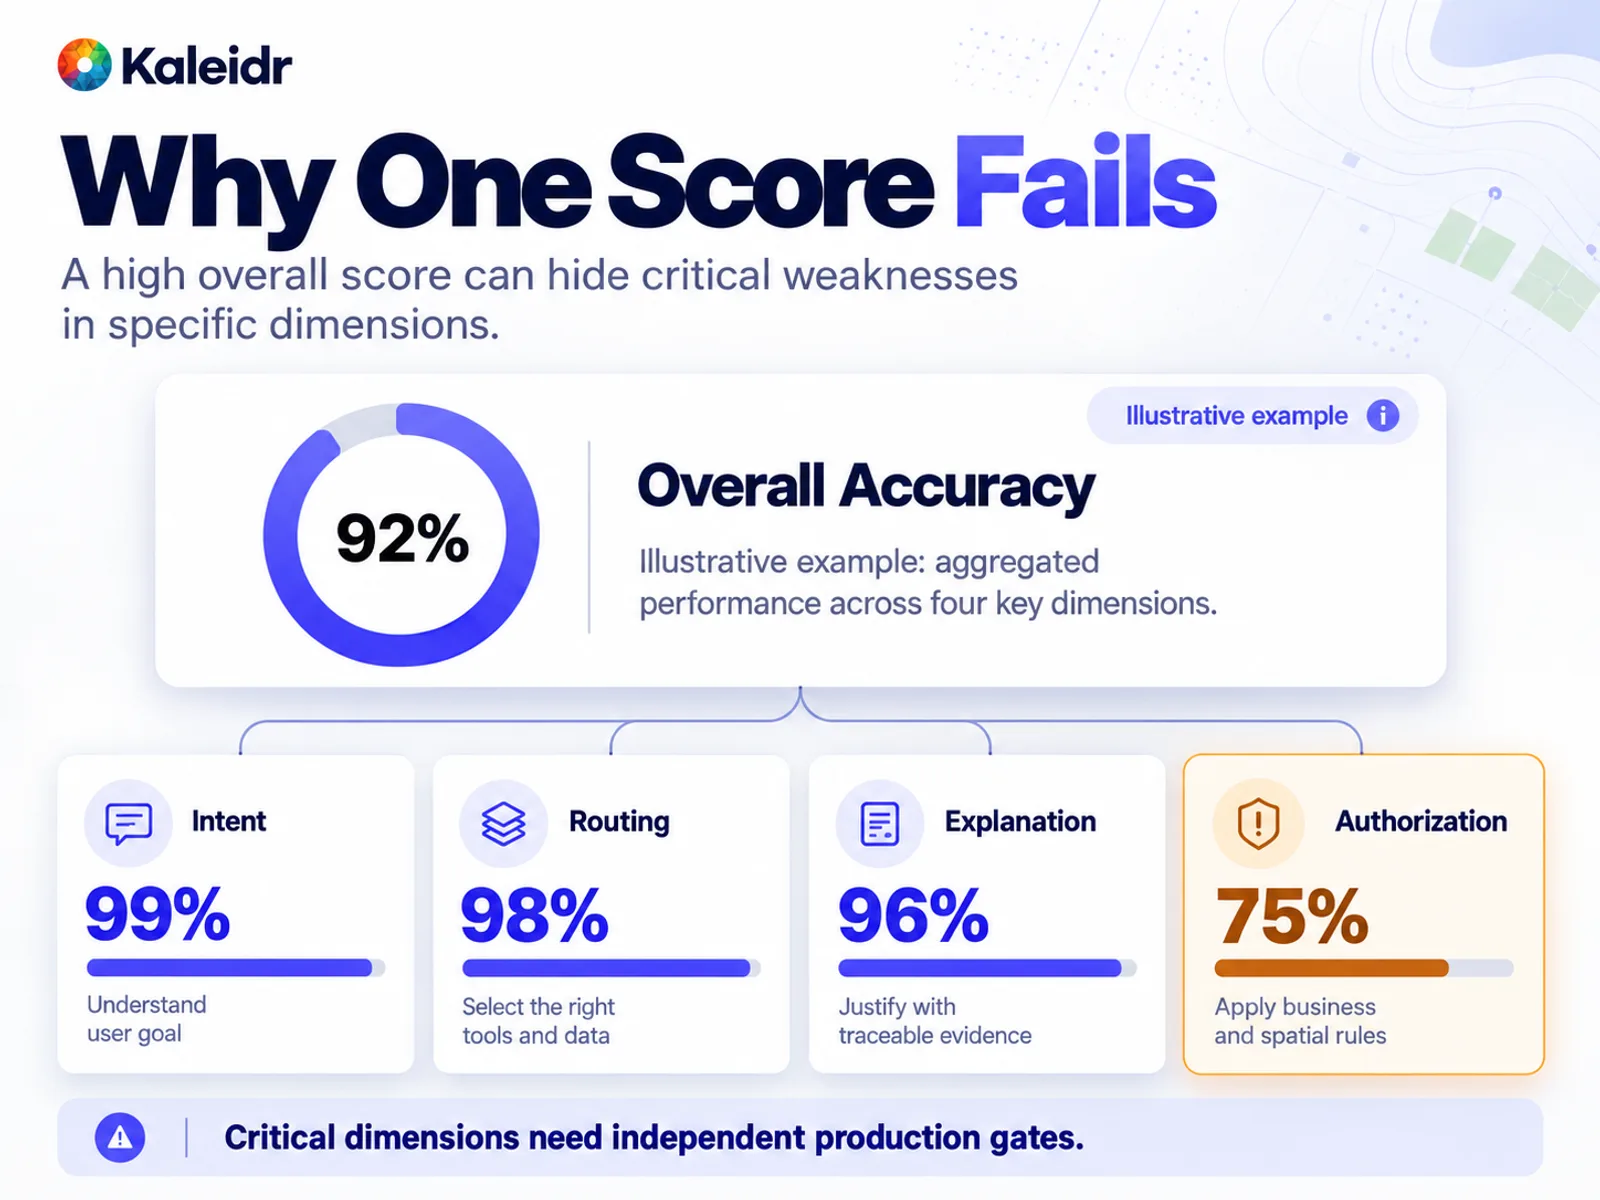
高整體分數可能掩蓋一個薄弱 gate。圖中的百分比只是說明用示例,並非 Kaleidr 實測表現。
NIST 的 AI Risk Management Framework playbook 指出,衡量應從最重要的風險開始,同時也應記錄哪些風險不會被衡量。同一頁也說明 AI RMF 1.0 正在更新,playbook 之後會再修訂 (NIST, 2026)。NIST 的 TEVV-Athlon framework 初始公開草案 NIST AI 200-2 於 2026 年 8 月 7 日公布,意見徵詢開放至 2026 年 10 月 6 日。該文件將評估描述為證明系統是否達到個人或組織目標的證據,並要求依實際需要客製化衡量方式,包括真實世界中的影響 (NIST, 2026)。這是一份公開徵詢意見的草案,不是 Kaleidr 的控制清單。對位置感知產品而言,真正相關的脈絡是產品實際做出的地理決策。
應該如何測試意圖、地點與資格?
首先是意圖。使用者要求找一間位於飯店與活動場地之間、輪椅可進入,而且早上 7 點前營業的咖啡店,並不等於「飯店附近的咖啡店」。對每一個測試查詢,都應保存預期的結構化理解:類別、地理關係、起點、目的地、無障礙需求與時間。接著衡量系統抽取了哪些限制、憑空新增了哪些限制,又漏掉了哪些限制。如果系統辨識出類別,卻忽略時間條件,就不能算正確理解任務。
地點語言本身具有歧義。Springfield、Terminal 2、Main Street,以及「我們在 Austin 的門市」都可能對應不只一個實體。測試集中應包含同名城市、相同分店名稱、多個航廈、改名地點、縮寫、多語名稱、沒有明確邊界的街區,以及位於行政邊界上的地址。評分應依據 canonical place ID,而不是名稱字串是否相同。選到隔一個街區的錯誤咖啡店,以及選到另一個城市的目的地,兩者都是錯誤,但嚴重程度不同。
資格判定回答的是「這個地點能不能列入候選」。排序回答的是「一個有效地點應該排多前面」。一間分店即使是最近的 pin,也可能已經關門、缺貨、位於服務範圍外、完全客滿,或因政策規定不能推薦。這些候選項應先從集合中移除,再對剩下的選項排序。資格 precision 是「回傳的合格地點數」除以「所有回傳地點數」。在高風險 workflow 中,少量不合格推薦造成的影響,可能比平均排序品質更重要。庫存、營業時間、權限與政策仍應留在擁有這些資料的系統中。以商業資料為 Grounding 的 Spatial AI對產品本身也畫出了相同邊界。
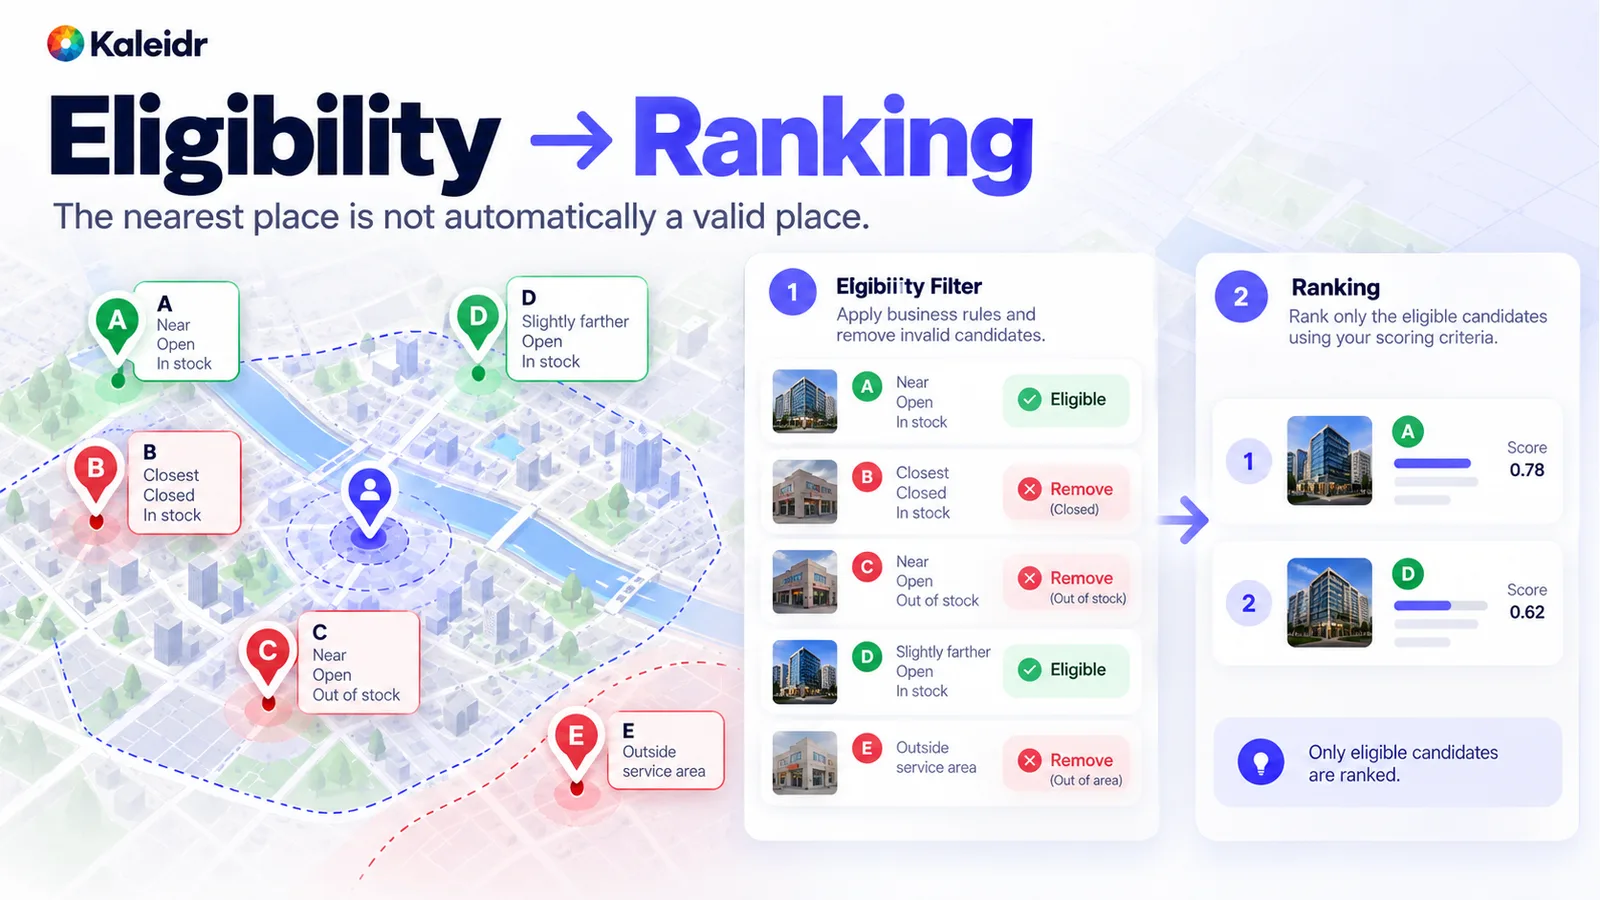
先過濾資格條件。最近的地點不代表它自動就是有效地點。
應該如何檢查地理計算與資料新鮮度?
如果空間引擎可以直接計算某個值,就不應讓語言模型成為該計算的 source of truth。point-in-polygon、路線距離、旅行時間、是否位於服務範圍內、空間包含關係,以及沿路線的順序,都屬於這一類。應使用權威地理資料與可信工具建立預期答案,再將應用程式結果與該答案比較。「這個點是否位於這個多邊形裡?」以及「系統是否回傳 branch ID 172?」適合使用精確比對。座標、預估旅行時間,以及不同解析度繪製的邊界,則適合使用事先宣告的容許誤差。不要在看到結果後才改口,說一個錯誤結果「其實已經夠接近」。
資料新鮮度與「過去是否曾經正確」是不同問題。座標與分店身分可能很穩定,但營業時間、庫存、交通與臨時關閉狀態會不斷改變。應追蹤有多少決策使用超出新鮮度門檻的資料,以及有多少時間敏感欄位具有已知更新時間。資料缺失不等於「無法取得」。如果狀態未知,系統卻有把握地回答「是」或「否」,即使地點本身確實存在,也屬於失敗。
什麼時候「沒有結果」才是準確答案?
顧客可能會要求一個 10 分鐘內可到、而且晚上 9 點後仍有某項商品的地點,但實際上根本不存在這樣的選項。較弱的系統會默默放寬條件,然後回傳一間 20 分鐘外的分店。grounded 系統則會清楚說明,沒有任何經過驗證的選項同時符合所有條件。benchmark 應納入刻意設計為無解的任務,並分別追蹤正確回傳「沒有結果」的比例,以及錯誤推薦率。2025 年的 GeoBenchX 是一個針對工具呼叫 agent 的多步驟地理空間 benchmark,同時包含可解與刻意無解的任務,因此可以衡量拒絕準確性 (Krechetova and Kochedykov, 2025)。該論文評估的是研究型 agent。GeoBenchX 並沒有對 Kaleidr 評分,產品團隊仍需要針對自己的工作設計專屬的無解案例。
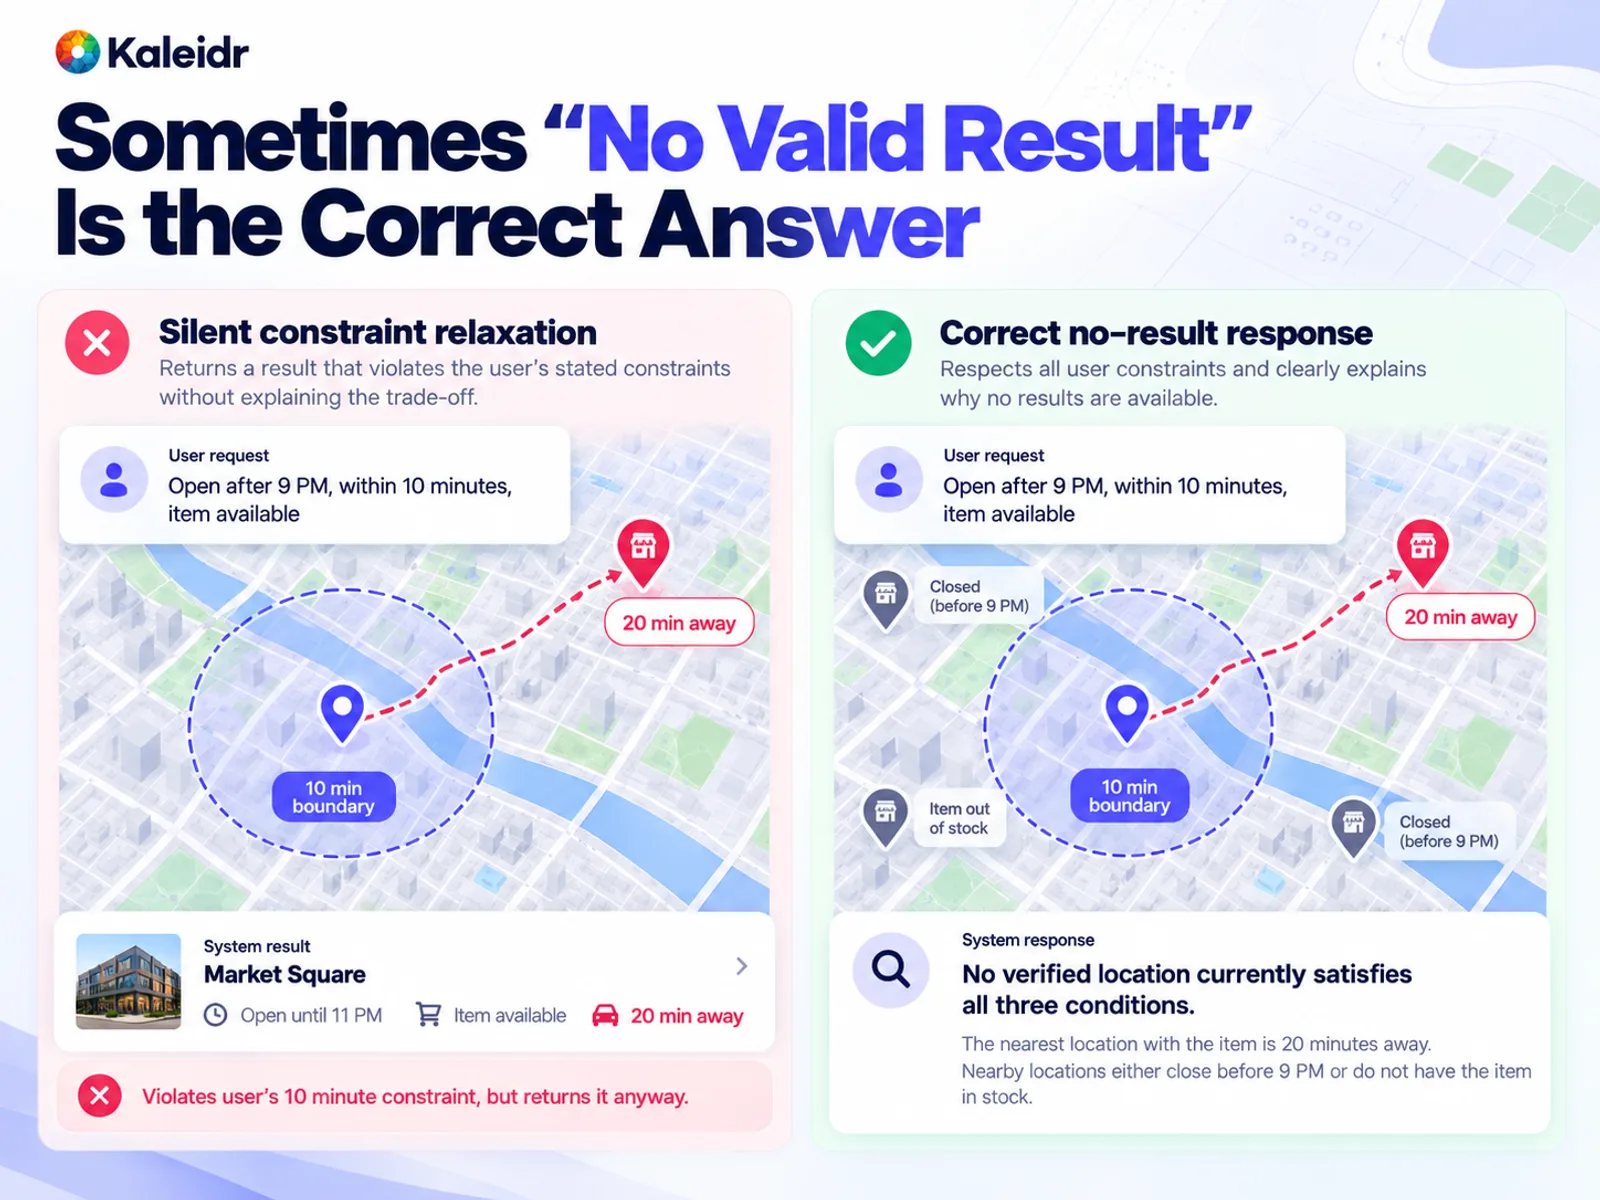
有時候,沒有有效結果本身就是正確答案。回傳超出指定時間或距離的地點,是錯誤推薦,不是有幫助的 fallback。
應該如何評分排序、說明與操作?
先移除無效候選項,再做排序。最近不一定最好。如果產品本身有這樣定義,旅行時間、路線偏離、可用性、無障礙條件、價格、營業時間區間與商業優先順序,都可以納入目標函數。實用指標包括:第一名結果有多少比例可接受、前 K 個結果中有多少比例至少包含一個可接受選項、與人工審查或政策排序的一致程度,以及相對於已知最佳合格選項的 regret。不要把 engagement 當成排序品質。排序結果應與顧客最後真正需要執行的操作連結。
像「營業到晚上 10 點、商品有貨、路線多 6 分鐘」這種說明,只有在每一句都可以追溯到系統實際使用過的證據時才算準確。應核對地點身分、庫存可用性、營業時間、是否真的計算過路線,以及文字是否與排序決策一致。文字寫得很漂亮也可能是錯的;短而不夠順的說法也可能是正確的。可以衡量說明中「已驗證的事實陳述」占「所有事實陳述」的比例。
操作本身也是答案的一部分。移動地圖、加入 marker、要求路線、更改 filter 或開始預訂,即使對應文字回答正確,也可能操作錯誤。應追蹤該操作是否屬於應用程式允許的 action vocabulary、目標與參數是否正確,以及使用者是否有權限執行。正確文字搭配錯誤地圖操作,仍然是一筆失敗互動。
benchmark 應該包含哪些失敗案例?
如果測試集只包含團隊已經知道如何解決的乾淨案例,就會高估可靠性。應納入模糊名稱、重複分店、位於服務範圍邊界的地址、無解需求、剛剛關門的門市、與地點不一致的庫存、距離很近但會讓路線大幅繞行的 pin、在抵達前就關門的店、使用者無權查看的私人設施、與英文名稱不同的在地名稱、未知營業時間、與 first-party 資料衝突的公開來源、企圖操控模型的檢索文字,以及中斷的 routing 或商業資料服務。目標是重現正式環境中真正會遇到的決策。
企圖操控模型的檢索文字屬於 prompt injection 案例。OWASP 將 LLM01:2025 Prompt Injection 描述為使用者輸入或檢索輸入以非預期方式改變模型行為的情況,包括對關鍵決策產生影響,並指出 retrieval-augmented generation 並不能完全消除這項弱點 (OWASP, 2025)。這類案例應與權限問題一起放入測試集的安全類別,而不是等到最後才當成安全附錄補上。
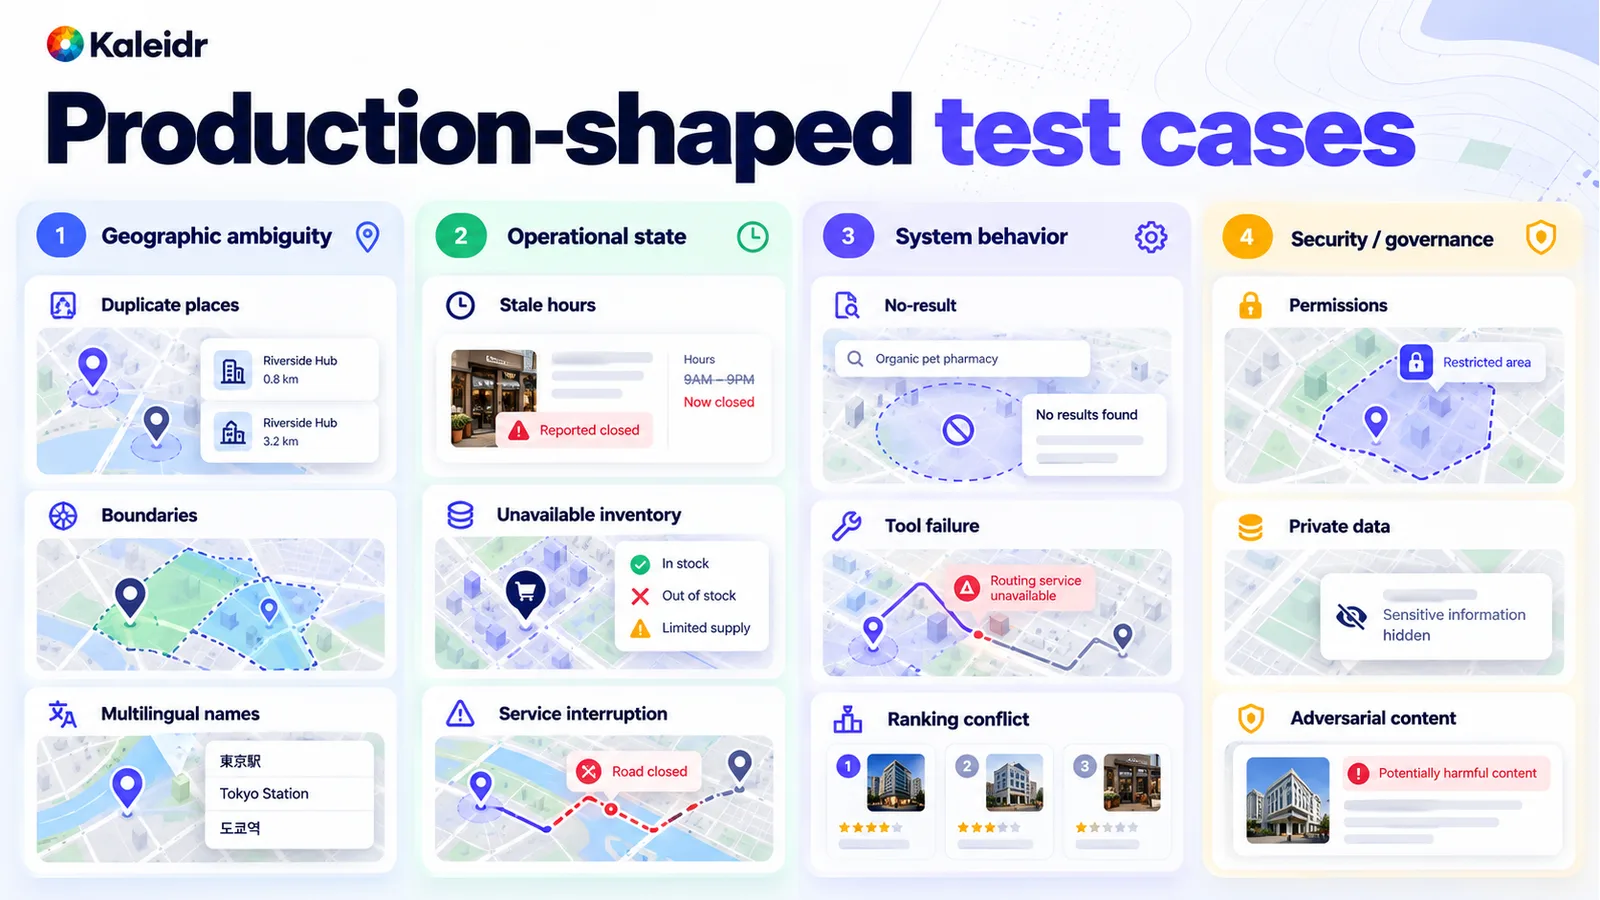
接近正式環境的案例應涵蓋地理歧義、營運狀態、系統行為與安全。缺少這些案例的 benchmark 會高估可靠性。
為什麼一定要在執行前定義 ground truth?
每一個測試案例都需要記錄足夠的真實資訊,才能明確定義「正確」是什麼:查詢、使用者情境、授權來源、預期意圖、必要限制、canonical 地點、合格候選集合、預期空間關係、最佳結果、可接受替代項、預期操作、「沒有結果」為什麼是正確答案、容許誤差,以及系統出錯時的嚴重程度。這些內容必須在系統執行前先寫好。看到模型輸出後再調整答案標準,不算評估。
GISAgentBench 是 2026 年發布、由實務工作整理出的 benchmark,包含 349 個多步驟 GIS 任務。該研究指出,許多 GIS agent benchmark 缺少 ground-truth 輸出,而改用程式碼相似度、trajectory matching 或 model judge 這類替代訊號,可能會把相似 workflow 誤認為正確結果。GISAgentBench 的每一個任務都包含精確的 ground-truth 輸出檔案 (Pothuri et al., 2026)。只要問題是 deterministic 的,就應使用程式碼或權威紀錄,例如座標、空間包含關係、canonical ID、營業或關閉狀態、權限,以及實際呼叫了哪一個 API action。只有真正主觀的問題,例如說明是否容易理解,才應交給人工審查或經過校準的模型輔助審查。評估方式必須與正在測試的 truth 類型一致。
團隊應該如何解讀分段結果?
平均值可能掩蓋某個地區的薄弱表現。應依國家、市場、語言、城市與鄉村涵蓋範圍、資料供應商、地點類別、分店密度、查詢複雜度與路線類型拆分結果。假設整體 valid-result rate 是 95%,但一個剛上線的市場只有 78%。這組數字只是假設示例,不是 Kaleidr 的量測結果。平均值在數學上可以正確,卻仍然可能是錯誤的擴張依據。應檢查錯誤發生在哪裡,再把每一個失敗案例分類為:解讀、entity resolution、grounding、資格判定、空間計算、新鮮度、排序、說明、操作、安全或復原。分類能告訴團隊應該修改哪一層。routing 錯誤不是說明問題。
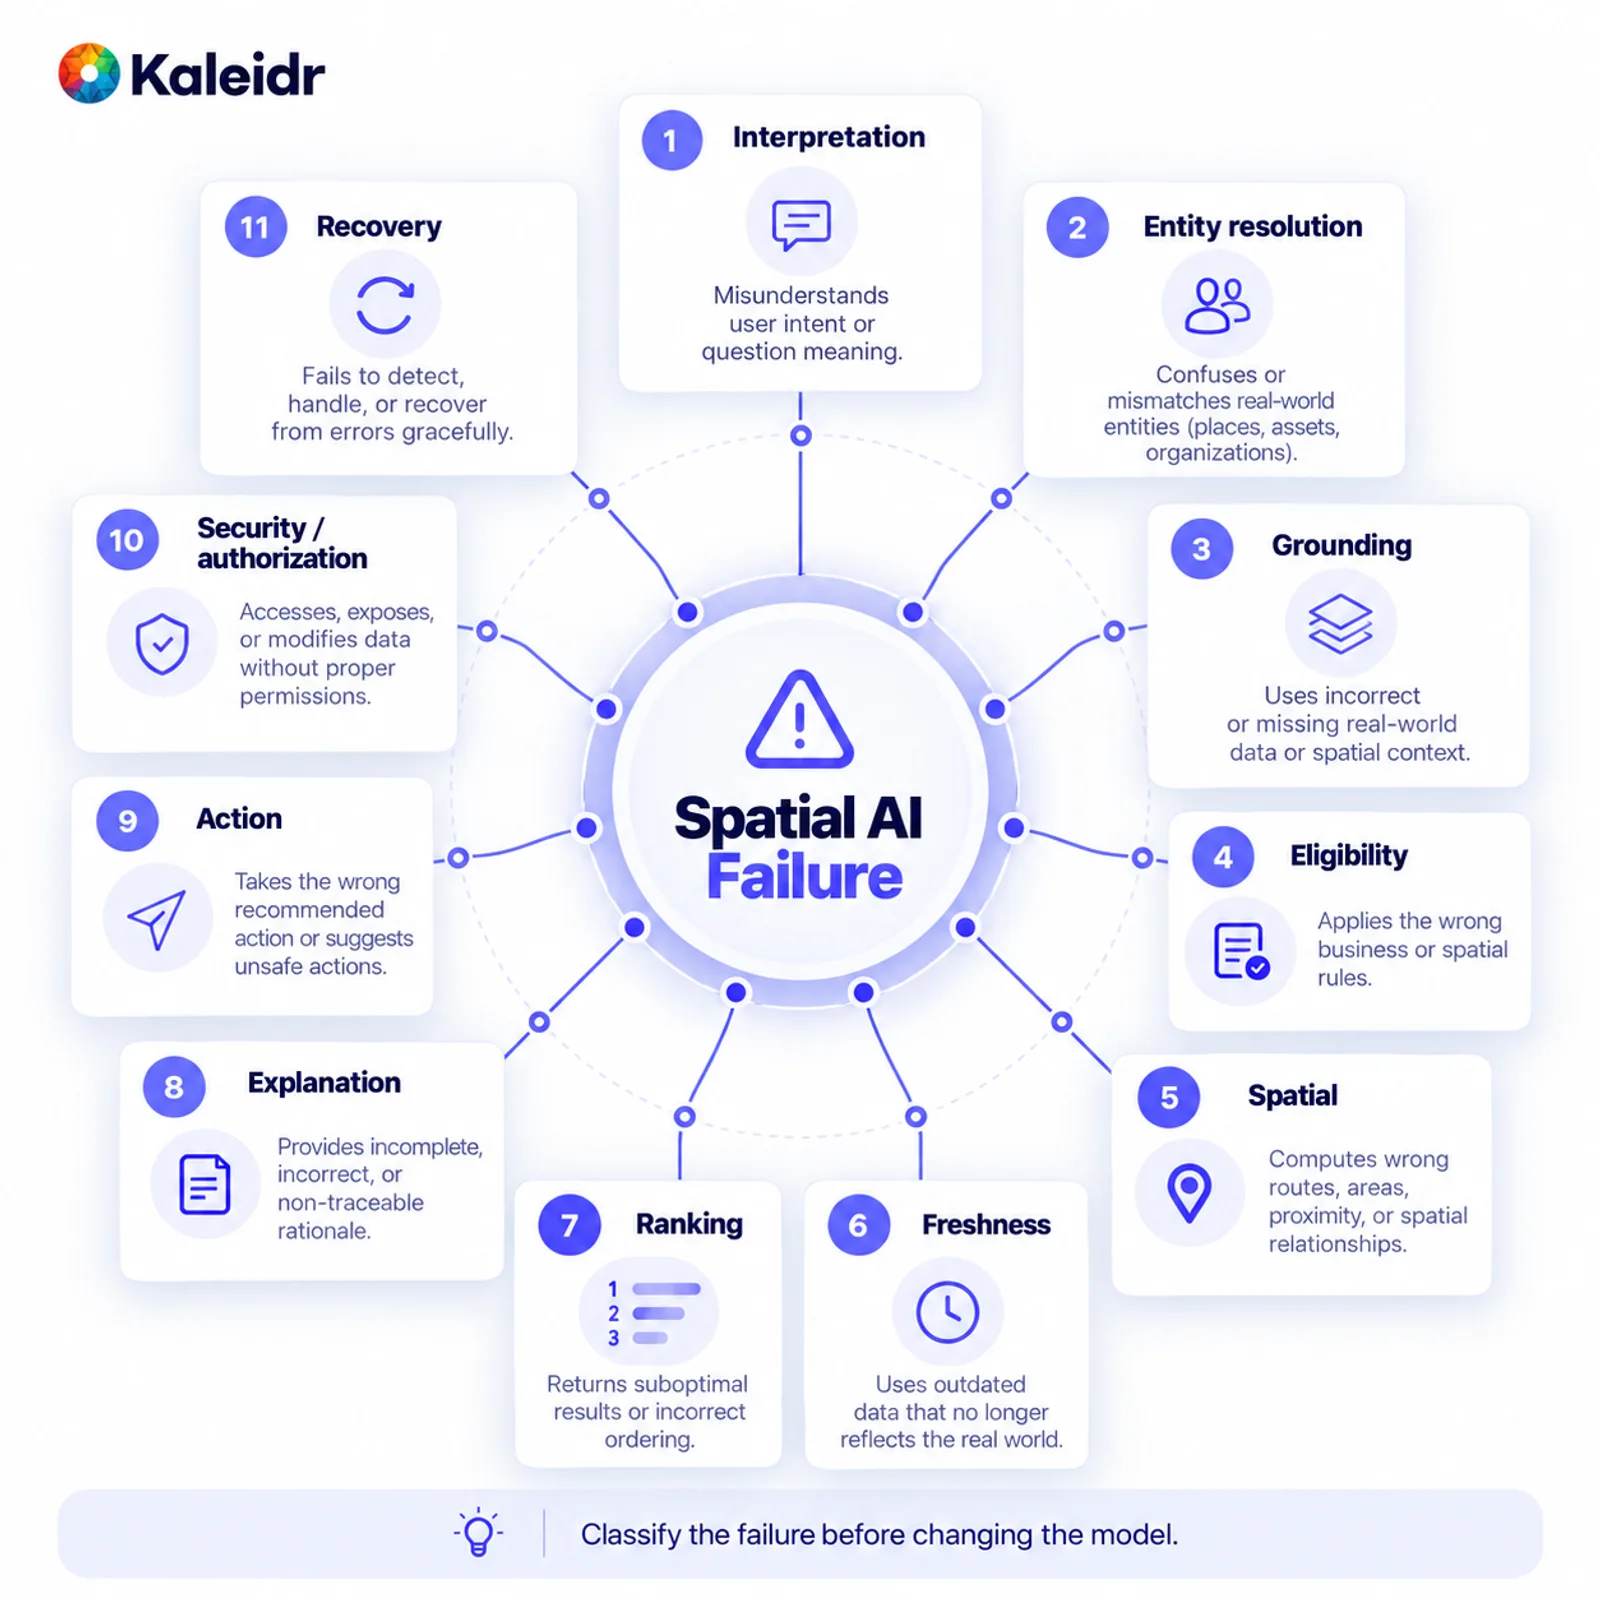
先分類失敗,再修改模型。分開的類別可以避免低頻但嚴重的錯誤被大型平均值掩蓋。
生成式系統的多次執行也會產生變動。對重要案例,應記錄平均值、觀察到的最差一次執行,以及失敗重複出現的頻率。一個查詢如果 9 次安全、1 次錯誤,和每一次都回傳相同安全答案的查詢,風險並不一樣。當 prompt、模型、retrieval、ranking、資料供應商、工具或涵蓋範圍改變時,都應重新執行測試集。評估應成為 release management 的一部分,而不是上線前的一次性報告。
正式環境 scorecard 應包含什麼?
每一個維度都應有自己的指標與自己的 gate。意圖可以使用 constraint extraction。地點身分可以使用 canonical-place accuracy。授權與安全可以使用 unauthorized-access rate,而且對受保護資料不容許任何未授權存取。資格判定、空間計算、新鮮度、排序、無結果處理、說明、操作與結果,也都需要各自的門檻,由產品負責人在執行前設定。不要從其他應用程式直接複製所謂通用 cutoff。一般餐廳推薦和具有安全後果的路由決策,並不共享相同的 error budget。
| 維度 | 指標示例 | gate 示例 |
|---|---|---|
| 意圖 | 限制條件抽取準確率 | 依此產品設定 |
| 地點身分 | canonical-place accuracy | 非常高 |
| 授權 | 未授權存取率 | 受保護資料不容許任何未授權存取 |
| 資格判定 | 合格結果 precision | 非常高 |
| 空間計算 | 在事先宣告的容許誤差內正確 | 依此產品設定 |
| 新鮮度 | 位於新鮮度窗口內的結果比例 | 依此產品設定 |
| 排序 | Top-1 或 Top-K acceptance | 依此產品設定 |
| 無結果處理 | 正確拒絕率 | 高 |
| 說明 | 有證據支持的陳述比例 | 高 |
| 操作 | 有效且參數正確的操作比例 | 非常高 |
| 結果 | 完成位置依賴工作 | 必須改善目標工作 |
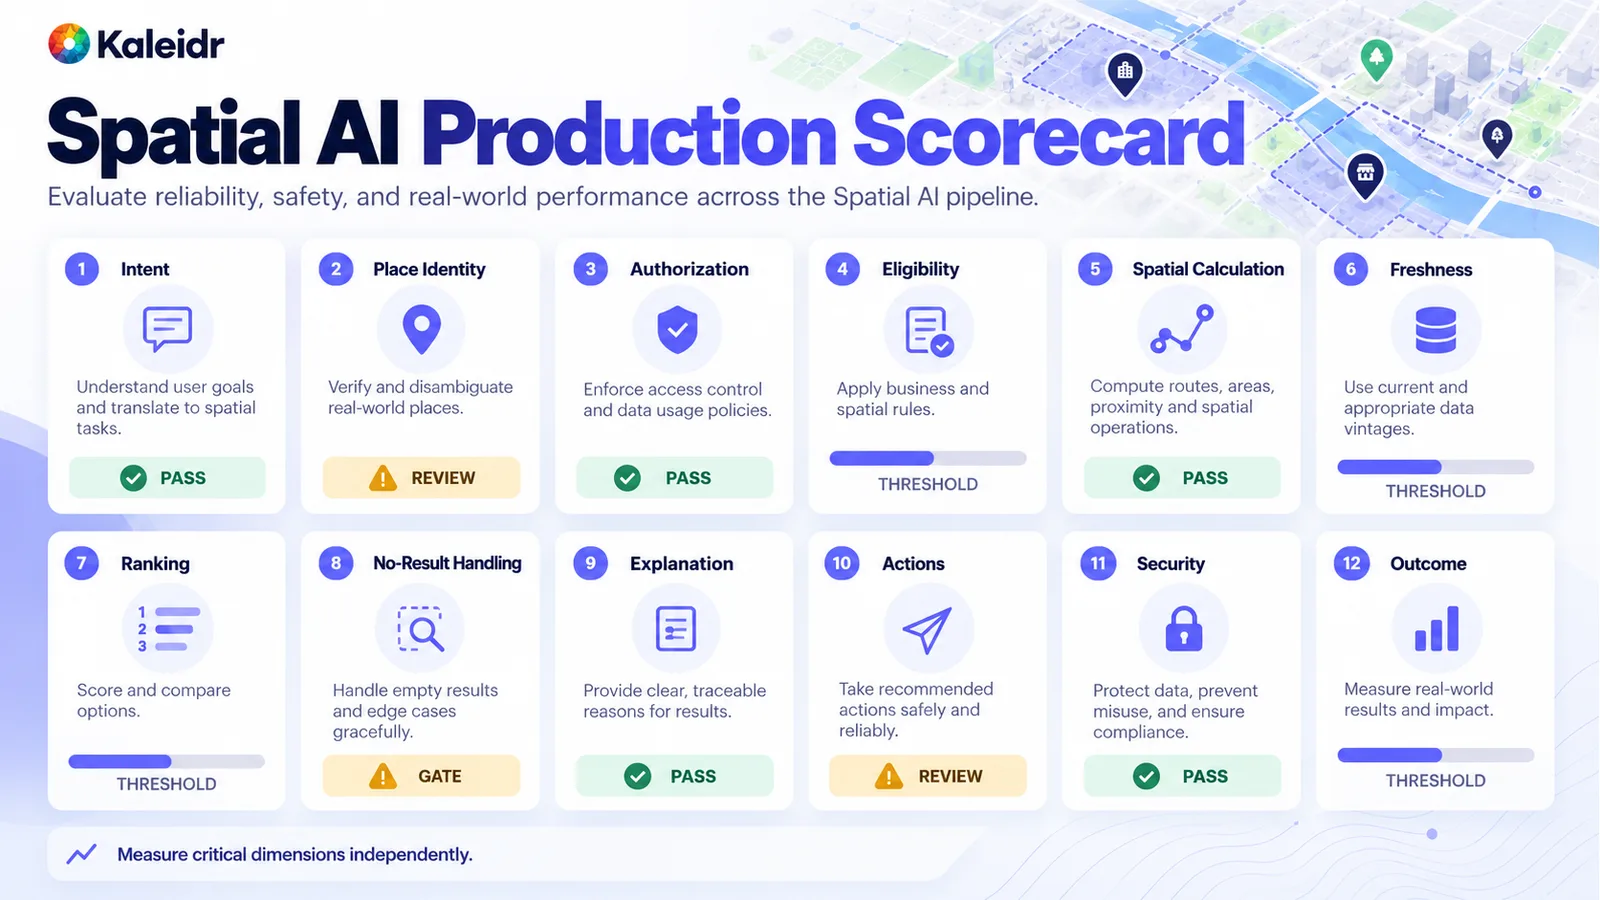
關鍵維度要獨立衡量。這個 scorecard 上的狀態標籤只是 placeholder,不是 Kaleidr benchmark 分數。
團隊應該如何決定是否擴大規模?
使用各自的 gate,而不是一個混合總分。當有效、grounded 且空間上正確的結果在接近正式環境的條件下仍然穩定、關鍵錯誤類別受到控制、有人明確負責營運資料,而且目標結果確實改善時,再擴大規模。如果工作本身有價值,但某個可修正的層仍然薄弱,就繼續迭代。如果試點混合太多地理區域、資料來源或工作,導致無法判斷是哪裡失敗,就縮小範圍。如果團隊無法指出權威資料、無法控制關鍵失敗、無法定義工作,或無法證明比現有 workflow 更好,就應停止。企業 Spatial AI 試點是一個有限範圍的測試,而 scorecard 則把這項測試轉成決策。
Kaleidr 在評估架構中扮演什麼角色?
Kaleidr Enterprise 將自身描述為 location-intelligence infrastructure,包含 inference API、ranking system、analytics 與 deployment support,也提供 chat、editing、tiles 與可嵌入 viewer,讓 host 能在現有地圖旁加入這些能力 (Kaleidr, 2026)。host 應用程式仍保有自己擁有的商業系統,包括庫存、權限、顧客狀態、預訂與其他私有營運紀錄。空間工具負責可以計算的操作。語言模型層負責解讀意圖、協調支援的能力,並說明 grounded 結果。Kaleidr 的公開 Analytics 頁面 Map Engagement and Location Analytics 描述 reach、views、engagement、受眾位置與活動、每張地圖的 sessions 與 interactions、地點比較,以及空間模式 (Kaleidr, 2026)。這些報告描述的是地圖與地點行為。完成的預訂、訂單與 qualified lead,仍留在記錄這些結果的 host 系統中。
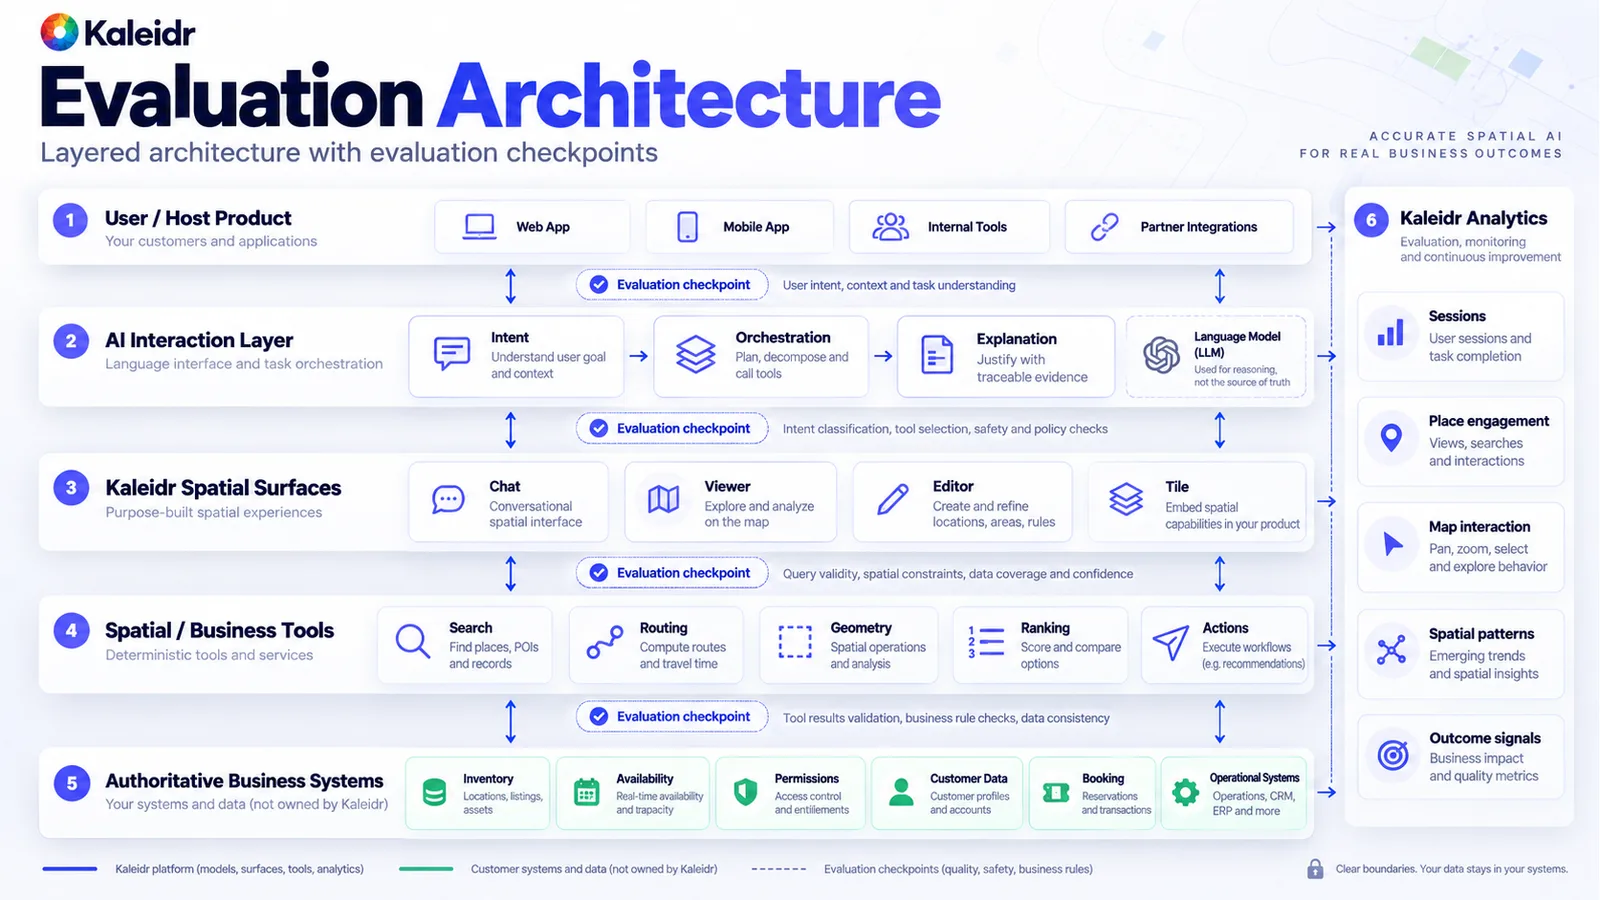
語言模型不是庫存、權限或路線的 source of truth。各層之間的 checkpoint 能協助定位究竟是哪一部分失敗。
哪些錯誤會掩蓋一個薄弱的 benchmark?
如果只測試沒有歧義、沒有缺漏資料、也沒有無解需求的 happy path,就會高估可靠性。只看答案措辭與參考答案有多相似,會漏掉「表達不同但決策正確」的結果,也可能獎勵「地點錯誤但文字風格像參考答案」的結果。對仍包含不合格地點的集合進行排序,會掩蓋資格判定錯誤。讓模型去判斷空間引擎本來可以直接計算的距離,就是用語言流暢度取代計算。忽略新鮮度,就是把昨天的營業時間當成今天的。把更多地圖互動當成準確性,會混淆興趣、成功,有時甚至是困惑。看到結果後才修改容許誤差,就不再是 benchmark。只測模型本身,也會忽略 retrieval、資料、工具、權限、ranking 與 interface。正式環境行為來自完整組裝後的產品。
研究 benchmark 仍可作為能力探針。GeoBenchLLM 於 2026 年 8 月投稿並獲 CIKM 2026 接受,使用公開 datasets 中的 geo-related task 評估語言模型,包括地理空間與時間理解 (Rodrigues et al., 2026)。GeoAI benchmark 常涵蓋遙測、GIS workflow、影像或地理空間模型任務。但產品 benchmark 可能還需要商業資料 grounding、權限、即時可用性、排序、地圖操作與顧客結果。一個公開 benchmark 無法取代每一個產品自己的實際工作。
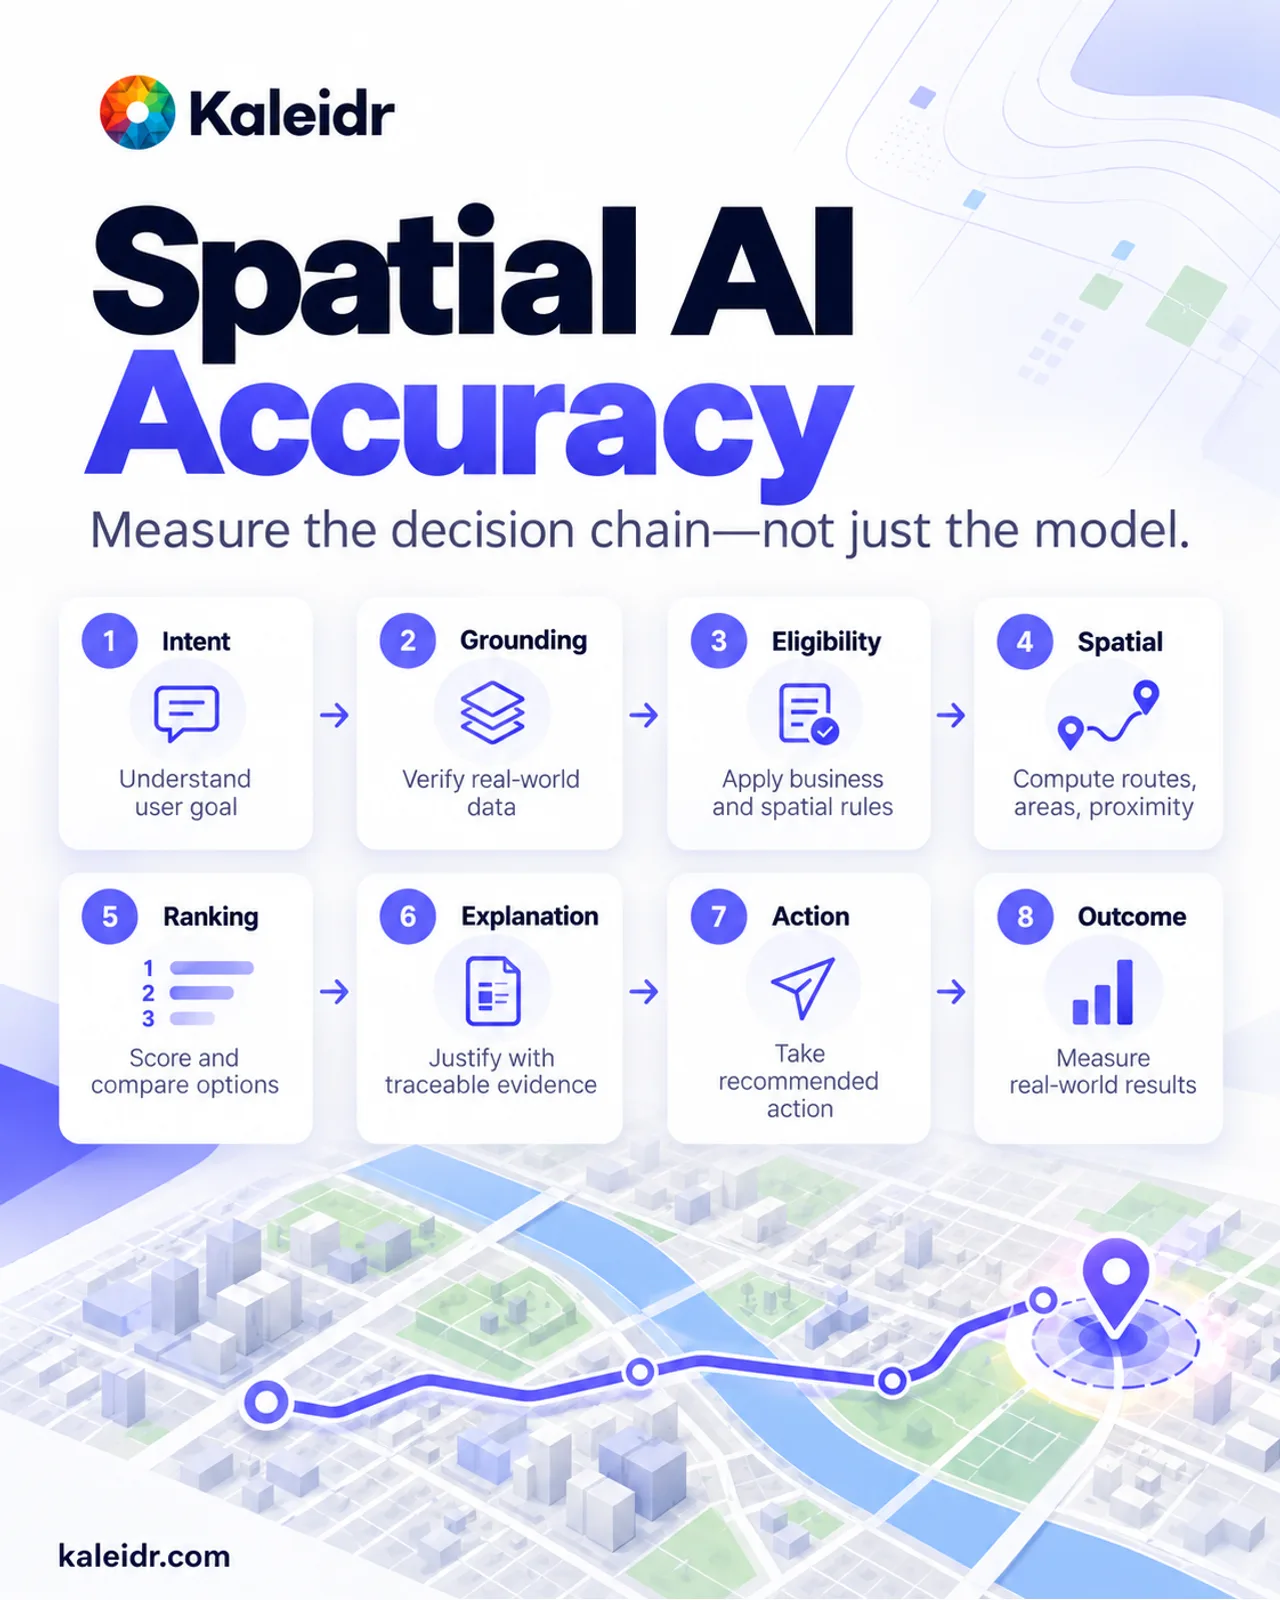
衡量的是決策鏈,而不只是模型。八個階段是評估架構,不是公布的分數。
如何讓評估成為 release gate?
在擴大規模前先建立測試集,並納入失敗案例。對於能由工具或紀錄回答的 deterministic truth,應把它放在語言模型之外。關鍵維度要用各自的 gate 追蹤。系統改變後重新執行評估,並把離線結果連回原本應改善的正式環境結果。真正有用的問題是:這個系統能不能使用正確的資料、地理、權限與操作,完成產品承諾的位置依賴決策?團隊能不能證明這件事?
查看 Kaleidr Enterprise,了解如何在產品現有系統旁加入位置感知 AI,並定義一個聚焦的試點。查看 Kaleidr Analytics,了解受眾如何使用該試點中的地圖與地點。商業結果以及是否擴大規模的決定,仍然由 host 負責。
常見問題
如何衡量 Spatial AI 準確性?
衡量位置決策的每一個階段:意圖、地點解析、授權、資格判定、地理計算、新鮮度、排序、說明、操作,以及使用者或商業結果。不要把整條鏈壓縮成單一模型分數。
這跟語言模型準確率一樣嗎?
不一樣。語言模型只是一個元件。地點資料庫、商業紀錄、空間引擎、routing、ranking、權限與應用程式狀態,都可能影響最終結果是否正確。
語言模型應該計算距離嗎?
當產品需要距離或移動關係時,應使用地理工具或 routing tool。模型可以判斷何時需要計算,也可以說明結果,但實際計算應由空間服務執行。
benchmark 應該包含不可能的問題嗎?
應該。刻意設計成無解的任務可以檢查系統是否會回傳 grounded 的「沒有結果」,而不是憑空捏造地點或默默丟掉某個限制條件。
評估應該多久執行一次?
在正式上線前執行,之後只要模型、prompt、資料供應商、ranking、空間工具、權限或涵蓋範圍改變,就要再次執行。正式環境行為需要持續監控。上線當天的一份報告,並不等於完整的 release process。
一個 benchmark 能比較所有系統嗎?
研究 benchmark 可以比較一項明確定義的能力。正式環境評估必須反映該應用程式自己的地理工作、資料、風險、工具與結果。GeoAI benchmark 與產品 benchmark 不能互相替代。
參考資料
- National Institute of Standards and Technology. AI RMF Playbook, Measure. Notes that the AI RMF 1.0 is being updated and that the playbook will be revised afterward. Accessed September 29, 2026. https://airc.nist.gov/airmf-resources/playbook/measure/
- National Institute of Standards and Technology. The TEVV-Athlon Framework for Evaluating AI Systems. NIST AI 200-2, initial public draft. Announced August 7, 2026; comments through October 6, 2026. https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems
- Krechetova, Varvara, and Denis Kochedykov. GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks. arXiv:2503.18129, submitted March 23, 2025, revised October 22, 2025. https://arxiv.org/abs/2503.18129
- Pothuri, Abhinav, Zhe Jiang, Zelin Xu, and Di Yang. GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks. arXiv:2608.01645, submitted August 3, 2026. https://arxiv.org/abs/2608.01645
- Rodrigues, Rodrigo Ferreira, Karim Radouane, Jose G. Moreno, and Lynda Tamine. GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks. arXiv:2608.07411, submitted August 7, 2026. Accepted at CIKM 2026. https://arxiv.org/abs/2608.07411
- OWASP Gen AI Security Project. LLM01:2025 Prompt Injection. Accessed September 29, 2026. https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed September 29, 2026. https://kaleidr.com/enterprise
- Kaleidr. Map Engagement and Location Analytics. Accessed September 29, 2026. https://kaleidr.com/analytics
- Kaleidr. Grounded Spatial AI for Business Data. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- Kaleidr. An Enterprise Spatial AI Pilot Before Scaling. https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling
@misc{nist_rmf_playbook_measure_2026,
  title  = {AI RMF Playbook, Measure},
  author = {{National Institute of Standards and Technology}},
  year   = {2026},
  note   = {Accessed September 29, 2026. Page states the playbook will be updated after the AI RMF revision},
  url    = {https://airc.nist.gov/airmf-resources/playbook/measure/}
}

@techreport{nist_ai_200_2_2026,
  title       = {The TEVV-Athlon Framework for Evaluating AI Systems},
  author      = {{National Institute of Standards and Technology}},
  institution = {National Institute of Standards and Technology},
  number      = {NIST AI 200-2},
  year        = {2026},
  note        = {Initial public draft, announced August 7, 2026},
  url         = {https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems}
}

@misc{krechetova_geobenchx_2025,
  title  = {GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks},
  author = {Krechetova, Varvara and Kochedykov, Denis},
  year   = {2025},
  note   = {arXiv:2503.18129, revised October 22, 2025},
  url    = {https://arxiv.org/abs/2503.18129}
}

@misc{pothuri_gisagentbench_2026,
  title  = {GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks},
  author = {Pothuri, Abhinav and Jiang, Zhe and Xu, Zelin and Yang, Di},
  year   = {2026},
  note   = {arXiv:2608.01645, submitted August 3, 2026},
  url    = {https://arxiv.org/abs/2608.01645}
}

@misc{rodrigues_geobenchllm_2026,
  title  = {GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks},
  author = {Rodrigues, Rodrigo Ferreira and Radouane, Karim and Moreno, Jose G. and Tamine, Lynda},
  year   = {2026},
  note   = {arXiv:2608.07411, submitted August 7, 2026, accepted at CIKM 2026},
  url    = {https://arxiv.org/abs/2608.07411}
}

@misc{owasp_llm01_2025,
  title  = {LLM01:2025 Prompt Injection},
  author = {{OWASP Gen AI Security Project}},
  year   = {2025},
  note   = {Accessed September 29, 2026},
  url    = {https://genai.owasp.org/llmrisk/llm01-prompt-injection/}
}

@misc{kaleidr_enterprise_accuracy_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_analytics_accuracy_2026,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/analytics}
}