
La précision de Spatial AI mesure si un système sensible à la localisation interprète correctement la demande, identifie les bons lieux, utilise des données actuelles et autorisées, calcule correctement la géographie, classe uniquement les options éligibles, explique les éléments de preuve et n’exécute que des actions valides. Une réponse fluide peut malgré tout envoyer quelqu’un vers la mauvaise agence. Un score unique du modèle ne peut pas montrer tout cela. Le benchmark doit tester, avant la production, le travail que le produit promet d’accomplir.
Les sections ci-dessous séparent la chaîne de décision, les portes qu’une moyenne peut masquer, les cas d’échec qu’il vaut mieux construire à l’avance et la frontière entre benchmarks de recherche et évaluation produit. Pour aller plus loin, consultez Spatial AI fondée sur les données métier et Un pilote Spatial AI d’entreprise. Un refus correct peut être plus précis qu’une recommandation plausible.
Principes essentiels de la précision de Spatial AI
- Évaluer toute la chaîne : intention, grounding, éligibilité, calcul spatial, classement, explication, action et résultat.
- Vérifier les faits hors du modèle : identité des lieux, horaires, inventaire, autorisations et itinéraires appartiennent aux systèmes de référence.
- Inclure les cas difficiles : demandes ambiguës, obsolètes, non autorisées et volontairement insolubles.
- Garder les portes séparées : un score élevé sur une couche à faible risque ne doit pas compenser un échec d’autorisation.
- Relier l’évaluation au travail réel : les cas hors ligne et les résultats en production répondent à des questions différentes. Les deux sont nécessaires.
Que signifie la précision de Spatial AI ?
Un client peut demander quel magasin situé près de son trajet de retour a encore un article en stock et sera ouvert à son arrivée. Cette phrase contient plusieurs problèmes indépendants : ce que la personne veut, quels magasins existent, si l’inventaire est à jour, si les horaires correspondent à l’heure d’arrivée, quelles agences sont réellement accessibles depuis l’itinéraire, quelles règles métier éliminent un candidat et comment classer et expliquer les options restantes. Une phrase finale bien formulée ne prouve pas que chaque étape est correcte. L’évaluation doit séparer les couches, car une erreur de résolution de lieu ne se corrige pas en réécrivant un prompt de classement, et un flux d’inventaire obsolète ne se corrige pas en changeant de modèle de langage.
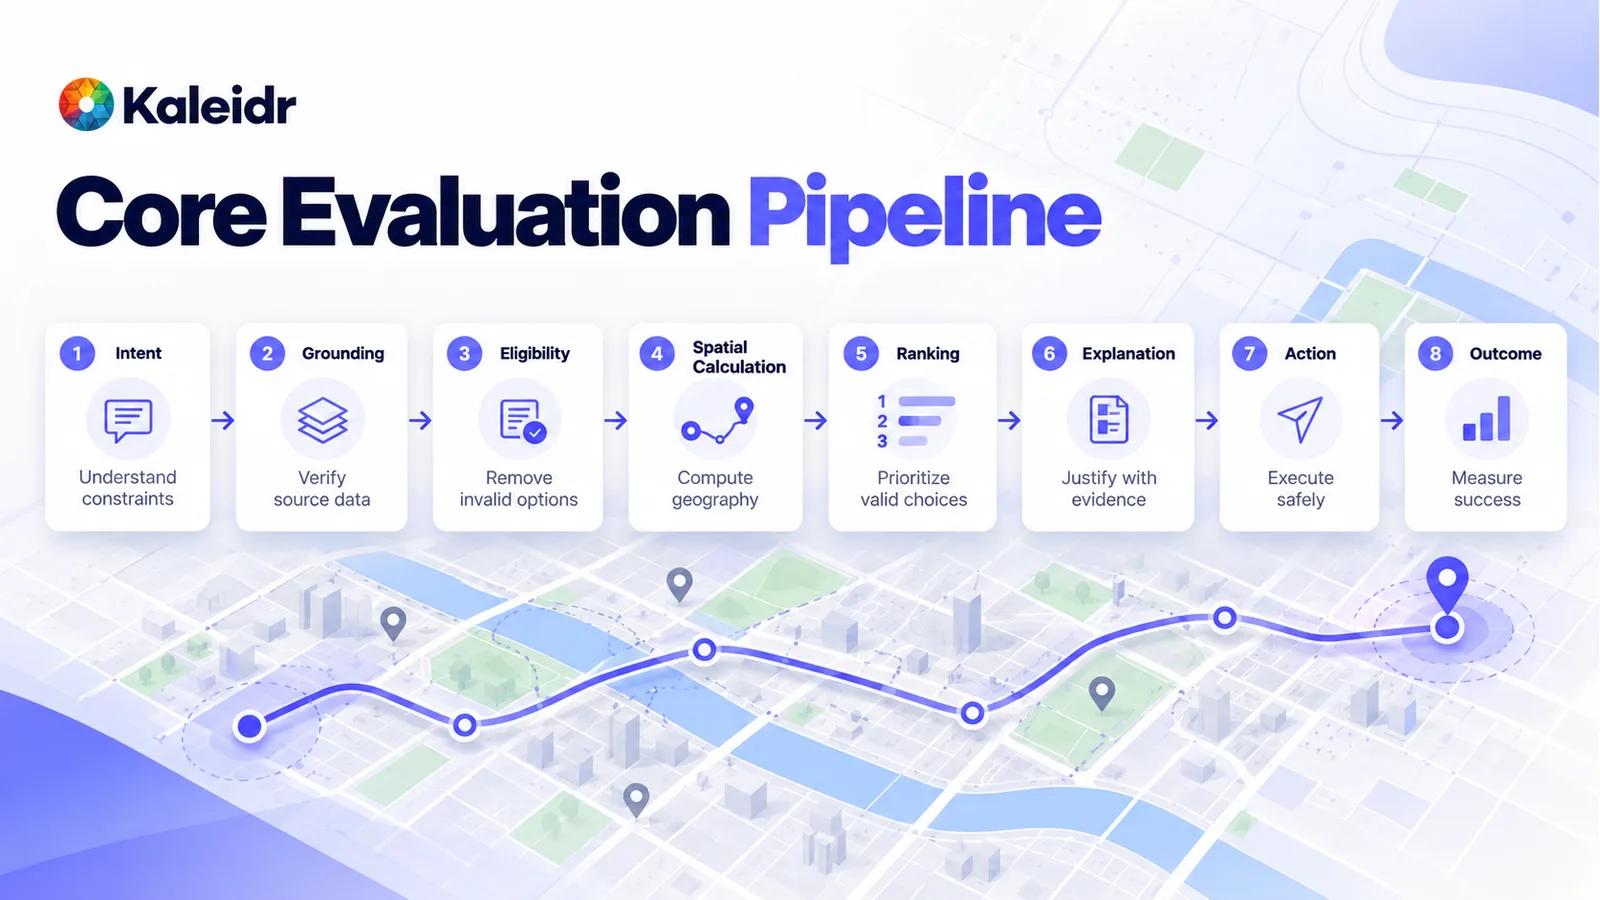
Testez la chaîne dans l’ordre : comprendre les contraintes, vérifier la source, éliminer les options non valides, calculer la géographie, classer ce qui reste, justifier avec des preuves, agir uniquement lorsque l’action est autorisée et mesurer si le travail a été accompli.
Pourquoi un seul score ne suffit-il pas ?
Un pourcentage global est facile à comparer et facile à mal utiliser. Une scorecard illustrative peut afficher 92 % au total, alors que l’intention est à 99 %, le routage à 98 %, l’explication à 96 % et l’autorisation à 75 %. Ces chiffres sont un exemple, pas un résultat Kaleidr. La moyenne peut rester flatteuse alors que le système expose ou utilise des données auxquelles la personne ne devrait pas avoir accès. Les dimensions critiques ont besoin de leurs propres portes de production. D’excellentes performances sur une tâche à faible risque ne doivent pas compenser un échec d’autorisation, une destination invalide, une action non prise en charge ou une disponibilité inventée.
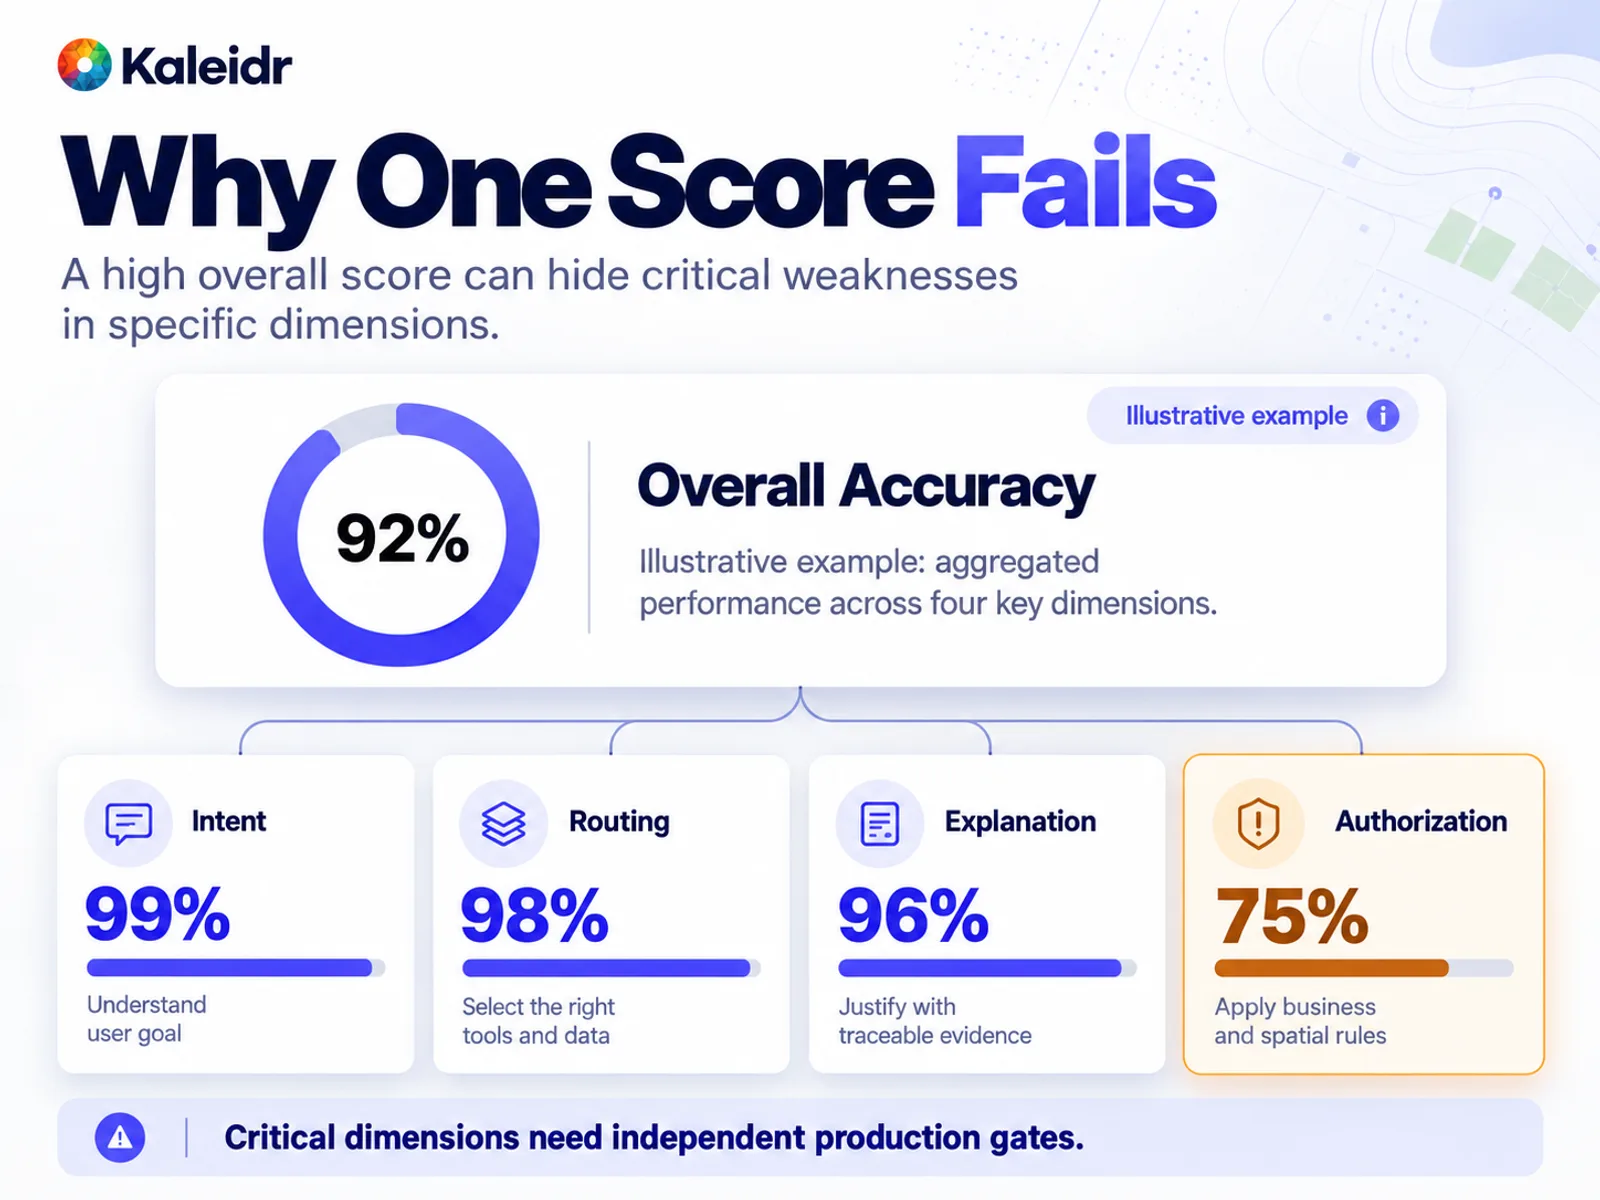
Un score global élevé peut masquer une porte faible. Les pourcentages de cette figure sont un exemple illustratif et non des performances Kaleidr mesurées.
Le playbook du NIST AI Risk Management Framework indique que la mesure doit commencer par les risques les plus importants et que les risques qui ne seront pas mesurés doivent être documentés. La même page précise que l’AI RMF 1.0 est en cours de mise à jour et que le playbook sera révisé ensuite (NIST, 2026). Le projet public initial du cadre TEVV-Athlon du NIST, NIST AI 200-2, annoncé le 7 août 2026 avec une période de commentaires ouverte jusqu’au 6 octobre 2026, décrit l’évaluation comme la preuve qu’un système atteint des objectifs individuels ou organisationnels grâce à des mesures adaptées à ces besoins, y compris l’impact réel (NIST, 2026). Le document est un projet soumis à commentaires. Ce n’est pas une liste de contrôles Kaleidr. Pour un produit sensible à la localisation, le contexte pertinent est la décision géographique que le produit prend réellement.
Comment tester l’intention, le lieu et l’éligibilité ?
L’intention vient en premier. Une demande de café accessible en fauteuil roulant entre un hôtel et un lieu d’événement, ouvert avant 7 h, ne signifie pas « cafés près de l’hôtel ». Enregistrez pour chaque requête de test l’interprétation structurée attendue : catégorie, relation géographique, origine, destination, accessibilité et heure. Mesurez ensuite l’extraction des contraintes, les contraintes inventées par le système et celles qu’il a omises. Un système qui reconnaît la catégorie mais ignore la fenêtre horaire n’a pas correctement interprété la tâche.
Le langage des lieux est ambigu. Springfield, Terminal 2, Main Street et « notre magasin d’Austin » peuvent chacun désigner plusieurs entités. Incluez des villes homonymes, des noms d’agences identiques, plusieurs terminaux, des lieux renommés, des abréviations, des noms multilingues, des quartiers sans limite nette et des adresses situées sur une frontière administrative. Évaluez les identifiants canoniques des lieux, pas une simple correspondance de chaîne sur le nom. Le mauvais café à un pâté de maisons et une destination dans la mauvaise ville sont tous deux incorrects, mais leur gravité n’est pas la même.
L’éligibilité demande si un lieu peut être pris en compte. Le classement demande à quelle position un lieu valide doit apparaître. Une agence peut être le point le plus proche tout en étant fermée, en rupture de stock, hors zone de service, complète ou interdite par une règle. Ces candidats doivent sortir de l’ensemble avant de classer ce qui reste. La précision d’éligibilité correspond au nombre de lieux éligibles renvoyés divisé par l’ensemble des lieux renvoyés. Dans un workflow à haut risque, quelques recommandations non éligibles peuvent compter davantage que la qualité moyenne du classement. Inventaire, horaires, autorisations et politiques restent dans les systèmes qui en sont propriétaires. Spatial AI fondée sur les données métier trace la même limite pour le produit lui-même.
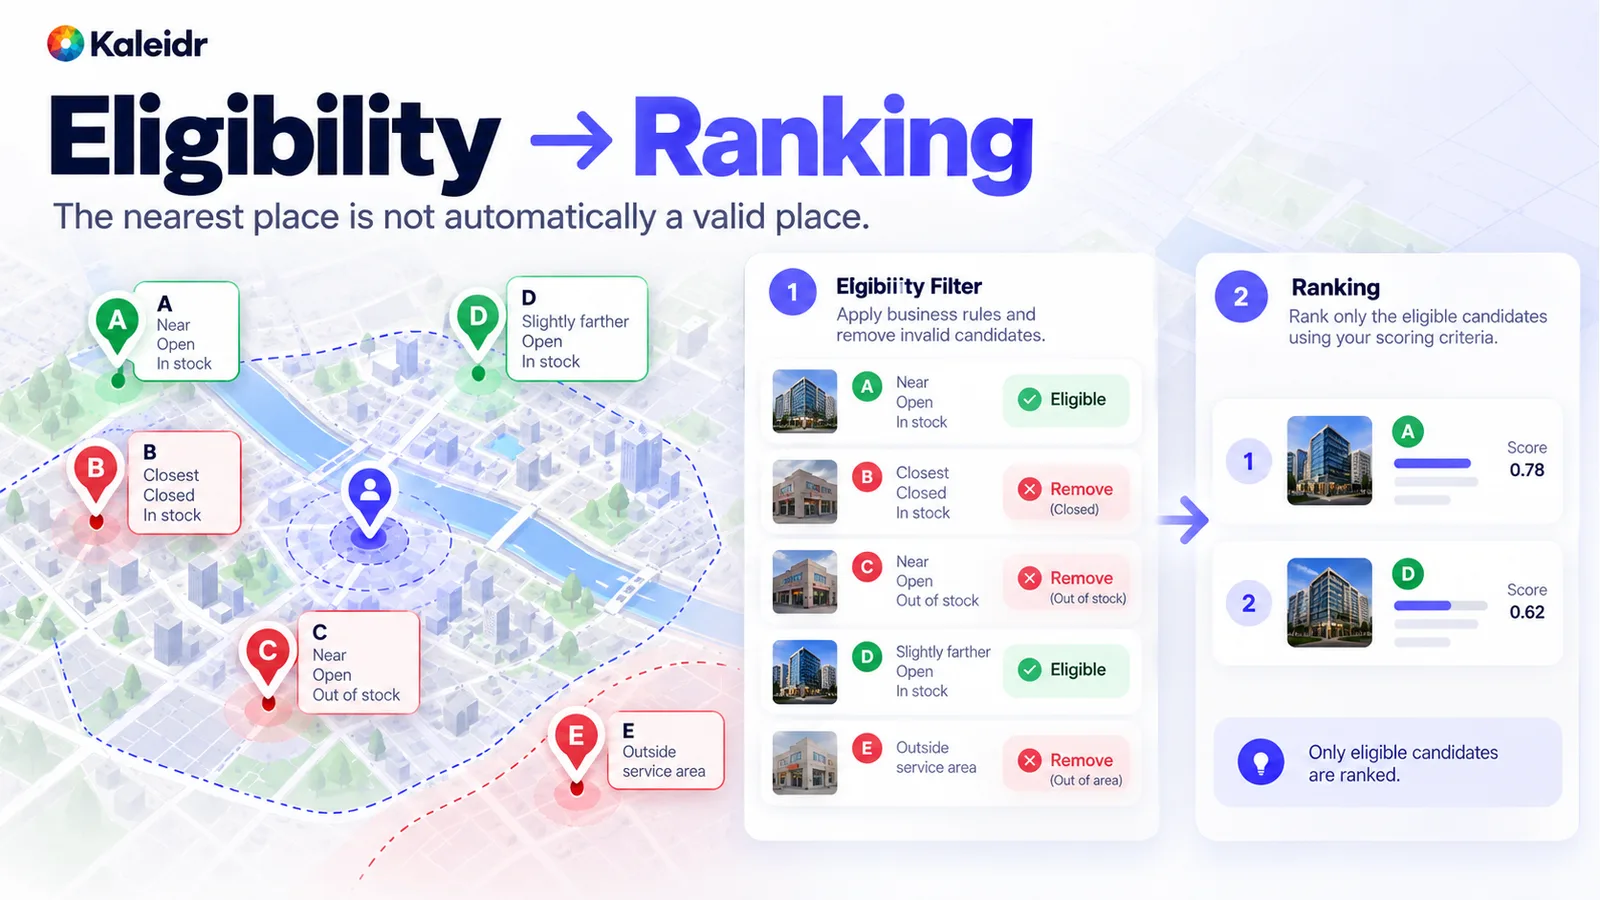
Filtrez d’abord l’éligibilité. Le lieu le plus proche n’est pas automatiquement un lieu valide.
Comment vérifier la géographie et la fraîcheur des données ?
Un modèle de langage ne devrait pas être la source de vérité pour un calcul qu’un moteur spatial peut effectuer. Point dans polygone, distance d’itinéraire, temps de trajet, appartenance à une zone de service, inclusion spatiale et ordre le long d’un trajet appartiennent à cette catégorie. Construisez la réponse attendue à partir de données géographiques de référence et d’un outil fiable, puis comparez le résultat de l’application à cette réponse. Une correspondance exacte convient pour « ce point se trouve-t-il dans ce polygone ? » et « le système a-t-il renvoyé l’agence ID 172 ? ». Une tolérance définie à l’avance convient aux coordonnées, au temps de trajet estimé et aux limites tracées à des résolutions différentes. Ne décidez pas après l’exécution qu’un résultat incorrect était finalement assez proche.
La fraîcheur est une question distincte de la correction historique. Les coordonnées et l’identité d’une agence peuvent rester stables tandis que les horaires, l’inventaire, le trafic et les fermetures évoluent. Suivez la proportion de décisions prises à partir de données hors du seuil de fraîcheur et la proportion de champs sensibles au temps disposant d’une heure de mise à jour connue. Une donnée manquante n’est pas le même fait que « indisponible ». Un oui ou un non affirmé avec confiance à partir d’un état inconnu constitue un échec, même si le lieu existe réellement.
Quand « aucun résultat » est-il la réponse exacte ?
Un client peut demander un lieu à moins de dix minutes qui possède un article après 21 h alors qu’aucun lieu ne répond à ces critères. Un système faible relâche silencieusement la contrainte et renvoie une agence située à vingt minutes. Un système grounded indique qu’aucune option vérifiée ne satisfait toutes les conditions. Les benchmarks doivent inclure des tâches volontairement insolubles, puis suivre le taux correct d’« aucun résultat » et le taux de fausses recommandations. GeoBenchX, benchmark de 2025 pour des agents appelant des outils sur des tâches géospatiales en plusieurs étapes, inclut à la fois des tâches solubles et volontairement insolubles afin de mesurer la précision du rejet (Krechetova and Kochedykov, 2025). Cet article évalue des agents de recherche. GeoBenchX n’évalue pas Kaleidr, et une équipe produit doit malgré tout écrire des cas insolubles propres à son usage.
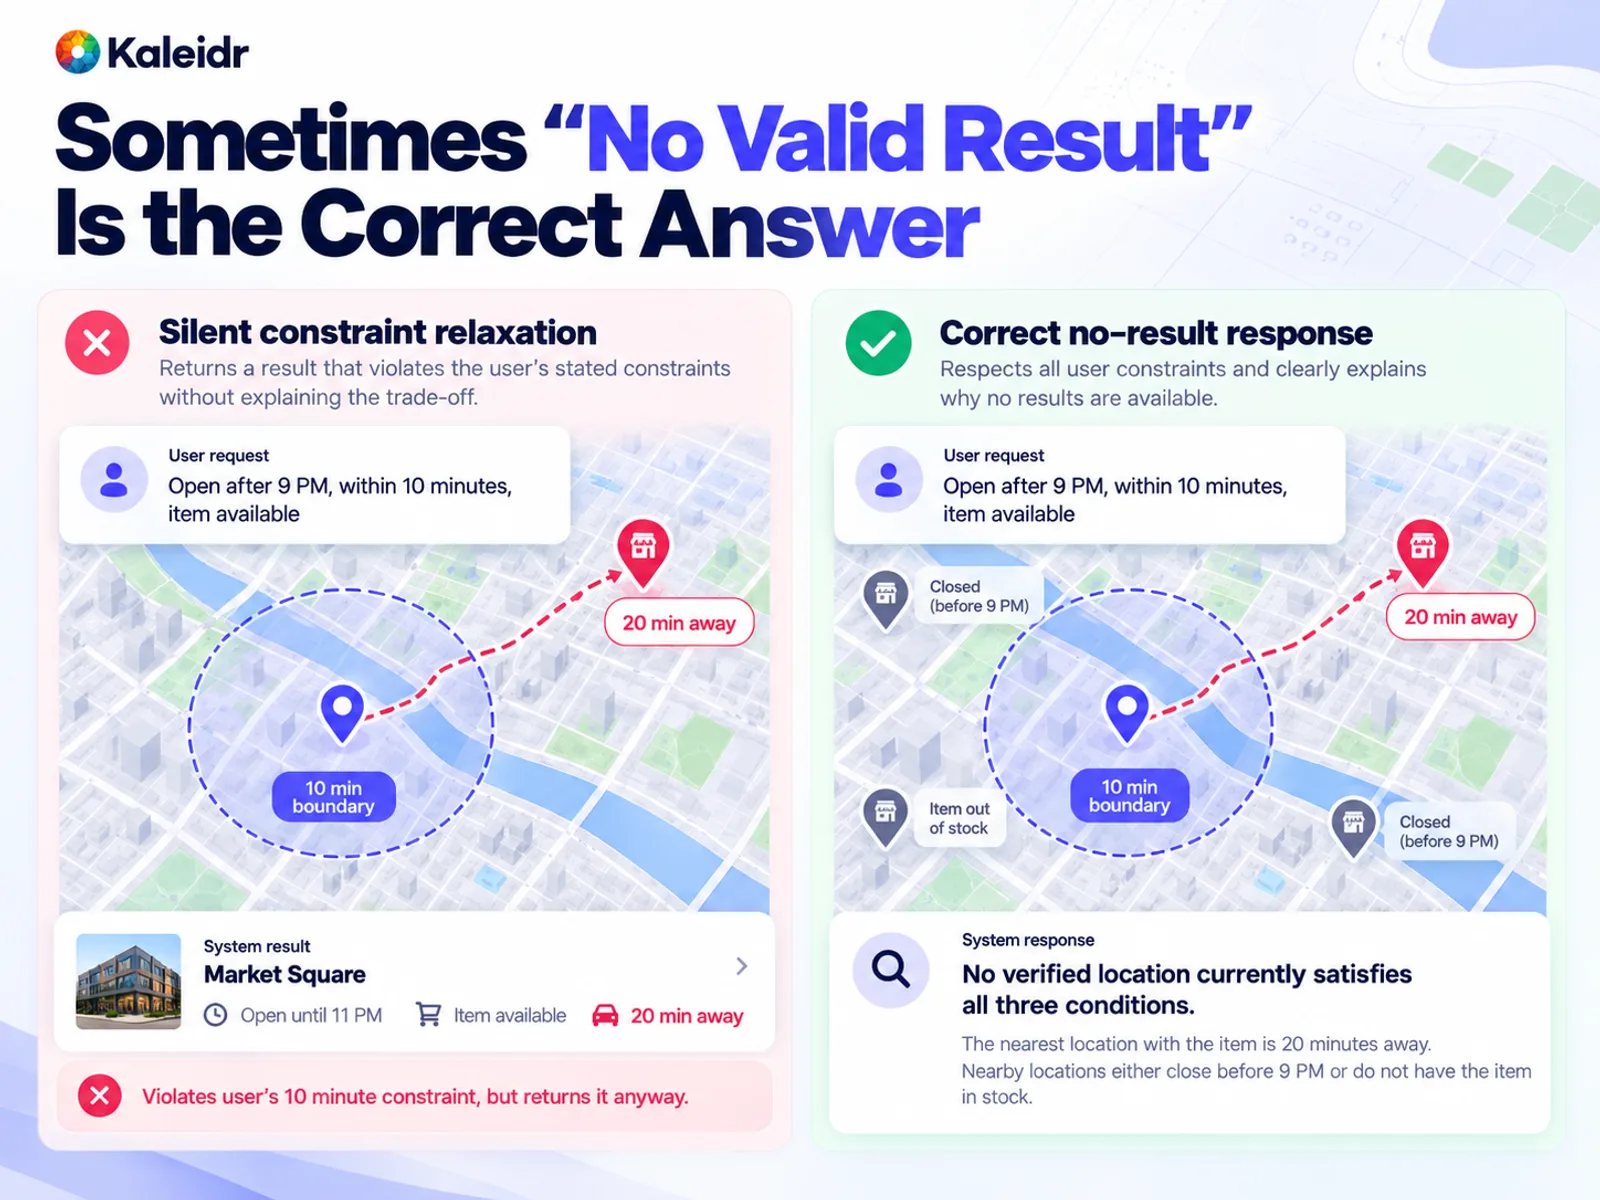
Parfois, l’absence de résultat valide est la bonne réponse. Renvoyer un lieu hors de l’heure ou de la distance indiquée est une fausse recommandation, pas une solution de repli utile.
Comment noter le classement, l’explication et les actions ?
Ne classez qu’après avoir éliminé les candidats non valides. Le plus proche n’est pas automatiquement le meilleur. Temps de trajet, détour, disponibilité, accessibilité, prix, fenêtre d’ouverture et priorité métier peuvent tous faire partie de l’objectif si le produit le définit ainsi. Parmi les mesures utiles : la fréquence à laquelle le premier résultat est acceptable, la fréquence à laquelle un choix acceptable apparaît dans les K premiers résultats, l’accord avec un ordre revu par un humain ou défini par une politique, et le regret par rapport à la meilleure option éligible connue. Ne confondez pas engagement et qualité du classement. Reliez l’ordre à l’action dont le client avait besoin.
Une explication comme « ouvert jusqu’à 22 h, article disponible, six minutes supplémentaires sur le trajet » n’est exacte que si chaque proposition peut être reliée à une preuve effectivement utilisée par le système. Vérifiez l’identité du lieu, l’affirmation de disponibilité, les horaires, si un itinéraire a réellement été calculé et si le texte correspond à la décision de classement. Un paragraphe bien écrit peut être faux. Un paragraphe court et maladroit peut être juste. Mesurez les affirmations vérifiées parmi les affirmations factuelles de l’explication.
Les actions font partie de la réponse. Déplacer la carte, ajouter un marqueur, demander un itinéraire, modifier un filtre ou commencer une réservation peut être incorrect même si la phrase est juste. Suivez si l’action appartient au vocabulaire de l’application, si la cible et les paramètres sont corrects et si la personne était autorisée à l’effectuer. Une phrase correcte associée à la mauvaise action cartographique reste une interaction échouée.
Quels cas d’échec doivent figurer dans le benchmark ?
Un ensemble composé uniquement d’exemples propres que l’équipe sait déjà résoudre surestimera la fiabilité. Incluez des noms ambigus, des agences en double, des adresses en bordure de zone de service, des demandes insolubles, un magasin qui vient de fermer, un inventaire incompatible avec le lieu, un point proche qui augmente fortement le détour, une heure de fermeture antérieure à l’arrivée, un établissement privé que l’utilisateur n’a pas le droit de voir, un nom local différent du nom anglais, des horaires inconnus, une source publique qui contredit des données de première partie, du texte récupéré qui tente d’orienter le modèle et un service de routage ou de données métier indisponible. Le but est de reproduire les décisions auxquelles la production sera réellement confrontée.
Un texte récupéré qui tente d’orienter le modèle constitue un cas de prompt injection. OWASP décrit LLM01:2025 Prompt Injection comme une entrée utilisateur ou récupérée qui modifie le comportement du modèle de manière non intentionnelle, notamment en influençant une décision critique, et précise que la génération augmentée par récupération ne supprime pas complètement cette faiblesse (OWASP, 2025). Placez ce cas dans la famille sécurité du jeu de tests, à côté des autorisations, plutôt que de traiter la sécurité comme une annexe ajoutée plus tard.
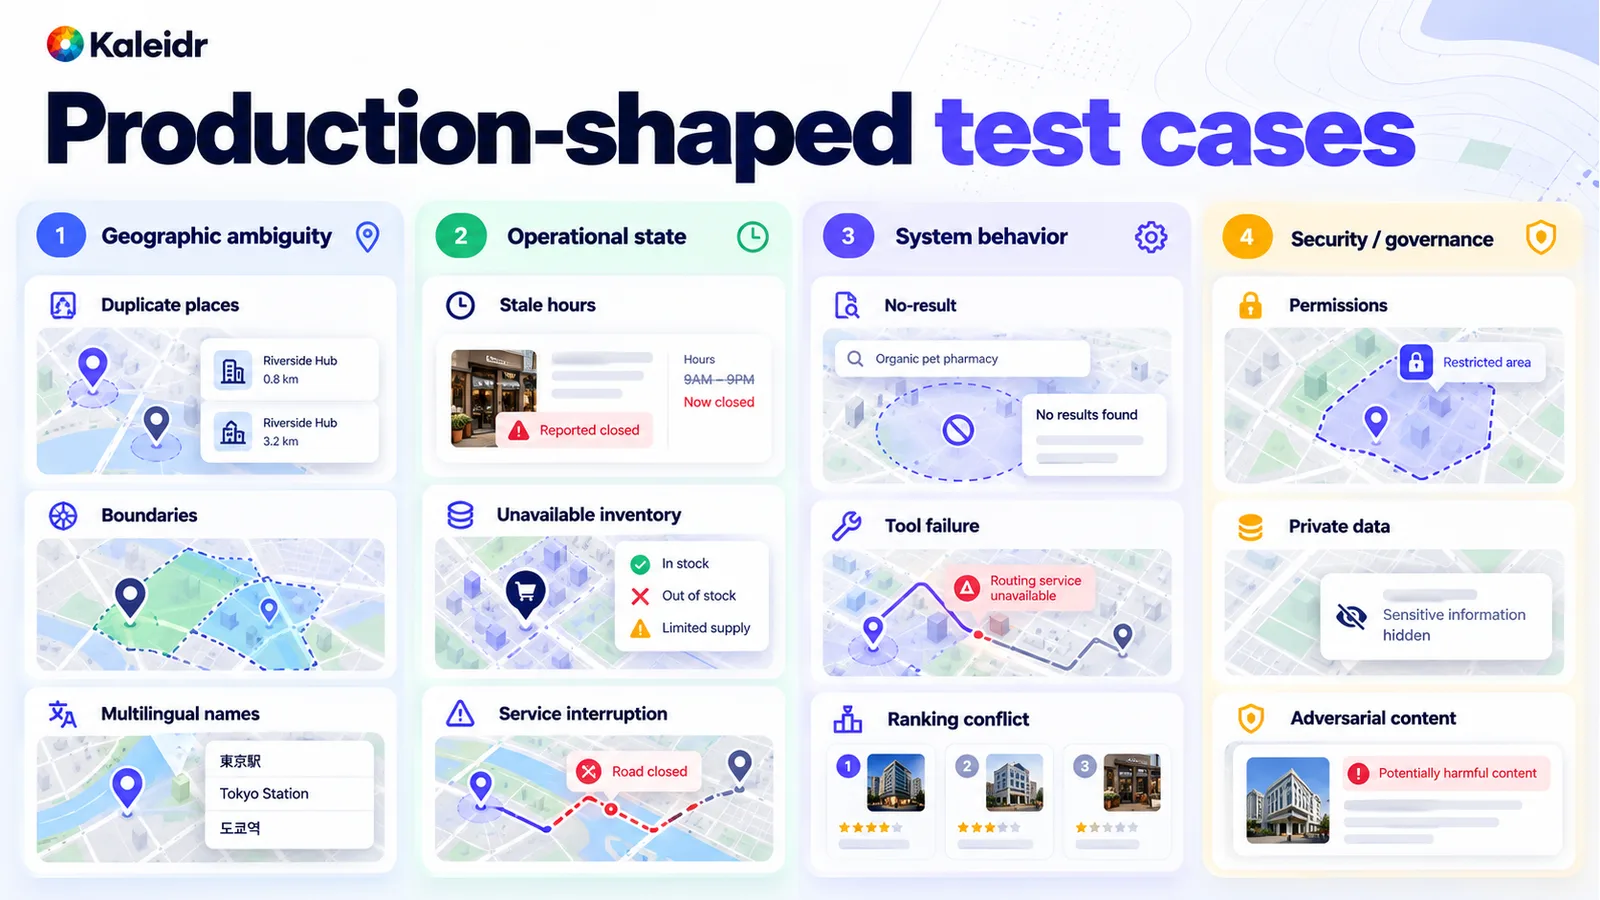
Les cas proches de la production couvrent l’ambiguïté géographique, l’état opérationnel, le comportement du système et la sécurité. Un benchmark qui les omet surestimera la fiabilité.
Pourquoi la vérité terrain doit-elle exister avant l’exécution ?
Chaque cas doit contenir suffisamment de vérité enregistrée pour définir ce qui est correct : la requête, le contexte utilisateur, les sources autorisées, l’intention attendue, les contraintes requises, les lieux canoniques, l’ensemble éligible, la relation spatiale attendue, le meilleur résultat, les alternatives acceptables, l’action attendue, la raison pour laquelle « aucun résultat » est correct, la tolérance et la gravité en cas d’erreur. Écrivez cet enregistrement avant l’exécution du système. Adapter la clé de réponse à ce que le modèle a produit n’est pas une évaluation.
GISAgentBench, benchmark 2026 issu de praticiens et composé de 349 tâches GIS en plusieurs étapes, soutient que de nombreux benchmarks d’agents GIS manquent de sorties de vérité terrain et utilisent à la place des signaux de substitution comme la similarité de code, l’alignement de trajectoires ou un modèle juge, qui peuvent considérer un workflow similaire comme un résultat correct. Chaque tâche GISAgentBench inclut un fichier de sortie exact servant de vérité terrain (Pothuri et al., 2026). Utilisez du code ou un enregistrement de référence partout où la question est déterministe : coordonnées, inclusion, ID canonique, ouvert ou fermé, autorisation et action API appelée. Réservez la revue humaine, ou une revue assistée par modèle calibrée, aux questions réellement subjectives, comme le caractère compréhensible d’une explication. L’évaluateur doit correspondre au type de vérité testé.
Comment les équipes doivent-elles lire un résultat segmenté ?
Une moyenne peut masquer une géographie faible. Ventilez les résultats par pays, marché, langue, couverture urbaine et rurale, fournisseur de données, catégorie de lieu, densité d’agences, complexité de la requête et type d’itinéraire. Supposons que le taux global de résultats valides soit de 95 % alors qu’un marché nouvellement lancé se situe à 78 %. Cette paire de chiffres est une illustration hypothétique, pas une mesure Kaleidr. La moyenne peut être arithmétiquement correcte tout en étant la mauvaise valeur sur laquelle baser une mise à l’échelle. Examinez où surviennent les erreurs, puis attribuez chaque cas échoué à une catégorie : interprétation, résolution d’entité, grounding, éligibilité, calcul spatial, fraîcheur, classement, explication, action, sécurité ou récupération. La catégorie indique à l’équipe quoi modifier. Un échec de routage n’est pas un problème d’explication.
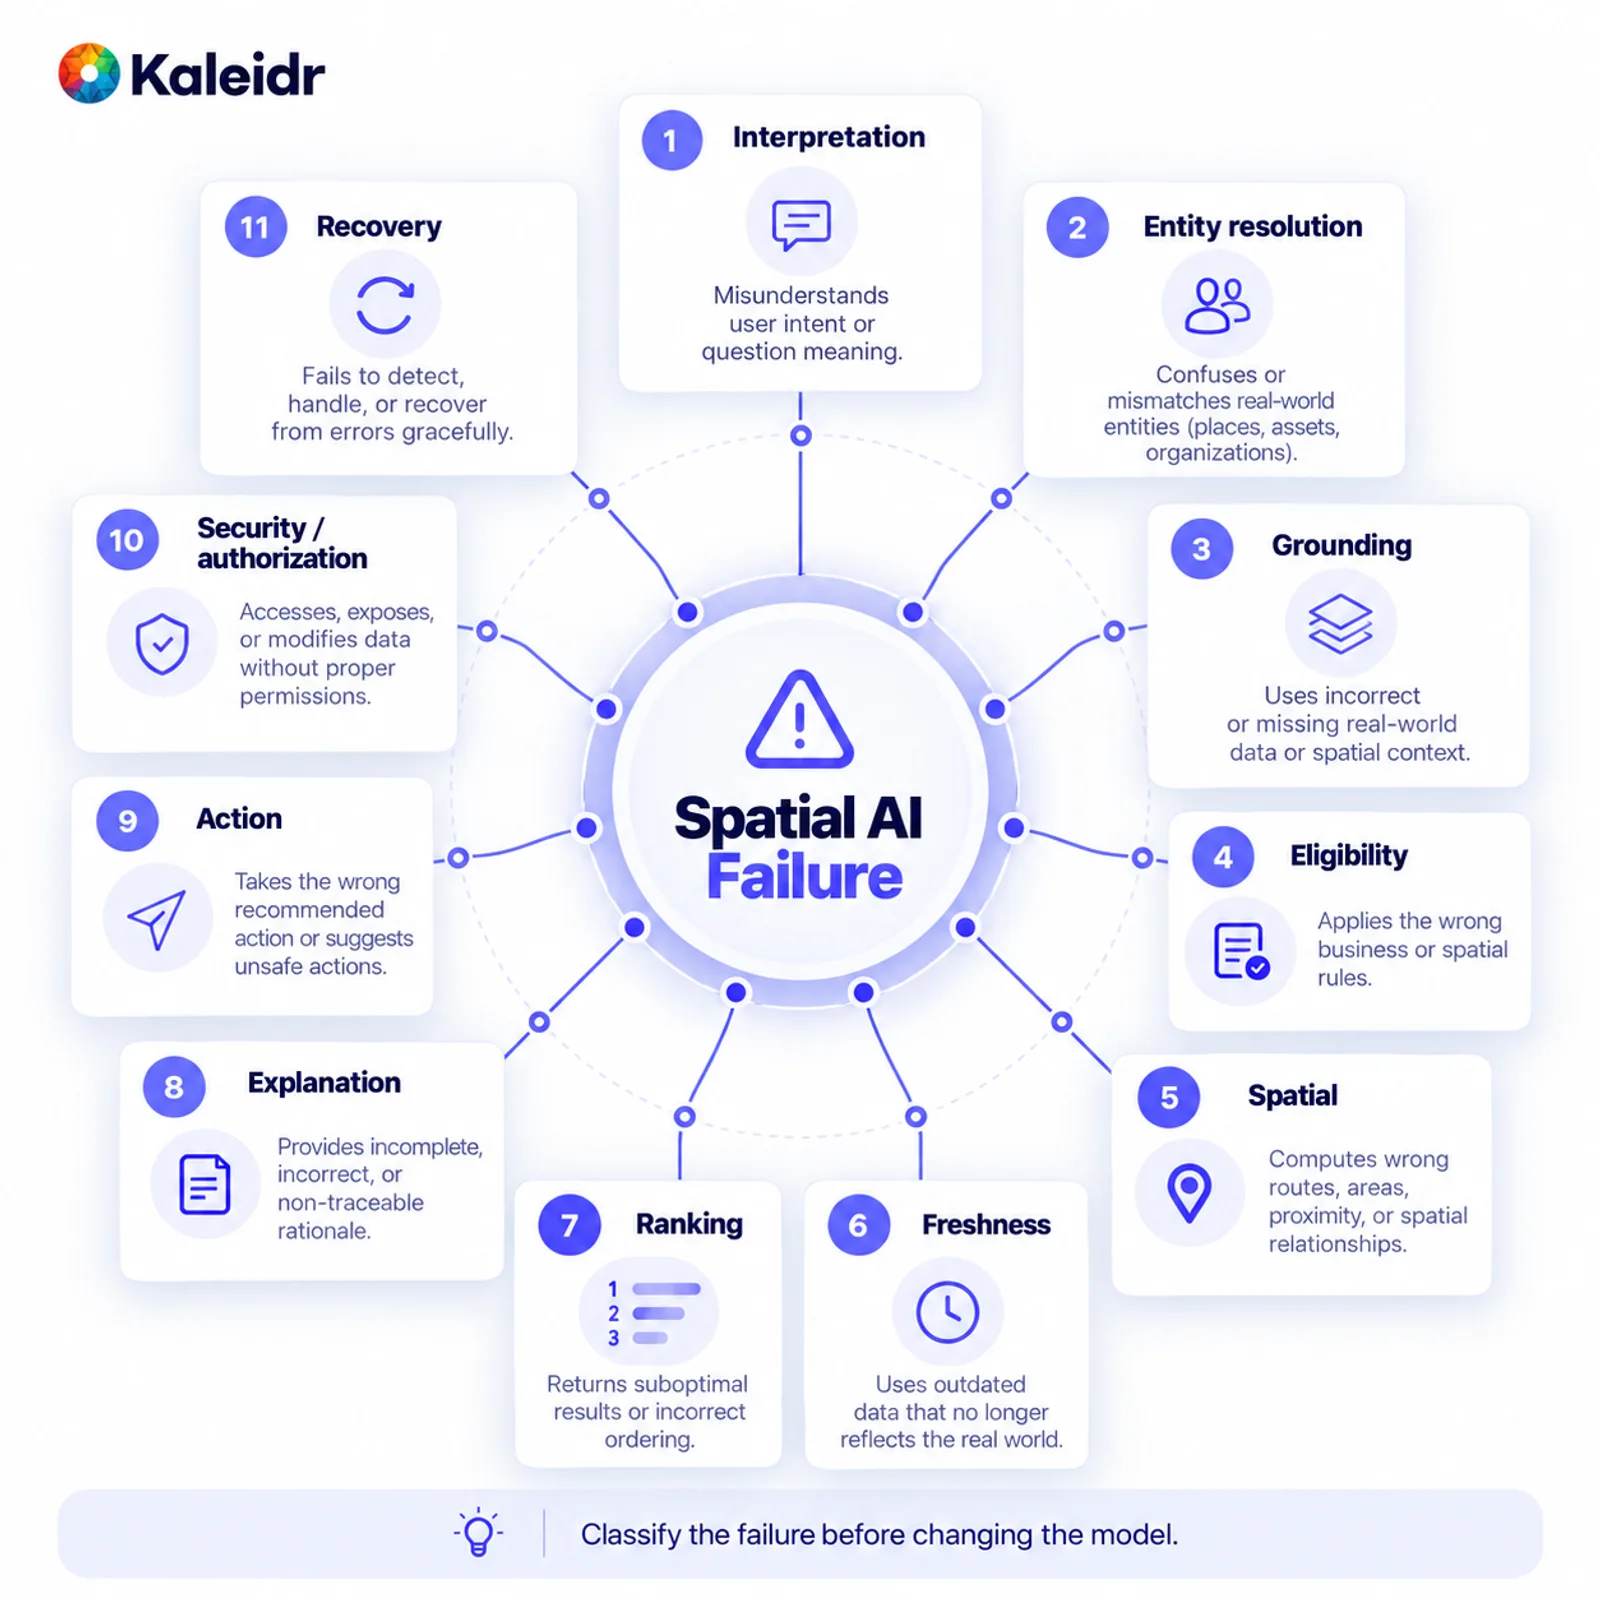
Classez l’échec avant de changer le modèle. Des catégories distinctes empêchent une erreur rare et grave de disparaître dans une grande moyenne.
Les exécutions génératives varient également. Pour les cas importants, enregistrez la moyenne, la pire exécution observée et la fréquence à laquelle l’échec se reproduit. Une requête sûre neuf fois et incorrecte une fois présente un risque différent d’une requête qui renvoie à chaque fois la même réponse sûre. Répétez le jeu de tests lorsque les prompts, modèles, systèmes de récupération, classements, fournisseurs de données, outils ou zones de couverture changent. L’évaluation appartient à la gestion des releases, pas à un unique rapport pré-lancement.
Que doit contenir une scorecard de production ?
Attribuez à chaque dimension sa propre métrique et sa propre porte. L’intention peut utiliser l’extraction des contraintes. L’identité du lieu peut utiliser la précision du lieu canonique. L’autorisation et la sécurité peuvent utiliser un taux d’accès non autorisé pour lequel aucune exposition de données protégées n’est tolérée. Éligibilité, calcul spatial, fraîcheur, classement, gestion des absences de résultat, explication, actions et résultat ont chacun besoin d’un seuil défini par le responsable produit avant l’exécution. Ne copiez pas un seuil universel depuis une autre application. Une recommandation informelle de restaurant et une décision de routage ayant des conséquences de sécurité n’ont pas le même budget d’erreur.
| Dimension | Exemple de métrique | Exemple de porte |
|---|---|---|
| Intention | Précision de l’extraction des contraintes | À définir pour ce produit |
| Identité du lieu | Précision du lieu canonique | Très élevée |
| Autorisation | Taux d’accès non autorisé | Aucun toléré pour les données protégées |
| Éligibilité | Précision des résultats éligibles | Très élevée |
| Calcul spatial | Correct dans une tolérance définie à l’avance | À définir pour ce produit |
| Fraîcheur | Part des résultats dans la fenêtre de fraîcheur | À définir pour ce produit |
| Classement | Acceptation Top-1 ou Top-K | À définir pour ce produit |
| Gestion d’« aucun résultat » | Taux de rejet correct | Élevé |
| Explication | Taux d’affirmations étayées | Élevé |
| Actions | Taux d’actions valides et correctement paramétrées | Très élevé |
| Résultat | Achèvement de la tâche dépendante de la localisation | Doit améliorer le travail visé |
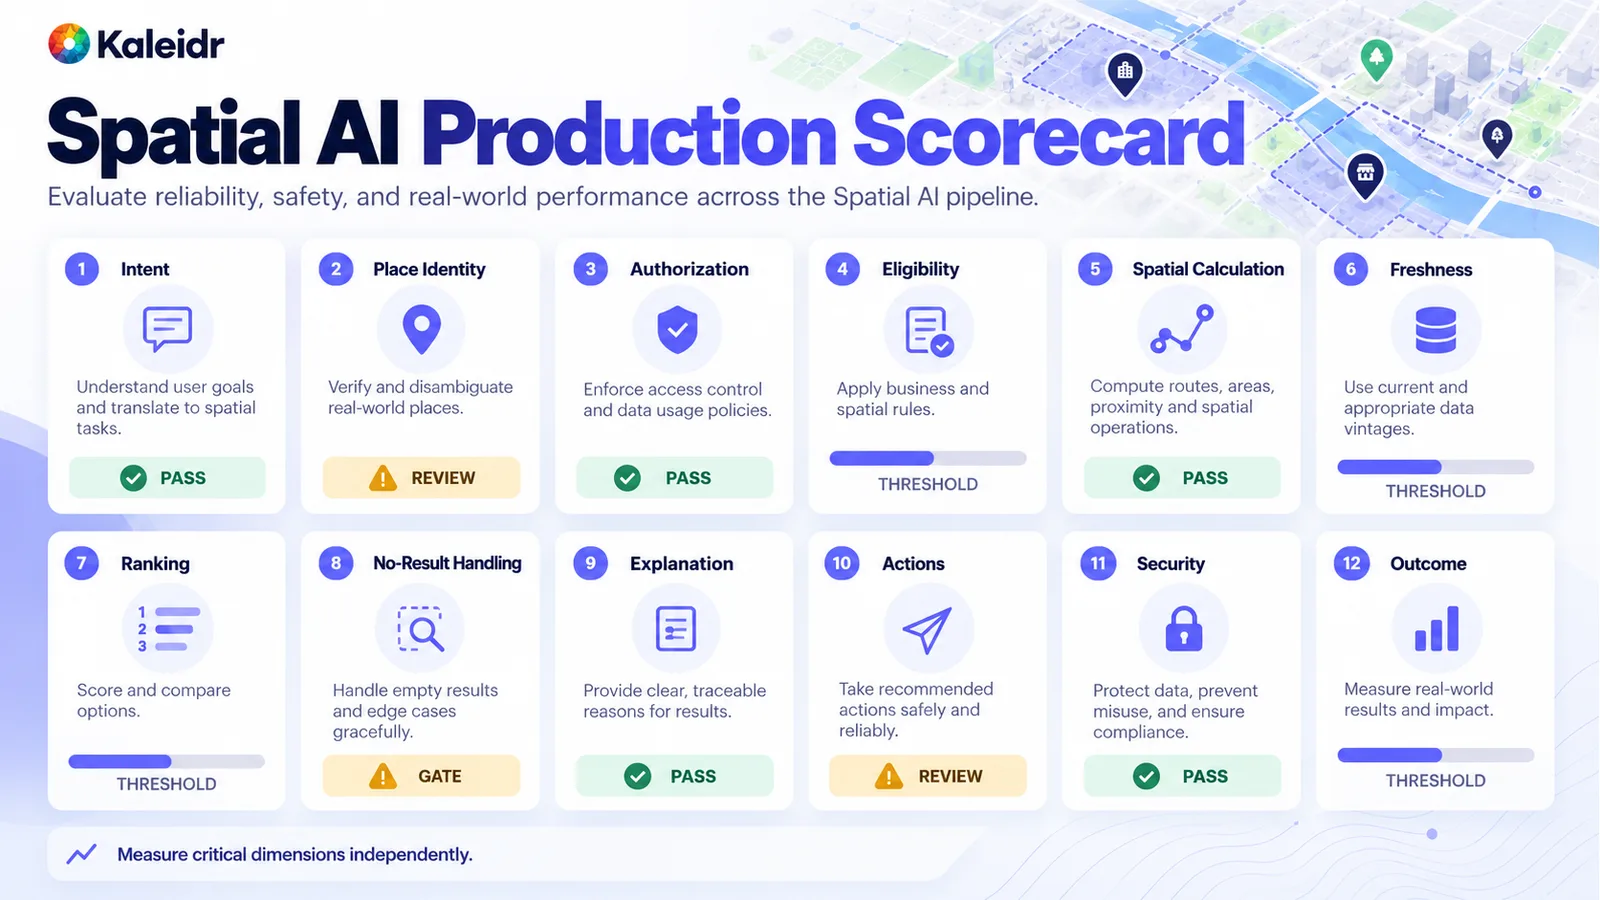
Mesurez les dimensions critiques indépendamment. Les étiquettes de statut de cette scorecard sont des placeholders, pas des scores de benchmark Kaleidr.
Comment une équipe doit-elle décider de passer à l’échelle ?
Utilisez les portes, pas un score agrégé. Passez à l’échelle lorsque des résultats valides, grounded et spatialement corrects tiennent dans des conditions proches de la production, que les classes d’erreurs critiques sont maîtrisées, que quelqu’un est responsable des données opérationnelles et que le résultat visé s’améliore. Itérez lorsque le travail a de la valeur et qu’une couche corrigeable reste faible. Réduisez le périmètre lorsque le pilote mélange trop de géographies, de sources ou de travaux pour déterminer ce qui a échoué. Arrêtez lorsque l’équipe ne peut pas nommer les données de référence, ne peut pas contrôler un échec critique, ne peut pas définir la tâche ou ne peut pas montrer d’amélioration par rapport au workflow actuel. Un pilote Spatial AI d’entreprise est le test borné. La scorecard transforme ce test en décision.
Où Kaleidr intervient-il dans l’évaluation ?
Kaleidr Enterprise décrit une infrastructure de location intelligence avec des API d’inférence, des systèmes de classement, des analytics et un support de déploiement, comprenant le chat, l’édition, les tiles et des viewers intégrables qu’un hôte peut ajouter à côté d’une carte qu’il exploite déjà (Kaleidr, 2026). L’application hôte conserve les systèmes métier qu’elle possède : inventaire, autorisations, état client, réservation et autres enregistrements opérationnels privés. Les outils spatiaux prennent en charge les calculs déterministes. La couche du modèle de langage interprète l’intention, coordonne les capacités prises en charge et explique les résultats grounded. La page publique Analytics de Kaleidr, intitulée Map Engagement and Location Analytics, décrit la portée, les vues, l’engagement, la localisation et l’activité de l’audience, les sessions et interactions par carte, la comparaison de lieux et les motifs spatiaux (Kaleidr, 2026). Ces rapports décrivent le comportement autour des cartes et des lieux. Les réservations finalisées, commandes et leads qualifiés restent dans les systèmes hôtes qui les enregistrent.
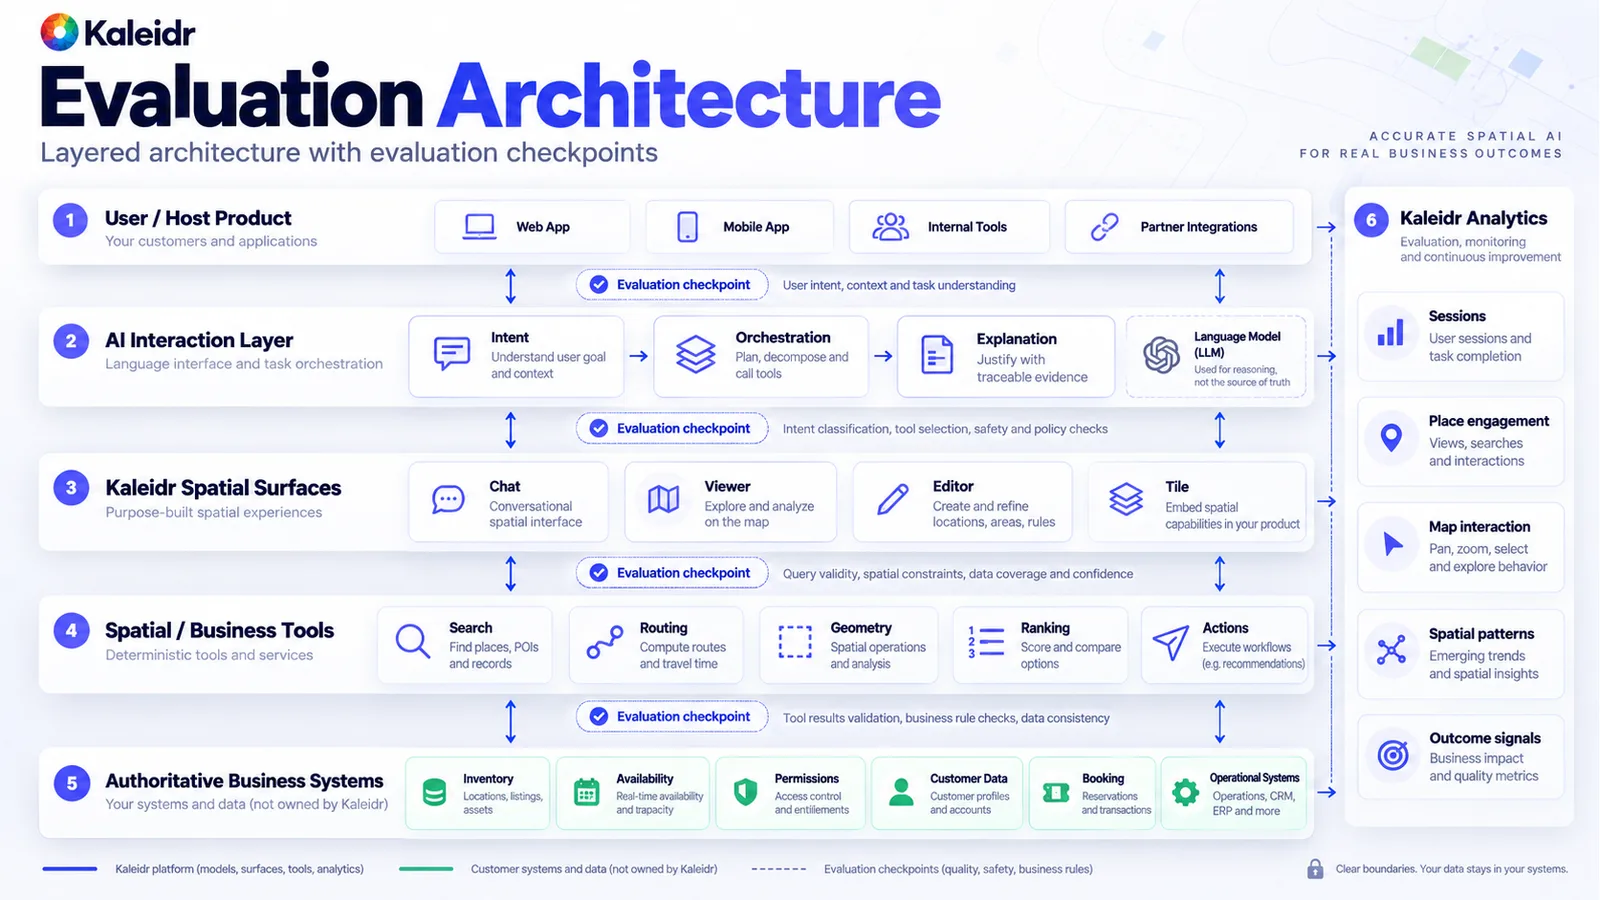
Le modèle de langage n’est pas la source de vérité pour l’inventaire, les autorisations ou un itinéraire. Les points de contrôle entre les couches montrent quelle partie a échoué.
Quelles erreurs cachent un benchmark faible ?
Des questions de happy path, sans ambiguïté, données manquantes ou demande insoluble, surestiment la fiabilité. Évaluer uniquement la similarité du texte avec une référence manque une décision correcte formulée autrement et récompense un mauvais lieu écrit dans le style de la référence. Classer un ensemble qui contient encore des lieux non éligibles masque l’échec d’éligibilité. Demander au modèle de vérifier une distance qu’un moteur spatial peut calculer remplace un calcul par de la fluidité. Ignorer la fraîcheur traite les horaires d’hier comme ceux d’aujourd’hui. Considérer davantage d’interaction avec la carte comme de la précision confond intérêt, succès et parfois confusion. Modifier une tolérance après avoir vu les chiffres n’est pas un benchmark. Tester uniquement le modèle ignore la récupération, les données, les outils, les autorisations, le classement et l’interface. Le comportement de production est celui du produit assemblé.
Les benchmarks de recherche restent utiles comme sondes de capacité. GeoBenchLLM, soumis en août 2026 et accepté à CIKM 2026, évalue les modèles de langage sur des tâches liées à la géographie issues de jeux de données publics, notamment la compréhension géospatiale et temporelle (Rodrigues et al., 2026). Les benchmarks GeoAI couvrent souvent la télédétection, les workflows GIS, l’imagerie ou des tâches de modèles géospatiaux. Un benchmark produit peut aussi nécessiter grounding sur des données métier, autorisations, disponibilité en temps réel, classement, actions cartographiques et résultat client. Un seul benchmark public ne peut pas remplacer le travail propre à chaque produit.
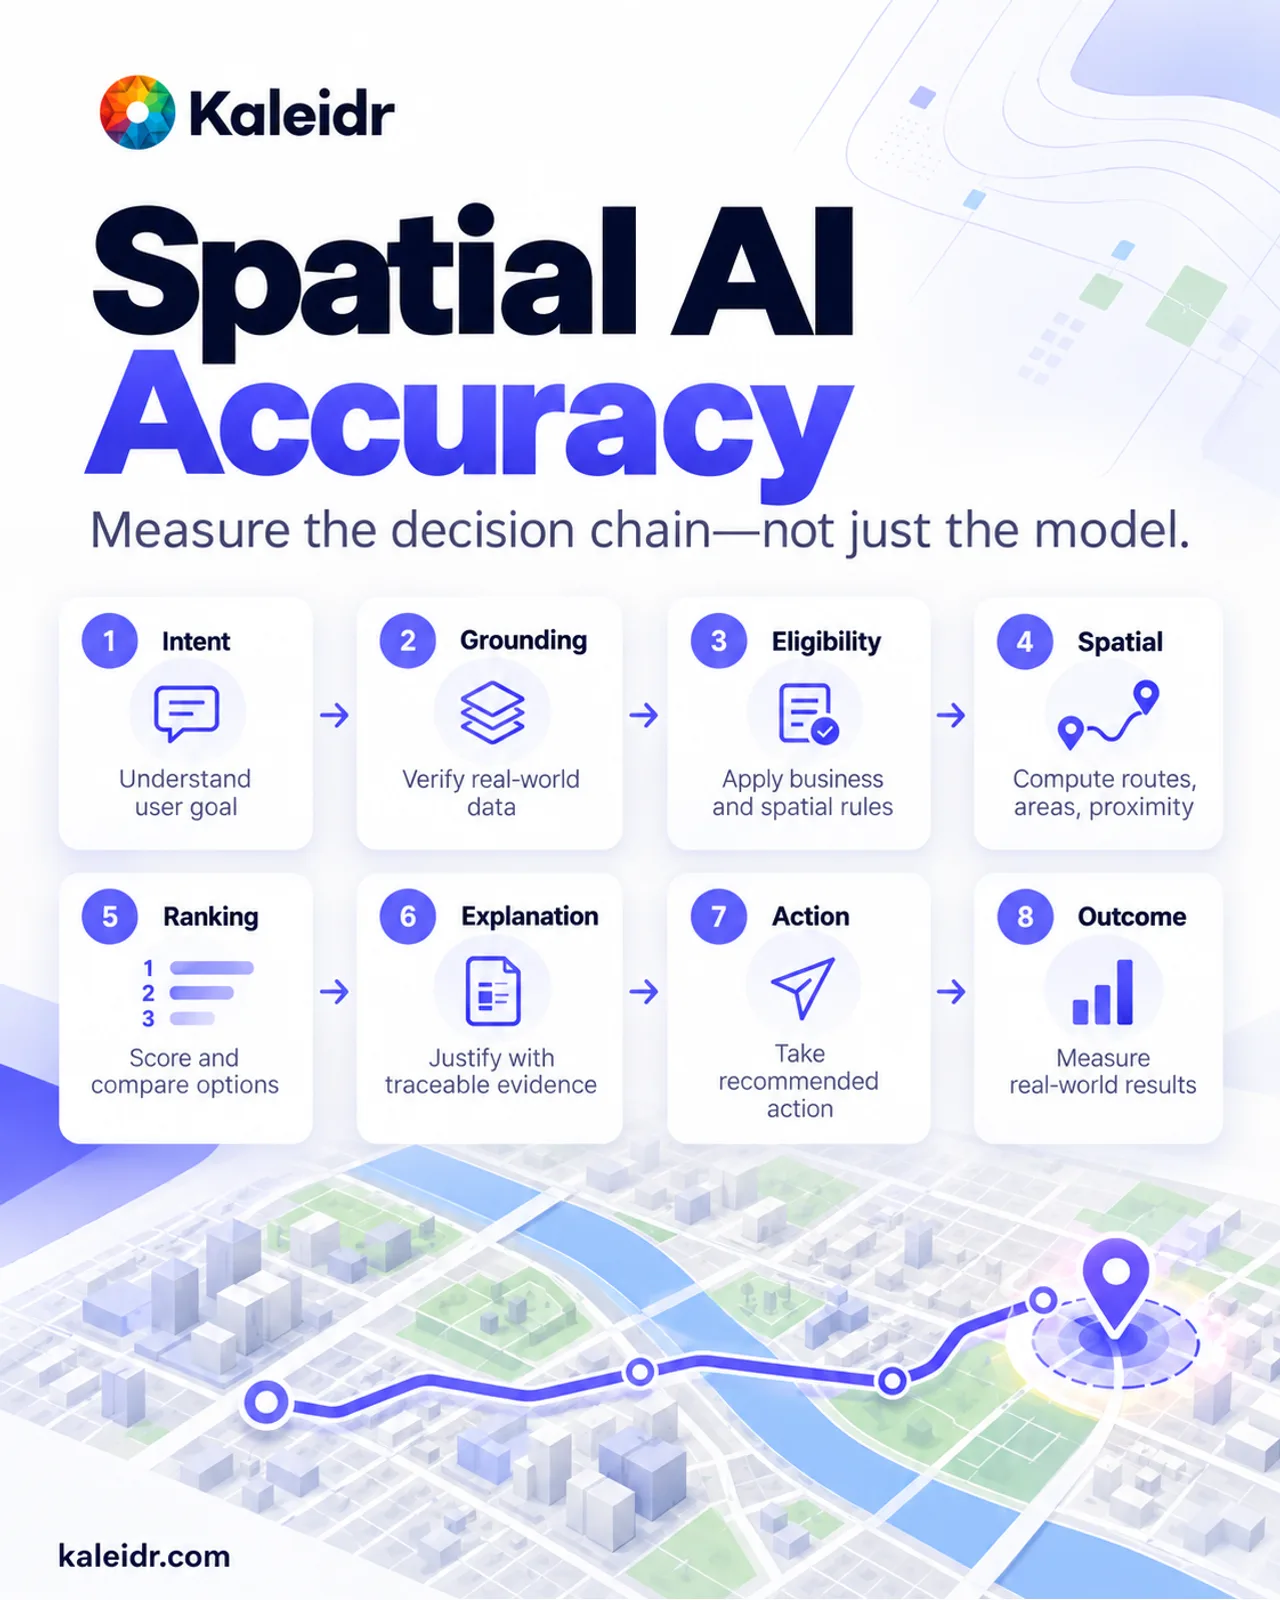
Mesurez la chaîne de décision, pas seulement le modèle. Les huit étapes constituent le plan de l’évaluation, pas un score publié.
Comment l’évaluation devient-elle une porte de release ?
Construisez le jeu de tests avant la mise à l’échelle. Incluez les cas d’échec. Gardez la vérité déterministe hors du modèle de langage lorsqu’un outil ou un enregistrement peut répondre. Suivez les dimensions critiques avec leurs propres portes. Répétez l’exécution lorsque le système change et reliez le résultat hors ligne au résultat en production que la tâche devait améliorer. La question utile est de savoir si ce système peut prendre la décision dépendante de la localisation que le produit promet, avec les bonnes données, la bonne géographie, les bonnes autorisations et les bonnes actions, et si l’équipe peut le prouver.
Découvrir Kaleidr Enterprise pour ajouter une AI sensible à la localisation à côté des systèmes qu’un produit utilise déjà et définir un pilote ciblé. Découvrir Kaleidr Analytics pour voir comment les audiences utilisent les cartes et les lieux de ce pilote. L’hôte conserve la responsabilité du résultat métier et de la décision de mise à l’échelle.
FAQ
Comment mesure-t-on la précision de Spatial AI ?
Mesurez les étapes de la décision de localisation : intention, résolution du lieu, autorisation, éligibilité, calculs géographiques, fraîcheur, classement, explication, action et résultat utilisateur ou métier. Ne réduisez pas cette chaîne à un score unique du modèle.
Est-ce la même chose que la précision d’un modèle de langage ?
Non. Un modèle de langage n’est qu’un composant. Les bases de données de lieux, les enregistrements métier, les moteurs spatiaux, le routage, le classement, les autorisations et l’état de l’application peuvent tous modifier la justesse du résultat.
Un modèle de langage doit-il calculer la distance ?
Utilisez un outil géographique ou de routage lorsque le produit a besoin d’une distance ou d’une relation de trajet. Le modèle peut décider quand le calcul est nécessaire et expliquer le résultat. Le service spatial effectue le calcul.
Les benchmarks doivent-ils inclure des questions impossibles ?
Oui. Les tâches volontairement insolubles montrent si le système renvoie une réponse grounded d’« aucun résultat » au lieu d’inventer un lieu ou d’abandonner silencieusement une contrainte.
À quelle fréquence l’évaluation doit-elle être exécutée ?
Exécutez-la avant la production, puis à nouveau lorsque les modèles, prompts, fournisseurs de données, systèmes de classement, outils spatiaux, autorisations ou couvertures changent. Surveillez en continu le comportement en production. Un rapport le jour du lancement ne constitue pas un processus de release.
Un seul benchmark peut-il comparer tous les systèmes ?
Les benchmarks de recherche peuvent comparer une capacité explicitement définie. L’évaluation de production doit refléter le travail géographique, les données, les risques, les outils et le résultat de l’application concernée. Les benchmarks GeoAI et les benchmarks produit ne sont pas interchangeables.
Références
- National Institute of Standards and Technology. AI RMF Playbook, Measure. Notes that the AI RMF 1.0 is being updated and that the playbook will be revised afterward. Accessed September 29, 2026. https://airc.nist.gov/airmf-resources/playbook/measure/
- National Institute of Standards and Technology. The TEVV-Athlon Framework for Evaluating AI Systems. NIST AI 200-2, initial public draft. Announced August 7, 2026; comments through October 6, 2026. https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems
- Krechetova, Varvara, and Denis Kochedykov. GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks. arXiv:2503.18129, submitted March 23, 2025, revised October 22, 2025. https://arxiv.org/abs/2503.18129
- Pothuri, Abhinav, Zhe Jiang, Zelin Xu, and Di Yang. GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks. arXiv:2608.01645, submitted August 3, 2026. https://arxiv.org/abs/2608.01645
- Rodrigues, Rodrigo Ferreira, Karim Radouane, Jose G. Moreno, and Lynda Tamine. GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks. arXiv:2608.07411, submitted August 7, 2026. Accepted at CIKM 2026. https://arxiv.org/abs/2608.07411
- OWASP Gen AI Security Project. LLM01:2025 Prompt Injection. Accessed September 29, 2026. https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed September 29, 2026. https://kaleidr.com/enterprise
- Kaleidr. Map Engagement and Location Analytics. Accessed September 29, 2026. https://kaleidr.com/analytics
- Kaleidr. Grounded Spatial AI for Business Data. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- Kaleidr. An Enterprise Spatial AI Pilot Before Scaling. https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling
@misc{nist_rmf_playbook_measure_2026,
  title  = {AI RMF Playbook, Measure},
  author = {{National Institute of Standards and Technology}},
  year   = {2026},
  note   = {Accessed September 29, 2026. Page states the playbook will be updated after the AI RMF revision},
  url    = {https://airc.nist.gov/airmf-resources/playbook/measure/}
}

@techreport{nist_ai_200_2_2026,
  title       = {The TEVV-Athlon Framework for Evaluating AI Systems},
  author      = {{National Institute of Standards and Technology}},
  institution = {National Institute of Standards and Technology},
  number      = {NIST AI 200-2},
  year        = {2026},
  note        = {Initial public draft, announced August 7, 2026},
  url         = {https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems}
}

@misc{krechetova_geobenchx_2025,
  title  = {GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks},
  author = {Krechetova, Varvara and Kochedykov, Denis},
  year   = {2025},
  note   = {arXiv:2503.18129, revised October 22, 2025},
  url    = {https://arxiv.org/abs/2503.18129}
}

@misc{pothuri_gisagentbench_2026,
  title  = {GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks},
  author = {Pothuri, Abhinav and Jiang, Zhe and Xu, Zelin and Yang, Di},
  year   = {2026},
  note   = {arXiv:2608.01645, submitted August 3, 2026},
  url    = {https://arxiv.org/abs/2608.01645}
}

@misc{rodrigues_geobenchllm_2026,
  title  = {GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks},
  author = {Rodrigues, Rodrigo Ferreira and Radouane, Karim and Moreno, Jose G. and Tamine, Lynda},
  year   = {2026},
  note   = {arXiv:2608.07411, submitted August 7, 2026, accepted at CIKM 2026},
  url    = {https://arxiv.org/abs/2608.07411}
}

@misc{owasp_llm01_2025,
  title  = {LLM01:2025 Prompt Injection},
  author = {{OWASP Gen AI Security Project}},
  year   = {2025},
  note   = {Accessed September 29, 2026},
  url    = {https://genai.owasp.org/llmrisk/llm01-prompt-injection/}
}

@misc{kaleidr_enterprise_accuracy_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_analytics_accuracy_2026,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/analytics}
}