
Spatial-AI-Genauigkeit misst, ob ein standortbezogenes System die Anfrage korrekt interpretiert, die richtigen Orte identifiziert, autorisierte und aktuelle Daten verwendet, Geografie korrekt berechnet, nur zulässige Optionen einstuft, die Evidenz erklärt und ausschließlich gültige Aktionen ausführt. Eine flüssige Antwort kann jemanden trotzdem zur falschen Filiale schicken. Ein einzelner Modell-Score kann das nicht zeigen. Der Benchmark muss vor dem Produktivbetrieb genau die Aufgabe testen, die das Produkt verspricht.
Die folgenden Abschnitte trennen die Entscheidungskette, die Gates, die ein Durchschnittswert verdeckt, die Fehlerfälle, die im Voraus aufgebaut werden sollten, und die Grenze zwischen Forschungsbenchmarks und einer Produktevaluierung. Weiterführende Beiträge sind Grounded Spatial AI für Geschäftsdaten und Ein Enterprise-Spatial-AI-Pilot. Eine korrekte Ablehnung kann genauer sein als eine plausibel klingende Empfehlung.
Das Wesentliche zur Spatial-AI-Genauigkeit
- Die Kette bewerten: Absicht, Grounding, Zulässigkeit, räumliche Berechnung, Ranking, Erklärung, Aktion und Ergebnis.
- Fakten außerhalb des Modells prüfen: Ortsidentität, Öffnungszeiten, Bestand, Berechtigungen und Routen gehören in autoritative Systeme.
- Schwierige Fälle einbeziehen: Mehrdeutige, veraltete, nicht autorisierte und absichtlich unlösbare Anfragen.
- Gates getrennt halten: Ein hoher Score in einer risikoarmen Schicht darf einen Berechtigungsfehler nicht ausgleichen.
- An die Aufgabe koppeln: Offline-Fälle und Produktionsergebnisse beantworten unterschiedliche Fragen. Beides ist nötig.
Was bedeutet Spatial-AI-Genauigkeit?
Ein Kunde kann fragen, welche Filiale auf dem Heimweg einen Artikel noch vorrätig hat und bei der Ankunft geöffnet sein wird. Dieser Satz enthält mehrere unabhängige Probleme: was die Person möchte, welche Filialen existieren, ob der Bestand aktuell ist, ob die Öffnungszeiten zur Ankunftszeit passen, welche Filialen entlang der Route tatsächlich erreichbar sind, welche Geschäftsregeln einen Kandidaten ausschließen und wie die verbleibenden Optionen eingestuft und erklärt werden sollen. Ein flüssiger Schlusssatz beweist keinen dieser Schritte. Die Evaluierung muss die Schichten trennen, denn ein Fehler bei der Ortsauflösung wird nicht durch das Umschreiben eines Ranking-Prompts behoben, und ein veralteter Bestandsfeed nicht durch den Austausch des Sprachmodells.
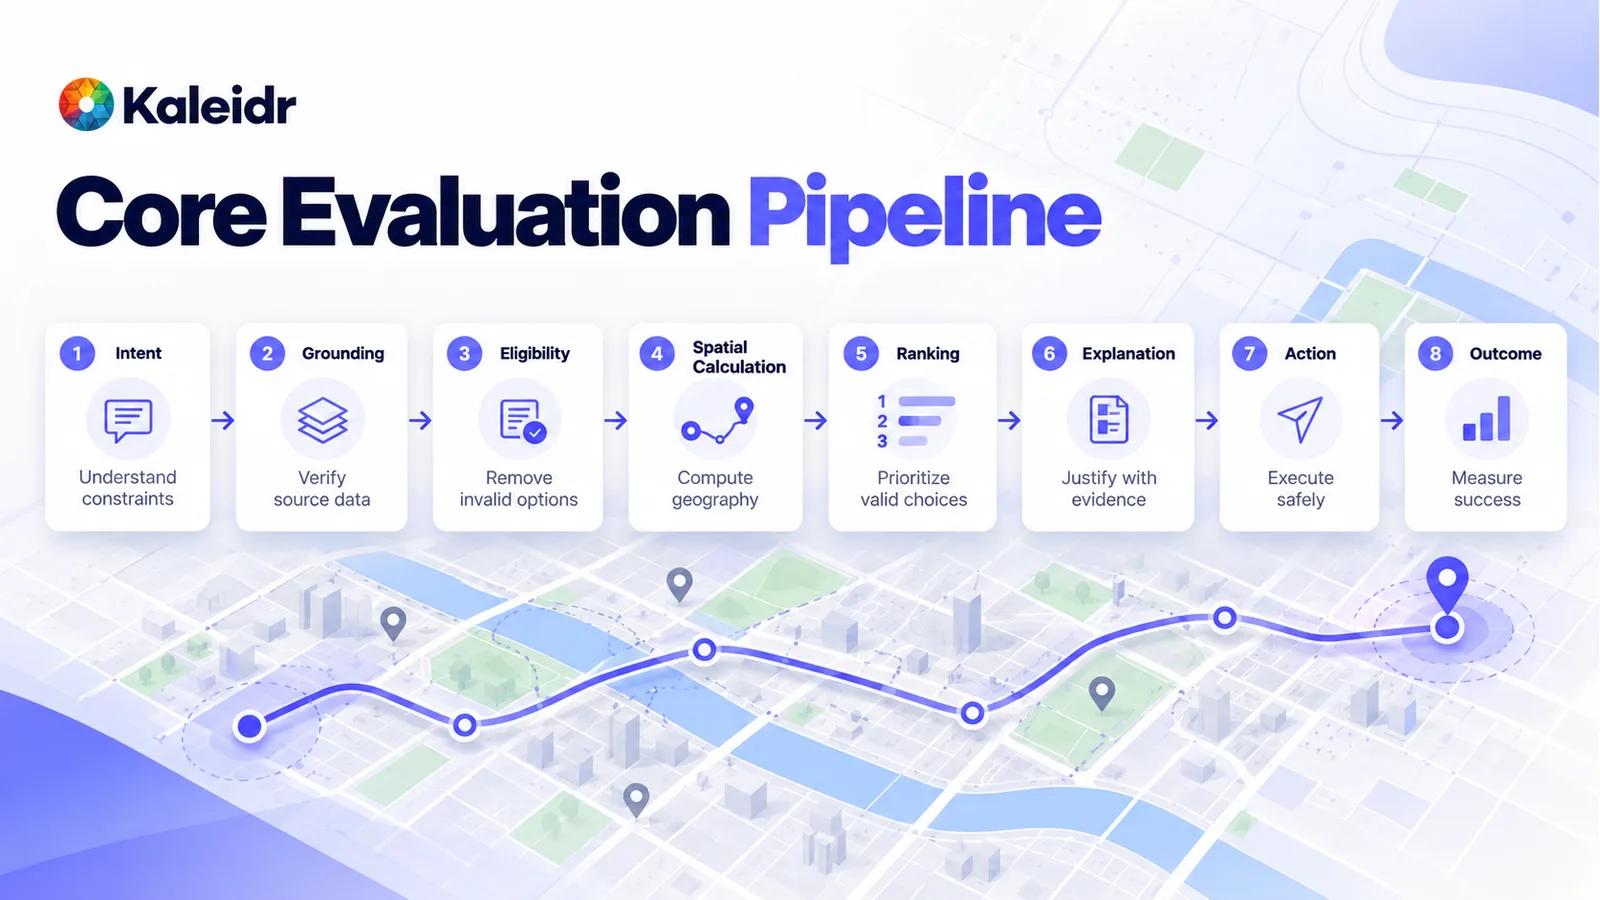
Testen Sie die Kette der Reihe nach: Einschränkungen verstehen, Quelle verifizieren, ungültige Optionen entfernen, Geografie berechnen, die verbleibenden Optionen einstufen, die Entscheidung mit Evidenz begründen, nur erlaubte Aktionen ausführen und messen, ob die Aufgabe abgeschlossen wurde.
Warum reicht ein einzelner Score nicht aus?
Ein Gesamtprozentsatz lässt sich leicht vergleichen und ebenso leicht falsch verwenden. Ein beispielhaftes Scorecard-Ergebnis kann insgesamt 92 Prozent zeigen, während die Absichtsinterpretation bei 99 Prozent, Routing bei 98 Prozent, Erklärung bei 96 Prozent und Autorisierung bei 75 Prozent liegt. Diese Zahlen sind ein Beispiel und kein Kaleidr-Ergebnis. Der Durchschnitt wirkt weiterhin stark, obwohl das System Daten offenlegen oder darauf handeln könnte, auf die die Person keinen Zugriff haben sollte. Kritische Dimensionen benötigen eigene Produktions-Gates. Hervorragende Leistung bei einer risikoarmen Aufgabe darf keinen Berechtigungsfehler, kein ungültiges Ziel, keine nicht unterstützte Aktion und keine erfundene Verfügbarkeit kompensieren.
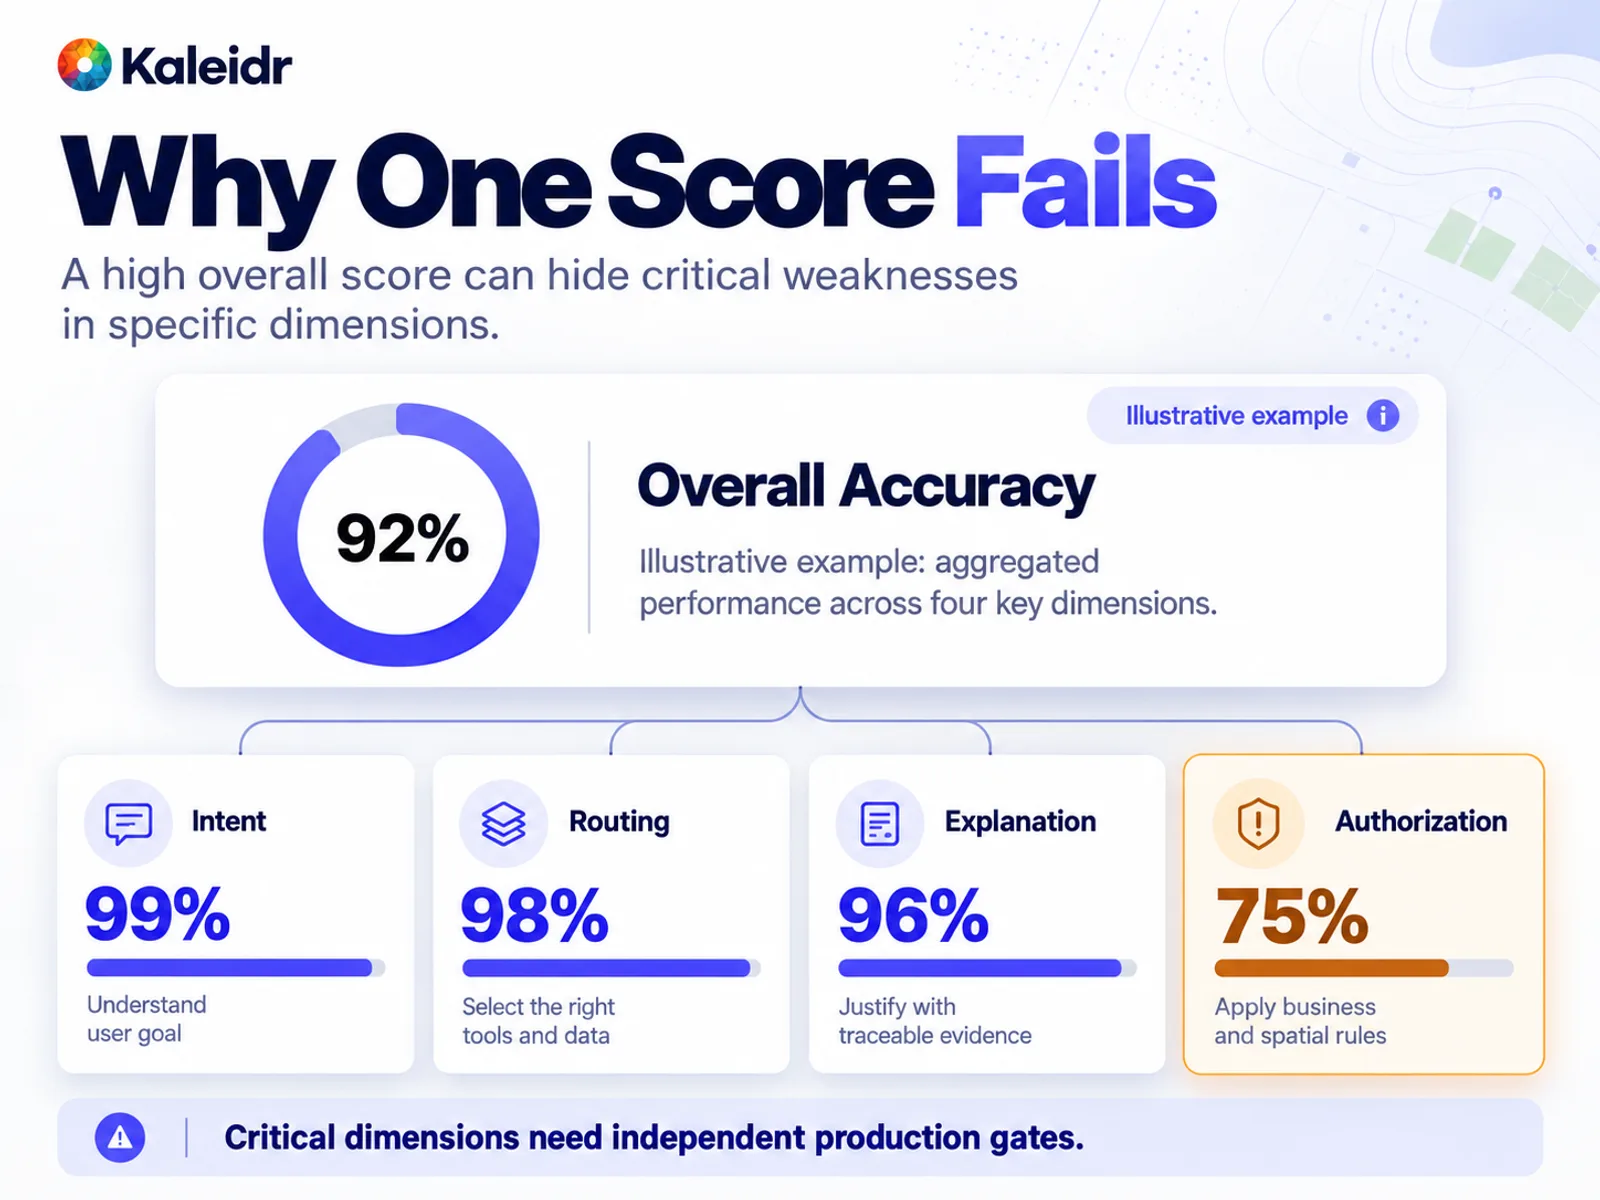
Ein hoher Gesamtwert kann ein schwaches Gate verdecken. Die Prozentwerte in dieser Abbildung sind ein illustratives Beispiel und keine gemessene Kaleidr-Leistung.
Das Playbook des NIST AI Risk Management Framework empfiehlt, die Messung mit den bedeutendsten Risiken zu beginnen und nicht gemessene Risiken zu dokumentieren. Dieselbe Playbook-Seite weist darauf hin, dass AI RMF 1.0 aktualisiert wird und das Playbook anschließend überarbeitet werden soll (NIST, 2026). Der erste öffentliche Entwurf des NIST-Frameworks TEVV-Athlon, NIST AI 200-2, wurde am 7. August 2026 angekündigt; Kommentare sind bis zum 6. Oktober 2026 möglich. Er beschreibt Evaluierung als Evidenz dafür, dass ein System individuelle oder organisatorische Ziele erreicht, mit auf diese Anforderungen zugeschnittener Messung einschließlich realer Auswirkungen (NIST, 2026). Das Dokument ist ein Entwurf zur öffentlichen Stellungnahme. Es ist keine Kaleidr-Kontrollliste. Bei einem standortbezogenen Produkt ist der relevante Kontext die geografische Entscheidung, die das Produkt tatsächlich trifft.
Wie sollten Absicht, Ort und Zulässigkeit getestet werden?
Die Absicht steht am Anfang. Eine Anfrage nach einem rollstuhlgerechten Café zwischen einem Hotel und einem Veranstaltungsort, das vor 7 Uhr geöffnet ist, bedeutet nicht „Cafés in der Nähe des Hotels“. Speichern Sie für jede Testanfrage die erwartete strukturierte Interpretation: Kategorie, geografische Beziehung, Ursprung, Ziel, Barrierefreiheit und Zeit. Messen Sie anschließend die extrahierten Einschränkungen, vom System erfundene Einschränkungen und ausgelassene Einschränkungen. Ein System, das die Kategorie erkennt, aber das Zeitfenster ignoriert, hat die Aufgabe nicht korrekt interpretiert.
Ortsbezeichnungen sind mehrdeutig. Springfield, Terminal 2, Main Street und „unsere Filiale in Austin“ können jeweils mehr als eine Entität bezeichnen. Nehmen Sie doppelte Städtenamen, identische Filialnamen, mehrere Terminals, umbenannte Orte, Abkürzungen, mehrsprachige Namen, Viertel ohne harte Grenze und Adressen an einer Verwaltungsgrenze auf. Bewerten Sie kanonische Orts-IDs statt einer String-Übereinstimmung beim Namen. Das falsche Café einen Block weiter und ein Ziel in der falschen Stadt sind beide falsch, aber nicht gleich schwerwiegend.
Zulässigkeit fragt, ob ein Ort überhaupt berücksichtigt werden darf. Ranking fragt, wie hoch ein gültiger Ort erscheinen sollte. Eine Filiale kann der nächstgelegene Pin sein und dennoch geschlossen, ausverkauft, außerhalb des Servicegebiets, vollständig ausgebucht oder durch Richtlinien ausgeschlossen sein. Diese Kandidaten sollten die Menge verlassen, bevor die übrigen Optionen gerankt werden. Die Präzision der Zulässigkeit ist die Zahl der zurückgegebenen zulässigen Orte geteilt durch alle zurückgegebenen Orte. In einem risikoreichen Workflow können wenige unzulässige Empfehlungen wichtiger sein als die durchschnittliche Ranking-Qualität. Bestand, Öffnungszeiten, Berechtigungen und Richtlinien bleiben in den Systemen, denen diese Daten gehören. Grounded Spatial AI für Geschäftsdaten zieht dieselbe Grenze für das Produkt selbst.
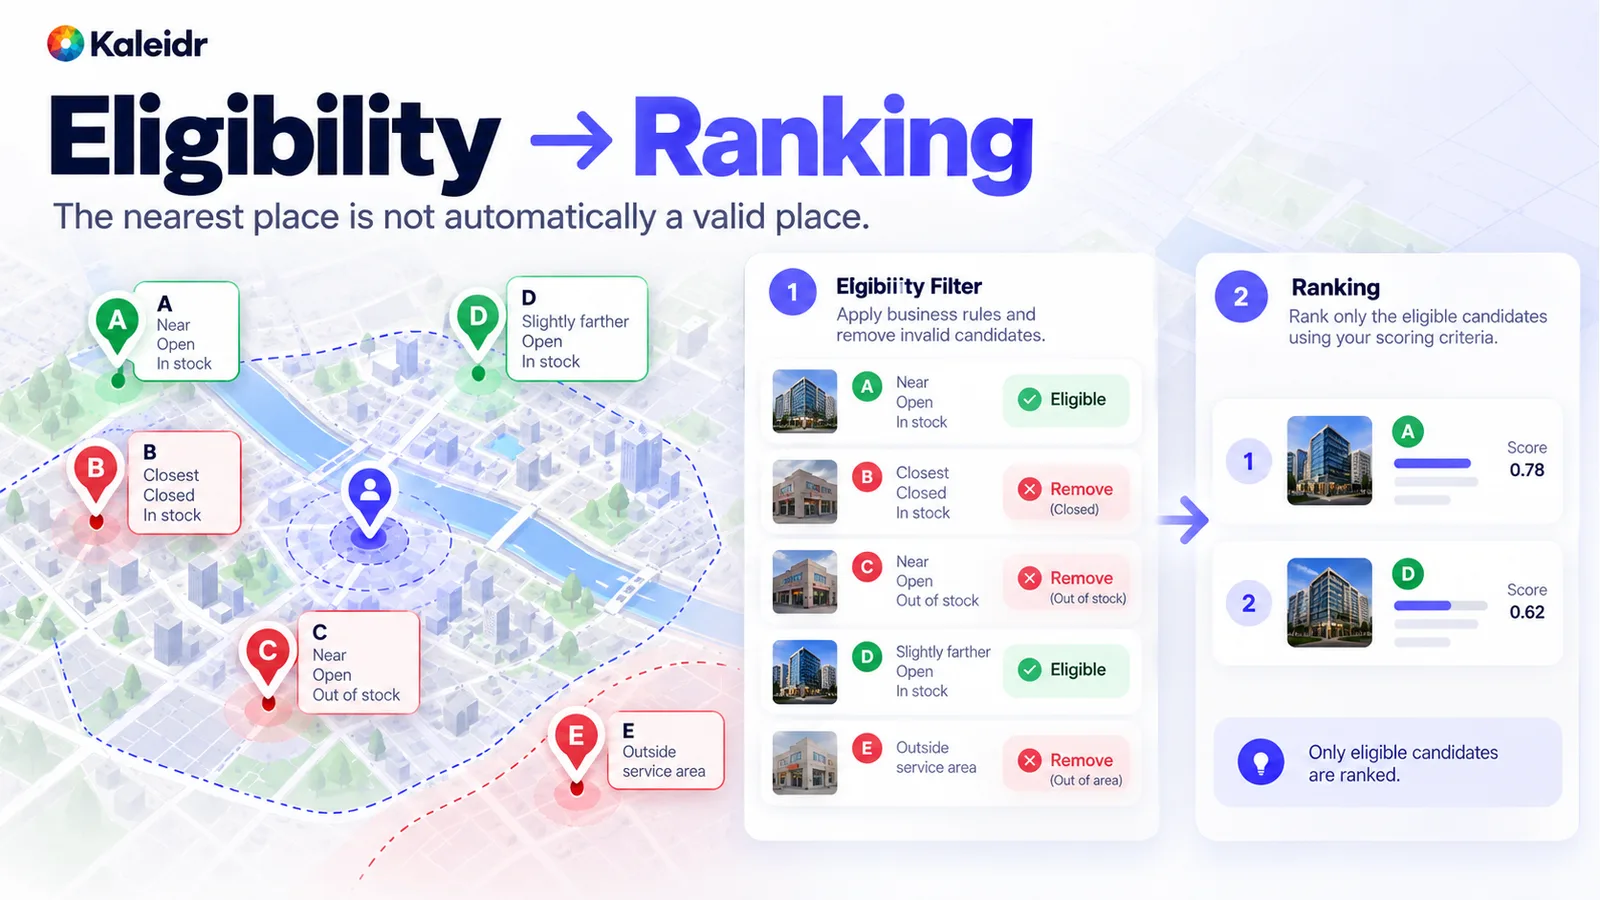
Zuerst die Zulässigkeit filtern. Der nächstgelegene Ort ist nicht automatisch ein gültiger Ort.
Wie sollten Geografie und Aktualität geprüft werden?
Ein Sprachmodell sollte nicht die Quelle der Wahrheit für eine Berechnung sein, die eine räumliche Engine ausführen kann. Punkt-in-Polygon, Routendistanz, Fahrzeit, Zugehörigkeit zu einem Servicegebiet, räumliche Enthaltung und Reihenfolge entlang einer Route gehören in diese Kategorie. Erstellen Sie die erwartete Antwort aus autoritativen geografischen Daten und einem vertrauenswürdigen Tool und vergleichen Sie dann das Anwendungsergebnis damit. Ein exakter Match passt für „Liegt dieser Punkt in diesem Polygon?“ und „Hat das System Filial-ID 172 zurückgegeben?“. Eine vorab definierte Toleranz passt zu Koordinaten, geschätzter Fahrzeit und Grenzen, die mit unterschiedlicher Auflösung gezeichnet wurden. Entscheiden Sie nicht erst nach dem Lauf, dass ein falsches Ergebnis doch nah genug war.
Aktualität ist eine eigene Frage und nicht dasselbe wie historische Korrektheit. Koordinaten und Filialidentität können stabil sein, während Öffnungszeiten, Bestand, Verkehr und Schließungen sich ändern. Verfolgen Sie den Anteil der Entscheidungen, die mit Daten außerhalb des Aktualitätsschwellenwerts getroffen wurden, sowie den Anteil zeitkritischer Felder mit bekanntem Aktualisierungszeitpunkt. Fehlende Daten sind nicht dieselbe Tatsache wie „nicht verfügbar“. Ein selbstsicheres Ja oder Nein auf Basis eines unbekannten Zustands ist ein Fehler, auch wenn der Ort selbst real ist.
Wann ist „kein Ergebnis“ die genaue Antwort?
Ein Kunde kann nach einem Ort innerhalb von zehn Minuten fragen, der nach 21 Uhr einen Artikel vorrätig hat, obwohl kein solcher Ort existiert. Ein schwaches System lockert die Einschränkung stillschweigend und gibt eine Filiale zwanzig Minuten entfernt zurück. Ein geerdetes System sagt, dass keine verifizierte Option alle Bedingungen erfüllt. Benchmarks sollten absichtlich unlösbare Aufgaben enthalten und anschließend die Rate korrekt erkannter „kein Ergebnis“-Fälle sowie die Rate falscher Empfehlungen messen. GeoBenchX, ein Benchmark aus dem Jahr 2025 für Tool-Calling-Agenten bei mehrstufigen Geospatial-Aufgaben, enthält sowohl lösbare als auch absichtlich unlösbare Aufgaben, damit die Ablehnungsgenauigkeit gemessen werden kann (Krechetova and Kochedykov, 2025). Die Arbeit bewertet Forschungsagenten. GeoBenchX bewertet Kaleidr nicht, und ein Produktteam sollte weiterhin eigene unlösbare Fälle für die eigene Aufgabe schreiben.
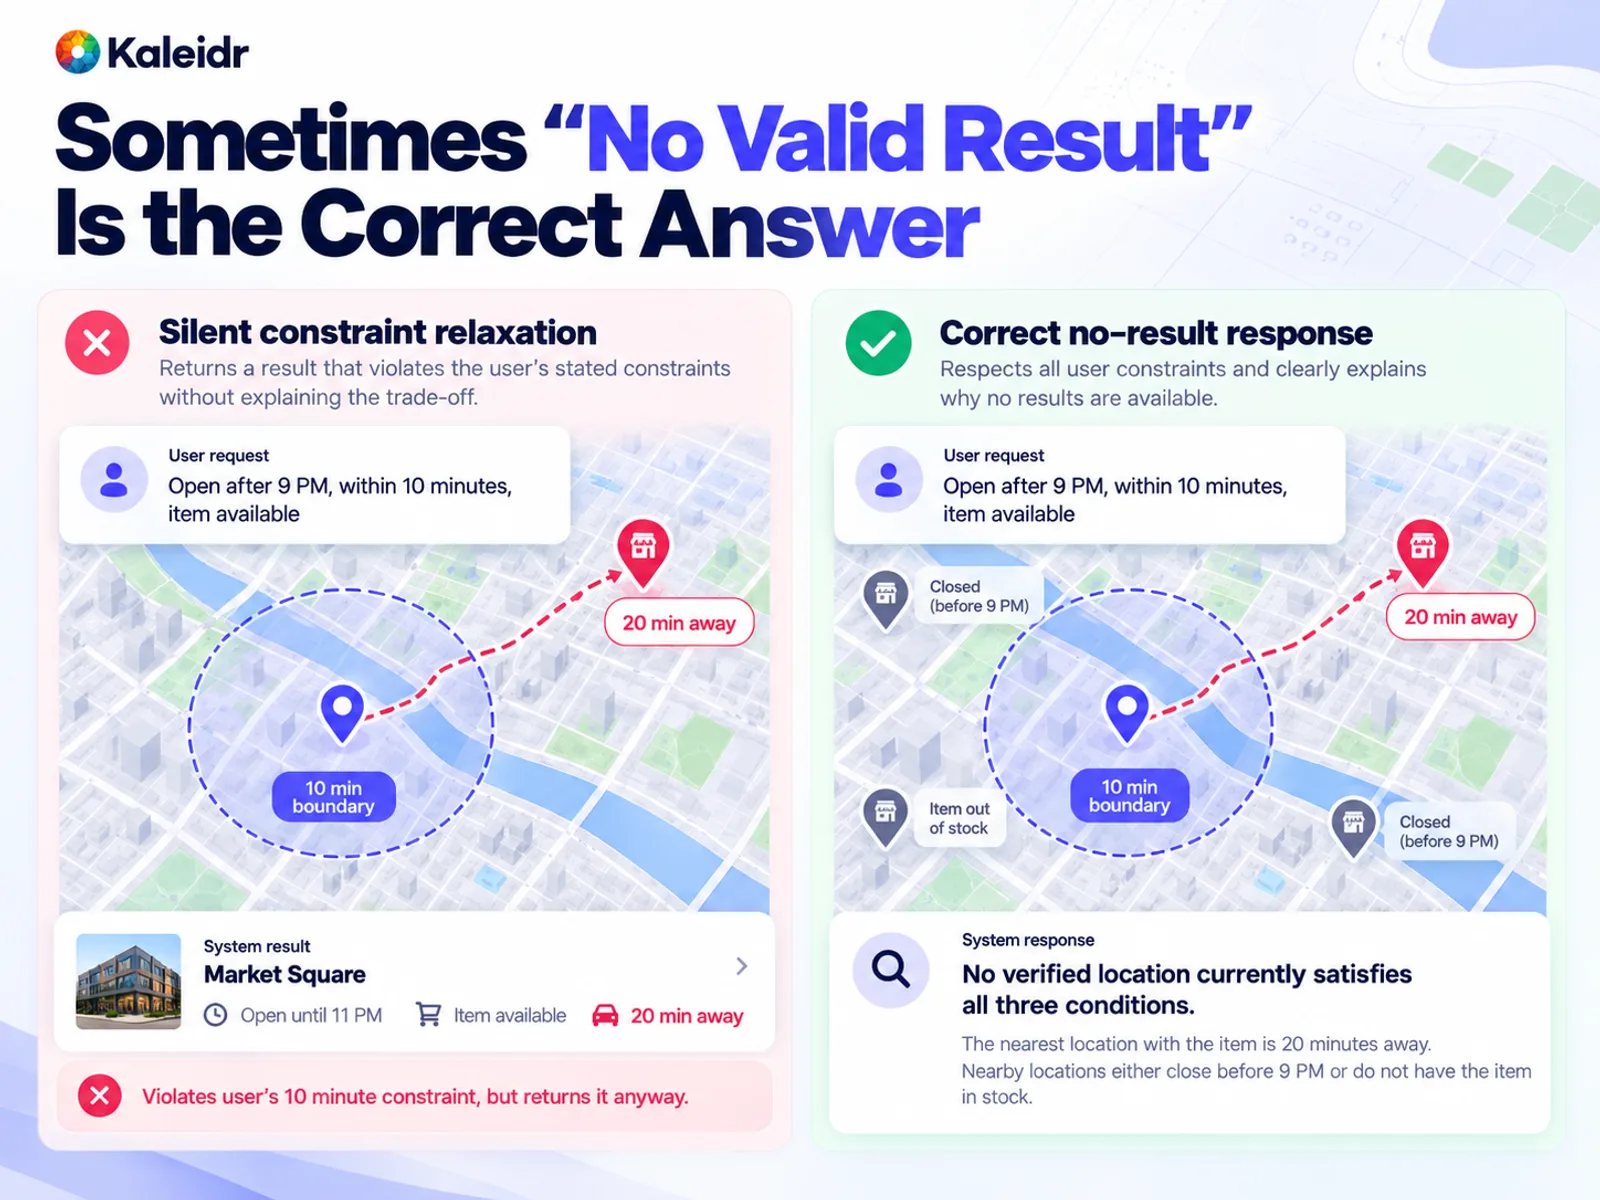
Manchmal ist „kein gültiges Ergebnis“ die korrekte Antwort. Einen Ort außerhalb der angegebenen Zeit oder Entfernung zurückzugeben, ist eine falsche Empfehlung und kein hilfreicher Fallback.
Wie sollten Ranking, Erklärung und Aktionen bewertet werden?
Ranken Sie erst, nachdem ungültige Kandidaten entfernt wurden. Der nächstgelegene Ort ist nicht automatisch der beste. Fahrzeit, Routenabweichung, Verfügbarkeit, Barrierefreiheit, Preis, Öffnungsfenster und Geschäftspriorität können Teil des Ziels sein, wenn das Produkt dies so definiert. Nützliche Messgrößen sind unter anderem, wie oft das erste Ergebnis akzeptabel ist, wie oft eine akzeptable Wahl unter den ersten K Ergebnissen erscheint, die Übereinstimmung mit einer von Menschen geprüften oder policy-basierten Reihenfolge und der Regret gegenüber der stärksten bekannten zulässigen Option. Behandeln Sie Engagement nicht als Ranking-Qualität. Verbinden Sie die Reihenfolge mit der Aktion, die der Kunde ausführen musste.
Eine Erklärung wie „bis 22 Uhr geöffnet, Artikel verfügbar, sechs Minuten zusätzlicher Fahrtweg“ ist nur dann genau, wenn jede Aussage auf Evidenz zurückgeführt werden kann, die das System tatsächlich verwendet hat. Prüfen Sie Ortsidentität, Verfügbarkeitsaussage, Öffnungszeiten, ob eine Route tatsächlich berechnet wurde und ob der Text zur Ranking-Entscheidung passt. Ein eleganter Absatz kann trotzdem falsch sein. Ein kurzer holpriger Satz kann richtig sein. Messen Sie verifizierte Aussagen im Verhältnis zu allen Tatsachenbehauptungen in der Erklärung.
Aktionen sind Teil der Antwort. Die Karte zu verschieben, einen Marker hinzuzufügen, eine Route anzufordern, einen Filter zu ändern oder eine Buchung zu starten, kann falsch sein, selbst wenn der Satz richtig ist. Verfolgen Sie, ob die Aktion zum Vokabular der Anwendung gehört, ob Ziel und Parameter korrekt sind und ob die Person sie ausführen durfte. Ein korrekter Satz mit der falschen Kartenaktion ist weiterhin eine fehlgeschlagene Interaktion.
Welche Fehlerfälle gehören in den Benchmark?
Ein Testset, das nur aus sauberen Beispielen besteht, die das Team bereits lösen kann, überschätzt die Zuverlässigkeit. Nehmen Sie mehrdeutige Namen, doppelte Filialen, Adressen am Rand eines Servicegebiets, unlösbare Anfragen, eine gerade geschlossene Filiale, Bestand, der nicht zum Ort passt, einen nahen Pin mit großer Routenabweichung, eine Schließzeit vor der Ankunft, eine private Einrichtung, die der Nutzer nicht sehen darf, einen lokalen Namen, der vom englischen Namen abweicht, unbekannte Öffnungszeiten, eine öffentliche Quelle, die First-Party-Daten widerspricht, abgerufenen Text, der versucht, das Modell zu steuern, sowie einen ausgefallenen Routing- oder Geschäftsdatenservice auf. Ziel ist, die Entscheidungen nachzubilden, denen die Produktion tatsächlich begegnen wird.
Abgerufener Text, der versucht, das Modell zu steuern, ist ein Prompt-Injection-Fall. OWASP beschreibt LLM01:2025 Prompt Injection als Benutzer- oder abgerufene Eingabe, die das Modellverhalten unbeabsichtigt verändert, einschließlich Einfluss auf eine kritische Entscheidung, und weist darauf hin, dass Retrieval-Augmented Generation die Schwachstelle nicht vollständig beseitigt (OWASP, 2025). Ordnen Sie diesen Fall der Sicherheitsfamilie des Testsets zu, neben Berechtigungen, statt Sicherheit als späteren Anhang zu behandeln.
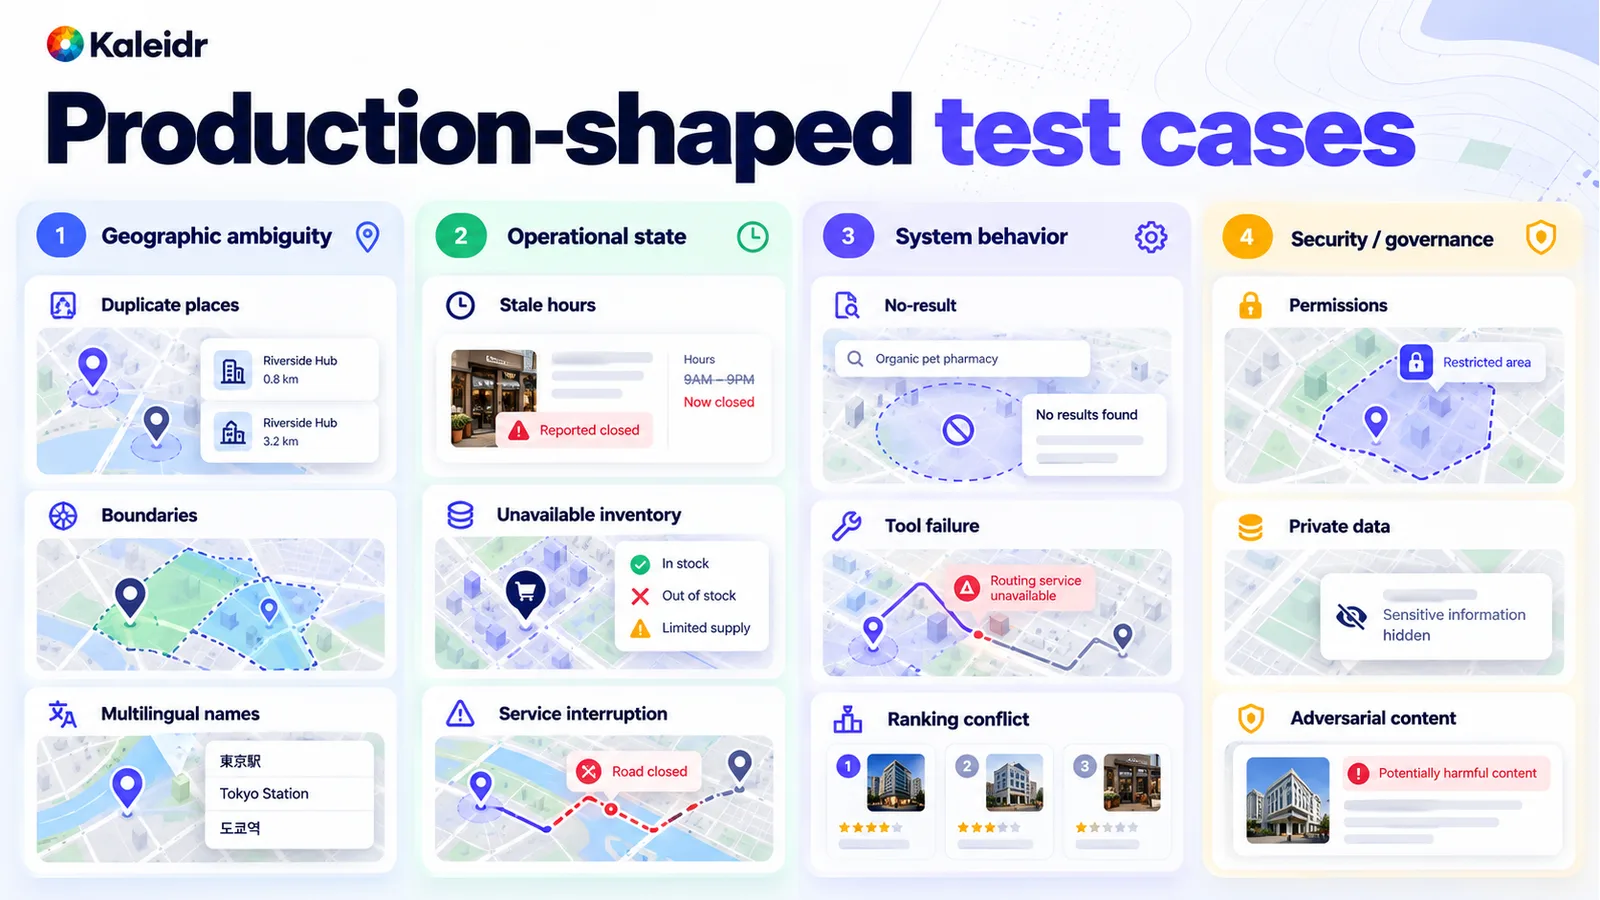
Produktionsnahe Fälle decken geografische Mehrdeutigkeit, Betriebszustand, Systemverhalten und Sicherheit ab. Ein Benchmark, der sie auslässt, überschätzt die Zuverlässigkeit.
Warum muss Ground Truth vor dem Lauf existieren?
Jeder Fall braucht genügend aufgezeichnete Wahrheit, um zu definieren, was korrekt bedeutet: Anfrage, Nutzerkontext, autorisierte Quellen, erwartete Absicht, erforderliche Einschränkungen, kanonische Orte, zulässige Menge, erwartete räumliche Beziehung, bestes Ergebnis, akzeptable Alternativen, erwartete Aktion, Grund für ein korrektes „kein Ergebnis“, Toleranz und Schweregrad bei einem Fehler. Schreiben Sie diesen Datensatz, bevor das System läuft. Den Lösungsschlüssel an das anzupassen, was das Modell ausgegeben hat, ist keine Evaluierung.
GISAgentBench, ein 2026 veröffentlichter, von Praktikern zusammengestellter Benchmark mit 349 mehrstufigen GIS-Aufgaben, argumentiert, dass vielen GIS-Agenten-Benchmarks Ground-Truth-Ausgaben fehlen und sie stattdessen Ersatzsignale wie Code-Ähnlichkeit, Trajektorienabgleich oder einen Modell-Judge verwenden, wodurch ein ähnlicher Workflow fälschlich als korrektes Ergebnis gewertet werden kann. Jede GISAgentBench-Aufgabe enthält eine exakte Ground-Truth-Ausgabedatei (Pothuri et al., 2026). Verwenden Sie Code oder einen autoritativen Datensatz überall dort, wo die Frage deterministisch ist: Koordinaten, Enthaltung, kanonische ID, geöffnet oder geschlossen, Berechtigung und welcher API-Aufruf ausgeführt wurde. Nutzen Sie menschliche Prüfung oder eine kalibrierte modellgestützte Prüfung für tatsächlich subjektive Fragen, etwa ob eine Erklärung verständlich ist. Der Evaluator sollte zur Art der getesteten Wahrheit passen.
Wie sollten Teams segmentierte Ergebnisse lesen?
Ein Durchschnitt kann eine schwache Geografie verdecken. Brechen Sie Ergebnisse nach Land, Markt, Sprache, urbaner und ländlicher Abdeckung, Datenanbieter, Ortskategorie, Filialdichte, Anfragekomplexität und Routentyp auf. Angenommen, die gesamte Rate gültiger Ergebnisse liegt bei 95 Prozent und ein neu gestarteter Markt bei 78 Prozent. Dieses Zahlenpaar ist ein hypothetisches Beispiel und keine Kaleidr-Messung. Der Durchschnitt kann mathematisch korrekt sein und trotzdem die falsche Zahl für eine Skalierungsentscheidung. Untersuchen Sie, wo Fehler auftreten, und ordnen Sie jeden fehlgeschlagenen Fall einer Kategorie zu: Interpretation, Entitätsauflösung, Grounding, Zulässigkeit, räumliche Berechnung, Aktualität, Ranking, Erklärung, Aktion, Sicherheit oder Wiederherstellung. Die Kategorie zeigt dem Team, was verändert werden muss. Ein Routing-Fehler ist kein Erklärungsproblem.
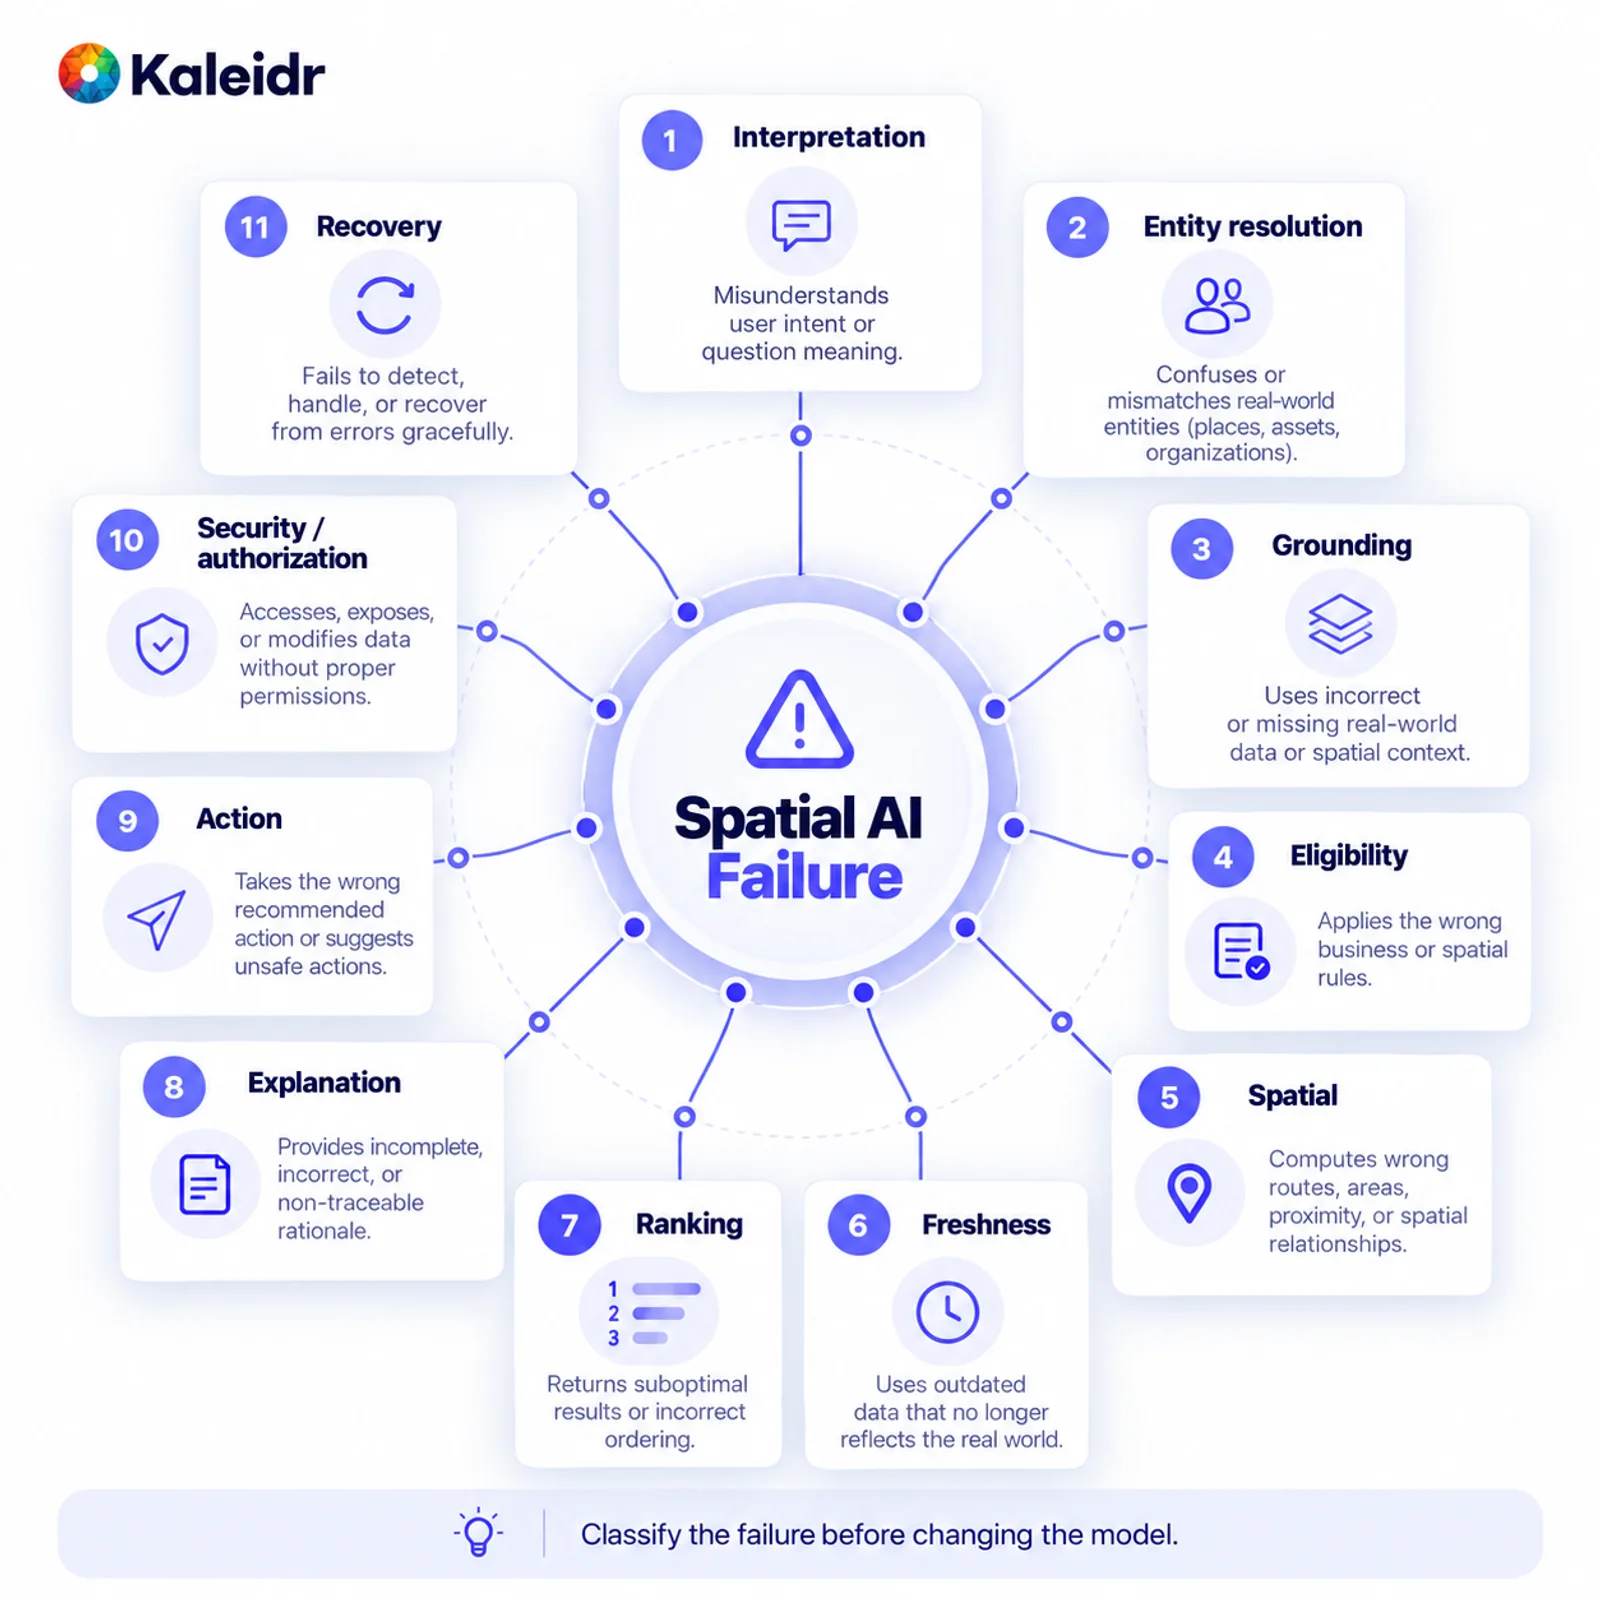
Klassifizieren Sie den Fehler, bevor Sie das Modell ändern. Gleichberechtigte Kategorien verhindern, dass ein seltener, schwerwiegender Fehler in einem großen Durchschnitt verschwindet.
Generative Läufe variieren ebenfalls. Erfassen Sie für wichtige Fälle den Durchschnitt, den schlechtesten beobachteten Lauf und wie oft sich der Fehler wiederholt. Eine Anfrage, die neunmal sicher und einmal falsch ist, hat ein anderes Risiko als eine Anfrage, die jedes Mal dieselbe sichere Antwort liefert. Wiederholen Sie das Testset, wenn Prompts, Modelle, Retrieval, Ranking, Datenanbieter, Tools oder Abdeckung geändert werden. Evaluierung gehört ins Release-Management und nicht in einen einmaligen Bericht vor dem Launch.
Was gehört auf eine Produktions-Scorecard?
Geben Sie jeder Dimension eine eigene Metrik und ein eigenes Gate. Für Absicht eignet sich die Extraktion von Einschränkungen. Für Ortsidentität eignet sich die Genauigkeit kanonischer Orte. Für Autorisierung und Sicherheit kann eine Rate nicht autorisierter Zugriffe verwendet werden, bei der geschützte Daten keine Treffer tolerieren. Zulässigkeit, räumliche Berechnung, Aktualität, Ranking, „kein Ergebnis“-Behandlung, Erklärung, Aktionen und Ergebnis brauchen jeweils einen Schwellenwert, den der Product Owner vor dem Lauf festlegt. Übernehmen Sie keinen universellen Grenzwert aus einer anderen Anwendung. Eine lockere Restaurantempfehlung und eine Routing-Entscheidung mit Sicherheitsfolgen haben nicht dasselbe Fehlerbudget.
| Dimension | Beispielmetrik | Beispiel-Gate |
|---|---|---|
| Absicht | Genauigkeit der Einschränkungsextraktion | Für dieses Produkt festlegen |
| Ortsidentität | Genauigkeit kanonischer Orte | Sehr hoch |
| Autorisierung | Rate nicht autorisierter Zugriffe | Keine für geschützte Daten toleriert |
| Zulässigkeit | Präzision zulässiger Ergebnisse | Sehr hoch |
| Räumliche Berechnung | Korrekt innerhalb einer vorab definierten Toleranz | Für dieses Produkt festlegen |
| Aktualität | Anteil der Ergebnisse innerhalb des Aktualitätsfensters | Für dieses Produkt festlegen |
| Ranking | Top-1- oder Top-K-Akzeptanz | Für dieses Produkt festlegen |
| Kein-Ergebnis-Behandlung | Rate korrekter Ablehnungen | Hoch |
| Erklärung | Rate belegter Aussagen | Hoch |
| Aktionen | Rate gültiger, korrekt parametrisierter Aktionen | Sehr hoch |
| Ergebnis | Abschluss der standortabhängigen Aufgabe | Muss die beabsichtigte Aufgabe verbessern |
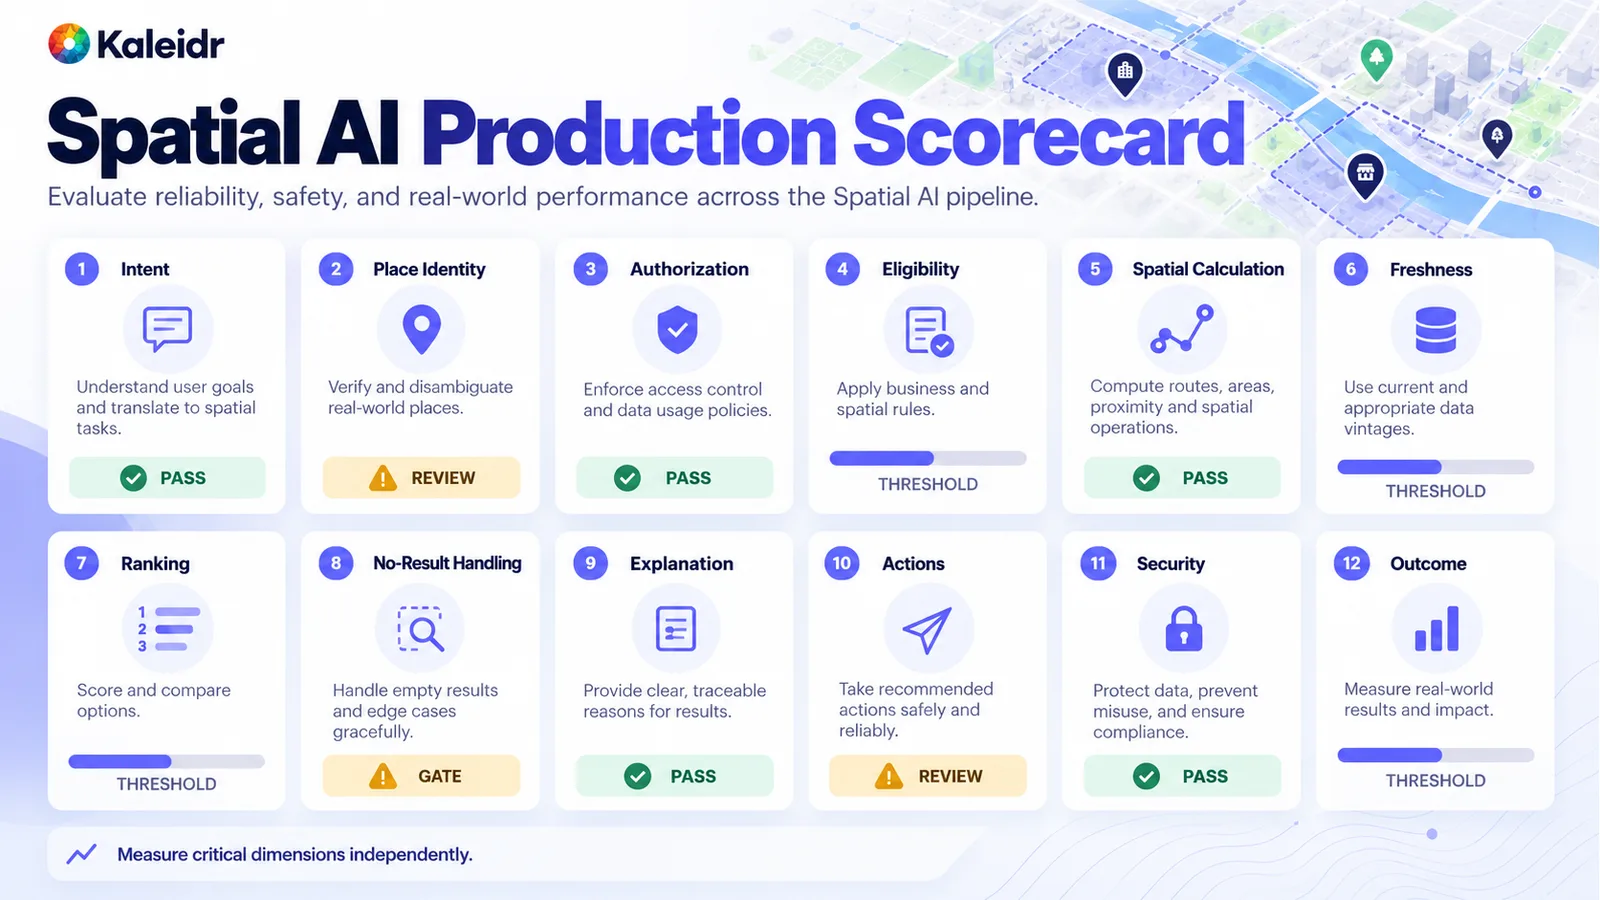
Messen Sie kritische Dimensionen unabhängig voneinander. Statusbezeichnungen auf dieser Scorecard sind Platzhalter und keine Kaleidr-Benchmark-Scores.
Wie sollte ein Team über die Skalierung entscheiden?
Nutzen Sie die Gates und keinen vermischten Gesamtwert. Skalieren Sie, wenn gültige, geerdete und räumlich korrekte Ergebnisse unter produktionsnahen Bedingungen Bestand haben, kritische Fehlerklassen kontrolliert sind, die Betriebsdaten klar verantwortet werden und sich das beabsichtigte Ergebnis verbessert. Iterieren Sie, wenn die Aufgabe wertvoll ist und eine behebbare Schicht noch schwach ist. Verengen Sie den Umfang, wenn der Pilot zu viele Geografien, Quellen oder Aufgaben vermischt, um erkennen zu können, was fehlgeschlagen ist. Stoppen Sie, wenn das Team keine autoritativen Daten benennen, einen kritischen Fehler nicht kontrollieren, die Aufgabe nicht definieren oder keine Verbesserung gegenüber dem aktuellen Workflow zeigen kann. Ein Enterprise-Spatial-AI-Pilot ist der begrenzte Test. Die Scorecard macht aus diesem Test eine Entscheidung.
Wo passt Kaleidr in die Evaluierung?
Kaleidr Enterprise beschreibt Location-Intelligence-Infrastruktur mit Inference-APIs, Ranking-Systemen, Analytics und Deployment-Unterstützung, einschließlich Chat, Editing, Tiles und einbettbaren Viewern, die ein Host neben einer bereits betriebenen Karte ergänzen kann (Kaleidr, 2026). Die Host-Anwendung behält die Geschäftssysteme, die sie besitzt: Bestand, Berechtigungen, Kundenstatus, Buchung und weitere private Betriebsdaten. Räumliche Tools übernehmen Berechnungen, die deterministisch ausgeführt werden können. Die Sprachmodellschicht interpretiert die Absicht, koordiniert unterstützte Fähigkeiten und erklärt geerdete Ergebnisse. Die öffentliche Analytics-Seite von Kaleidr mit dem Titel Map Engagement and Location Analytics beschreibt Reichweite, Views, Engagement, Standort und Aktivität des Publikums, Sitzungen und Interaktionen pro Karte, Ortsvergleiche und räumliche Muster (Kaleidr, 2026). Diese Berichte beschreiben Karten- und Ortsverhalten. Abgeschlossene Buchungen, Bestellungen und qualifizierte Leads bleiben in den Host-Systemen, die diese Datensätze führen.
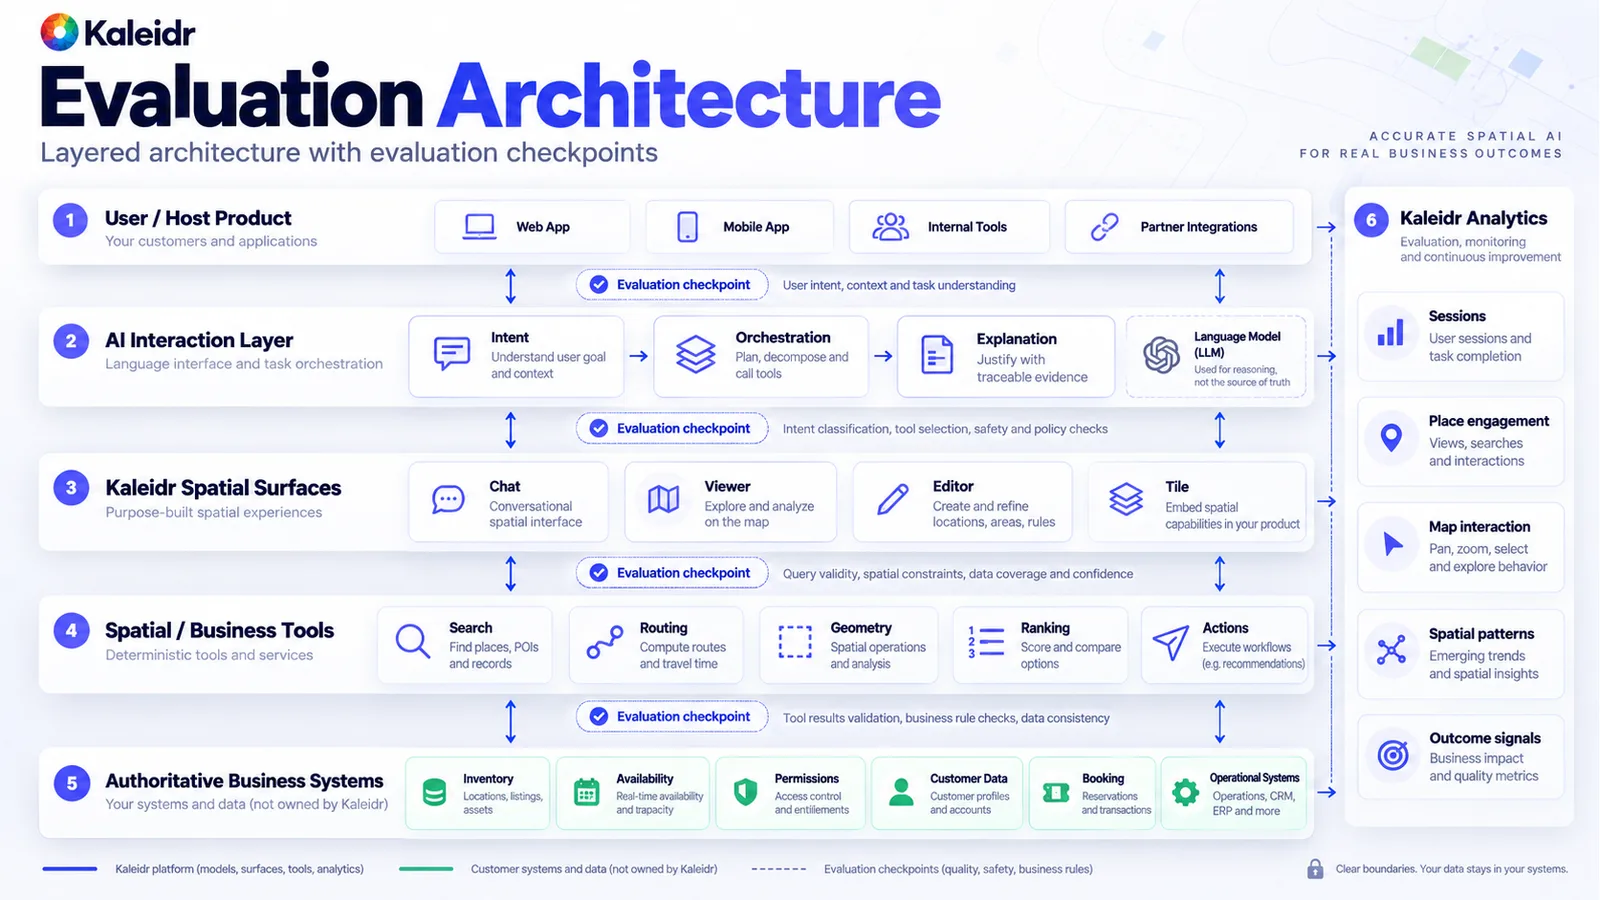
Das Sprachmodell ist nicht die Quelle der Wahrheit für Bestand, Berechtigungen oder eine Route. Checkpoints zwischen den Schichten zeigen, welcher Teil fehlgeschlagen ist.
Welche Fehler verbergen einen schwachen Benchmark?
Happy-Path-Fragen ohne Mehrdeutigkeit, fehlende Daten oder unlösbare Anforderungen überschätzen die Zuverlässigkeit. Nur die Ähnlichkeit der Formulierung mit einer Referenz zu bewerten, übersieht eine korrekt getroffene, aber anders formulierte Entscheidung und belohnt einen falschen Ort, der im Stil der Referenz geschrieben wurde. Eine Menge zu ranken, die noch unzulässige Orte enthält, versteckt den Zulässigkeitsfehler. Das Modell eine Distanz prüfen zu lassen, die eine räumliche Engine berechnen kann, ersetzt eine Berechnung durch Sprachflüssigkeit. Das Ignorieren von Aktualität behandelt die Öffnungszeiten von gestern wie die von heute. Mehr Karteninteraktion als Genauigkeit zu werten, verwechselt Interesse mit Erfolg und manchmal mit Verwirrung. Eine Toleranz nach dem Ansehen der Zahlen zu ändern, ist kein Benchmark. Nur das Modell zu testen ignoriert Retrieval, Daten, Tools, Berechtigungen, Ranking und Interface. Das Produktionsverhalten entsteht aus dem zusammengesetzten Produkt.
Forschungsbenchmarks helfen weiterhin als Fähigkeitsproben. GeoBenchLLM, im August 2026 eingereicht und für CIKM 2026 angenommen, bewertet Sprachmodelle bei geo-bezogenen Aufgaben aus öffentlichen Datensätzen, einschließlich geo-räumlichem und zeitlichem Verständnis (Rodrigues et al., 2026). GeoAI-Benchmarks decken häufig Fernerkundung, GIS-Workflows, Bilddaten oder Aufgaben geospatialer Modelle ab. Ein Produktbenchmark kann zusätzlich Grounding auf Geschäftsdaten, Berechtigungen, Live-Verfügbarkeit, Ranking, Kartenaktionen und das Kundenergebnis benötigen. Ein einzelner öffentlicher Benchmark kann nicht die Aufgabe jedes Produkts vertreten.
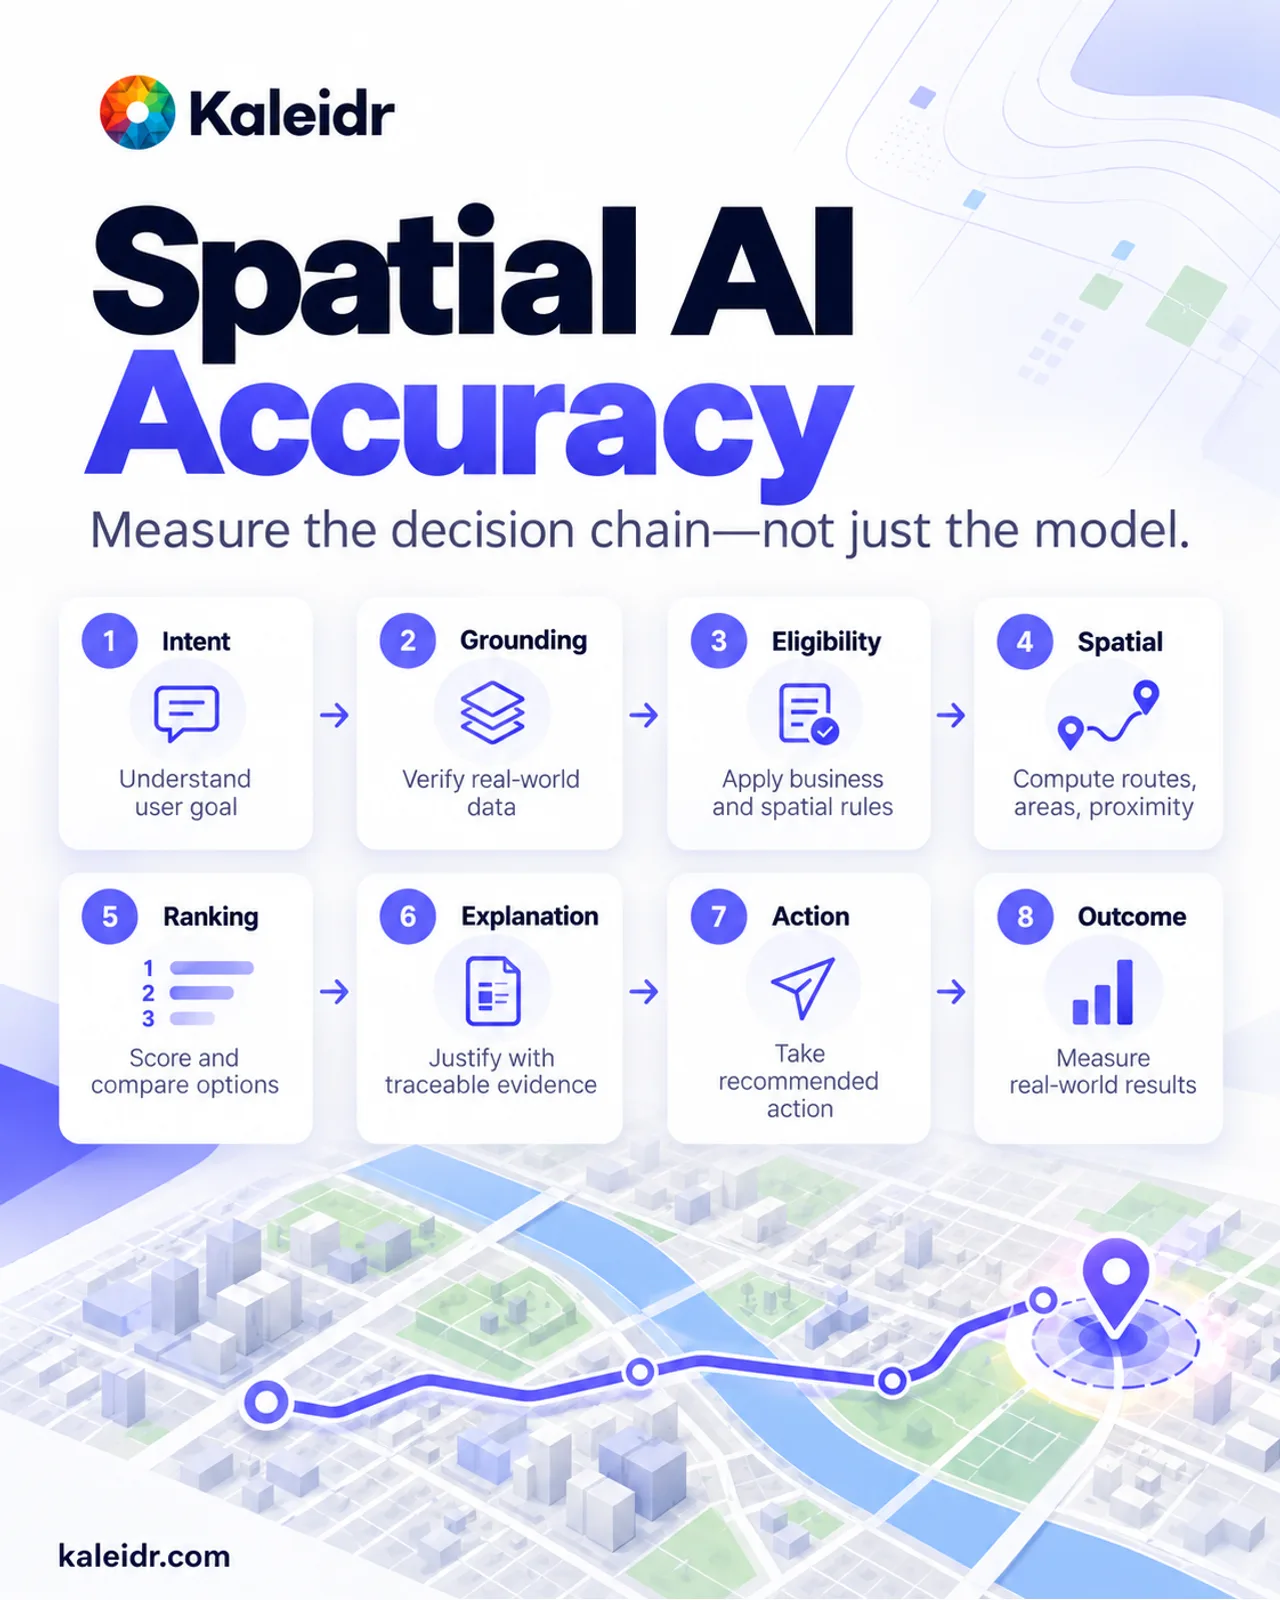
Messen Sie die Entscheidungskette und nicht nur das Modell. Die acht Stufen sind der Evaluierungsrahmen und kein gemeldeter Score.
Wie wird Evaluierung zu einem Release-Gate?
Bauen Sie das Testset vor der Skalierung auf. Nehmen Sie die Fehlerfälle auf. Halten Sie deterministische Wahrheit außerhalb des Sprachmodells, wo ein Tool oder Datensatz antworten kann. Verfolgen Sie kritische Dimensionen mit eigenen Gates. Wiederholen Sie den Lauf, wenn sich das System ändert, und verbinden Sie das Offline-Ergebnis mit dem Produktionsergebnis, das die Aufgabe verbessern sollte. Die nützliche Frage lautet, ob dieses System die standortabhängige Entscheidung treffen kann, die das Produkt verspricht, mit den richtigen Daten, der richtigen Geografie, den richtigen Berechtigungen und Aktionen, und ob das Team dies belegen kann.
Kaleidr Enterprise entdecken, um standortbezogene AI neben den bereits betriebenen Systemen eines Produkts hinzuzufügen und einen fokussierten Pilot zu definieren. Kaleidr Analytics entdecken, um zu sehen, wie Zielgruppen die Karten und Orte in diesem Pilot nutzen. Das Host-System behält die Verantwortung für das Geschäftsergebnis und die Entscheidung zur Skalierung.
FAQs
Wie misst man die Genauigkeit von Spatial AI?
Messen Sie die Stufen der Standortentscheidung: Absicht, Ortsauflösung, Autorisierung, Zulässigkeit, geografische Berechnungen, Aktualität, Ranking, Erklärung, Aktion und das Nutzer- oder Geschäftsergebnis. Reduzieren Sie diese Kette nicht auf einen einzigen Modell-Score.
Ist das dasselbe wie die Genauigkeit eines Sprachmodells?
Nein. Ein Sprachmodell ist nur eine Komponente. Ortsdatenbanken, Geschäftsdaten, räumliche Engines, Routing, Ranking, Berechtigungen und Anwendungsstatus können alle beeinflussen, ob das Ergebnis korrekt ist.
Sollte ein Sprachmodell Entfernungen berechnen?
Verwenden Sie ein geografisches oder Routing-Tool, wenn das Produkt eine Distanz oder Reisebeziehung benötigt. Das Modell kann entscheiden, wann die Berechnung erforderlich ist, und das Ergebnis erklären. Der räumliche Dienst führt die Berechnung aus.
Sollten Benchmarks unmögliche Fragen enthalten?
Ja. Absichtlich unlösbare Aufgaben zeigen, ob das System eine geerdete „kein Ergebnis“-Antwort liefert, statt einen Ort zu erfinden oder stillschweigend eine Einschränkung fallen zu lassen.
Wie oft sollte die Evaluierung laufen?
Führen Sie sie vor dem Produktivbetrieb aus und erneut, wenn sich Modelle, Prompts, Datenanbieter, Ranking, räumliche Tools, Berechtigungen oder Abdeckung ändern. Beobachten Sie das Produktionsverhalten kontinuierlich. Ein Bericht zum Launch-Tag ist kein Release-Prozess.
Kann ein Benchmark jedes System vergleichen?
Forschungsbenchmarks können eine klar benannte Fähigkeit vergleichen. Eine Produktionsevaluierung muss die geografische Aufgabe, die Daten, Risiken, Tools und das Ergebnis der jeweiligen Anwendung widerspiegeln. GeoAI-Benchmarks und Produktbenchmarks sind nicht austauschbar.
Referenzen
- National Institute of Standards and Technology. AI RMF Playbook, Measure. Notes that the AI RMF 1.0 is being updated and that the playbook will be revised afterward. Accessed September 29, 2026. https://airc.nist.gov/airmf-resources/playbook/measure/
- National Institute of Standards and Technology. The TEVV-Athlon Framework for Evaluating AI Systems. NIST AI 200-2, initial public draft. Announced August 7, 2026; comments through October 6, 2026. https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems
- Krechetova, Varvara, and Denis Kochedykov. GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks. arXiv:2503.18129, submitted March 23, 2025, revised October 22, 2025. https://arxiv.org/abs/2503.18129
- Pothuri, Abhinav, Zhe Jiang, Zelin Xu, and Di Yang. GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks. arXiv:2608.01645, submitted August 3, 2026. https://arxiv.org/abs/2608.01645
- Rodrigues, Rodrigo Ferreira, Karim Radouane, Jose G. Moreno, and Lynda Tamine. GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks. arXiv:2608.07411, submitted August 7, 2026. Accepted at CIKM 2026. https://arxiv.org/abs/2608.07411
- OWASP Gen AI Security Project. LLM01:2025 Prompt Injection. Accessed September 29, 2026. https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed September 29, 2026. https://kaleidr.com/enterprise
- Kaleidr. Map Engagement and Location Analytics. Accessed September 29, 2026. https://kaleidr.com/analytics
- Kaleidr. Grounded Spatial AI for Business Data. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- Kaleidr. An Enterprise Spatial AI Pilot Before Scaling. https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling
@misc{nist_rmf_playbook_measure_2026,
  title  = {AI RMF Playbook, Measure},
  author = {{National Institute of Standards and Technology}},
  year   = {2026},
  note   = {Accessed September 29, 2026. Page states the playbook will be updated after the AI RMF revision},
  url    = {https://airc.nist.gov/airmf-resources/playbook/measure/}
}

@techreport{nist_ai_200_2_2026,
  title       = {The TEVV-Athlon Framework for Evaluating AI Systems},
  author      = {{National Institute of Standards and Technology}},
  institution = {National Institute of Standards and Technology},
  number      = {NIST AI 200-2},
  year        = {2026},
  note        = {Initial public draft, announced August 7, 2026},
  url         = {https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems}
}

@misc{krechetova_geobenchx_2025,
  title  = {GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks},
  author = {Krechetova, Varvara and Kochedykov, Denis},
  year   = {2025},
  note   = {arXiv:2503.18129, revised October 22, 2025},
  url    = {https://arxiv.org/abs/2503.18129}
}

@misc{pothuri_gisagentbench_2026,
  title  = {GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks},
  author = {Pothuri, Abhinav and Jiang, Zhe and Xu, Zelin and Yang, Di},
  year   = {2026},
  note   = {arXiv:2608.01645, submitted August 3, 2026},
  url    = {https://arxiv.org/abs/2608.01645}
}

@misc{rodrigues_geobenchllm_2026,
  title  = {GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks},
  author = {Rodrigues, Rodrigo Ferreira and Radouane, Karim and Moreno, Jose G. and Tamine, Lynda},
  year   = {2026},
  note   = {arXiv:2608.07411, submitted August 7, 2026, accepted at CIKM 2026},
  url    = {https://arxiv.org/abs/2608.07411}
}

@misc{owasp_llm01_2025,
  title  = {LLM01:2025 Prompt Injection},
  author = {{OWASP Gen AI Security Project}},
  year   = {2025},
  note   = {Accessed September 29, 2026},
  url    = {https://genai.owasp.org/llmrisk/llm01-prompt-injection/}
}

@misc{kaleidr_enterprise_accuracy_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_analytics_accuracy_2026,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/analytics}
}