
Spatial AI 정확도는 위치 인식 시스템이 요청을 올바르게 해석하고, 적절한 장소를 식별하며, 권한이 있는 최신 데이터를 사용하고, 지리를 정확히 계산하며, 적격한 옵션만 랭킹하고, 근거를 설명하고, 유효한 액션만 실행하는지를 측정합니다. 답변이 유창해도 사용자를 잘못된 지점으로 보낼 수 있습니다. 하나의 모델 점수만으로는 이런 문제를 보여줄 수 없습니다. benchmark는 프로덕션 이전에 제품이 실제로 약속하는 작업을 테스트해야 합니다.
아래에서는 의사결정 체인, 하나의 평균값이 숨길 수 있는 게이트, 미리 구축할 가치가 있는 실패 사례, 그리고 연구 benchmark와 제품 평가의 경계를 분리해 다룹니다. 관련 글로 비즈니스 데이터에 근거한 Spatial AI와 Enterprise Spatial AI 파일럿을 참고할 수 있습니다. 그럴듯한 추천보다 올바른 거절이 더 정확할 수 있습니다.
Spatial AI 정확도 평가의 핵심
- 체인을 평가하세요: 의도, grounding, 적격성, 공간 계산, 랭킹, 설명, 액션, 결과.
- 사실은 모델 밖에서 확인하세요: 장소 식별자, 영업시간, 재고, 권한, 경로는 권위 있는 시스템이 관리해야 합니다.
- 어려운 사례를 포함하세요: 모호한 요청, 오래된 데이터, 미승인 요청, 의도적으로 풀 수 없는 요청.
- 게이트를 분리하세요: 낮은 위험의 레이어에서 높은 점수를 받았다고 권한 오류를 상쇄해서는 안 됩니다.
- 실제 작업에 연결하세요: 오프라인 케이스와 프로덕션 결과는 서로 다른 질문에 답합니다. 둘 다 필요합니다.
Spatial AI 정확도란 무엇인가?
고객이 집으로 가는 경로 근처에서 특정 상품이 아직 재고에 있고 도착할 때도 영업 중인 매장을 물을 수 있습니다. 이 한 문장에는 여러 독립적인 문제가 들어 있습니다. 사용자가 무엇을 원하는지, 어떤 매장이 실제로 존재하는지, 재고가 최신인지, 영업시간이 도착 시간과 맞는지, 경로에서 실제로 접근 가능한 지점이 어디인지, 어떤 비즈니스 규칙이 후보를 제외하는지, 남은 후보를 어떻게 정렬하고 설명해야 하는지입니다. 마지막 문장이 자연스럽다고 각 단계가 정확하다는 뜻은 아닙니다. 평가에서는 레이어를 분리해야 합니다. 장소 해석 실패는 ranking prompt를 다시 쓰는 것으로 해결되지 않으며, 오래된 재고 피드는 언어 모델을 바꾼다고 해결되지 않습니다.
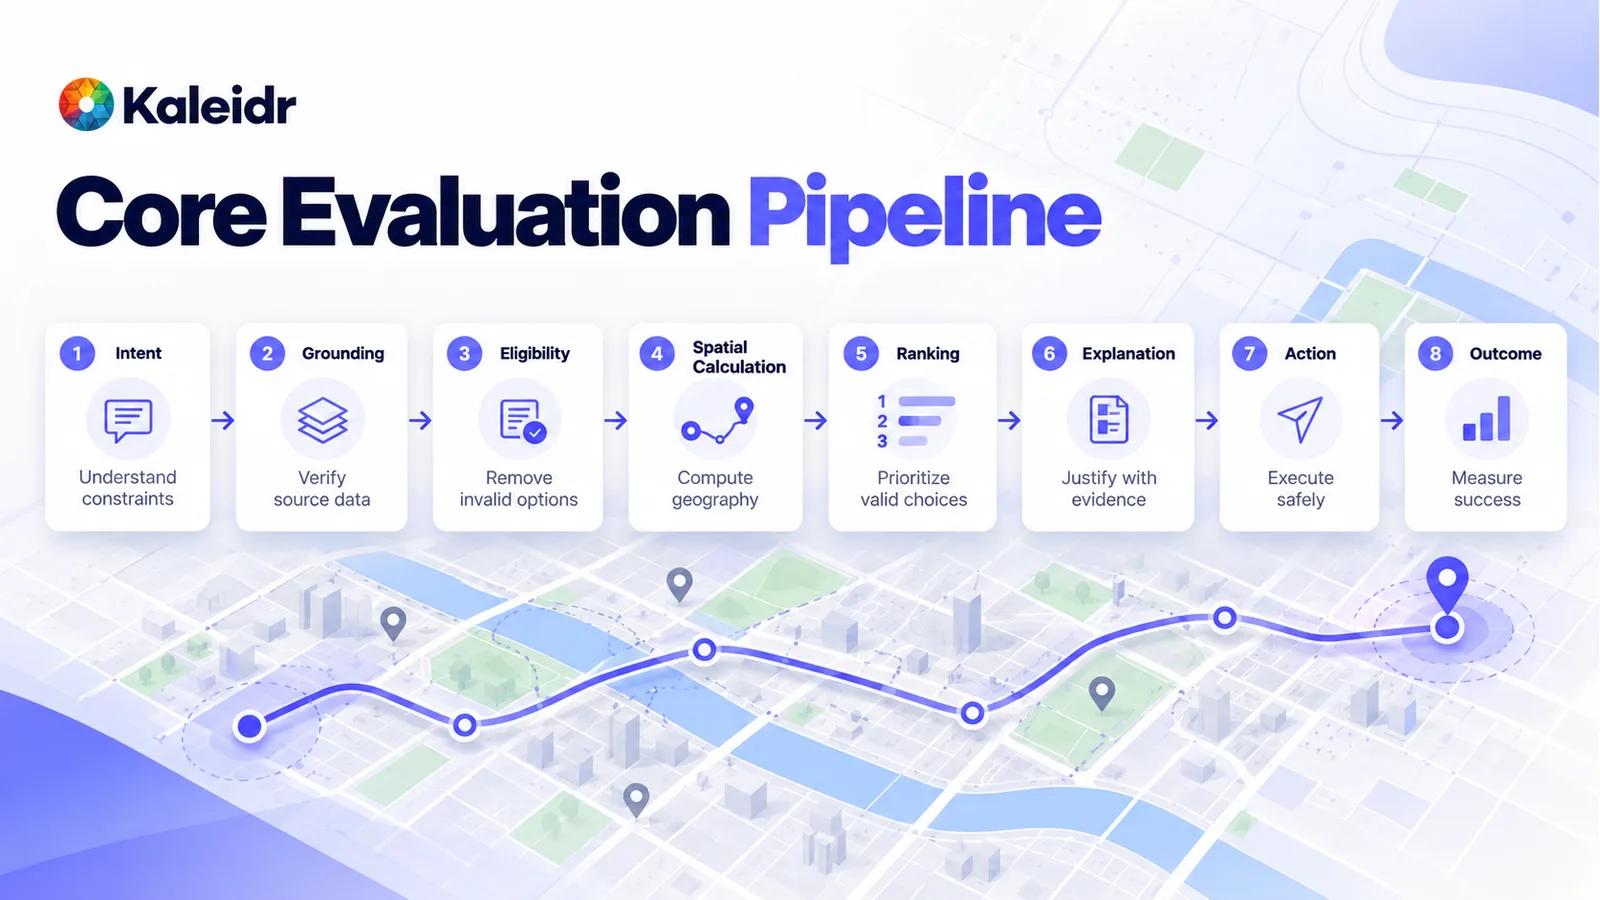
체인을 순서대로 테스트하세요. 제약을 이해하고, 출처를 검증하고, 유효하지 않은 옵션을 제거하고, 지리를 계산하고, 남은 후보를 랭킹하고, 근거로 설명하고, 허용된 경우에만 액션을 실행한 뒤 작업이 완료되었는지 측정합니다.
왜 하나의 점수로는 충분하지 않은가?
전체 백분율은 비교하기 쉽고 오용하기도 쉽습니다. 예시 scorecard에서 전체 정확도가 92%여도 의도는 99%, 라우팅은 98%, 설명은 96%, 인증은 75%일 수 있습니다. 이 수치는 예시일 뿐 Kaleidr의 실제 결과가 아닙니다. 평균은 여전히 좋아 보이지만 시스템이 사용자가 접근해서는 안 되는 데이터를 노출하거나 그 데이터로 액션을 실행할 수 있습니다. 중요한 차원에는 각각 별도의 프로덕션 게이트가 필요합니다. 낮은 위험의 작업에서 좋은 성능을 냈다고 권한 실패, 잘못된 목적지, 지원되지 않는 액션, 조작된 가용성을 상쇄해서는 안 됩니다.
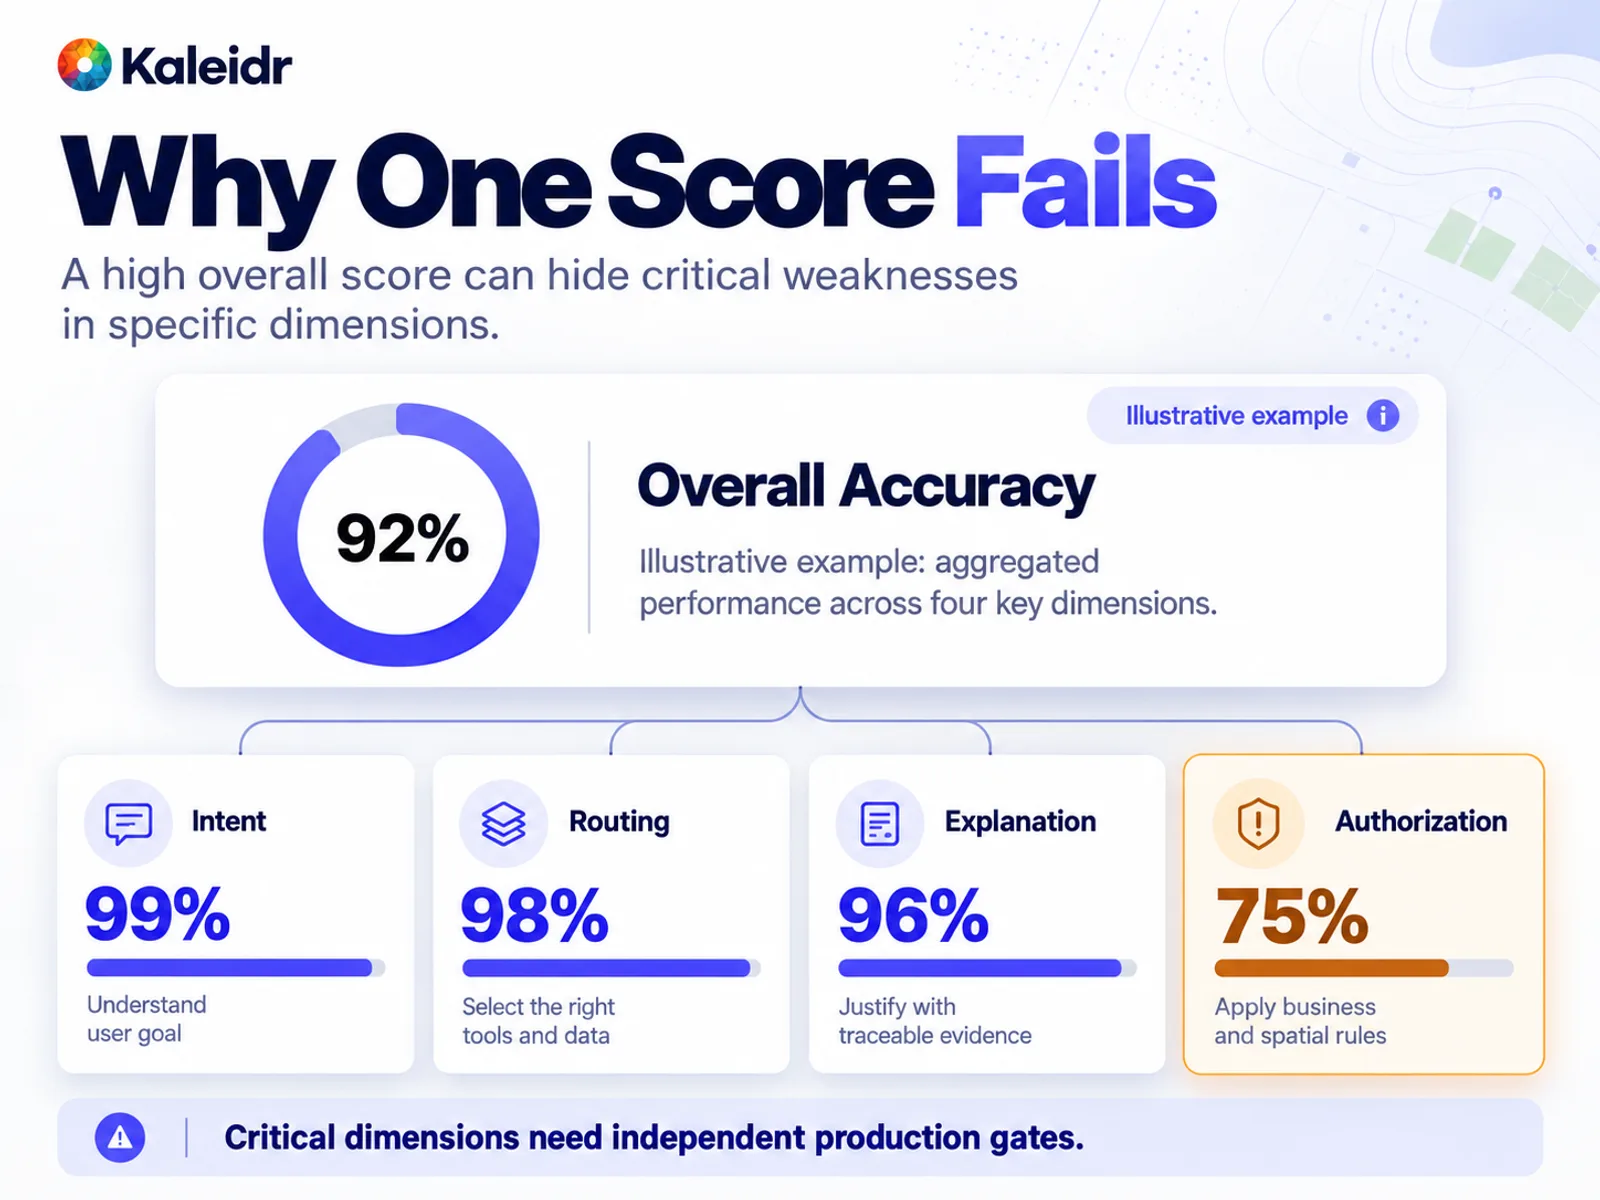
높은 전체 점수는 약한 게이트를 숨길 수 있습니다. 이 그림의 백분율은 설명용 예시이며 Kaleidr의 측정된 성능이 아닙니다.
NIST AI Risk Management Framework playbook은 가장 중요한 위험부터 측정을 시작하고, 측정하지 않을 위험도 문서화해야 한다고 설명합니다. 같은 playbook 페이지는 AI RMF 1.0이 업데이트 중이며 그 이후 playbook도 개정될 예정이라고 밝힙니다 (NIST, 2026). NIST의 TEVV-Athlon framework 초기 공개 초안인 NIST AI 200-2는 2026년 8월 7일 발표되었고 2026년 10월 6일까지 의견을 받습니다. 이 문서는 평가를 시스템이 개인 또는 조직의 목표를 충족한다는 증거로 설명하고, 실제 세계의 영향까지 포함해 그 필요에 맞게 측정을 설계해야 한다고 합니다 (NIST, 2026). 이 문서는 의견 수렴을 위한 초안입니다. Kaleidr의 제어 항목 목록이 아닙니다. 위치 인식 제품에서 중요한 맥락은 제품이 실제로 내리는 지리적 결정입니다.
의도, 장소, 적격성은 어떻게 테스트해야 하는가?
의도가 먼저입니다. 호텔과 행사장 사이에 있고 휠체어 접근이 가능하며 오전 7시 전에 여는 카페를 찾는 요청은 “호텔 근처 카페”와 다릅니다. 각 테스트 쿼리에 대해 예상되는 구조화 해석을 저장하세요. 카테고리, 지리적 관계, 출발지, 목적지, 접근성, 시간입니다. 그다음 제약 추출, 시스템이 임의로 추가한 제약, 누락한 제약을 측정합니다. 카테고리는 맞췄지만 시간 범위를 무시했다면 작업을 정확히 해석한 것이 아닙니다.
장소 표현은 모호할 수 있습니다. Springfield, Terminal 2, Main Street, “Austin의 우리 매장”은 각각 둘 이상의 엔터티를 가리킬 수 있습니다. 같은 이름의 도시, 동일한 지점명, 여러 터미널, 이름이 변경된 장소, 약어, 다국어 명칭, 경계가 뚜렷하지 않은 지역, 행정 경계에 걸친 주소를 포함하세요. 이름 문자열 일치가 아니라 canonical place ID를 평가합니다. 한 블록 떨어진 잘못된 카페와 다른 도시의 목적지는 둘 다 오류지만 심각도는 같지 않습니다.
적격성은 해당 장소를 후보로 고려할 수 있는지를 묻습니다. 랭킹은 유효한 장소가 얼마나 위에 나타나야 하는지를 묻습니다. 가장 가까운 pin이라도 영업 종료, 품절, 서비스 지역 밖, 예약 마감, 정책상 제외 대상일 수 있습니다. 이런 후보는 남은 후보를 랭킹하기 전에 제거해야 합니다. 적격성 precision은 반환된 전체 장소 중 적격한 장소의 비율입니다. 위험도가 높은 workflow에서는 소수의 부적격 추천이 평균적인 랭킹 품질보다 더 중요할 수 있습니다. 재고, 영업시간, 권한, 정책은 그것을 소유한 시스템에 남아야 합니다. 비즈니스 데이터에 근거한 Spatial AI도 제품에 대해 같은 경계를 설명합니다.
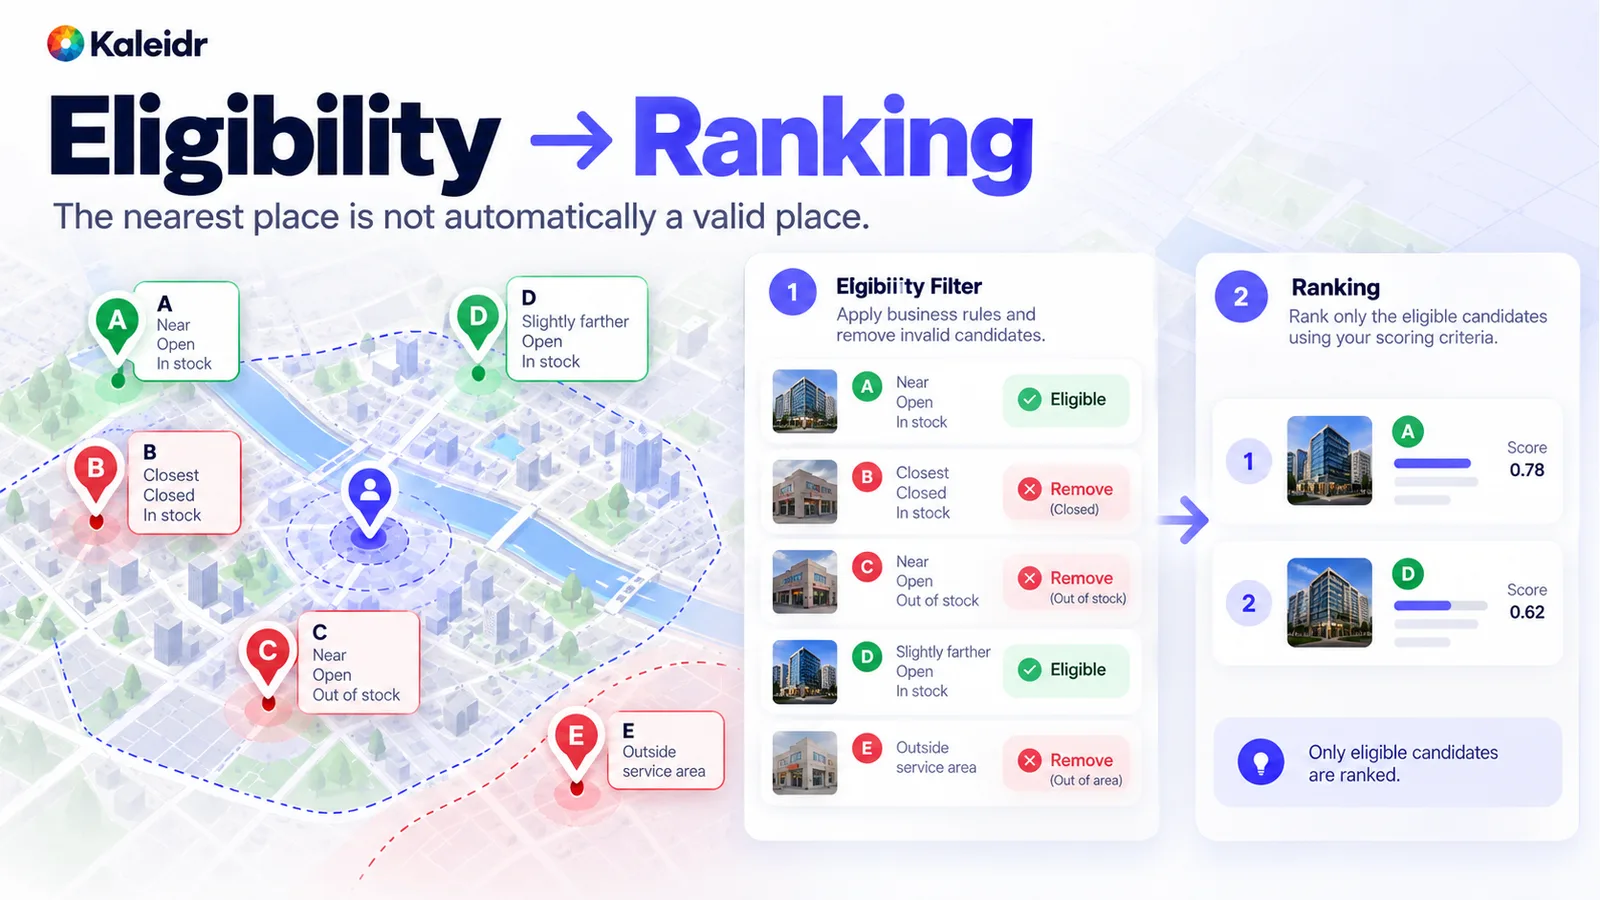
적격성을 먼저 필터링하세요. 가장 가까운 장소가 자동으로 유효한 장소가 되는 것은 아닙니다.
지리와 데이터 신선도는 어떻게 확인해야 하는가?
공간 엔진이 계산할 수 있는 값에 대해 언어 모델을 source of truth로 사용해서는 안 됩니다. point-in-polygon, 경로 거리, 이동 시간, 서비스 지역 포함 여부, containment, 경로상의 순서 등이 이에 해당합니다. 권위 있는 지리 데이터와 신뢰할 수 있는 도구로 예상 답을 만든 뒤 애플리케이션 결과와 비교하세요. “이 점이 이 폴리곤 안에 있는가?”나 “시스템이 branch ID 172를 반환했는가?”에는 정확 일치가 적합합니다. 좌표, 예상 이동 시간, 서로 다른 해상도로 그려진 경계에는 사전에 선언한 허용오차가 적합합니다. 실행 결과를 본 뒤 잘못된 결과가 “충분히 가까웠다”고 기준을 바꾸면 안 됩니다.
신선도는 과거에 옳았는지와 별개의 문제입니다. 좌표와 지점 식별자는 안정적일 수 있지만 영업시간, 재고, 교통, 폐점 상태는 변합니다. 신선도 임계값을 벗어난 데이터로 내려진 결정의 비율과, 업데이트 시각이 알려진 시간 민감 필드의 비율을 추적하세요. 데이터가 없다는 사실은 “이용 불가”와 같은 뜻이 아닙니다. 상태가 불명확한데도 확신 있게 예 또는 아니오라고 답하면 장소 자체가 실제로 존재하더라도 실패입니다.
언제 “결과 없음”이 정확한 답인가?
고객이 10분 이내 거리에서 오후 9시 이후에도 상품이 있는 장소를 요청했지만 실제로는 그런 장소가 없을 수 있습니다. 약한 시스템은 제약을 조용히 완화하고 20분 떨어진 지점을 반환합니다. grounded 시스템은 모든 조건을 충족하는 검증된 옵션이 없다고 답합니다. benchmark에는 의도적으로 풀 수 없는 작업을 포함하고, 올바른 “결과 없음” 비율과 잘못된 추천 비율을 추적해야 합니다. 2025년 GeoBenchX는 다단계 지리공간 작업에서 도구 호출 에이전트를 평가하는 benchmark로, 해결 가능한 작업과 의도적으로 해결 불가능한 작업을 모두 포함해 거절 정확도를 측정합니다 (Krechetova and Kochedykov, 2025). 이 논문은 연구용 에이전트를 평가합니다. GeoBenchX가 Kaleidr를 점수화하는 것은 아니며 제품 팀은 자신의 작업에 맞는 해결 불가능 사례를 별도로 작성해야 합니다.
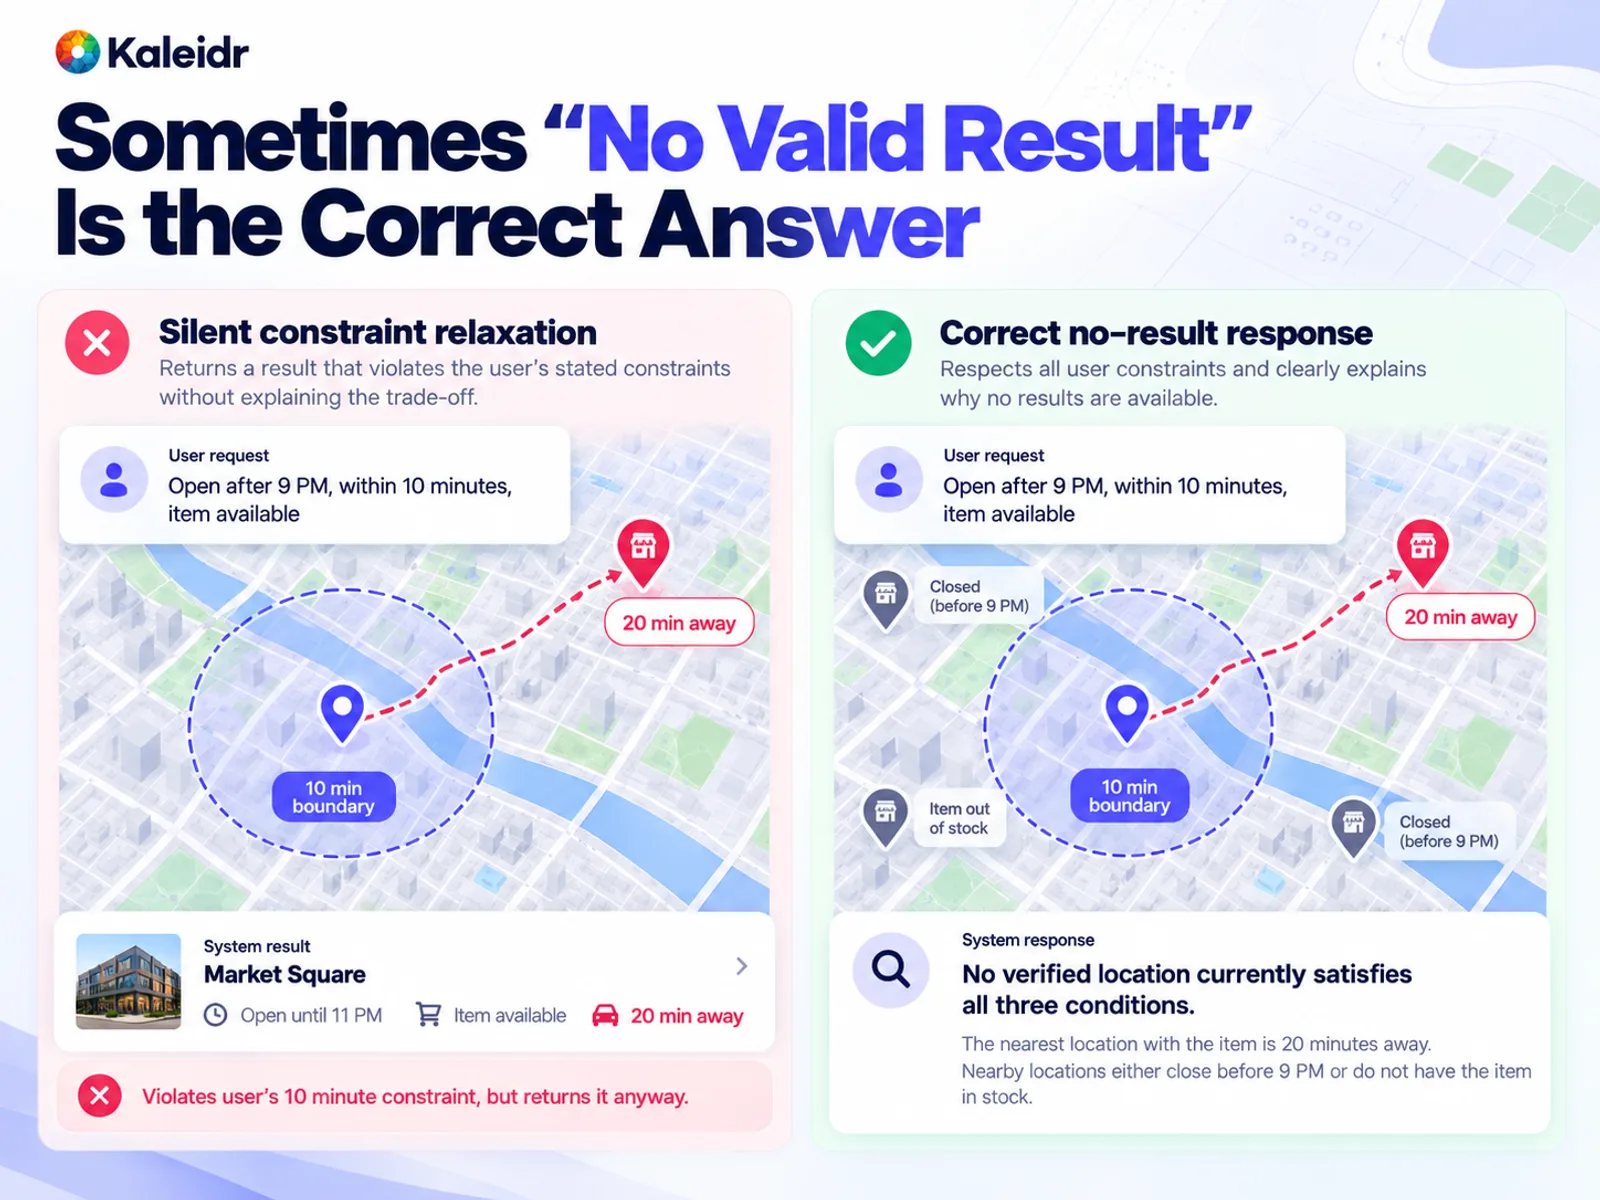
때로는 유효한 결과가 없다는 것이 정확한 답입니다. 지정된 시간이나 거리 밖의 장소를 반환하는 것은 유용한 fallback이 아니라 잘못된 추천입니다.
랭킹, 설명, 액션은 어떻게 평가해야 하는가?
잘못된 후보를 제거한 뒤에 랭킹하세요. 가장 가까운 곳이 자동으로 가장 좋은 곳은 아닙니다. 제품이 그렇게 정의한다면 이동 시간, 경로 이탈, 가용성, 접근성, 가격, 영업시간 범위, 비즈니스 우선순위를 목표에 포함할 수 있습니다. 유용한 지표에는 첫 번째 결과가 허용 가능한 비율, 상위 K개 결과에 허용 가능한 선택지가 포함되는 비율, 사람 검토 또는 정책 순서와의 일치, 알려진 최선의 적격 옵션 대비 regret 등이 있습니다. engagement를 랭킹 품질로 취급하지 마세요. 순위를 고객이 실제로 해야 했던 액션과 연결하세요.
“오후 10시까지 영업, 상품 재고 있음, 경로에 6분 추가”와 같은 설명은 각 문장이 시스템이 실제로 사용한 근거로 추적될 때만 정확합니다. 장소 식별자, 가용성 주장, 영업시간, 실제로 경로가 계산되었는지, 문장이 랭킹 결정과 일치하는지를 확인하세요. 매끄러운 문단도 틀릴 수 있습니다. 짧고 어색한 문장도 맞을 수 있습니다. 설명의 사실 주장 가운데 검증된 주장 비율을 측정하세요.
액션도 답변의 일부입니다. 지도를 이동하거나 marker를 추가하거나 경로를 요청하거나 filter를 변경하거나 예약을 시작하는 동작은 문장이 맞아도 틀릴 수 있습니다. 해당 액션이 애플리케이션의 vocabulary에 포함되는지, 대상과 파라미터가 맞는지, 사용자가 그 액션을 실행할 권한이 있는지를 추적하세요. 올바른 문장에 잘못된 지도 액션이 붙으면 여전히 실패한 상호작용입니다.
benchmark에는 어떤 실패 사례가 들어가야 하는가?
팀이 이미 해결 방법을 아는 깨끗한 예제만으로 만든 세트는 신뢰성을 과대평가합니다. 모호한 이름, 중복 지점, 서비스 지역 경계의 주소, 풀 수 없는 요청, 방금 폐점한 매장, 장소와 맞지 않는 재고, 가까워 보이지만 경로를 크게 돌아가게 하는 pin, 도착 전에 문을 닫는 지점, 사용자가 볼 권한이 없는 사설 시설, 영어 이름과 다른 현지 이름, 알 수 없는 영업시간, first-party 데이터와 충돌하는 공개 소스, 모델을 유도하려는 검색 텍스트, 다운된 routing 또는 비즈니스 데이터 서비스를 포함하세요. 목적은 프로덕션이 실제로 마주칠 결정을 재현하는 것입니다.
검색된 텍스트가 모델을 유도하려는 경우는 prompt injection 사례입니다. OWASP는 LLM01:2025 Prompt Injection을 사용자 또는 검색된 입력이 모델의 행동을 의도하지 않은 방식으로 바꾸는 문제로 설명하며, 중요한 의사결정에 영향을 줄 수 있고 retrieval-augmented generation으로도 완전히 제거되지 않는다고 지적합니다 (OWASP, 2025). 이 사례는 권한 문제와 함께 테스트 세트의 보안 계열에 포함하고, 보안을 나중에 붙이는 부록처럼 다루지 마세요.
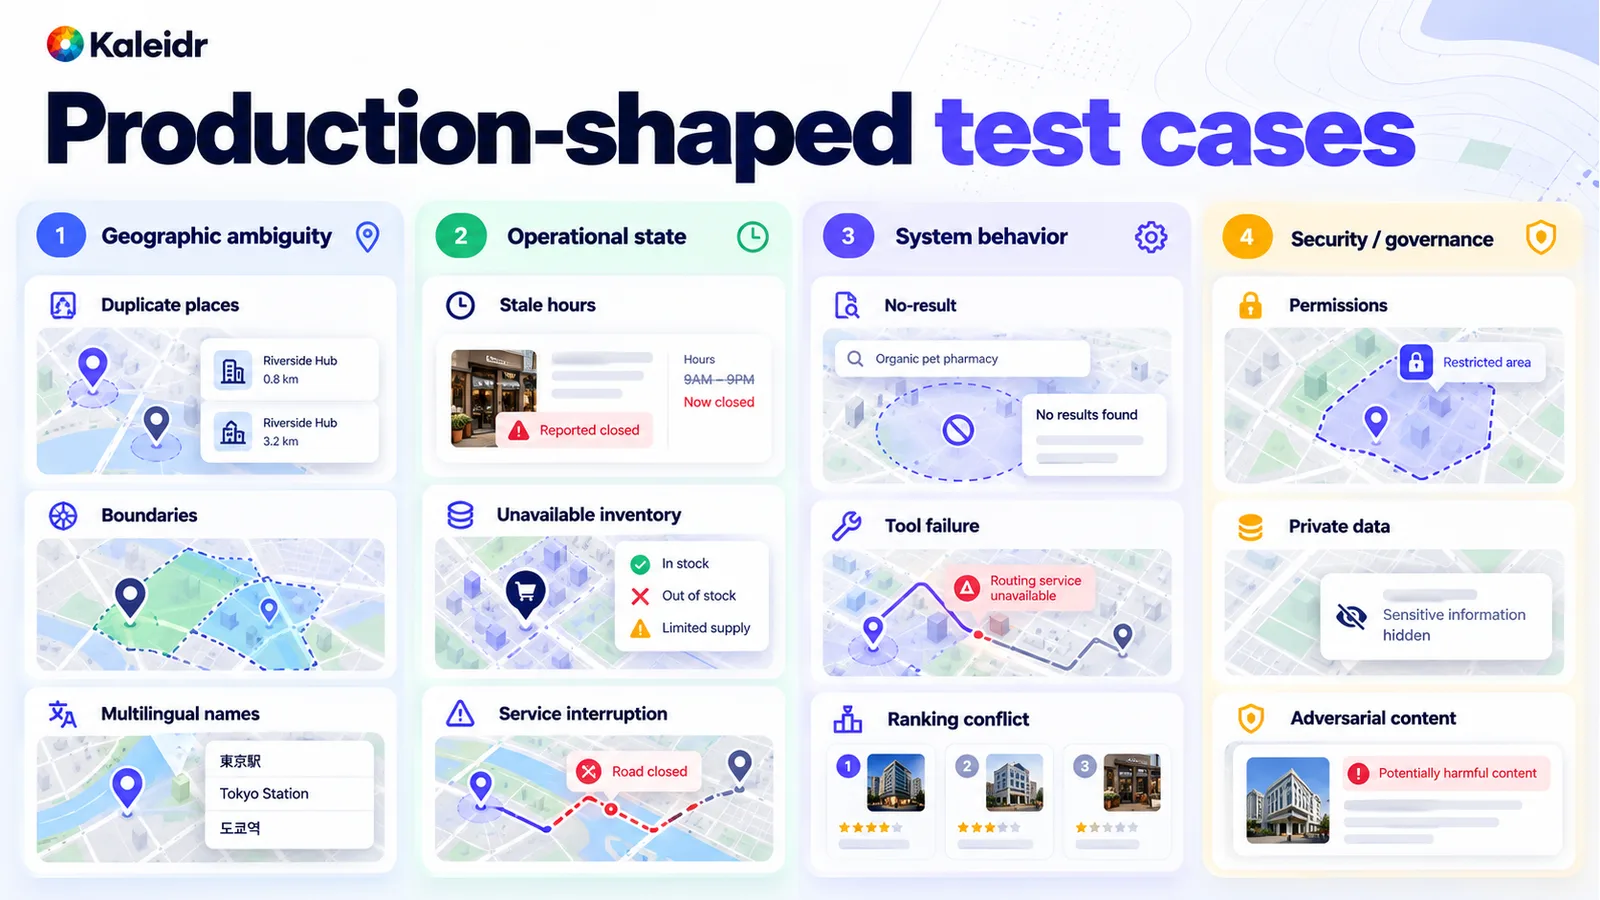
프로덕션 형태의 사례는 지리적 모호성, 운영 상태, 시스템 동작, 보안을 다룹니다. 이를 생략한 benchmark는 신뢰성을 과대평가합니다.
왜 실행 전에 ground truth가 있어야 하는가?
각 사례에는 무엇이 “정답”인지 말할 수 있을 만큼 충분한 기록이 필요합니다. 쿼리, 사용자 컨텍스트, 허용된 소스, 예상 의도, 필수 제약, canonical 장소, 적격 집합, 예상 공간 관계, 최선 결과, 허용 가능한 대안, 예상 액션, “결과 없음”이 맞는 이유, 허용오차, 시스템이 틀렸을 때의 심각도를 포함하세요. 시스템을 실행하기 전에 기록해야 합니다. 모델이 낸 답에 맞춰 정답 키를 바꾸는 것은 평가가 아닙니다.
GISAgentBench는 2026년 실무자 기반의 349개 다단계 GIS 작업으로 구성된 benchmark로, 많은 GIS agent benchmark에 ground-truth 출력이 없고 대신 코드 유사도, trajectory matching, model judge 같은 대체 신호를 사용해 비슷한 workflow를 정답으로 취급할 수 있다고 지적합니다. GISAgentBench의 각 작업에는 정확한 ground-truth 출력 파일이 포함됩니다 (Pothuri et al., 2026). 좌표, containment, canonical ID, 영업 중/종료, 권한, 어떤 API action이 호출되었는지처럼 결정론적인 질문에는 코드나 권위 있는 레코드를 사용하세요. 설명이 이해하기 쉬운지처럼 실제로 주관적인 질문에만 사람 검토 또는 보정된 모델 보조 검토를 사용하세요. 평가자는 테스트하려는 truth의 종류와 맞아야 합니다.
팀은 세그먼트 결과를 어떻게 읽어야 하는가?
평균은 약한 지역을 숨길 수 있습니다. 국가, 시장, 언어, 도시/농촌 커버리지, 데이터 제공업체, 장소 카테고리, 지점 밀도, 쿼리 복잡도, 경로 유형별로 결과를 나누세요. 전체 valid-result rate가 95%인데 새로 출시한 시장은 78%라고 가정해 봅시다. 이 숫자는 가상의 예시이며 Kaleidr 측정값이 아닙니다. 평균은 수학적으로 맞아도 확장 판단에 사용할 잘못된 숫자일 수 있습니다. 오류가 어디서 발생하는지 확인한 다음 실패한 사례를 해석, entity resolution, grounding, 적격성, 공간 계산, 신선도, 랭킹, 설명, 액션, 보안, 복구 중 하나로 분류하세요. 분류가 팀에 무엇을 바꿔야 하는지 알려줍니다. routing 오류는 설명 문제가 아닙니다.
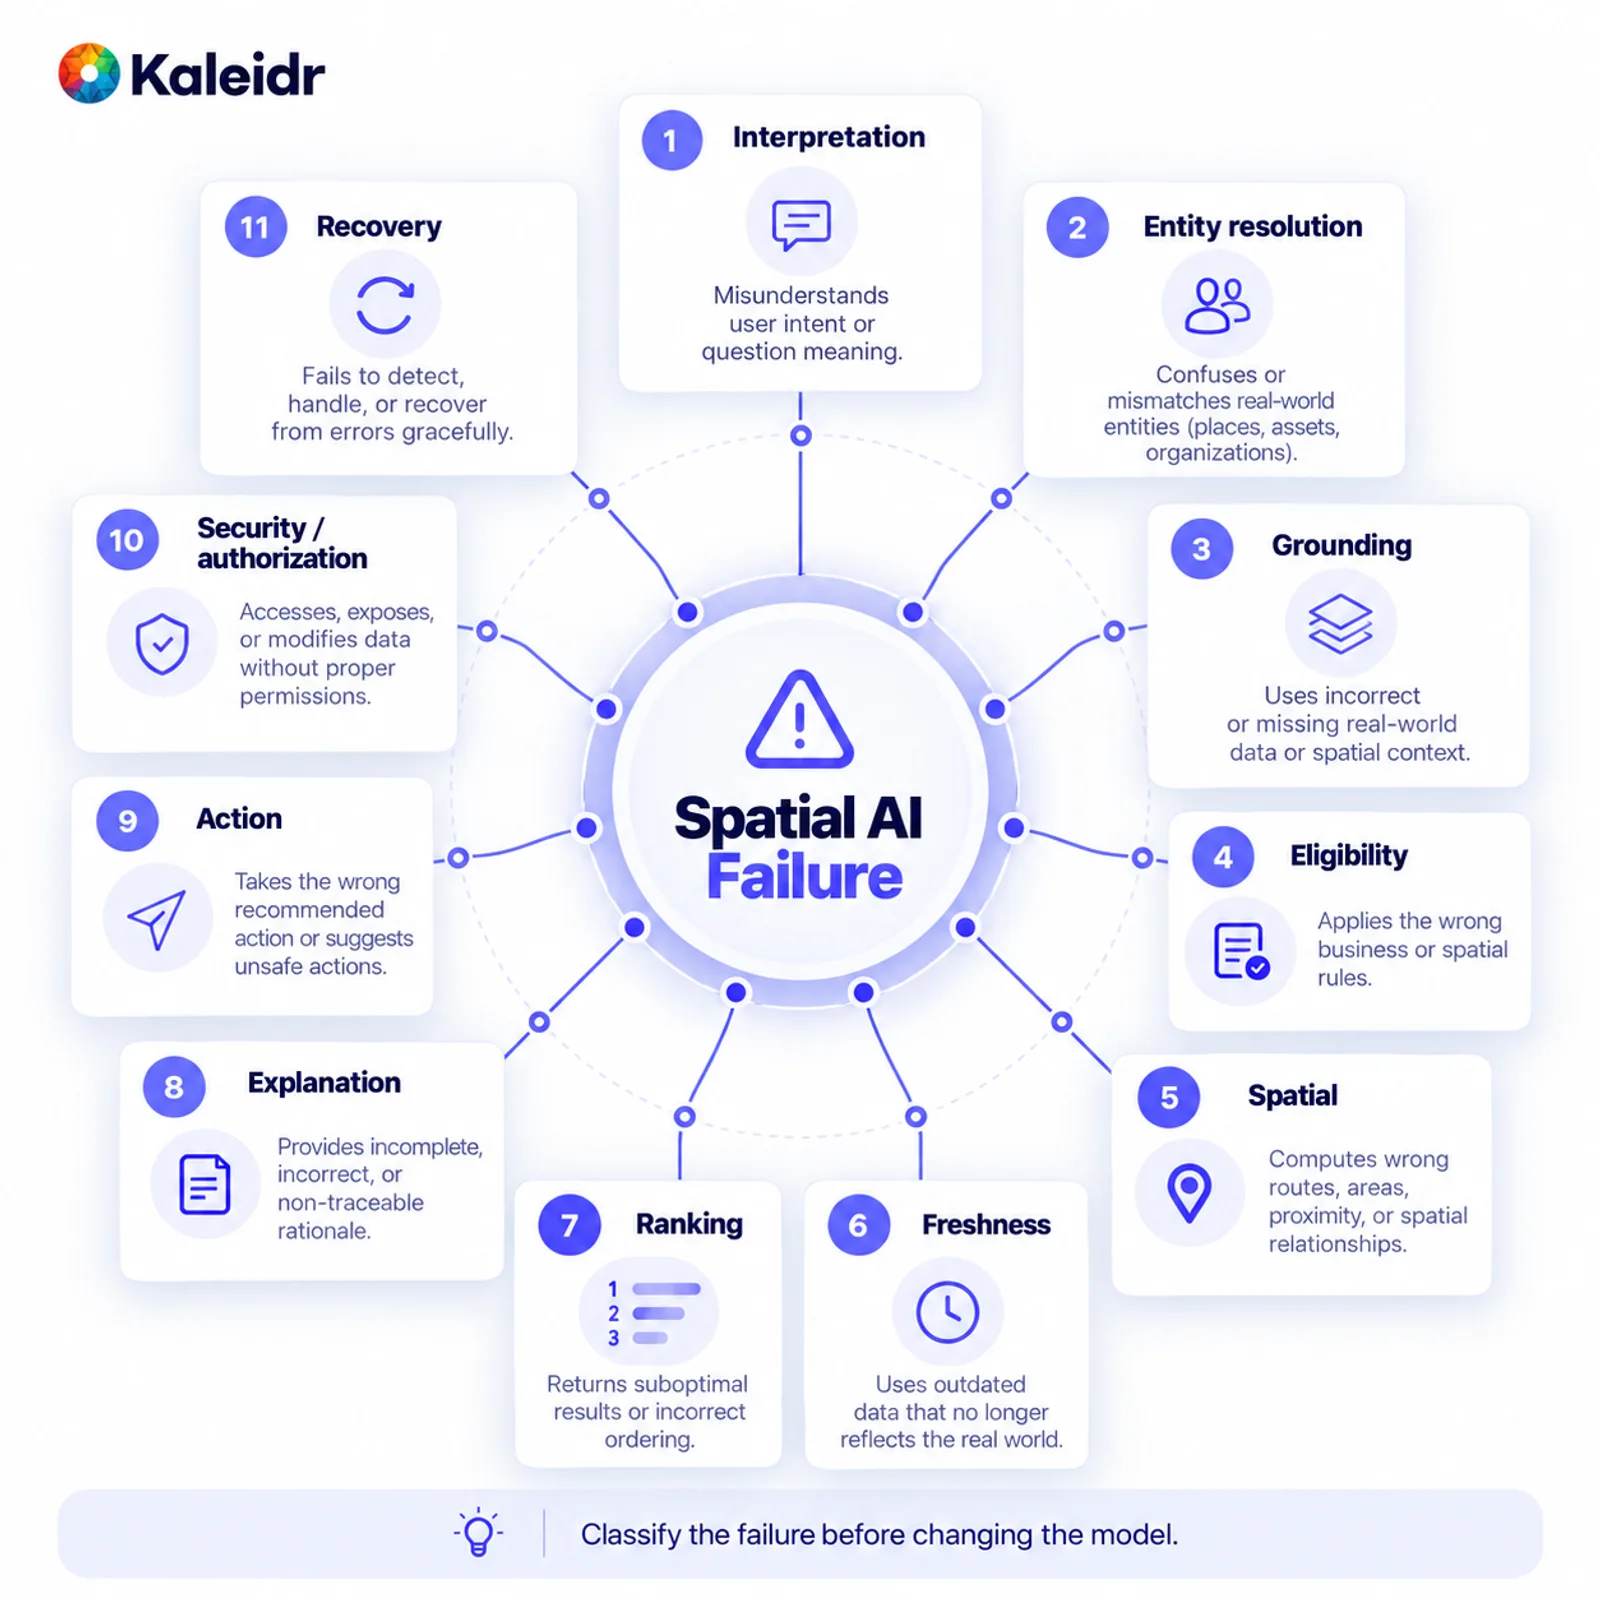
모델을 바꾸기 전에 실패를 분류하세요. 카테고리를 분리하면 드물지만 심각한 오류가 큰 평균값 안에서 사라지는 것을 막을 수 있습니다.
생성형 실행은 결과 변동도 있습니다. 중요한 사례에서는 평균, 관측된 최악의 실행, 오류가 얼마나 자주 반복되는지를 기록하세요. 9번 안전하고 1번 틀리는 쿼리는 매번 같은 안전한 답을 주는 쿼리와 위험이 다릅니다. prompt, 모델, retrieval, ranking, 데이터 제공업체, 도구, 커버리지가 바뀌면 세트를 다시 실행하세요. 평가는 한 번의 출시 전 보고서가 아니라 release management의 일부여야 합니다.
프로덕션 scorecard에는 무엇이 들어가야 하는가?
각 차원에 고유한 지표와 고유한 게이트를 부여하세요. 의도에는 constraint extraction을, 장소 식별에는 canonical-place accuracy를 사용할 수 있습니다. 인증과 보안에는 보호 데이터에 대해 어떤 무단 접근도 허용하지 않는 unauthorized-access rate를 사용할 수 있습니다. 적격성, 공간 계산, 신선도, 랭킹, 결과 없음 처리, 설명, 액션, 결과에도 각각 제품 책임자가 실행 전에 정하는 임계값이 필요합니다. 다른 애플리케이션의 보편적 cutoff를 복사하지 마세요. 가벼운 식당 추천과 안전에 영향을 주는 라우팅 판단은 같은 error budget을 공유하지 않습니다.
| 차원 | 예시 지표 | 예시 게이트 |
|---|---|---|
| 의도 | 제약 추출 정확도 | 이 제품에 맞게 설정 |
| 장소 식별 | canonical-place accuracy | 매우 높음 |
| 인증 | 무단 접근률 | 보호 데이터는 0 허용 |
| 적격성 | 적격 결과 precision | 매우 높음 |
| 공간 계산 | 사전 선언한 허용오차 안에서 정확 | 이 제품에 맞게 설정 |
| 신선도 | 신선도 범위 안의 결과 비율 | 이 제품에 맞게 설정 |
| 랭킹 | Top-1 또는 Top-K acceptance | 이 제품에 맞게 설정 |
| 결과 없음 처리 | 정확한 거절률 | 높음 |
| 설명 | 근거 있는 주장 비율 | 높음 |
| 액션 | 유효하고 올바르게 파라미터화된 액션 비율 | 매우 높음 |
| 결과 | 위치 의존 작업 완료 | 의도한 작업을 개선해야 함 |
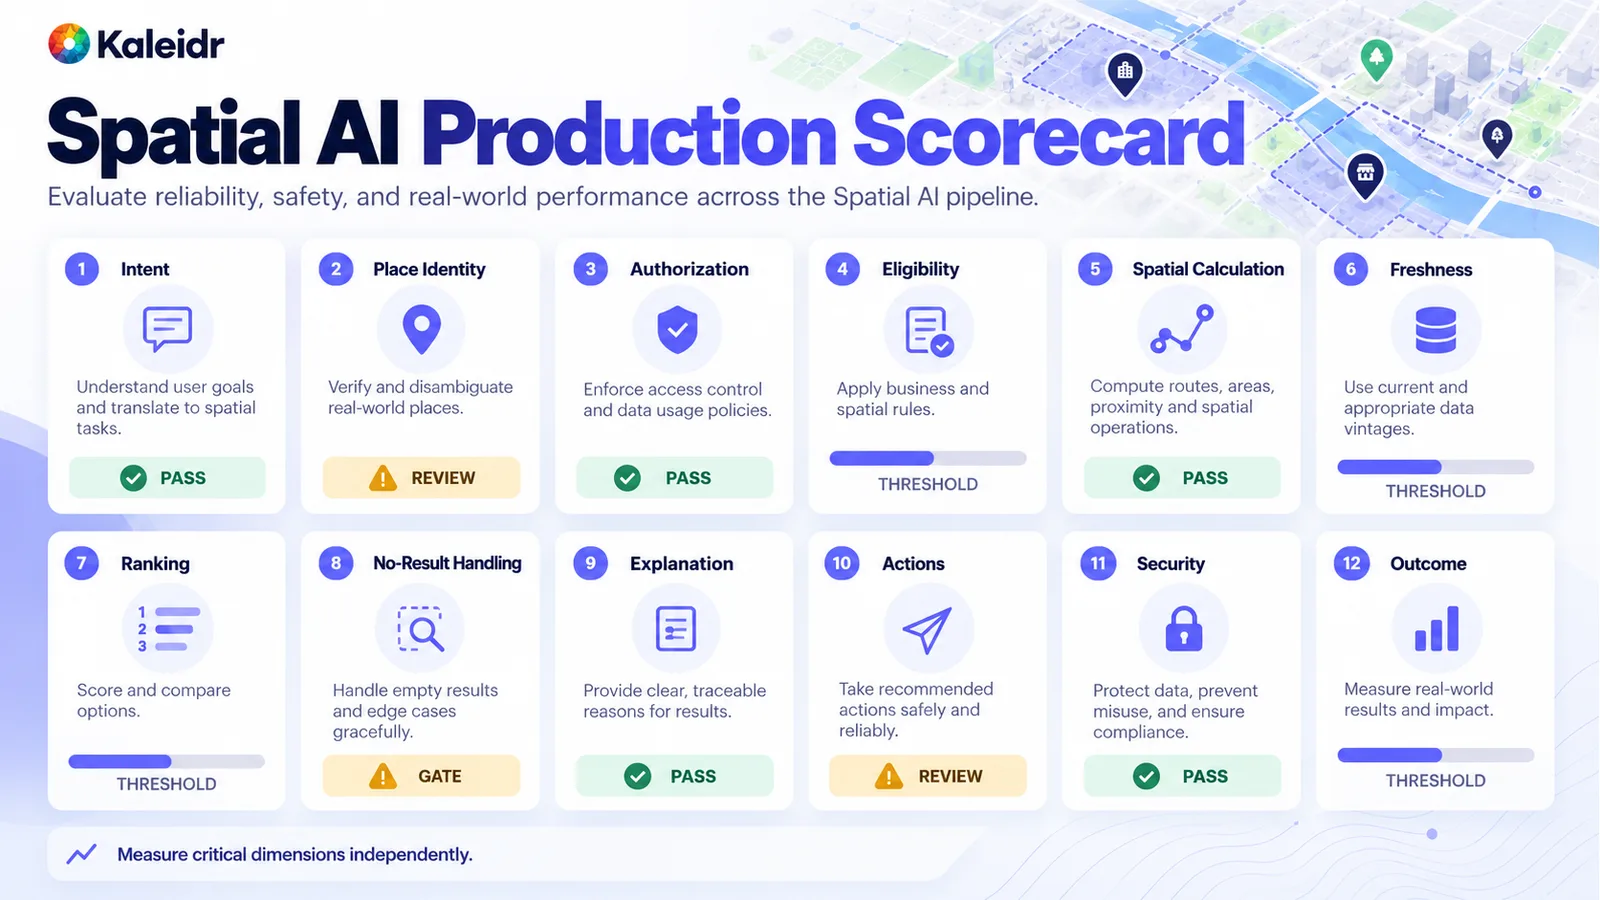
중요한 차원은 독립적으로 측정하세요. 이 scorecard의 상태 라벨은 placeholder이며 Kaleidr benchmark 점수가 아닙니다.
팀은 확장 여부를 어떻게 결정해야 하는가?
혼합된 단일 점수가 아니라 게이트를 사용하세요. 프로덕션과 유사한 조건에서 유효하고 grounded이며 공간적으로 정확한 결과가 유지되고, 중요한 오류 범주가 통제되고, 운영 데이터를 책임지는 사람이 있고, 의도한 결과가 개선될 때 확장합니다. 작업 자체에는 가치가 있지만 수정 가능한 레이어가 약하면 반복 개선합니다. 파일럿이 너무 많은 지역, 소스, 작업을 섞어 무엇이 실패했는지 알기 어렵다면 범위를 좁힙니다. 팀이 권위 있는 데이터를 지정할 수 없거나, 중요한 실패를 통제할 수 없거나, 작업을 정의할 수 없거나, 현재 workflow보다 개선됐음을 보여주지 못한다면 중단합니다. Enterprise Spatial AI 파일럿은 제한된 테스트입니다. scorecard는 그 테스트를 의사결정으로 바꾸는 방법입니다.
Kaleidr는 평가 스택에서 어디에 해당하는가?
Kaleidr Enterprise는 inference API, ranking system, analytics, deployment support를 포함한 location-intelligence infrastructure를 설명하며, 기존에 운영 중인 지도 옆에 추가할 수 있는 chat, editing, tiles, embeddable viewer도 포함합니다 (Kaleidr, 2026). 호스트 애플리케이션은 자신이 소유한 비즈니스 시스템을 계속 보유합니다. 재고, 권한, 고객 상태, 예약, 기타 비공개 운영 레코드가 이에 해당합니다. 공간 도구는 계산 가능한 연산을 담당합니다. 언어 모델 레이어는 의도를 해석하고 지원되는 기능을 조정하며 grounded 결과를 설명합니다. Kaleidr의 공개 Analytics 페이지인 Map Engagement and Location Analytics는 reach, views, engagement, audience location and activity, map별 sessions와 interactions, place comparison, spatial patterns를 설명합니다 (Kaleidr, 2026). 이 보고서는 지도와 장소 행동을 설명합니다. 완료된 예약, 주문, qualified lead는 해당 기록을 보유한 호스트 시스템에 남습니다.
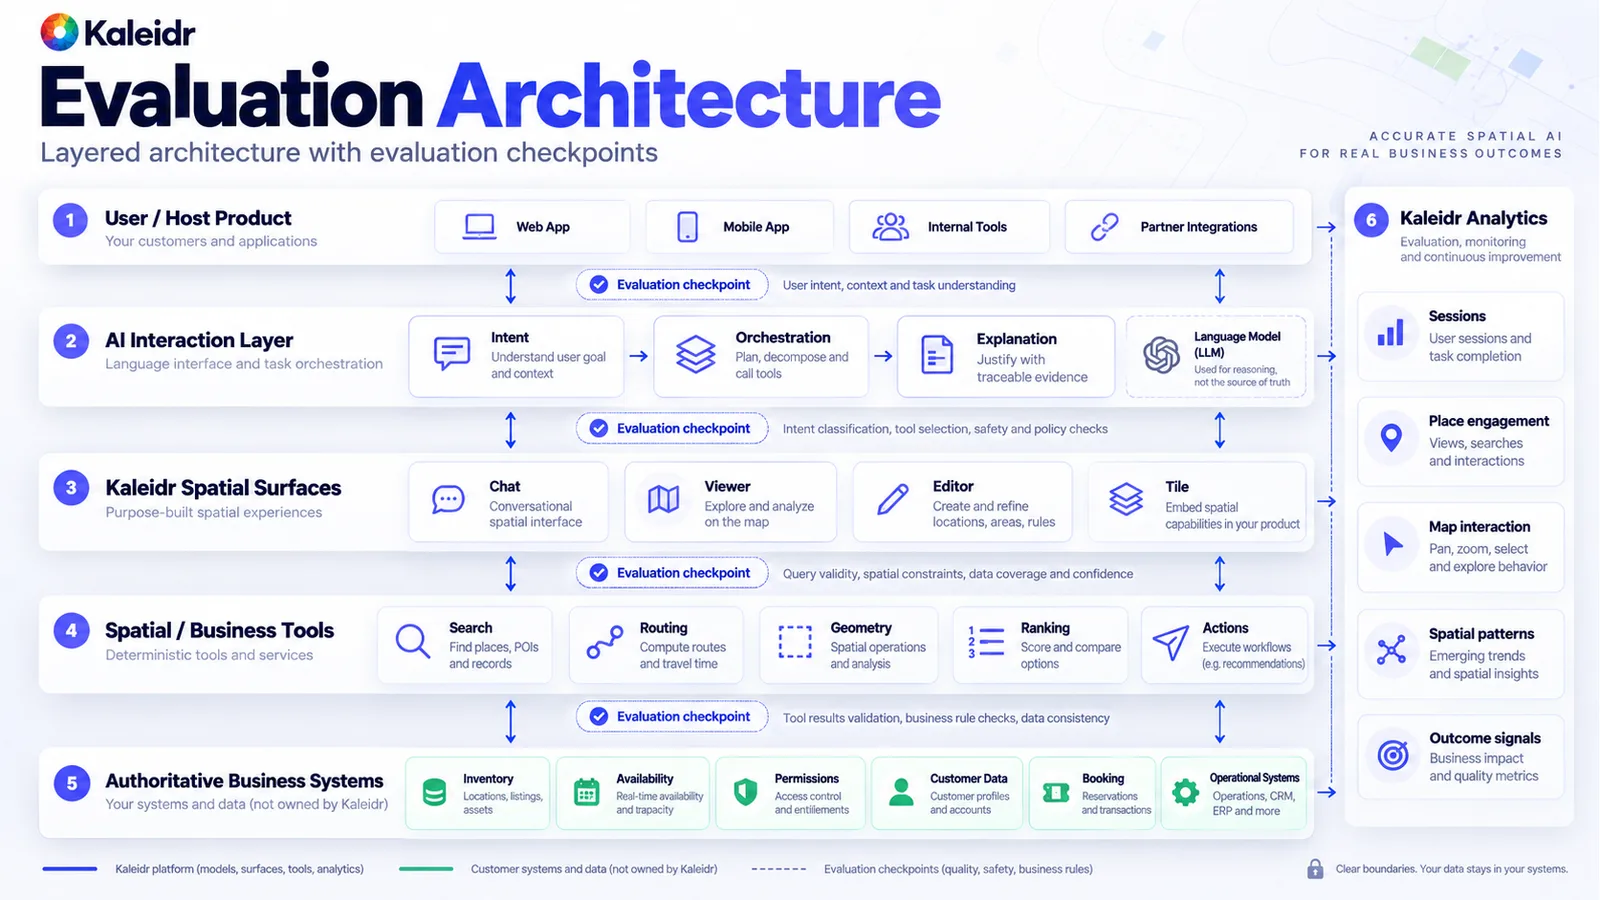
언어 모델은 재고, 권한, 경로의 source of truth가 아닙니다. 레이어 사이의 checkpoint를 통해 어떤 부분이 실패했는지 알 수 있습니다.
약한 benchmark를 숨기는 실수는 무엇인가?
모호성, 결측 데이터, 해결 불가능 요청이 없는 happy-path 질문만 사용하면 신뢰성을 과대평가합니다. 참조 문장과 얼마나 비슷하게 표현했는지만 점수화하면 다른 방식으로 표현한 올바른 결정을 놓치고, 참조 스타일로 쓴 잘못된 장소를 보상할 수 있습니다. 부적격 장소가 남아 있는 집합을 랭킹하면 적격성 오류가 숨겨집니다. 공간 엔진이 계산할 수 있는 거리를 모델에게 확인시키면 계산을 유창성으로 대체하는 셈입니다. 신선도를 무시하면 어제의 영업시간을 오늘의 영업시간처럼 취급합니다. 지도 상호작용이 늘어난 것을 정확도로 보는 것은 관심과 성공, 때로는 혼란을 섞는 것입니다. 수치를 본 뒤 허용오차를 바꾸는 것은 benchmark가 아닙니다. 모델만 테스트하면 retrieval, 데이터, 도구, 권한, ranking, interface를 무시합니다. 프로덕션 행동은 조립된 제품 전체의 행동입니다.
연구 benchmark는 여전히 역량 probe로 유용합니다. 2026년 8월 제출되어 CIKM 2026에 채택된 GeoBenchLLM은 공개 datasets 기반의 geo-related task에서 언어 모델을 평가하며 geospatial 및 temporal understanding을 포함합니다 (Rodrigues et al., 2026). GeoAI benchmark는 원격탐사, GIS workflow, imagery, geospatial model task를 다루는 경우가 많습니다. 하지만 제품 benchmark에는 비즈니스 데이터 grounding, 권한, 실시간 가용성, 랭킹, 지도 액션, 고객 결과도 필요할 수 있습니다. 하나의 공개 benchmark가 모든 제품의 작업을 대신할 수는 없습니다.
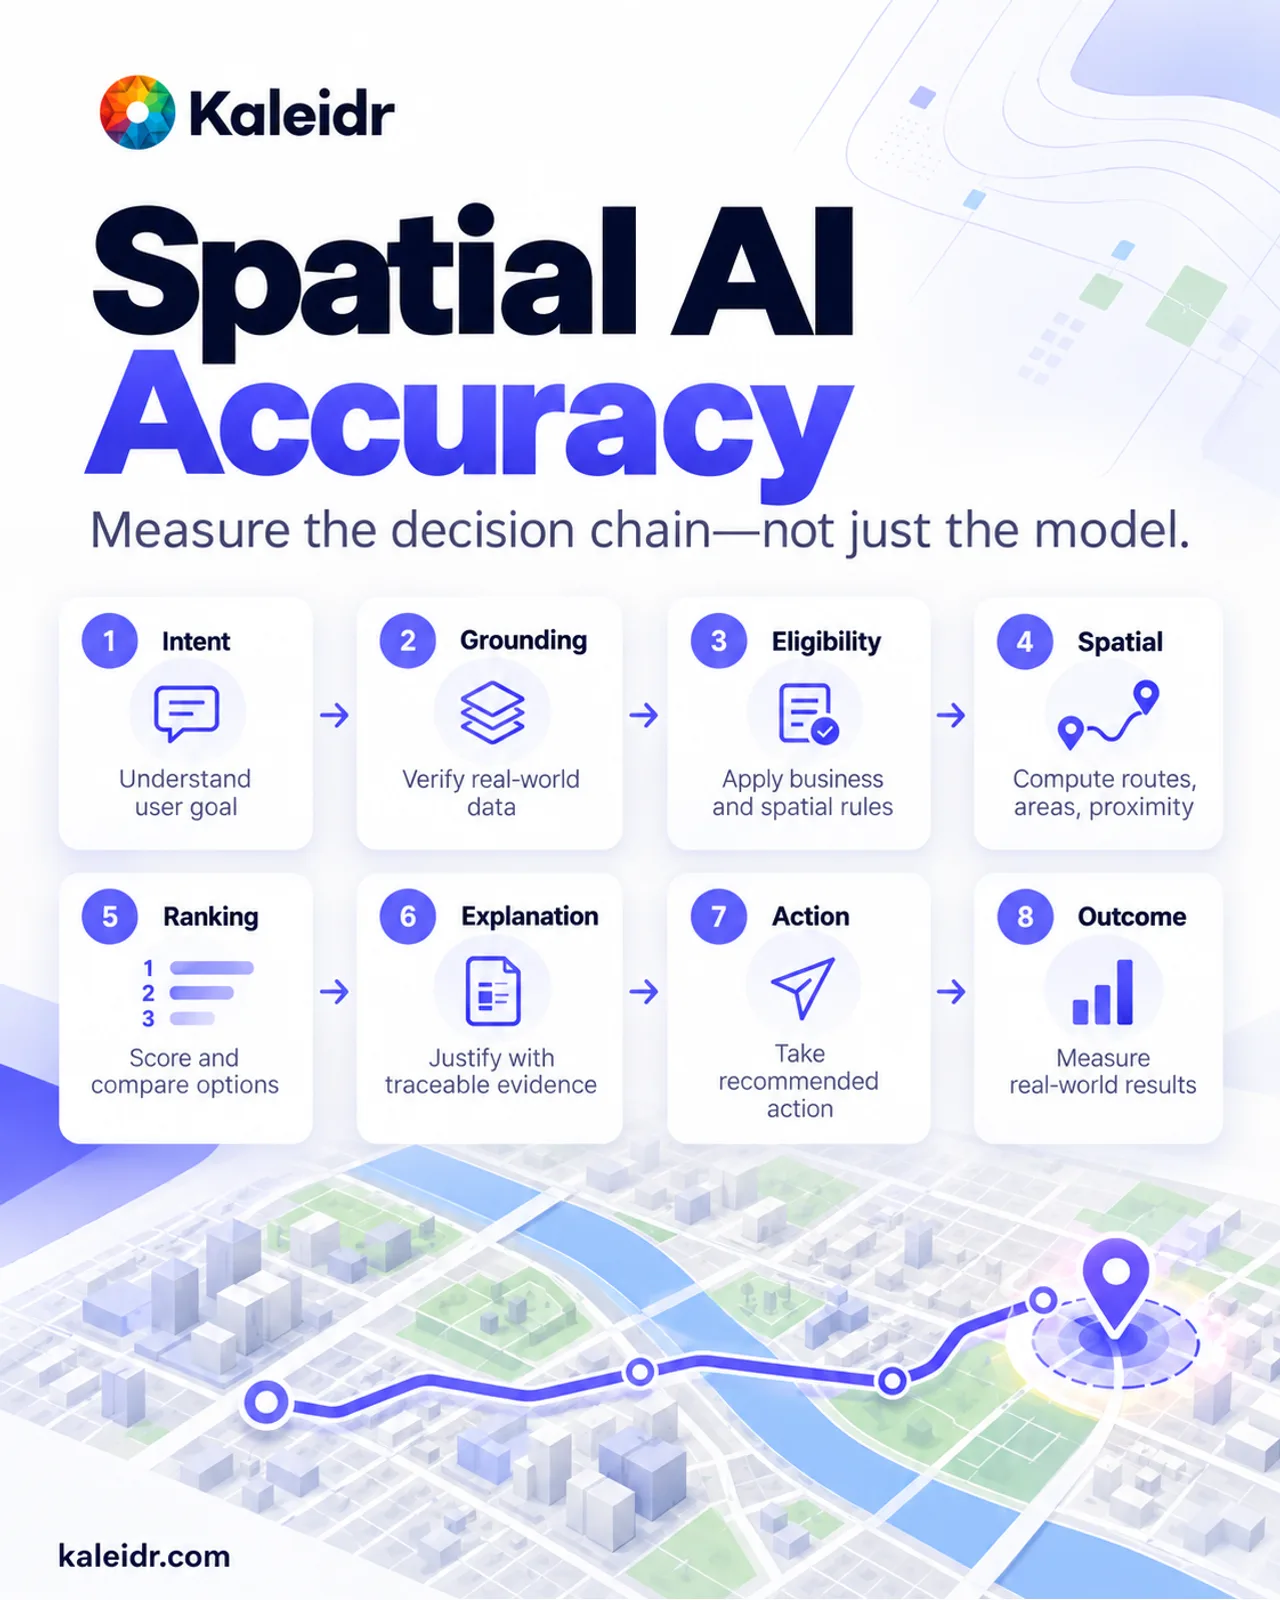
모델만이 아니라 의사결정 체인을 측정하세요. 8단계는 평가 개요이지 보고된 점수가 아닙니다.
평가는 어떻게 release gate가 되는가?
확장 전에 테스트 세트를 구축하세요. 실패 사례를 포함하세요. 도구나 레코드로 답할 수 있는 결정론적 truth는 언어 모델 밖에 두세요. 중요한 차원은 각자의 게이트로 추적하세요. 시스템이 바뀌면 다시 실행하고, 오프라인 결과를 원래 개선하려던 프로덕션 결과와 연결하세요. 핵심 질문은 이 시스템이 제품이 약속하는 위치 의존 결정을 올바른 데이터, 지리, 권한, 액션으로 수행할 수 있는지, 그리고 팀이 그것을 입증할 수 있는지입니다.
**Kaleidr Enterprise 살펴보기**에서 기존 시스템 옆에 위치 인식 AI를 추가하고 집중된 파일럿을 정의할 수 있습니다. **Kaleidr Analytics 살펴보기**에서 그 파일럿의 지도와 장소를 사용자가 어떻게 이용하는지 확인할 수 있습니다. 비즈니스 결과와 확장 결정은 계속 호스트가 소유합니다.
FAQ
Spatial AI 정확도는 어떻게 측정하는가?
위치 결정의 단계들을 측정하세요. 의도, 장소 해석, 인증, 적격성, 지리 계산, 신선도, 랭킹, 설명, 액션, 사용자 또는 비즈니스 결과입니다. 이 체인을 하나의 모델 점수로 합치지 마세요.
언어 모델 정확도와 같은가?
아닙니다. 언어 모델은 하나의 구성요소일 뿐입니다. 장소 데이터베이스, 비즈니스 레코드, 공간 엔진, routing, ranking, 권한, 애플리케이션 상태가 모두 결과의 정확성에 영향을 줄 수 있습니다.
언어 모델이 거리를 계산해야 하는가?
제품에 거리나 이동 관계가 필요하면 지리 도구나 routing tool을 사용하세요. 모델은 언제 계산이 필요한지 판단하고 결과를 설명할 수 있습니다. 실제 계산은 공간 서비스가 수행합니다.
benchmark에 불가능한 질문도 포함해야 하는가?
네. 의도적으로 해결 불가능한 작업은 시스템이 장소를 지어내거나 제약을 조용히 버리지 않고 grounded한 “결과 없음” 응답을 반환하는지 보여줍니다.
평가는 얼마나 자주 실행해야 하는가?
프로덕션 이전에 실행하고, 모델, prompt, 데이터 제공업체, ranking, 공간 도구, 권한, 커버리지가 바뀔 때마다 다시 실행하세요. 프로덕션 행동은 지속적으로 관찰해야 합니다. 출시 당일 보고서 하나는 release process가 아닙니다.
하나의 benchmark로 모든 시스템을 비교할 수 있는가?
연구 benchmark는 명시된 역량을 비교할 수 있습니다. 프로덕션 평가는 해당 애플리케이션의 지리적 작업, 데이터, 위험, 도구, 결과를 반영해야 합니다. GeoAI benchmark와 제품 benchmark는 서로 대체할 수 없습니다.
참고문헌
- National Institute of Standards and Technology. AI RMF Playbook, Measure. Notes that the AI RMF 1.0 is being updated and that the playbook will be revised afterward. Accessed September 29, 2026. https://airc.nist.gov/airmf-resources/playbook/measure/
- National Institute of Standards and Technology. The TEVV-Athlon Framework for Evaluating AI Systems. NIST AI 200-2, initial public draft. Announced August 7, 2026; comments through October 6, 2026. https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems
- Krechetova, Varvara, and Denis Kochedykov. GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks. arXiv:2503.18129, submitted March 23, 2025, revised October 22, 2025. https://arxiv.org/abs/2503.18129
- Pothuri, Abhinav, Zhe Jiang, Zelin Xu, and Di Yang. GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks. arXiv:2608.01645, submitted August 3, 2026. https://arxiv.org/abs/2608.01645
- Rodrigues, Rodrigo Ferreira, Karim Radouane, Jose G. Moreno, and Lynda Tamine. GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks. arXiv:2608.07411, submitted August 7, 2026. Accepted at CIKM 2026. https://arxiv.org/abs/2608.07411
- OWASP Gen AI Security Project. LLM01:2025 Prompt Injection. Accessed September 29, 2026. https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed September 29, 2026. https://kaleidr.com/enterprise
- Kaleidr. Map Engagement and Location Analytics. Accessed September 29, 2026. https://kaleidr.com/analytics
- Kaleidr. Grounded Spatial AI for Business Data. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- Kaleidr. An Enterprise Spatial AI Pilot Before Scaling. https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling
@misc{nist_rmf_playbook_measure_2026,
  title  = {AI RMF Playbook, Measure},
  author = {{National Institute of Standards and Technology}},
  year   = {2026},
  note   = {Accessed September 29, 2026. Page states the playbook will be updated after the AI RMF revision},
  url    = {https://airc.nist.gov/airmf-resources/playbook/measure/}
}

@techreport{nist_ai_200_2_2026,
  title       = {The TEVV-Athlon Framework for Evaluating AI Systems},
  author      = {{National Institute of Standards and Technology}},
  institution = {National Institute of Standards and Technology},
  number      = {NIST AI 200-2},
  year        = {2026},
  note        = {Initial public draft, announced August 7, 2026},
  url         = {https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems}
}

@misc{krechetova_geobenchx_2025,
  title  = {GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks},
  author = {Krechetova, Varvara and Kochedykov, Denis},
  year   = {2025},
  note   = {arXiv:2503.18129, revised October 22, 2025},
  url    = {https://arxiv.org/abs/2503.18129}
}

@misc{pothuri_gisagentbench_2026,
  title  = {GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks},
  author = {Pothuri, Abhinav and Jiang, Zhe and Xu, Zelin and Yang, Di},
  year   = {2026},
  note   = {arXiv:2608.01645, submitted August 3, 2026},
  url    = {https://arxiv.org/abs/2608.01645}
}

@misc{rodrigues_geobenchllm_2026,
  title  = {GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks},
  author = {Rodrigues, Rodrigo Ferreira and Radouane, Karim and Moreno, Jose G. and Tamine, Lynda},
  year   = {2026},
  note   = {arXiv:2608.07411, submitted August 7, 2026, accepted at CIKM 2026},
  url    = {https://arxiv.org/abs/2608.07411}
}

@misc{owasp_llm01_2025,
  title  = {LLM01:2025 Prompt Injection},
  author = {{OWASP Gen AI Security Project}},
  year   = {2025},
  note   = {Accessed September 29, 2026},
  url    = {https://genai.owasp.org/llmrisk/llm01-prompt-injection/}
}

@misc{kaleidr_enterprise_accuracy_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_analytics_accuracy_2026,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/analytics}
}