
تقيس دقة Spatial AI ما إذا كان النظام الواعي بالموقع يفسر الطلب بشكل صحيح، ويحدد الأماكن المناسبة، ويستخدم بيانات حالية ومصرحًا بها، ويحسب الجغرافيا بصورة صحيحة، ويرتب الخيارات المؤهلة فقط، ويشرح الأدلة، وينفذ الإجراءات الصالحة فقط. قد تكون الإجابة سلسة ومقنعة ومع ذلك ترسل الشخص إلى الفرع الخطأ. ولا تستطيع درجة واحدة للنموذج إظهار كل ذلك. لذلك يجب أن يختبر الـ benchmark، قبل الإنتاج، المهمة التي يعد المنتج بتنفيذها فعليًا.
تفصل الأقسام التالية بين سلسلة القرار، والبوابات التي قد يخفيها المتوسط، وحالات الفشل التي ينبغي بناؤها مسبقًا، والحد الفاصل بين benchmarks البحثية وتقييم المنتج. ومن القراءات ذات الصلة Spatial AI المؤسس على بيانات الأعمال وتجربة Enterprise لـ Spatial AI. وقد يكون الرفض الصحيح أكثر دقة من توصية تبدو معقولة.
أساسيات دقة Spatial AI
- قيّم السلسلة: النية، والـ grounding، والأهلية، والحساب المكاني، والترتيب، والشرح، والإجراء، والنتيجة.
- تحقق من الحقائق خارج النموذج: هوية المكان، وساعات العمل، والمخزون، والصلاحيات، والمسارات يجب أن تبقى في الأنظمة المرجعية الموثوقة.
- أدرج الحالات الصعبة: الطلبات الغامضة، والبيانات القديمة، والطلبات غير المصرح بها، والحالات المصممة لتكون غير قابلة للحل.
- أبقِ البوابات منفصلة: لا ينبغي لنتيجة مرتفعة في طبقة منخفضة المخاطر أن تعوض عن فشل في الصلاحيات.
- اربط التقييم بالمهمة: حالات الاختبار offline ونتائج الإنتاج تجيب عن أسئلة مختلفة. تحتاج إلى الاثنين.
ما المقصود بدقة Spatial AI؟
قد يسأل العميل عن المتجر القريب من طريق عودته إلى المنزل الذي ما زال لديه منتج في المخزون وسيكون مفتوحًا عند وصوله. تتضمن هذه الجملة عدة مشكلات مستقلة: ماذا يريد الشخص، وما المتاجر الموجودة، وهل بيانات المخزون حديثة، وهل ساعات العمل تناسب وقت الوصول، وأي الفروع يمكن الوصول إليها فعليًا عبر المسار، وأي قواعد أعمال تستبعد مرشحًا، وكيف ينبغي ترتيب الخيارات المتبقية وشرحها. لا تثبت جملة ختامية سلسة أن كل خطوة صحيحة. يجب أن يفصل التقييم بين الطبقات، لأن خطأ حلّ هوية المكان لا يُصلح بإعادة كتابة prompt للترتيب، كما أن تغذية مخزون قديمة لا تُصلح بتبديل نموذج اللغة.
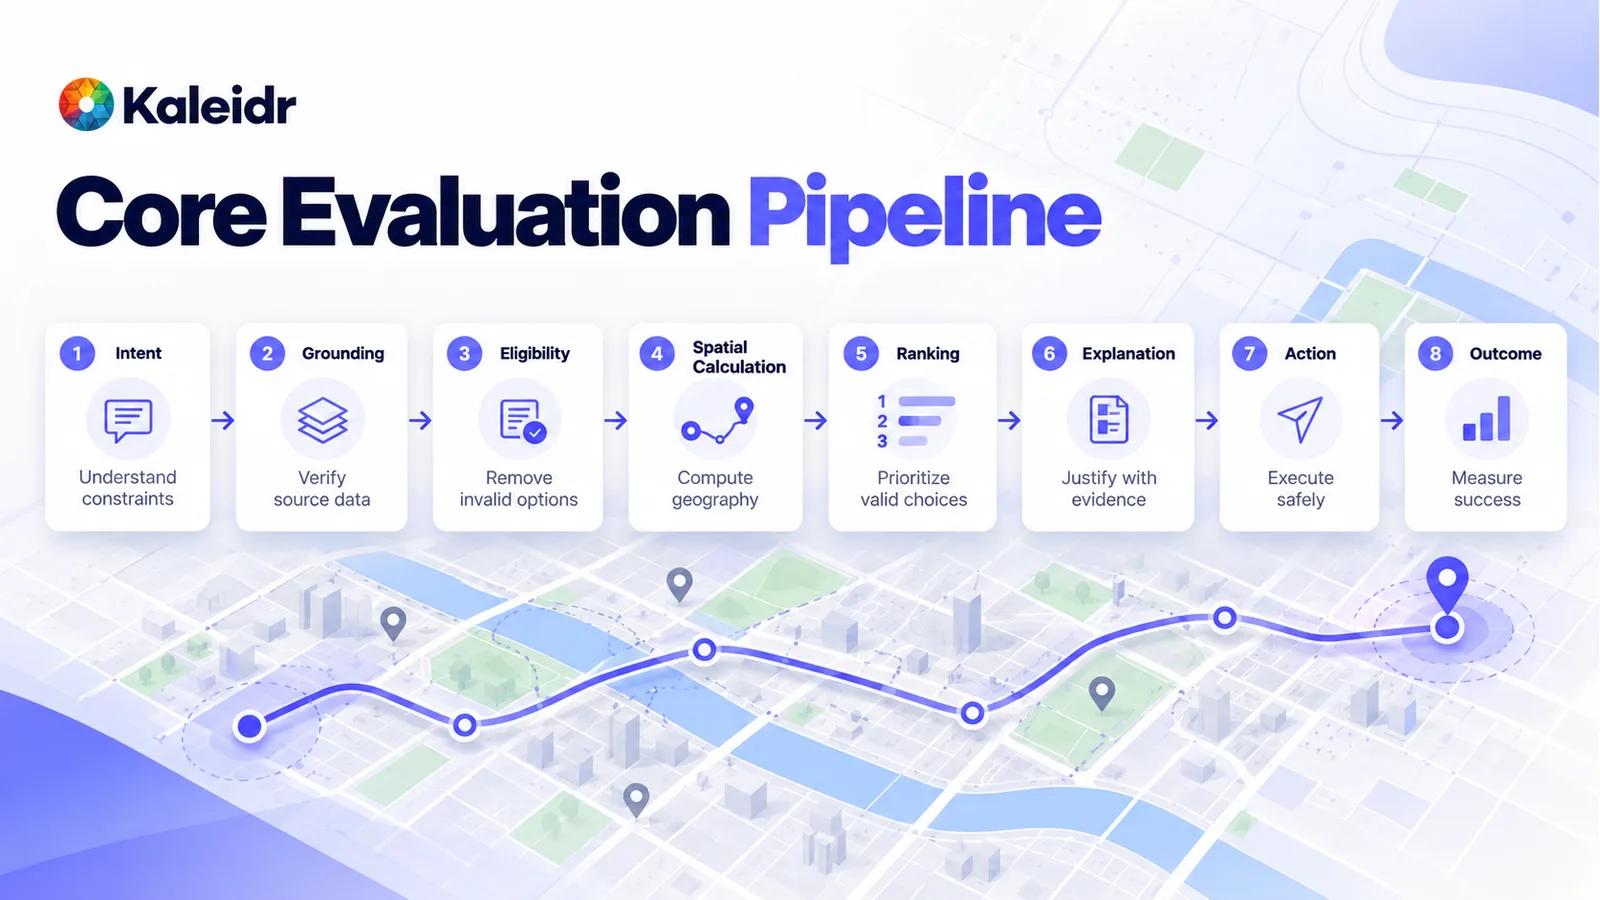
اختبر السلسلة بالترتيب: افهم القيود، وتحقق من المصدر، واستبعد الخيارات غير الصالحة، واحسب الجغرافيا، ورتب ما تبقى، وبرر النتيجة بالأدلة، ونفذ الإجراء فقط إذا كان مسموحًا، ثم قِس ما إذا كانت المهمة قد اكتملت.
لماذا لا تكفي درجة واحدة؟
النسبة الإجمالية سهلة المقارنة وسهلة إساءة الاستخدام أيضًا. قد تُظهر scorecard توضيحية دقة إجمالية قدرها 92% بينما تكون النية عند 99%، والتوجيه عند 98%، والشرح عند 96%، والتفويض عند 75%. هذه الأرقام مثال وليست نتيجة من Kaleidr. قد يبدو المتوسط قويًا بينما يستطيع النظام كشف بيانات لا ينبغي للمستخدم الوصول إليها أو تنفيذ إجراء بناءً عليها. تحتاج الأبعاد الحرجة إلى بوابات إنتاج مستقلة. لا ينبغي للأداء الممتاز في مهمة منخفضة المخاطر أن يعوض عن فشل في الصلاحيات أو وجهة غير صالحة أو إجراء غير مدعوم أو توافر مُختلق.
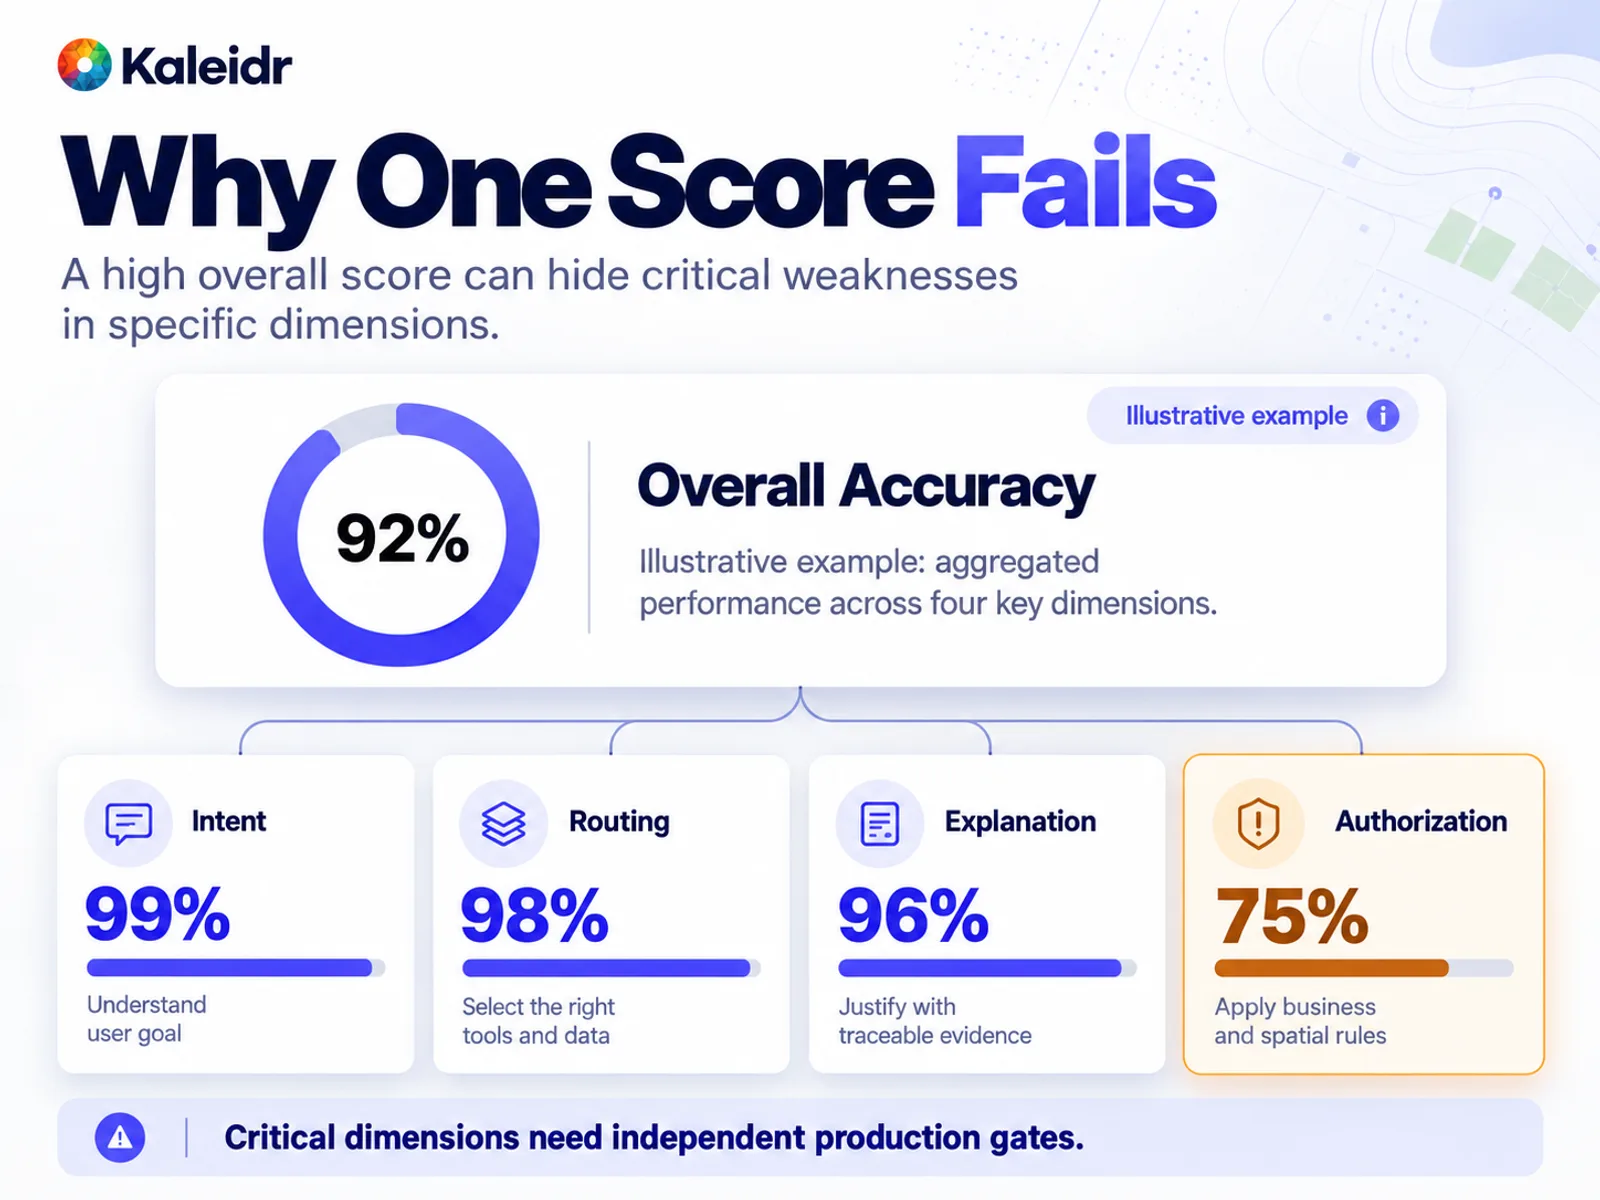
قد تخفي الدرجة الإجمالية المرتفعة بوابة ضعيفة. النسب الواردة في هذا الشكل مثال توضيحي وليست أداءً مقاسًا لـ Kaleidr.
يوضح playbook الخاص بـ NIST AI Risk Management Framework أن القياس ينبغي أن يبدأ بأهم المخاطر، وأن المخاطر التي لن تُقاس يجب توثيقها. وتشير الصفحة نفسها إلى أن AI RMF 1.0 قيد التحديث وأن الـ playbook سيُراجع بعد ذلك (NIST, 2026). كما يصف المسودّة العامة الأولية لإطار TEVV-Athlon من NIST، وهو NIST AI 200-2، والمعلن عنها في 7 أغسطس 2026 مع فتح التعليقات حتى 6 أكتوبر 2026، التقييم بأنه دليل على أن النظام يحقق أهدافًا فردية أو مؤسسية باستخدام قياسات مخصصة لتلك الاحتياجات، بما في ذلك الأثر في العالم الحقيقي (NIST, 2026). الوثيقة مسودة مفتوحة للملاحظات. وهي ليست قائمة ضوابط لـ Kaleidr. وبالنسبة إلى منتج واعٍ بالموقع، فإن السياق المهم هو القرار الجغرافي الذي يتخذه المنتج فعليًا.
كيف ينبغي اختبار النية والمكان والأهلية؟
تأتي النية أولًا. طلب مقهى مناسب للكراسي المتحركة بين فندق ومكان فعالية، ومفتوح قبل الساعة 7 صباحًا، لا يعني "مقاهي بالقرب من الفندق". خزّن القراءة المنظمة المتوقعة لكل استعلام اختبار: الفئة، والعلاقة الجغرافية، ونقطة الانطلاق، والوجهة، وإمكانية الوصول، والوقت. بعد ذلك قِس استخراج القيود، والقيود التي اخترعها النظام، والقيود التي أسقطها. النظام الذي يحدد الفئة بشكل صحيح لكنه يتجاهل النافذة الزمنية لم يفسر المهمة كما ينبغي.
لغة الأماكن غامضة. Springfield وTerminal 2 وMain Street و"متجرنا في Austin" يمكن لكل منها أن يشير إلى أكثر من كيان. أدرج مدنًا متشابهة الأسماء، وأسماء فروع متطابقة، ومحطات متعددة، وأماكن أعيدت تسميتها، واختصارات، وأسماء متعددة اللغات، وأحياء بلا حدود حادة، وعناوين تقع على حد إداري. قيّم معرفات الأماكن canonical بدلًا من مطابقة النص في الاسم. المقهى الخطأ على بُعد مبنى واحد والوجهة في مدينة خاطئة كلاهما غير صحيح، لكنهما لا يحملان الدرجة نفسها من الخطورة.
الأهلية تسأل ما إذا كان المكان يجوز أخذه في الاعتبار أصلًا. أما الترتيب فيسأل عن موقع المكان الصالح ضمن النتائج. قد يكون الفرع أقرب pin، ومع ذلك يكون مغلقًا أو بلا مخزون أو خارج منطقة الخدمة أو محجوزًا بالكامل أو ممنوعًا وفق السياسة. يجب إزالة هذه العناصر من المجموعة قبل ترتيب ما تبقى. دقة الأهلية هي عدد الأماكن المؤهلة المعادة مقسومًا على جميع الأماكن المعادة. وفي تدفق عالي المخاطر، قد تكون عدة توصيات غير مؤهلة أكثر أهمية من متوسط جودة الترتيب. يظل المخزون وساعات العمل والصلاحيات والسياسات في الأنظمة التي تملك تلك السجلات. ويوضح Spatial AI المؤسس على بيانات الأعمال الحد نفسه على مستوى المنتج.
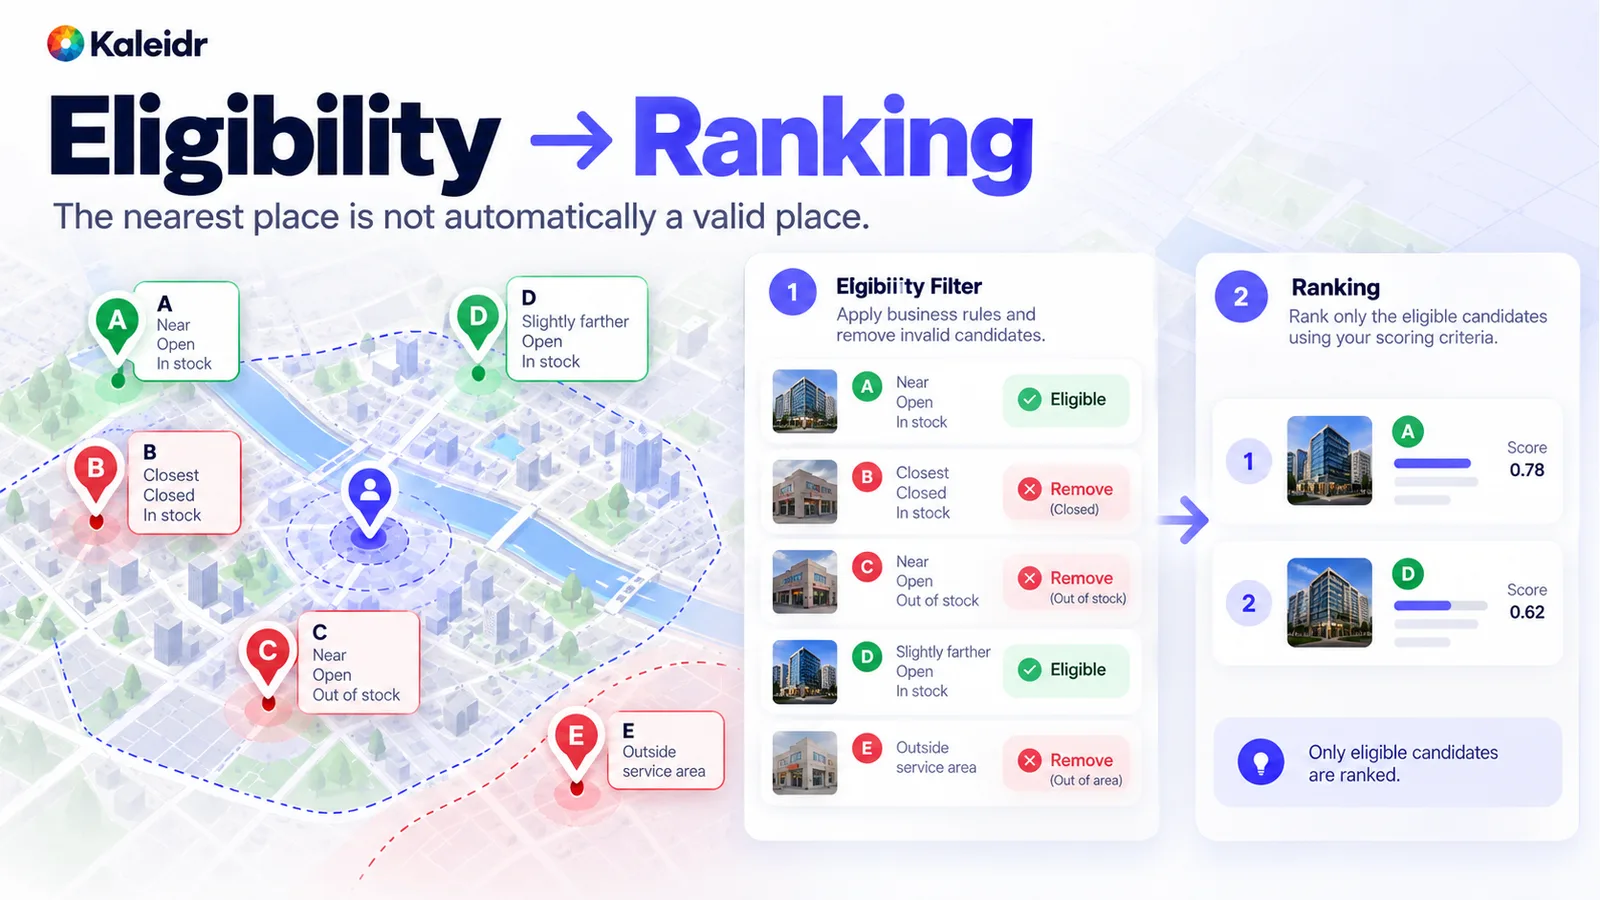
صفِّ الأهلية أولًا. أقرب مكان ليس بالضرورة مكانًا صالحًا.
كيف ينبغي التحقق من الجغرافيا وحداثة البيانات؟
لا ينبغي أن يكون نموذج اللغة مصدر الحقيقة لحساب يمكن لمحرك مكاني تنفيذه. يشمل ذلك point-in-polygon، ومسافة المسار، ووقت السفر، والانتماء إلى منطقة خدمة، والاحتواء، والترتيب على طول المسار. أنشئ الإجابة المتوقعة من بيانات جغرافية موثوقة وأداة موثوقة، ثم قارن نتيجة التطبيق بتلك الإجابة. تطابق دقيق مناسب لأسئلة مثل "هل تقع هذه النقطة داخل هذا المضلع؟" و"هل أعاد النظام الفرع ذي المعرّف 172؟". أما التحمّل المحدد مسبقًا فيناسب الإحداثيات، ووقت السفر التقديري، والحدود المرسومة بدرجات دقة مختلفة. لا تقرر بعد التشغيل أن النتيجة الخاطئة كانت قريبة بما يكفي.
حداثة البيانات سؤال منفصل عن الصحة التاريخية. قد تبقى الإحداثيات وهوية الفرع ثابتة بينما تتغير ساعات العمل والمخزون وحركة المرور وحالات الإغلاق. تتبع نسبة القرارات التي اتُّخذت باستخدام بيانات خارج حد الحداثة، ونسبة الحقول الحساسة للوقت التي تحمل وقت تحديث معروفًا. البيانات المفقودة ليست حقيقة مساوية لعبارة "غير متاح". إجابة واثقة بـ نعم أو لا مبنية على حالة مجهولة تُعد فشلًا حتى إذا كان المكان نفسه حقيقيًا.
متى تكون «لا توجد نتيجة» هي الإجابة الدقيقة؟
قد يطلب العميل موقعًا ضمن عشر دقائق يتوفر فيه منتج بعد الساعة 9 مساءً، بينما لا يوجد أي مكان يحقق ذلك. النظام الضعيف يخفف القيد بصمت ويعيد فرعًا يبعد عشرين دقيقة. أما النظام grounded فيوضح أنه لا توجد أي خيار متحقق منه يفي بجميع الشروط. يجب أن تتضمن benchmarks مهام مصممة عمدًا لتكون غير قابلة للحل، ثم تقيس معدل الإجابة الصحيحة بـ «لا توجد نتيجة» ومعدل التوصيات الكاذبة. يتضمن GeoBenchX، وهو benchmark من عام 2025 لوكلاء يستدعون الأدوات في مهام جغرافية متعددة الخطوات، مهام قابلة للحل وأخرى متعمدة الاستحالة لقياس دقة الرفض (Krechetova and Kochedykov, 2025). هذه الورقة تقيم وكلاء بحثيين. GeoBenchX لا يقيم Kaleidr، ولا يزال على فريق المنتج كتابة حالات غير قابلة للحل مرتبطة بمهمته الخاصة.
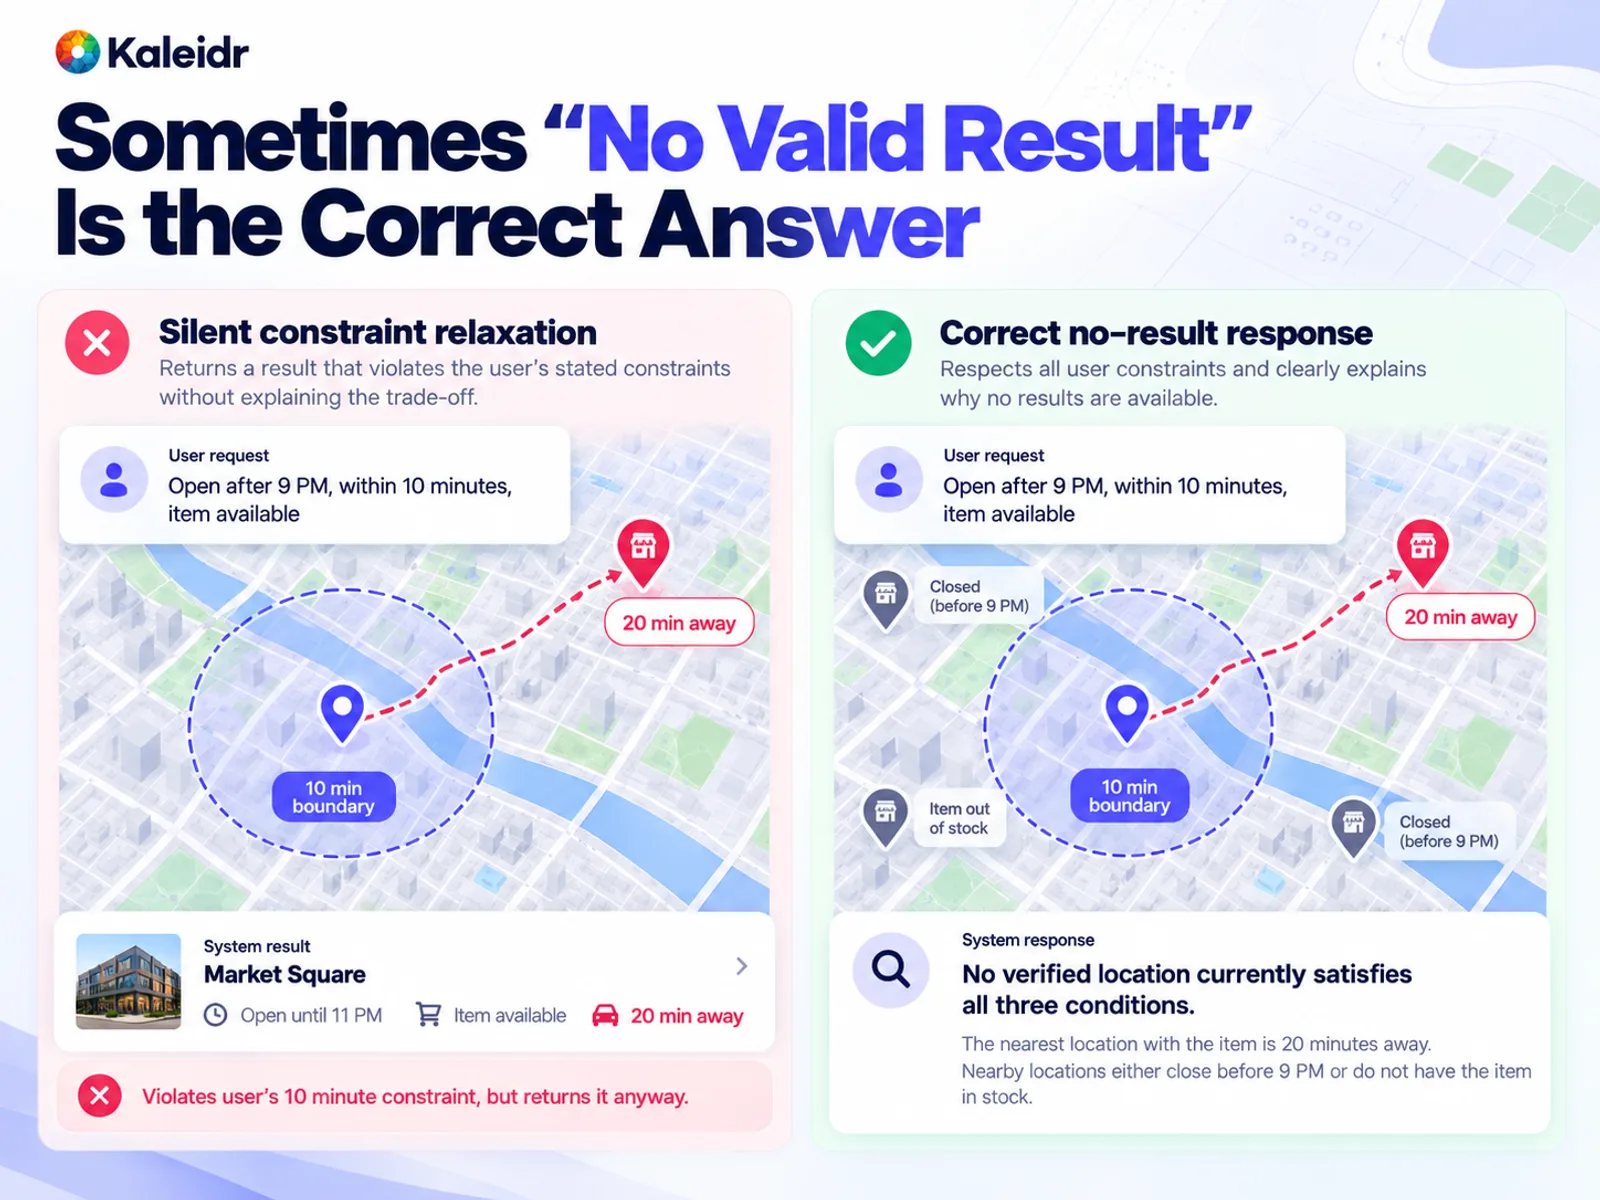
أحيانًا يكون عدم وجود نتيجة صالحة هو الجواب الصحيح. إعادة مكان خارج الوقت أو المسافة المحددين توصية خاطئة وليست fallback مفيدة.
كيف ينبغي تقييم الترتيب والشرح والإجراءات؟
لا ترتب النتائج إلا بعد إزالة المرشحين غير الصالحين. الأقرب ليس دائمًا الأفضل. يمكن أن تدخل مدة السفر، والانحراف عن المسار، والتوافر، وإمكانية الوصول، والسعر، ونافذة الفتح، وأولوية العمل ضمن الهدف إذا كان المنتج يعرّفها كذلك. ومن المقاييس المفيدة: عدد المرات التي تكون فيها النتيجة الأولى مقبولة، وعدد المرات التي يظهر فيها خيار مقبول ضمن أول K نتائج، ومدى الاتفاق مع ترتيب راجعه البشر أو حددته سياسة، والـ regret مقارنة بأفضل خيار مؤهل معروف. لا تعتبر engagement مقياسًا لجودة الترتيب. اربط ترتيب النتائج بالفعل الذي احتاج العميل إلى تنفيذه.
شرح مثل "مفتوح حتى 10 مساءً، المنتج متوفر، ويضيف ست دقائق إلى المسار" لا يكون دقيقًا إلا إذا أمكن إرجاع كل عبارة إلى دليل استخدمه النظام بالفعل. تحقق من هوية المكان، وادعاء التوافر، وساعات العمل، وما إذا كان قد تم حساب المسار فعلًا، وما إذا كان النص يتطابق مع قرار الترتيب. قد تكون الفقرة المصقولة خاطئة. وقد تكون الجملة القصيرة غير الأنيقة صحيحة. قِس الادعاءات المتحقق منها مقارنة بكل الادعاءات الواقعية في الشرح.
الإجراءات جزء من الإجابة. قد يكون تحريك الخريطة أو إضافة marker أو طلب مسار أو تغيير filter أو بدء حجز إجراءً خاطئًا حتى لو كانت الجملة صحيحة. تتبع ما إذا كان الإجراء ضمن مفردات التطبيق، وما إذا كان الهدف والمعلمات صحيحين، وما إذا كان المستخدم مخولًا بتنفيذه. جملة صحيحة مرتبطة بإجراء خريطة خاطئ لا تزال تفاعلًا فاشلًا.
ما حالات الفشل التي يجب أن تدخل في الـ benchmark؟
مجموعة اختبار تتكون فقط من أمثلة نظيفة يعرف الفريق بالفعل كيفية حلها ستبالغ في تقدير الاعتمادية. أدرج أسماء غامضة، وفروعًا متكررة، وعناوين على حافة منطقة خدمة، وطلبات غير قابلة للحل، ومتجرًا أغلق للتو، ومخزونًا لا يطابق المكان، وpin قريبًا يسبب انحرافًا كبيرًا في المسار، ووقت إغلاق يسبق الوصول، ومنشأة خاصة لا يحق للمستخدم رؤيتها، واسمًا محليًا يختلف عن الاسم الإنجليزي، وساعات عمل مجهولة، ومصدرًا عامًا يخالف بيانات first-party، ونصًا مسترجعًا يحاول توجيه النموذج، وخدمة توجيه أو بيانات أعمال متوقفة. الهدف هو محاكاة القرارات التي سيواجهها النظام في الإنتاج فعلًا.
النص المسترجع الذي يحاول توجيه النموذج يمثل حالة prompt injection. تصف OWASP فئة LLM01:2025 Prompt Injection بأنها إدخال من المستخدم أو من المحتوى المسترجع يغير سلوك النموذج بطرق غير مقصودة، بما في ذلك التأثير في قرار حرج، وتشير إلى أن retrieval-augmented generation لا يزيل هذا الضعف بالكامل (OWASP, 2025). ضع هذه الحالة ضمن عائلة الأمن في مجموعة الاختبار، بجانب الصلاحيات، بدلًا من التعامل مع الأمن كملاحق لاحقة.
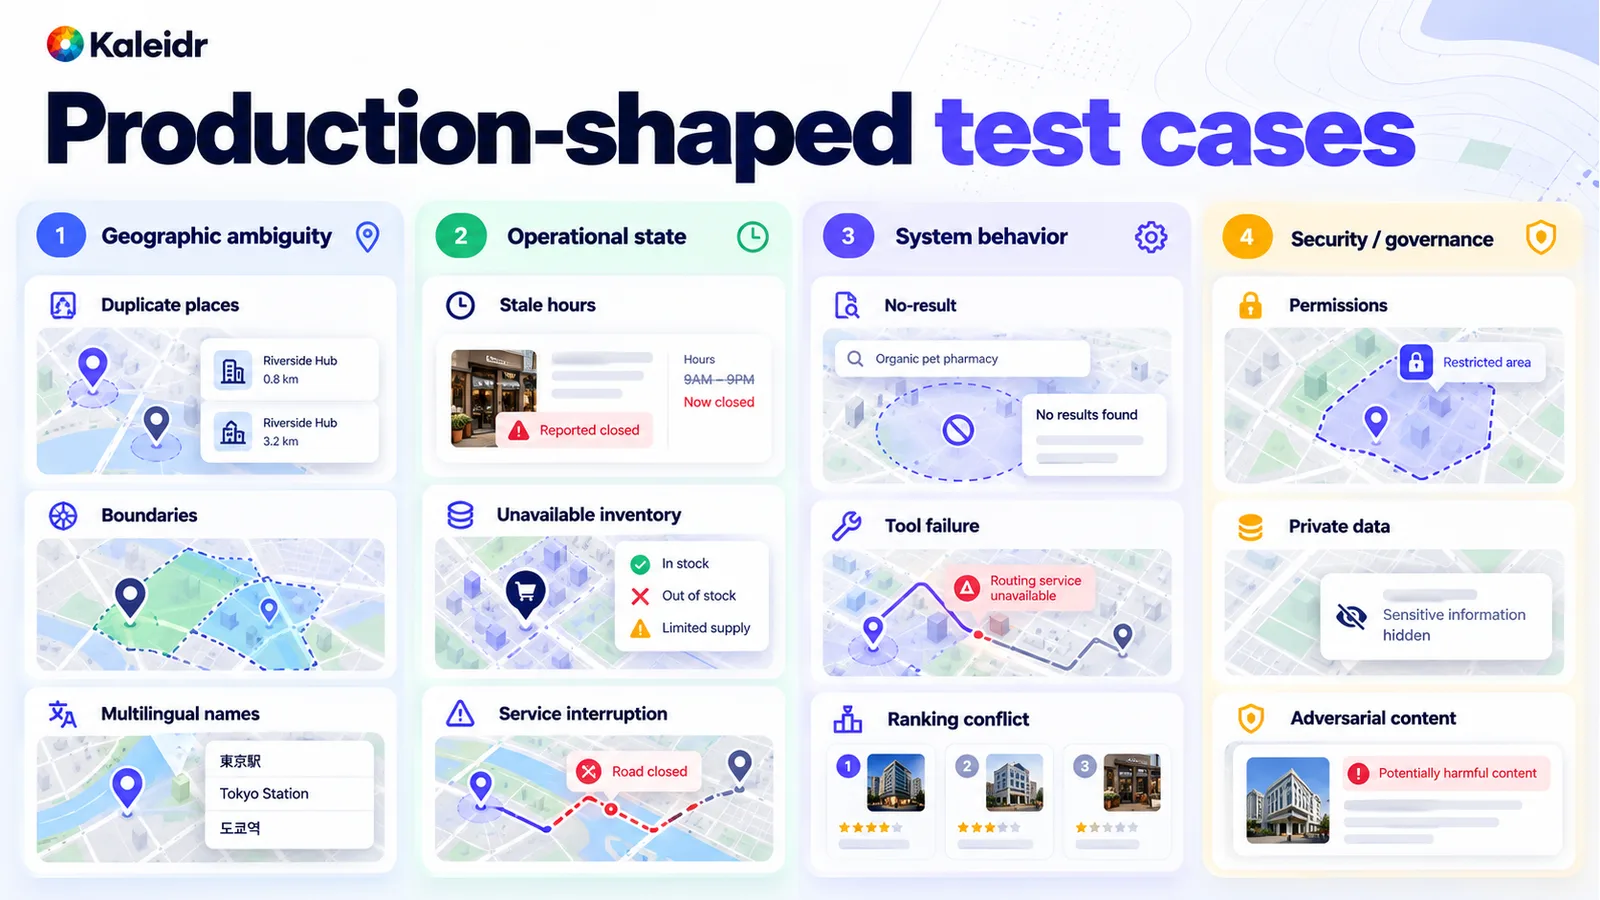
الحالات المصممة لتشبه الإنتاج تغطي الغموض الجغرافي والحالة التشغيلية وسلوك النظام والأمن. benchmark يتجاهلها سيبالغ في تقدير الاعتمادية.
لماذا يجب أن توجد الحقيقة المرجعية قبل التشغيل؟
يحتاج كل اختبار إلى حقيقة مسجلة كافية لتعريف معنى «الصواب»: الاستعلام، وسياق المستخدم، والمصادر المصرح بها، والنية المتوقعة، والقيود المطلوبة، والأماكن canonical، ومجموعة العناصر المؤهلة، والعلاقة المكانية المتوقعة، وأفضل نتيجة، والبدائل المقبولة، والإجراء المتوقع، وسبب صحة «لا توجد نتيجة»، والتسامح، وشدة الخطأ إذا أخفق النظام. اكتب هذا السجل قبل تشغيل النظام. تكييف مفتاح الإجابة مع ما أنتجه النموذج ليس تقييمًا.
يرى GISAgentBench، وهو benchmark لعام 2026 مبني على 349 مهمة GIS متعددة الخطوات من واقع الممارسين، أن كثيرًا من benchmarks لوكلاء GIS تفتقر إلى مخرجات ground-truth وتستخدم بدلًا منها إشارات بديلة مثل تشابه الكود أو مطابقة المسار أو model judge، ما قد يجعل سير عمل مشابه يبدو كأنه نتيجة صحيحة. وتحتوي كل مهمة في GISAgentBench على ملف مخرجات ground-truth دقيق (Pothuri et al., 2026). استخدم الكود أو سجلًا موثوقًا عندما يكون السؤال deterministic: الإحداثيات، والاحتواء، والمعرف canonical، ومفتوح أو مغلق، والصلاحية، وأي API action تم استدعاؤه. احتفظ بالمراجعة البشرية، أو مراجعة بمساعدة نموذج معاير، للأسئلة الذاتية فعلًا مثل ما إذا كان الشرح مفهومًا. يجب أن يطابق المقيم نوع الحقيقة الجاري اختبارها.
كيف ينبغي للفرق قراءة نتيجة مقسمة؟
قد يخفي المتوسط جغرافيا ضعيفة. قسّم النتائج بحسب البلد، والسوق، واللغة، والتغطية الحضرية والريفية، ومزود البيانات، وفئة المكان، وكثافة الفروع، وتعقيد الاستعلام، ونوع المسار. افترض أن معدل النتائج الصالحة الإجمالي 95% بينما سوق جديد عند 78%. هذا المثال افتراضي وليس قياسًا لـ Kaleidr. قد يكون المتوسط صحيحًا حسابيًا لكنه الرقم الخطأ لاتخاذ قرار التوسع. افحص مكان حدوث الأخطاء، ثم صنف كل حالة فاشلة ضمن فئة: التفسير، أو حل الكيان، أو grounding، أو الأهلية، أو الحساب المكاني، أو الحداثة، أو الترتيب، أو الشرح، أو الإجراء، أو الأمن، أو الاستعادة. الفئة تخبر الفريق ما الذي يجب تغييره. خطأ التوجيه ليس مشكلة شرح.
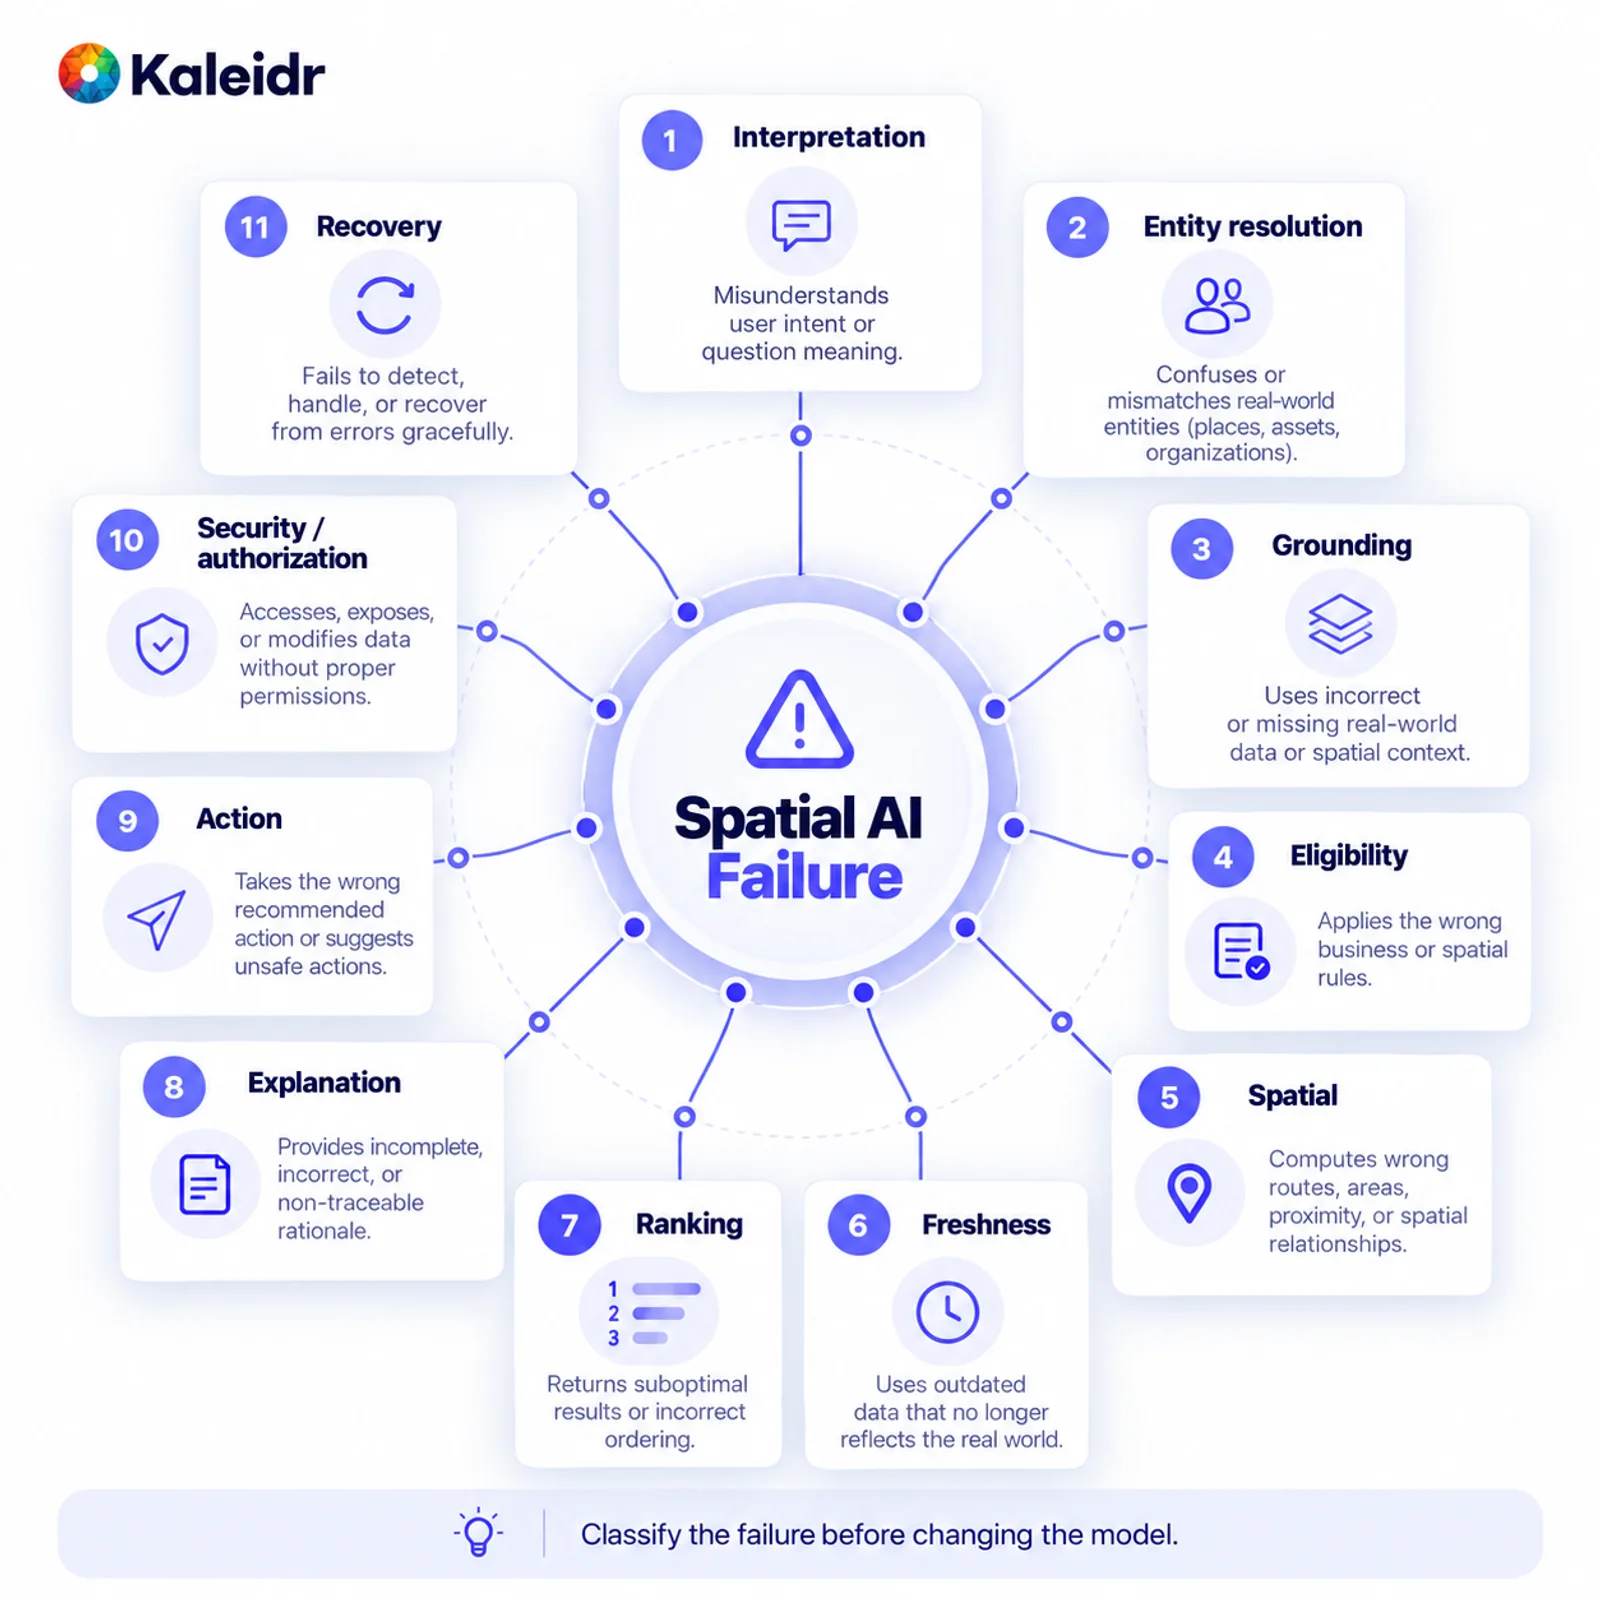
صنّف الفشل قبل تغيير النموذج. إبقاء الفئات منفصلة يمنع خطأ نادرًا وخطيرًا من الاختفاء داخل متوسط كبير.
كما تختلف عمليات التشغيل التوليدية. في الحالات المهمة، سجّل المتوسط، وأسوأ تشغيل تمت ملاحظته، ومدى تكرار الفشل. استعلام آمن تسع مرات وخاطئ مرة واحدة يحمل مخاطرة مختلفة عن استعلام يعطي الإجابة الآمنة نفسها في كل مرة. أعد تشغيل المجموعة عندما تتغير prompts أو النماذج أو الاسترجاع أو الترتيب أو مزودو البيانات أو الأدوات أو التغطية. التقييم جزء من إدارة الإصدارات، وليس تقريرًا وحيدًا قبل الإطلاق.
ماذا يجب أن تتضمن scorecard الإنتاج؟
أعطِ كل بُعد مقياسه الخاص وبوابته الخاصة. يمكن قياس النية بدقة استخراج القيود. ويمكن قياس هوية المكان بدقة المكان canonical. ويمكن قياس التفويض والأمن بمعدل وصول غير مصرح به لا يسمح بتسرب البيانات المحمية. تحتاج الأهلية، والحساب المكاني، والحداثة، والترتيب، والتعامل مع «لا توجد نتيجة»، والشرح، والإجراءات، والنتيجة إلى حد خاص يحدده مالك المنتج قبل التشغيل. لا تنسخ حدًا عالميًا من تطبيق آخر. توصية عادية بمطعم وقرار توجيه له عواقب سلامة لا يتشاركان ميزانية الخطأ نفسها.
| البُعد | مثال على المقياس | مثال على البوابة |
|---|---|---|
| النية | دقة استخراج القيود | تُحدد لهذا المنتج |
| هوية المكان | دقة المكان canonical | مرتفعة جدًا |
| التفويض | معدل الوصول غير المصرح به | لا يُسمح بأي حالة للبيانات المحمية |
| الأهلية | دقة النتائج المؤهلة | مرتفعة جدًا |
| الحساب المكاني | صحيح ضمن تسامح محدد مسبقًا | يُحدد لهذا المنتج |
| الحداثة | نسبة النتائج داخل نافذة الحداثة | تُحدد لهذا المنتج |
| الترتيب | قبول Top-1 أو Top-K | يُحدد لهذا المنتج |
| التعامل مع عدم وجود نتيجة | معدل الرفض الصحيح | مرتفع |
| الشرح | معدل الادعاءات المدعومة | مرتفع |
| الإجراءات | معدل الإجراءات الصالحة والمُعلمة بشكل صحيح | مرتفع جدًا |
| النتيجة | إكمال المهمة المعتمدة على الموقع | يجب أن يحسن المهمة المقصودة |
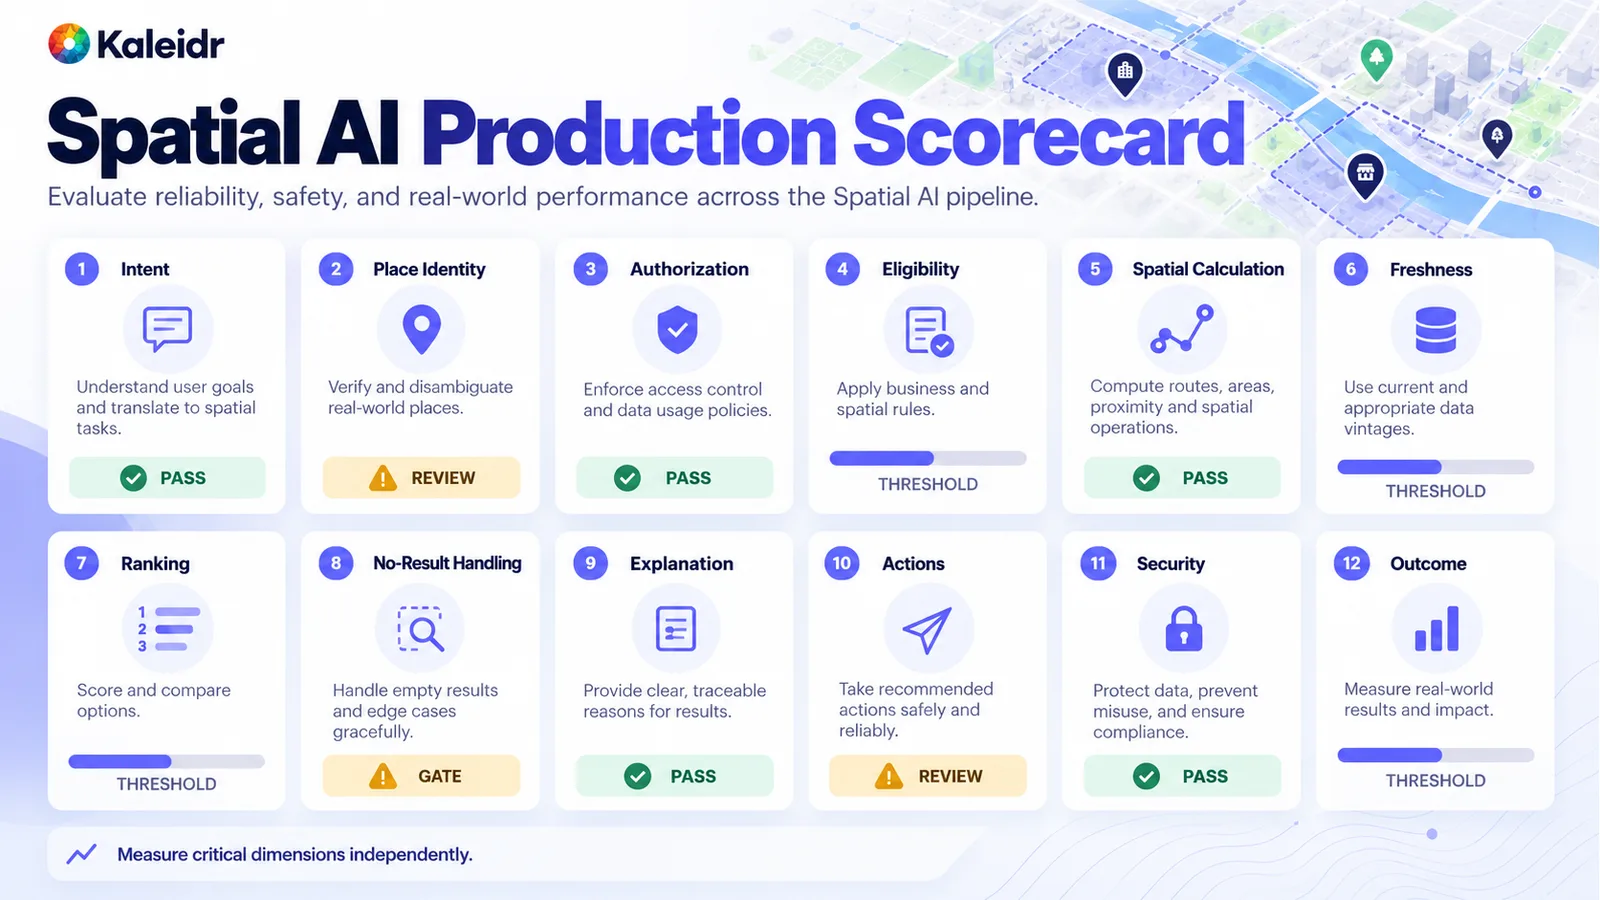
قِس الأبعاد الحرجة بشكل مستقل. تسميات الحالة في هذه scorecard placeholders وليست درجات benchmark لـ Kaleidr.
كيف ينبغي للفريق أن يقرر التوسع؟
استخدم البوابات، لا درجة ممزوجة. توسع عندما تستمر النتائج الصالحة والـ grounded والصحيحة مكانيًا في ظروف شبيهة بالإنتاج، وتكون فئات الأخطاء الحرجة تحت السيطرة، ويكون هناك مالك واضح للبيانات التشغيلية، وتتحسن النتيجة المقصودة. كرر وحسّن عندما تكون المهمة ذات قيمة وتظل طبقة قابلة للإصلاح ضعيفة. ضيق النطاق عندما يخلط pilot عددًا كبيرًا من الجغرافيات أو المصادر أو المهام بحيث يصعب معرفة سبب الفشل. توقف عندما لا يستطيع الفريق تحديد البيانات المرجعية، أو السيطرة على فشل حرج، أو تعريف المهمة، أو إثبات تحسن مقارنة بسير العمل الحالي. تجربة Enterprise لـ Spatial AI هي الاختبار المحدود. والـ scorecard هي ما يحول ذلك الاختبار إلى قرار.
أين يقع Kaleidr ضمن التقييم؟
يصف Kaleidr Enterprise بنية تحتية لـ location intelligence تشمل inference APIs وأنظمة ترتيب وanalytics ودعم النشر، بما في ذلك chat والتحرير وtiles وviewers قابلة للتضمين يمكن للمضيف إضافتها إلى جانب خريطة يشغلها بالفعل (Kaleidr, 2026). يحتفظ تطبيق المضيف بأنظمة الأعمال التي يملكها: المخزون، والصلاحيات، وحالة العميل، والحجز، وسجلات التشغيل الخاصة الأخرى. الأدوات المكانية مسؤولة عن الحسابات التي يمكن تنفيذها بصورة حتمية. طبقة نموذج اللغة تفسر النية، وتنسق القدرات المدعومة، وتشرح النتائج grounded. وتصف صفحة Kaleidr Analytics العامة، بعنوان Map Engagement and Location Analytics، مدى الوصول، والمشاهدات، والتفاعل، وموقع الجمهور ونشاطه، والجلسات والتفاعلات لكل خريطة، ومقارنة الأماكن، والأنماط المكانية (Kaleidr, 2026). هذه التقارير تصف سلوك الخريطة والمكان. أما الحجوزات المكتملة والطلبات والعملاء المحتملون المؤهلون فتظل في أنظمة المضيف التي تسجلها.
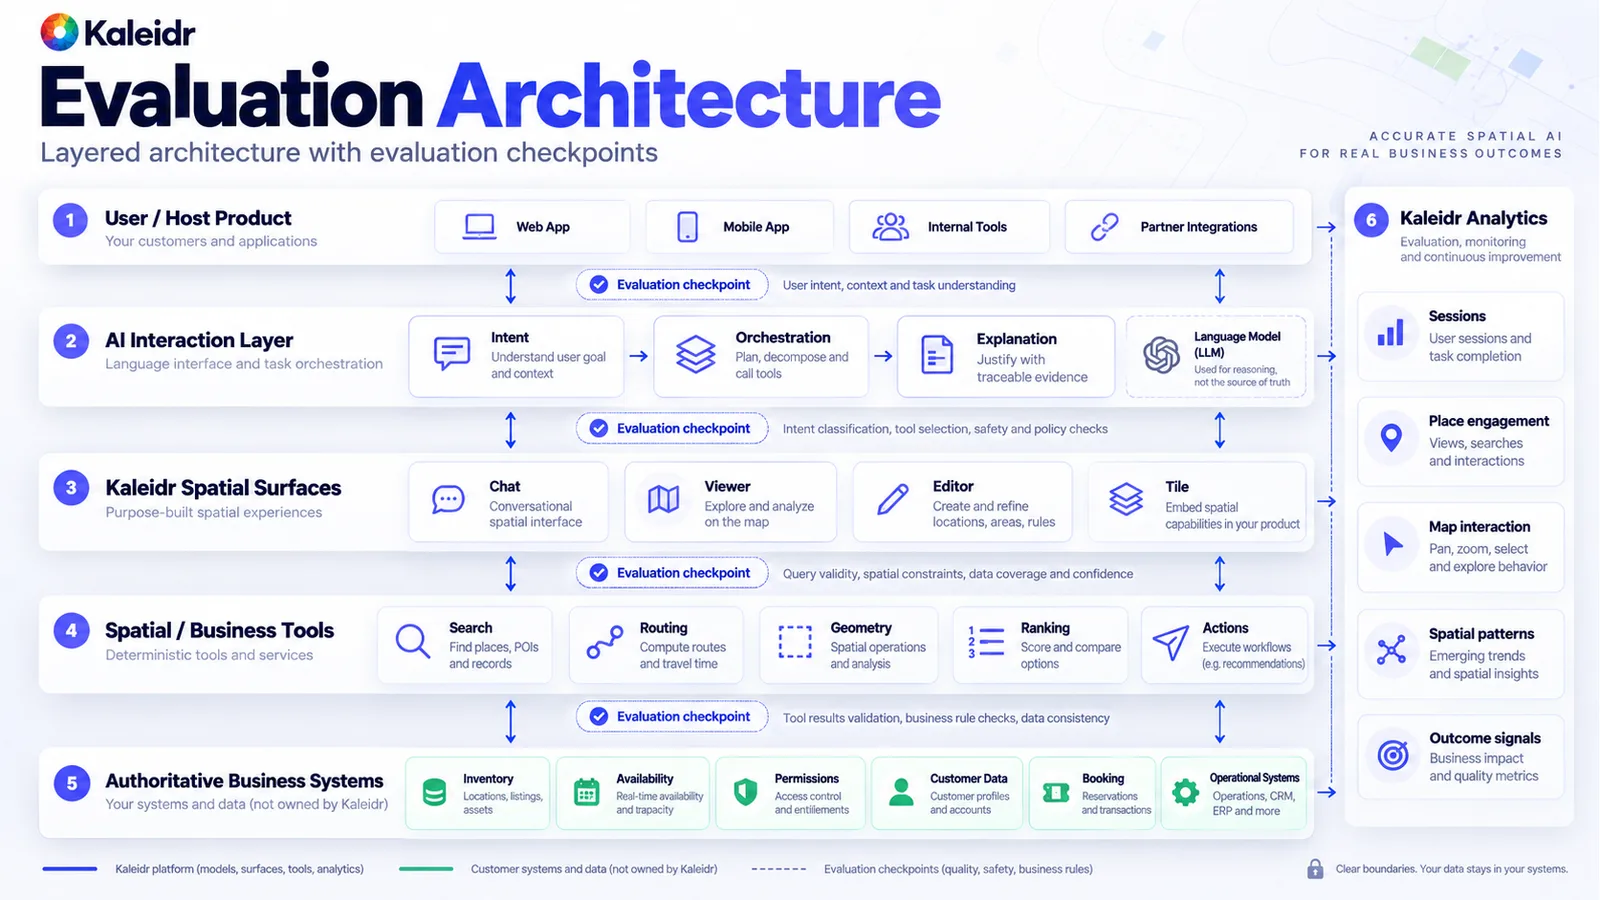
نموذج اللغة ليس مصدر الحقيقة للمخزون أو الصلاحيات أو المسار. نقاط التحقق بين الطبقات توضح أي جزء فشل.
ما الأخطاء التي تخفي benchmark ضعيفًا؟
أسئلة happy path من دون غموض أو بيانات مفقودة أو طلب غير قابل للحل تبالغ في تقدير الاعتمادية. تقييم مدى تشابه الصياغة فقط مع مرجع قد يفشل في احتساب قرار صحيح صيغ بطريقة مختلفة، ويكافئ مكانًا خاطئًا كُتب بأسلوب المرجع. ترتيب مجموعة ما زالت تحتوي على أماكن غير مؤهلة يخفي فشل الأهلية. مطالبة النموذج بفحص مسافة يمكن للمحرك المكاني حسابها تستبدل الحساب بالطلاقة اللغوية. تجاهل الحداثة يعامل ساعات عمل أمس كما لو كانت ساعات اليوم. اعتبار زيادة التفاعل مع الخريطة دقة يخلط الاهتمام بالنجاح، وأحيانًا بالارتباك. تغيير هامش التحمّل بعد رؤية الأرقام ليس benchmark. واختبار النموذج وحده يتجاهل الاسترجاع والبيانات والأدوات والصلاحيات والترتيب والواجهة. سلوك الإنتاج هو سلوك المنتج المركب بأكمله.
تظل benchmarks البحثية مفيدة لاستكشاف القدرات. GeoBenchLLM، المقدم في أغسطس 2026 والمقبول في CIKM 2026، يقيم نماذج اللغة على مهام مرتبطة بالجغرافيا مأخوذة من datasets عامة، بما في ذلك الفهم الجغرافي المكاني والزمني (Rodrigues et al., 2026). تغطي benchmarks في GeoAI غالبًا الاستشعار عن بُعد، وGIS workflows، والصور، أو مهام النماذج الجغرافية. وقد يحتاج benchmark المنتج أيضًا إلى grounding ببيانات الأعمال، والصلاحيات، والتوافر الحي، والترتيب، وإجراءات الخريطة، ونتيجة العميل. لا يمكن لـ benchmark عام واحد أن يحل محل مهمة كل منتج.
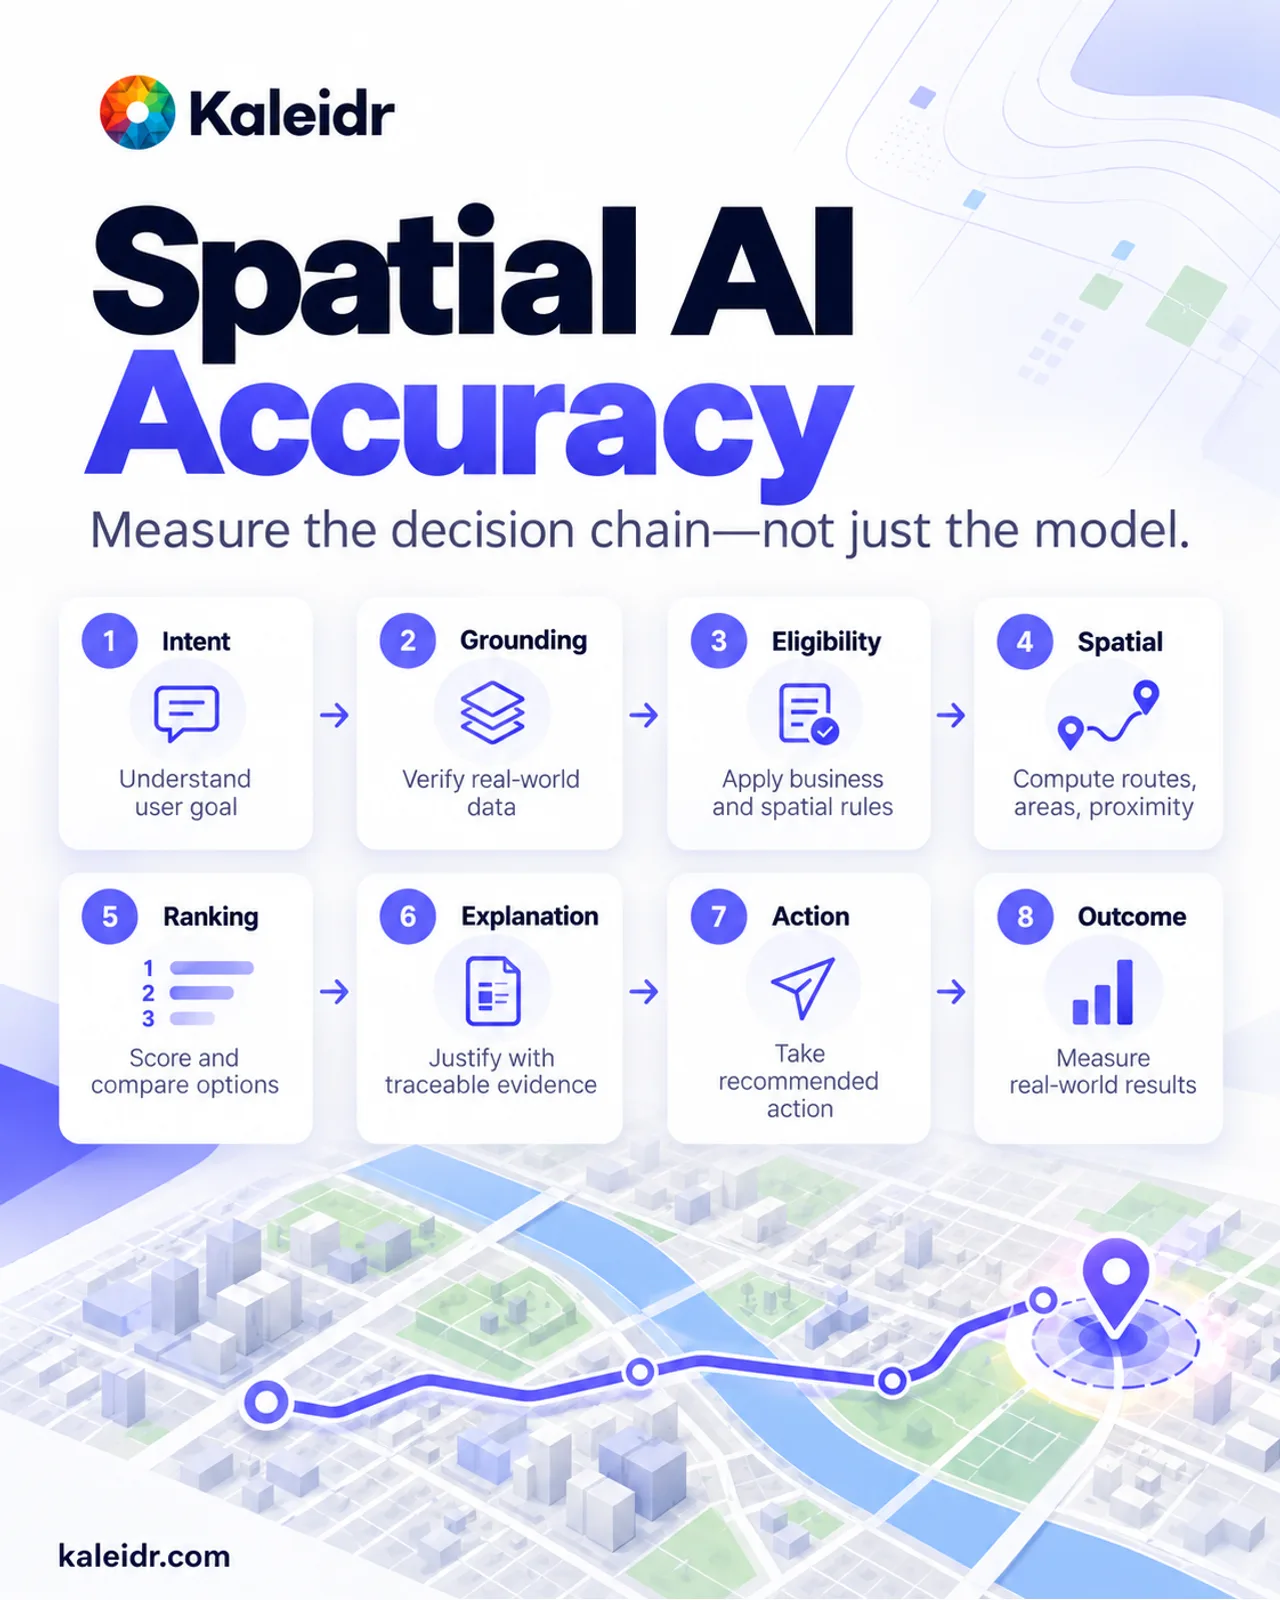
قِس سلسلة القرار، لا النموذج وحده. المراحل الثماني هي مخطط التقييم وليست درجة منشورة.
كيف يصبح التقييم بوابة إصدار؟
ابنِ مجموعة الاختبار قبل التوسع. أدرج حالات الفشل. أبقِ الحقيقة الحتمية خارج نموذج اللغة عندما تستطيع أداة أو سجل الإجابة. تابع الأبعاد الحرجة في بواباتها المستقلة. أعد التشغيل عندما يتغير النظام، واربط نتيجة offline بنتيجة الإنتاج التي يفترض أن تحسنها المهمة. السؤال المفيد هو ما إذا كان هذا النظام يستطيع اتخاذ القرار المعتمد على الموقع الذي يعد به المنتج، باستخدام البيانات والجغرافيا والصلاحيات والإجراءات الصحيحة، وما إذا كان الفريق يستطيع إثبات ذلك.
استكشف Kaleidr Enterprise لإضافة AI واعٍ بالموقع إلى جانب الأنظمة التي يستخدمها المنتج بالفعل ولتعريف pilot مركز. استكشف Kaleidr Analytics لمعرفة كيفية استخدام الجمهور للخرائط والأماكن في ذلك الـ pilot. يظل المضيف مسؤولًا عن نتيجة العمل وقرار التوسع.
الأسئلة الشائعة
كيف تُقاس دقة Spatial AI؟
قِس مراحل قرار الموقع: النية، وحل المكان، والتفويض، والأهلية، والحسابات الجغرافية، والحداثة، والترتيب، والشرح، والإجراء، ونتيجة المستخدم أو العمل. لا تختزل هذه السلسلة في درجة واحدة للنموذج.
هل هذا هو نفسه دقة نموذج اللغة؟
لا. نموذج اللغة مجرد مكوّن واحد. قواعد بيانات الأماكن، وسجلات الأعمال، والمحركات المكانية، والتوجيه، والترتيب، والصلاحيات، وحالة التطبيق يمكن كلها أن تغير ما إذا كانت النتيجة صحيحة.
هل ينبغي لنموذج اللغة حساب المسافة؟
استخدم أداة جغرافية أو أداة توجيه عندما يحتاج المنتج إلى مسافة أو علاقة سفر. يمكن للنموذج تحديد متى يكون الحساب مطلوبًا وشرح النتيجة. الخدمة المكانية هي التي تنفذ الحساب.
هل ينبغي أن تتضمن benchmarks أسئلة مستحيلة؟
نعم. المهام المصممة عمدًا لتكون غير قابلة للحل تكشف ما إذا كان النظام يعيد إجابة grounded من نوع «لا توجد نتيجة» بدلًا من اختراع مكان أو إسقاط قيد بصمت.
كم مرة ينبغي تشغيل التقييم؟
شغّله قبل الإنتاج، ثم أعده عندما تتغير النماذج أو prompts أو مزودو البيانات أو الترتيب أو الأدوات المكانية أو الصلاحيات أو التغطية. راقب سلوك الإنتاج باستمرار. تقرير يوم الإطلاق ليس عملية release.
هل يمكن لـ benchmark واحد مقارنة كل الأنظمة؟
يمكن لـ benchmarks البحثية مقارنة قدرة محددة. أما تقييم الإنتاج فيجب أن يعكس المهمة الجغرافية والبيانات والمخاطر والأدوات ونتيجة التطبيق نفسه. benchmarks GeoAI وbenchmarks المنتج ليست قابلة للاستبدال.
المراجع
- National Institute of Standards and Technology. AI RMF Playbook, Measure. Notes that the AI RMF 1.0 is being updated and that the playbook will be revised afterward. Accessed September 29, 2026. https://airc.nist.gov/airmf-resources/playbook/measure/
- National Institute of Standards and Technology. The TEVV-Athlon Framework for Evaluating AI Systems. NIST AI 200-2, initial public draft. Announced August 7, 2026; comments through October 6, 2026. https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems
- Krechetova, Varvara, and Denis Kochedykov. GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks. arXiv:2503.18129, submitted March 23, 2025, revised October 22, 2025. https://arxiv.org/abs/2503.18129
- Pothuri, Abhinav, Zhe Jiang, Zelin Xu, and Di Yang. GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks. arXiv:2608.01645, submitted August 3, 2026. https://arxiv.org/abs/2608.01645
- Rodrigues, Rodrigo Ferreira, Karim Radouane, Jose G. Moreno, and Lynda Tamine. GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks. arXiv:2608.07411, submitted August 7, 2026. Accepted at CIKM 2026. https://arxiv.org/abs/2608.07411
- OWASP Gen AI Security Project. LLM01:2025 Prompt Injection. Accessed September 29, 2026. https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed September 29, 2026. https://kaleidr.com/enterprise
- Kaleidr. Map Engagement and Location Analytics. Accessed September 29, 2026. https://kaleidr.com/analytics
- Kaleidr. Grounded Spatial AI for Business Data. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- Kaleidr. An Enterprise Spatial AI Pilot Before Scaling. https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling
@misc{nist_rmf_playbook_measure_2026,
  title  = {AI RMF Playbook, Measure},
  author = {{National Institute of Standards and Technology}},
  year   = {2026},
  note   = {Accessed September 29, 2026. Page states the playbook will be updated after the AI RMF revision},
  url    = {https://airc.nist.gov/airmf-resources/playbook/measure/}
}

@techreport{nist_ai_200_2_2026,
  title       = {The TEVV-Athlon Framework for Evaluating AI Systems},
  author      = {{National Institute of Standards and Technology}},
  institution = {National Institute of Standards and Technology},
  number      = {NIST AI 200-2},
  year        = {2026},
  note        = {Initial public draft, announced August 7, 2026},
  url         = {https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems}
}

@misc{krechetova_geobenchx_2025,
  title  = {GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks},
  author = {Krechetova, Varvara and Kochedykov, Denis},
  year   = {2025},
  note   = {arXiv:2503.18129, revised October 22, 2025},
  url    = {https://arxiv.org/abs/2503.18129}
}

@misc{pothuri_gisagentbench_2026,
  title  = {GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks},
  author = {Pothuri, Abhinav and Jiang, Zhe and Xu, Zelin and Yang, Di},
  year   = {2026},
  note   = {arXiv:2608.01645, submitted August 3, 2026},
  url    = {https://arxiv.org/abs/2608.01645}
}

@misc{rodrigues_geobenchllm_2026,
  title  = {GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks},
  author = {Rodrigues, Rodrigo Ferreira and Radouane, Karim and Moreno, Jose G. and Tamine, Lynda},
  year   = {2026},
  note   = {arXiv:2608.07411, submitted August 7, 2026, accepted at CIKM 2026},
  url    = {https://arxiv.org/abs/2608.07411}
}

@misc{owasp_llm01_2025,
  title  = {LLM01:2025 Prompt Injection},
  author = {{OWASP Gen AI Security Project}},
  year   = {2025},
  note   = {Accessed September 29, 2026},
  url    = {https://genai.owasp.org/llmrisk/llm01-prompt-injection/}
}

@misc{kaleidr_enterprise_accuracy_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_analytics_accuracy_2026,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/analytics}
}