
A precisão de Spatial AI mede se um sistema sensível à localização interpreta a solicitação, identifica os lugares corretos, usa dados atuais e autorizados, calcula a geografia corretamente, classifica apenas opções elegíveis, explica as evidências e executa somente ações válidas. Uma resposta fluente ainda pode mandar alguém para a filial errada. Uma única pontuação do modelo não consegue demonstrar tudo isso. O benchmark precisa testar, antes da produção, o trabalho que o produto promete realizar.
As seções abaixo separam a cadeia de decisão, os gates que uma média pode esconder, os casos de falha que vale a pena preparar com antecedência e a diferença entre benchmarks de pesquisa e uma avaliação de produto. Leituras relacionadas incluem Spatial AI fundamentada em dados de negócio e Um piloto empresarial de Spatial AI. Uma recusa correta pode ser mais precisa do que uma recomendação plausível.
Princípios essenciais da precisão de Spatial AI
- Avalie a cadeia: intenção, grounding, elegibilidade, cálculo espacial, ranking, explicação, ação e resultado.
- Verifique os fatos fora do modelo: identidade do lugar, horários, estoque, permissões e rotas pertencem a sistemas autoritativos.
- Inclua os casos difíceis: solicitações ambíguas, desatualizadas, não autorizadas e intencionalmente insolúveis.
- Mantenha os gates separados: uma pontuação alta em uma camada de baixo risco não deve compensar uma falha de permissões.
- Vincule ao trabalho: casos offline e resultados de produção respondem a perguntas diferentes. Você precisa dos dois.
O que significa precisão de Spatial AI?
Um cliente pode perguntar qual loja perto da rota para casa ainda tem um item e estará aberta quando ele chegar. Essa frase contém vários problemas independentes: o que a pessoa quer, quais lojas existem, se o estoque está atualizado, se o horário combina com a chegada, quais filiais a rota realmente consegue alcançar, quais regras de negócio eliminam um candidato e como as opções restantes devem ser classificadas e explicadas. Uma frase final fluente não comprova cada etapa. A avaliação precisa separar as camadas, porque uma falha de resolução de lugar não é corrigida reescrevendo um prompt de ranking, e um feed de estoque desatualizado não é corrigido trocando o modelo de linguagem.
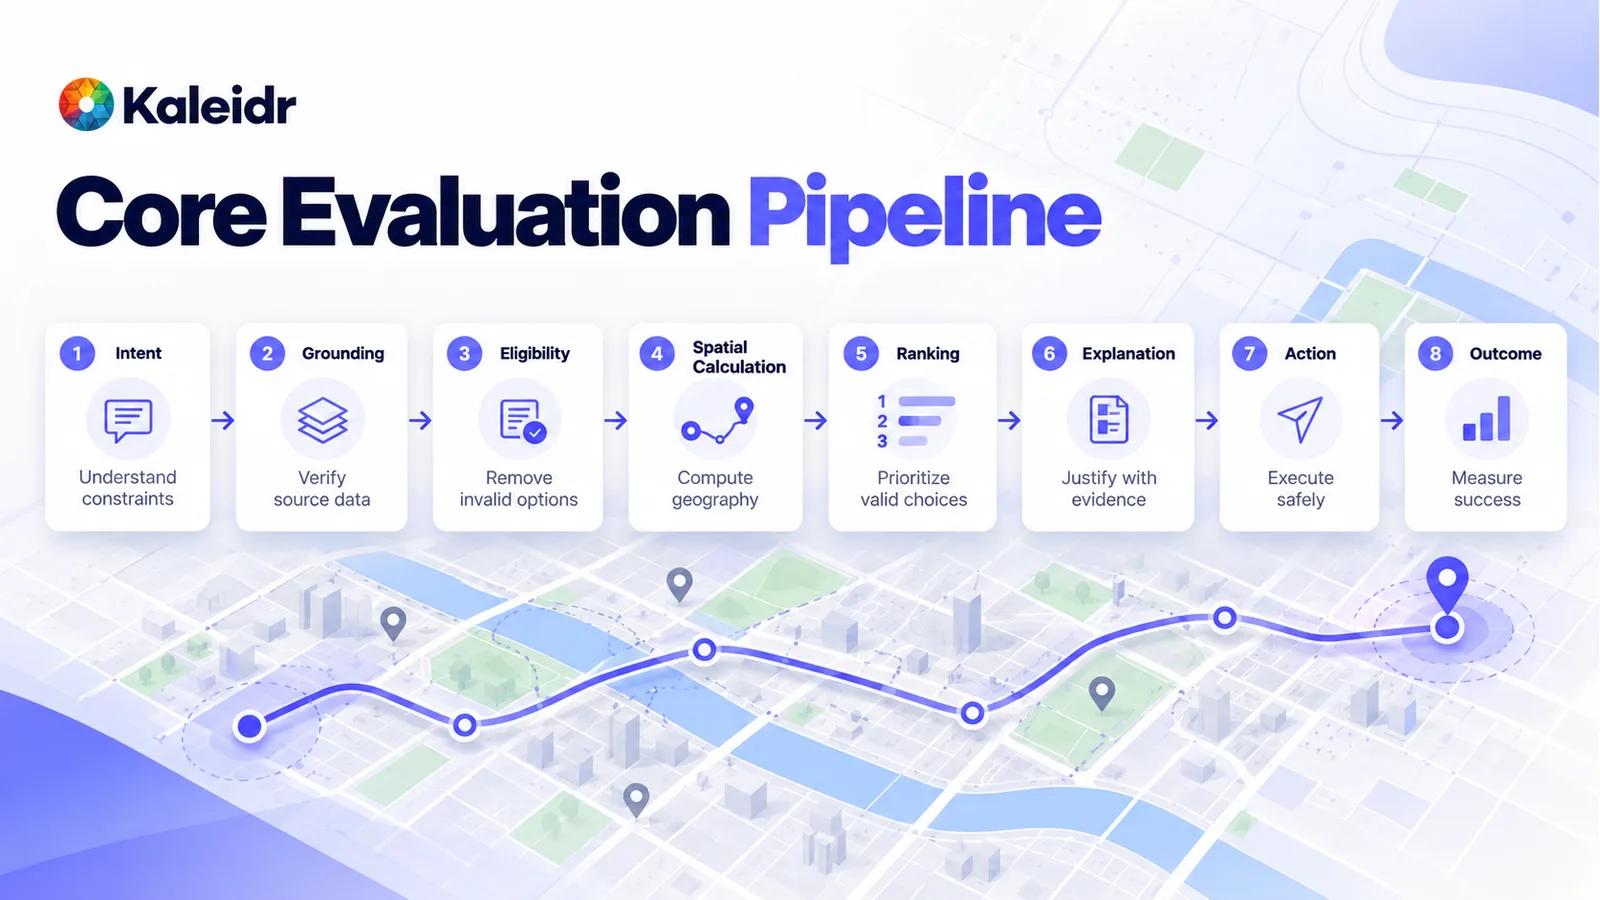
Teste a cadeia em ordem: entender as restrições, verificar a fonte, remover opções inválidas, calcular a geografia, classificar o que restou, justificar com evidências, agir apenas quando a ação for permitida e medir se o trabalho foi concluído.
Por que uma única pontuação não é suficiente?
Uma porcentagem geral é fácil de comparar e também fácil de usar mal. Uma scorecard ilustrativa pode mostrar 92% no geral, enquanto intenção está em 99%, roteamento em 98%, explicação em 96% e autorização em 75%. Esses números são um exemplo, não um resultado da Kaleidr. A média ainda pode parecer forte enquanto o sistema expõe ou age sobre dados que a pessoa não deveria acessar. Dimensões críticas precisam de seus próprios gates de produção. Excelente desempenho em uma tarefa de baixo risco não deve compensar uma falha de permissões, um destino inválido, uma ação sem suporte ou uma disponibilidade inventada.
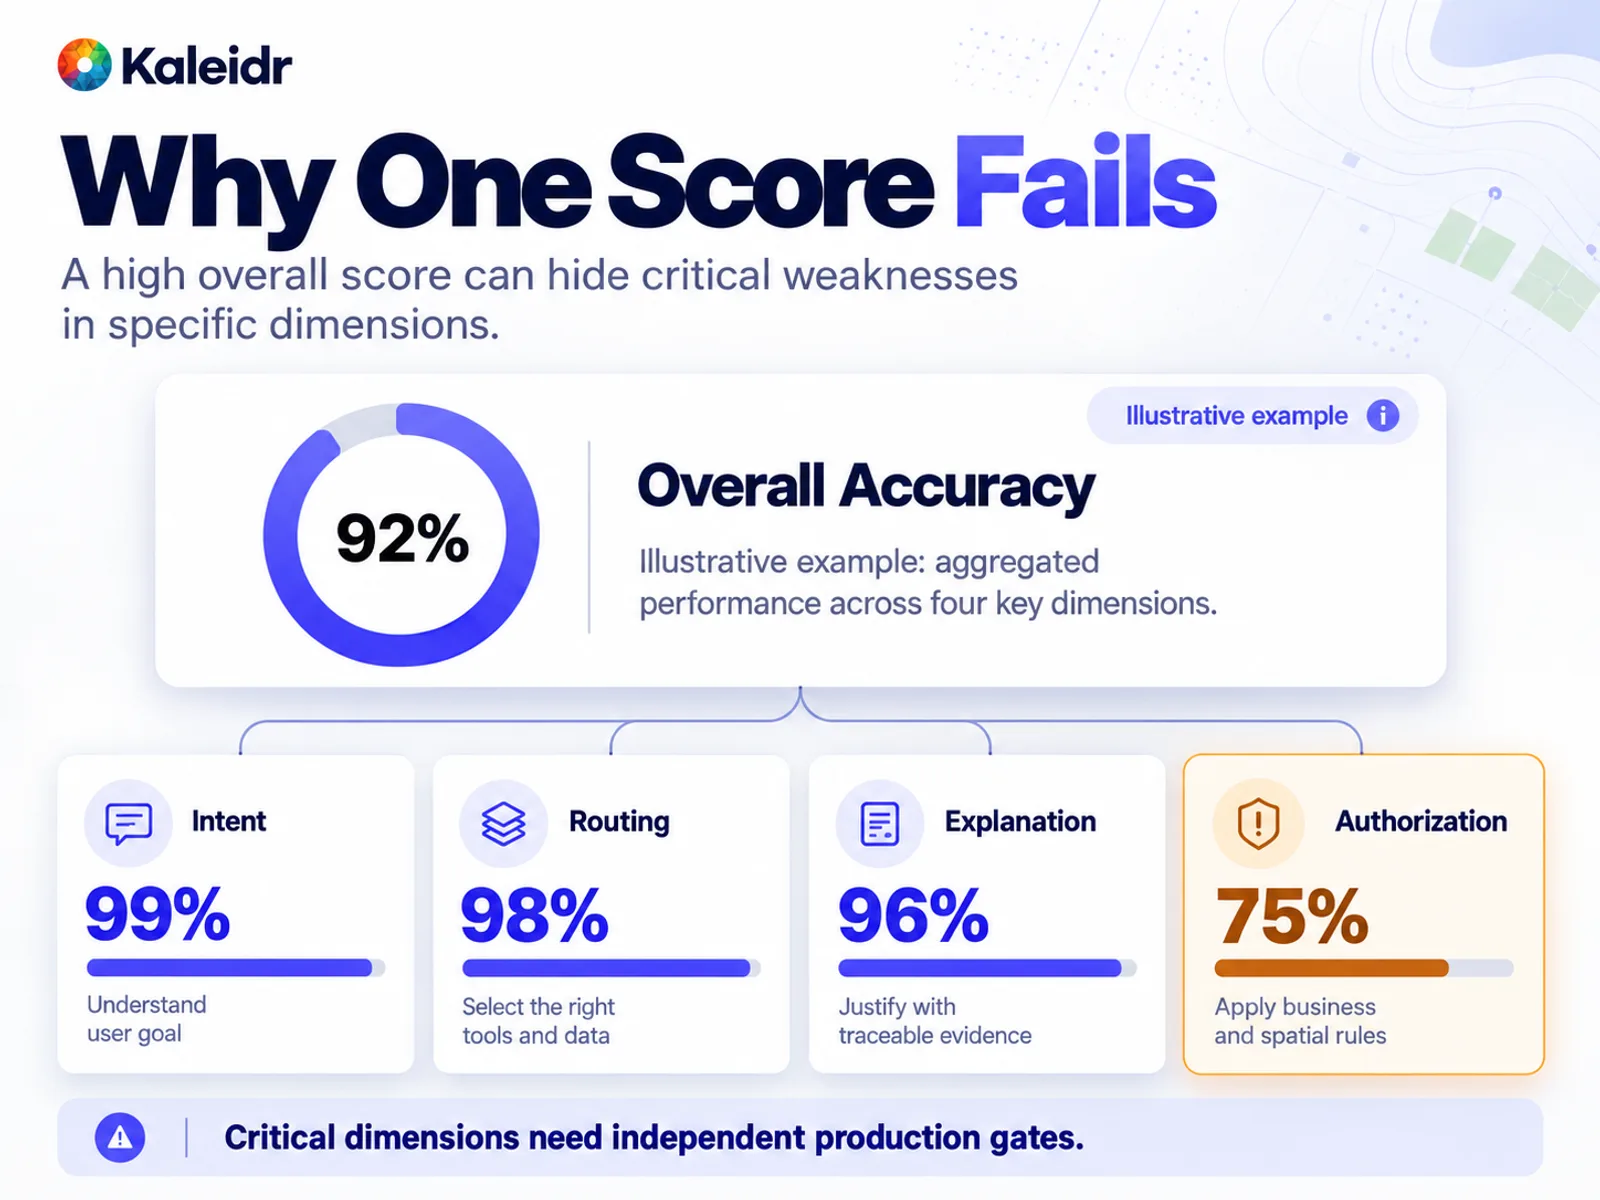
Uma pontuação geral alta pode esconder um gate fraco. As porcentagens desta figura são um exemplo ilustrativo, não desempenho medido da Kaleidr.
O playbook do AI Risk Management Framework do NIST diz que a medição deve começar pelos riscos mais significativos e que os riscos que não serão medidos devem ser documentados. A mesma página observa que o AI RMF 1.0 está sendo atualizado e que o playbook será revisado depois (NIST, 2026). O rascunho público inicial do framework TEVV-Athlon do NIST, NIST AI 200-2, anunciado em 7 de agosto de 2026 com comentários abertos até 6 de outubro de 2026, descreve avaliação como evidência de que um sistema atende a objetivos individuais ou organizacionais, usando medições personalizadas para essas necessidades, incluindo impacto no mundo real (NIST, 2026). O documento é um rascunho em busca de contribuições. Ele não é uma lista de controles da Kaleidr. Para um produto sensível à localização, o contexto é a decisão geográfica que o produto realmente toma.
Como intenção, lugar e elegibilidade devem ser testados?
A intenção vem primeiro. Uma solicitação por uma cafeteria acessível para cadeira de rodas entre um hotel e um local de evento, aberta antes das 7h, não significa “cafeterias perto do hotel”. Armazene a interpretação estruturada esperada para cada consulta de teste: categoria, relação geográfica, origem, destino, acessibilidade e horário. Depois meça a extração de restrições, as restrições inventadas pelo sistema e as restrições que ele deixou de considerar. Um sistema que acerta a categoria, mas ignora a janela de horário, não interpretou a tarefa corretamente.
A linguagem de lugares é ambígua. Springfield, Terminal 2, Main Street e “nossa loja de Austin” podem nomear mais de uma entidade. Inclua cidades duplicadas, nomes de filiais idênticos, vários terminais, lugares renomeados, abreviações, nomes multilíngues, bairros sem limite rígido e endereços em uma fronteira administrativa. Avalie identificadores canônicos de lugar, não correspondência de texto no nome. A cafeteria errada a um quarteirão e um destino na cidade errada estão ambos incorretos, mas não têm a mesma gravidade.
Elegibilidade pergunta se um lugar pode ser considerado. Ranking pergunta quão alto um lugar válido deve aparecer. Uma filial pode ser o pin mais próximo e ainda estar fechada, sem estoque, fora da área de serviço, totalmente reservada ou proibida por política. Esses candidatos devem sair do conjunto antes que o restante seja classificado. A precisão de elegibilidade é o número de lugares elegíveis retornados dividido pelo total de lugares retornados. Em um fluxo de alto risco, algumas recomendações inelegíveis podem importar mais do que a qualidade média do ranking. Estoque, horários, permissões e políticas permanecem nos sistemas que os controlam. Spatial AI fundamentada em dados de negócio traça a mesma linha para o próprio produto.
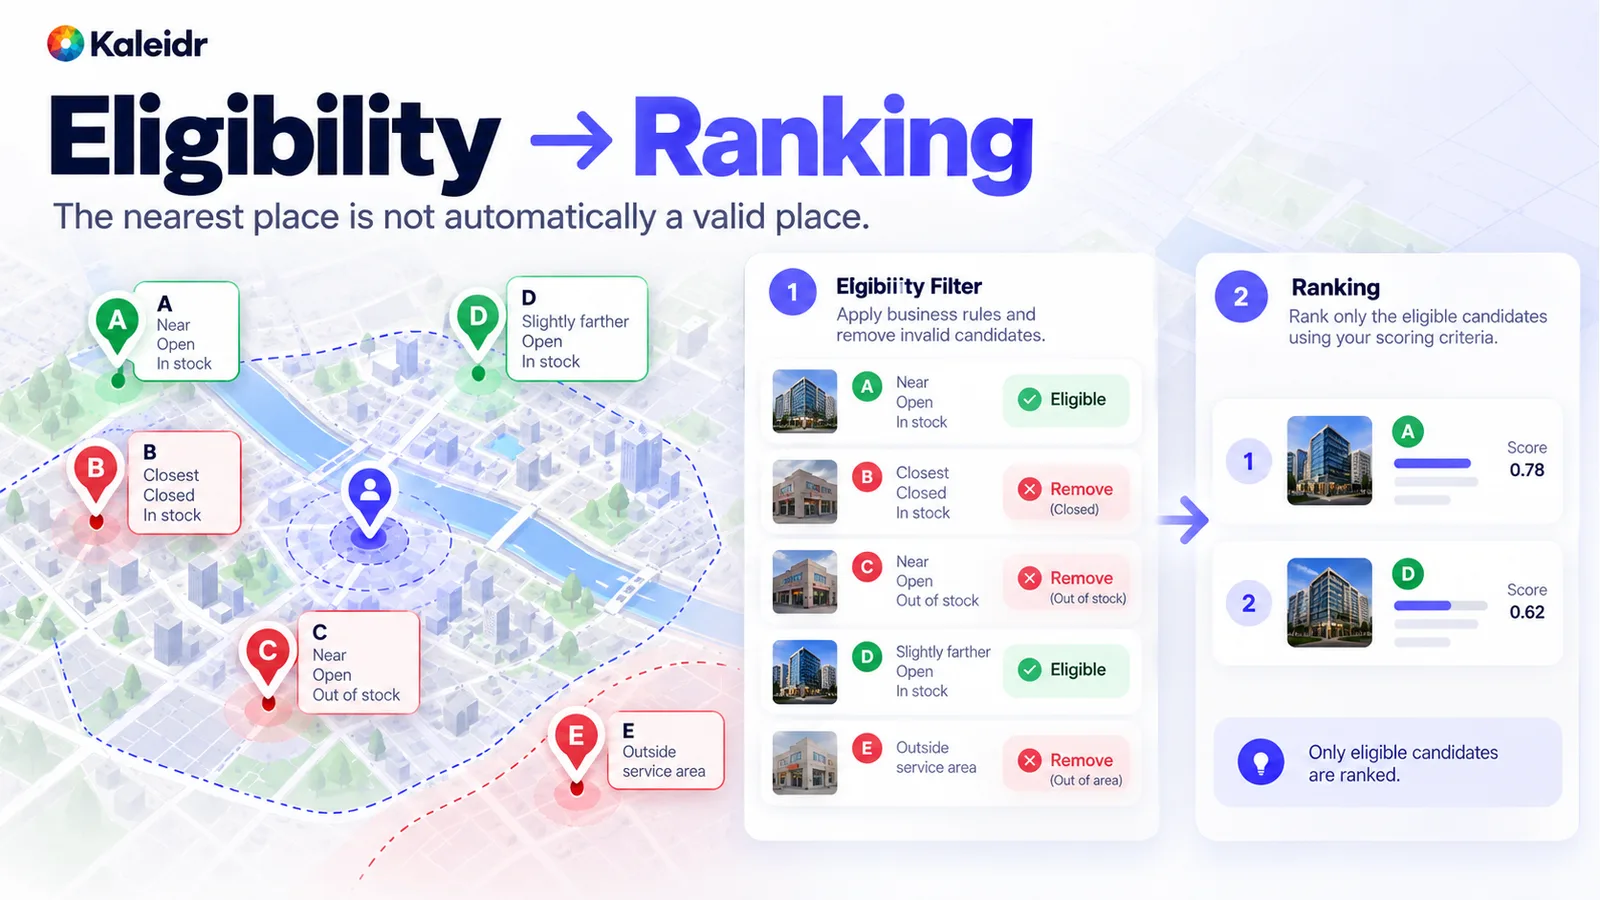
Filtre a elegibilidade primeiro. O lugar mais próximo não é automaticamente um lugar válido.
Como geografia e atualidade devem ser verificadas?
Um modelo de linguagem não deve ser a fonte de verdade para um cálculo que um mecanismo espacial pode realizar. Ponto em polígono, distância de rota, tempo de viagem, pertencimento a área de serviço, contenção e ordem ao longo de uma rota pertencem a esse conjunto. Construa a resposta esperada com dados geográficos autoritativos e uma ferramenta confiável e depois compare o resultado do aplicativo com essa resposta. Correspondência exata funciona para “este ponto está dentro deste polígono?” e “o sistema retornou a filial ID 172?”. Uma tolerância declarada previamente funciona para coordenadas, tempo estimado de viagem e limites desenhados em diferentes resoluções. Não decida depois da execução que um resultado incorreto estava perto o suficiente.
Atualidade é uma questão separada da correção histórica. Coordenadas e identidade da filial podem ser estáveis enquanto horários, estoque, trânsito e fechamentos mudam. Acompanhe a proporção de decisões tomadas com dados fora do limite de atualidade e a proporção de campos sensíveis ao tempo que têm um horário de atualização conhecido. Dado ausente não é o mesmo fato que “indisponível”. Um “sim” ou “não” confiante baseado em estado desconhecido é uma falha, mesmo quando o lugar realmente existe.
Quando “nenhum resultado” é a resposta correta?
Um cliente pode pedir um local a até dez minutos que tenha um item depois das 21h quando nenhum existe. Um sistema fraco relaxa a restrição silenciosamente e devolve uma filial a vinte minutos. Um sistema grounded informa que nenhuma opção verificada atende a todas as condições. Benchmarks devem incluir tarefas intencionalmente insolúveis e então acompanhar tanto a taxa correta de “nenhum resultado” quanto a taxa de recomendações falsas. GeoBenchX, benchmark de 2025 para agentes com chamada de ferramentas em tarefas geoespaciais de múltiplas etapas, inclui tarefas solucionáveis e intencionalmente insolúveis para medir a precisão de rejeição (Krechetova and Kochedykov, 2025). Esse trabalho avalia agentes de pesquisa. GeoBenchX não pontua a Kaleidr, e uma equipe de produto ainda deve escrever casos insolúveis para o próprio trabalho.
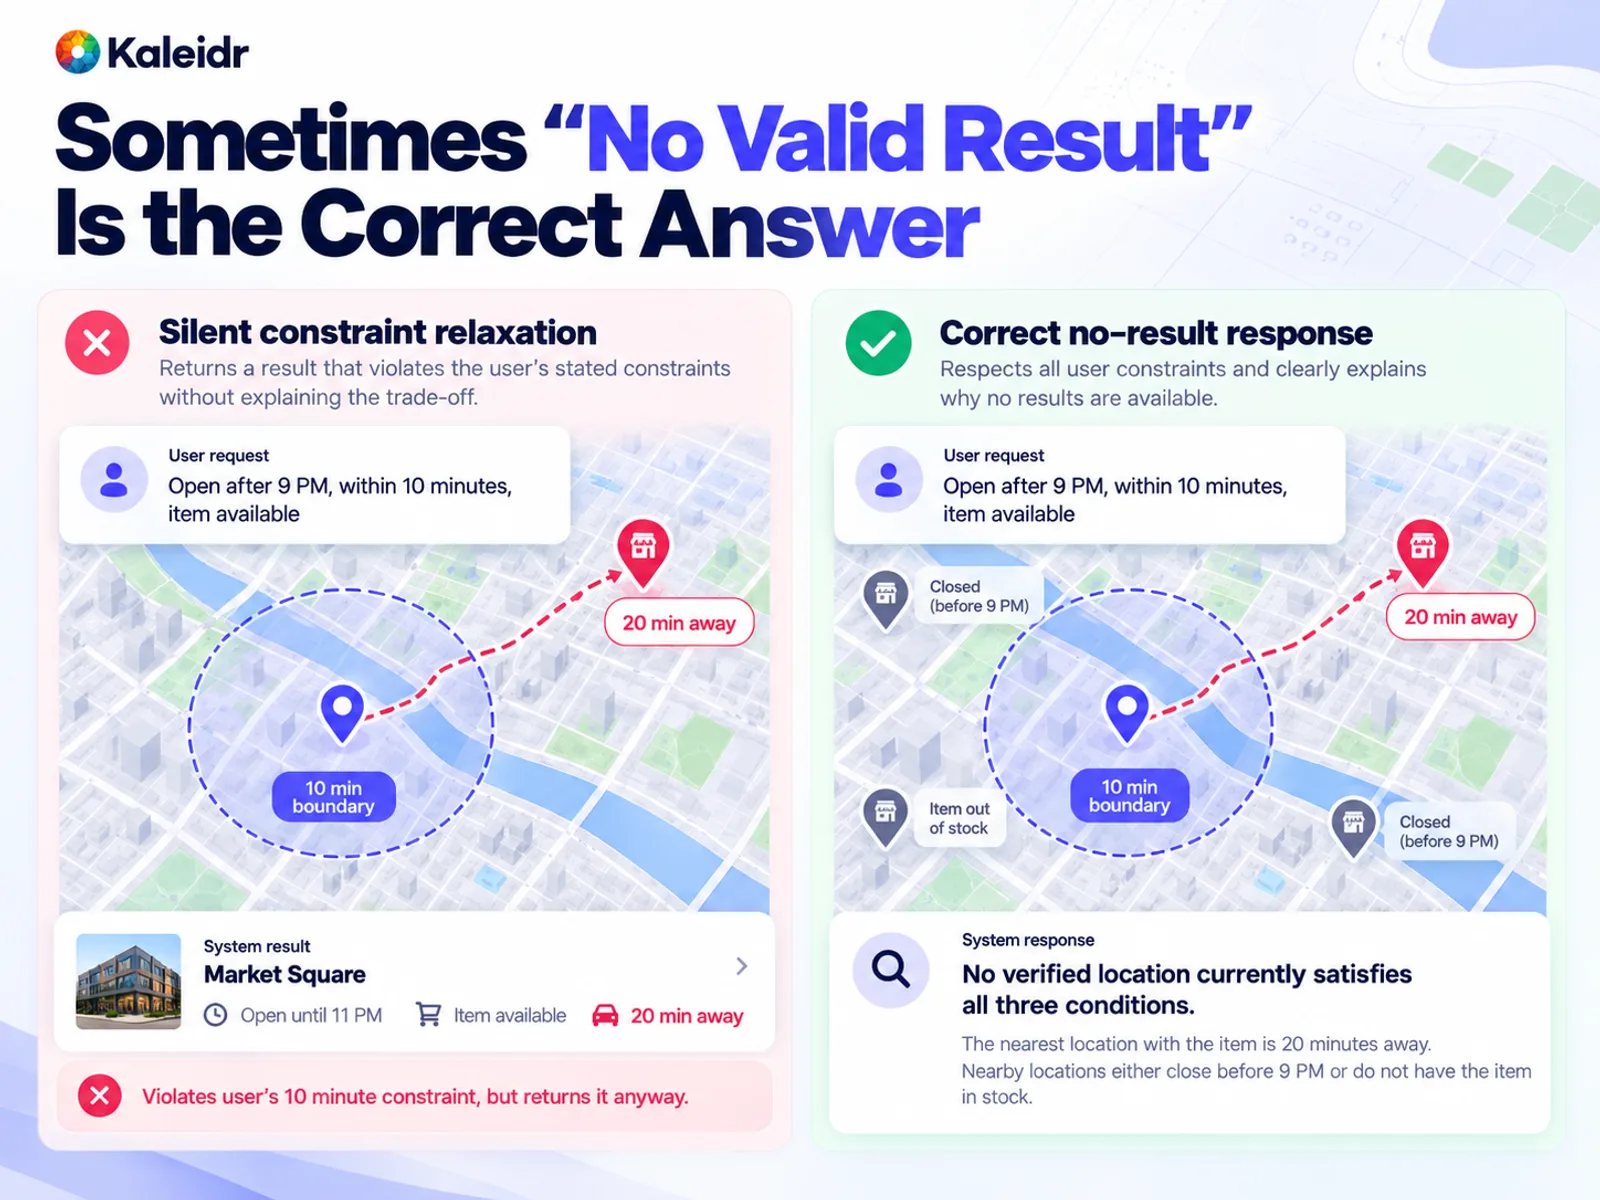
Às vezes, nenhum resultado válido é a resposta correta. Retornar um lugar fora do horário ou da distância declarada é uma recomendação falsa, não um fallback útil.
Como ranking, explicação e ações devem ser pontuados?
Classifique apenas depois que os candidatos inválidos forem removidos. O mais próximo não é automaticamente o melhor. Tempo de viagem, desvio de rota, disponibilidade, acessibilidade, preço, janela de abertura e prioridade de negócio podem fazer parte do objetivo, se o produto disser isso. Medidas úteis incluem a frequência com que o primeiro resultado é aceitável, a frequência com que uma opção aceitável aparece entre os primeiros K resultados, concordância com uma ordem revisada por humanos ou definida por política e regret em relação à melhor opção elegível conhecida. Não trate engajamento como qualidade de ranking. Conecte a ordem à ação que o cliente precisava realizar.
Uma explicação como “aberto até 22h, item disponível, seis minutos adicionados à rota” só é precisa se cada afirmação puder ser rastreada até evidências realmente usadas pelo sistema. Verifique a identidade do lugar, a afirmação de disponibilidade, os horários, se uma rota foi realmente calculada e se o texto corresponde à decisão de ranking. Um parágrafo bem escrito ainda pode estar errado. Um texto curto e pouco elegante pode estar certo. Meça as afirmações verificadas em relação às afirmações factuais da explicação.
As ações fazem parte da resposta. Mover o mapa, adicionar um marcador, solicitar uma rota, alterar um filtro ou iniciar uma reserva pode estar errado mesmo quando a frase está certa. Acompanhe se a ação faz parte do vocabulário do aplicativo, se o alvo e os parâmetros estão corretos e se a pessoa tinha permissão para executá-la. Uma frase correta acompanhada da ação de mapa errada ainda é uma interação com falha.
Quais casos de falha devem fazer parte do benchmark?
Um conjunto formado apenas por exemplos limpos que a equipe já sabe resolver superestimará a confiabilidade. Inclua nomes ambíguos, filiais duplicadas, endereços na borda de uma área de serviço, solicitações insolúveis, uma loja que acabou de fechar, estoque que não corresponde ao lugar, um pin próximo que aumenta demais o desvio da rota, horário de fechamento antes da chegada, uma instalação privada que o usuário não pode ver, um nome local diferente do nome em inglês, horários desconhecidos, uma fonte pública que entra em conflito com dados first-party, texto recuperado que tenta direcionar o modelo e um serviço de roteamento ou dados de negócio fora do ar. O objetivo é reproduzir as decisões que a produção realmente enfrentará.
Texto recuperado que tenta direcionar o modelo é um caso de prompt injection. A OWASP descreve LLM01:2025 Prompt Injection como entrada do usuário ou recuperada que muda o comportamento do modelo de maneiras não intencionais, incluindo influência sobre uma decisão crítica, e observa que retrieval-augmented generation não remove completamente essa fragilidade (OWASP, 2025). Coloque esse caso na família de segurança do conjunto de testes, ao lado de permissões, em vez de tratar segurança como um apêndice posterior.
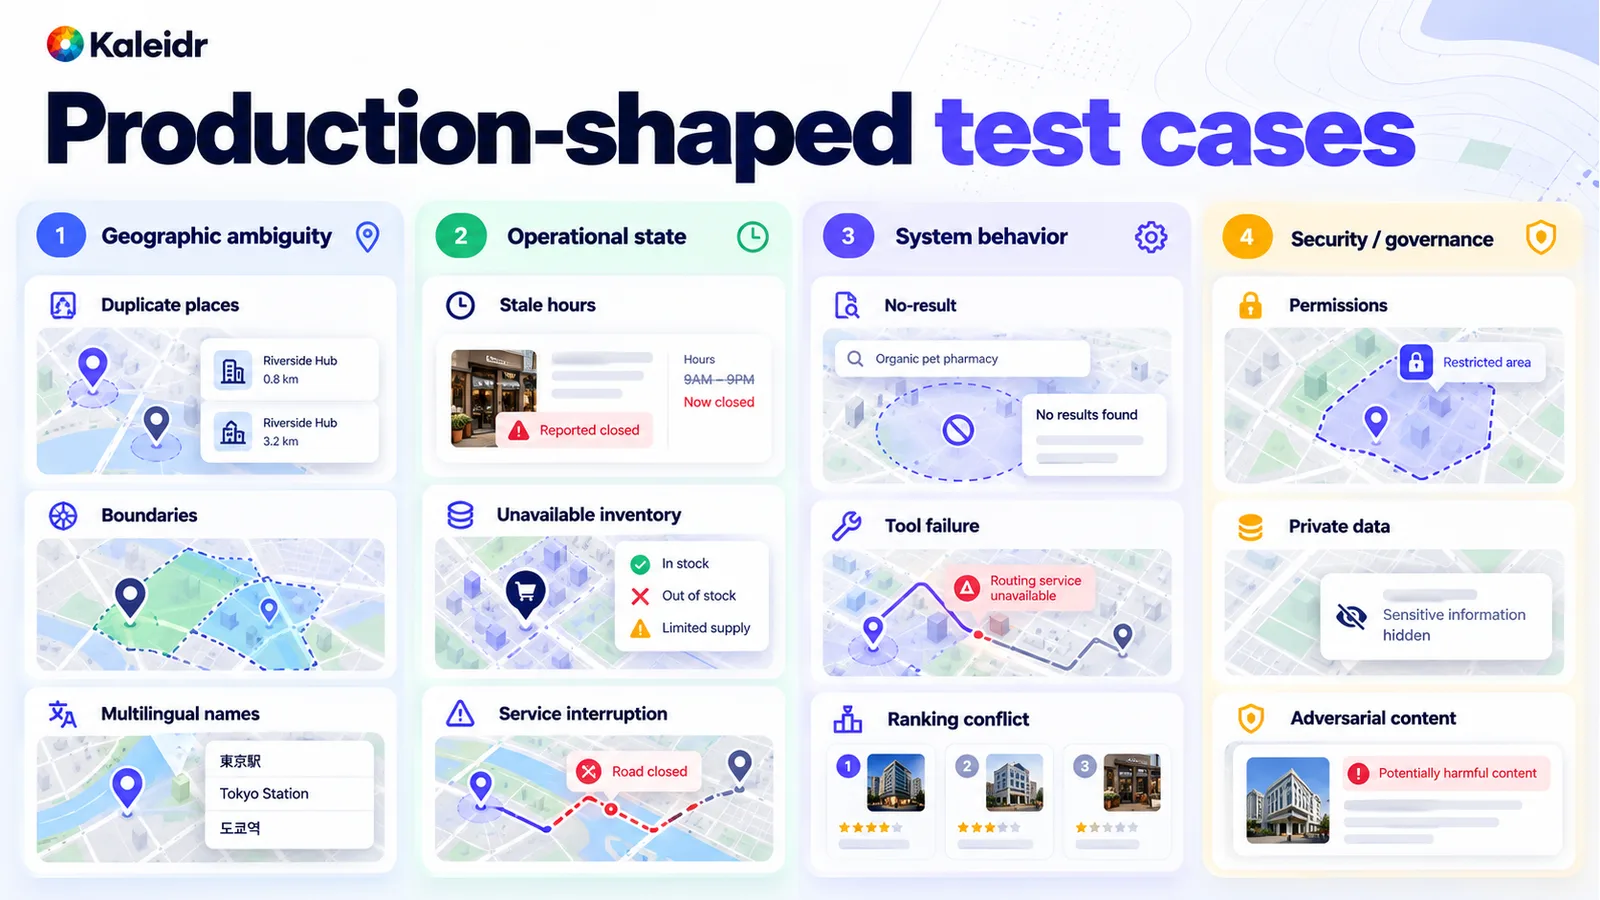
Casos com formato de produção cobrem ambiguidade geográfica, estado operacional, comportamento do sistema e segurança. Um benchmark que os omite superestimará a confiabilidade.
Por que a verdade de referência deve existir antes da execução?
Cada caso precisa de verdade suficiente registrada para definir o que significa “correto”: a consulta, o contexto do usuário, as fontes autorizadas, a intenção esperada, as restrições obrigatórias, os lugares canônicos, o conjunto elegível, a relação espacial esperada, o melhor resultado, alternativas aceitáveis, a ação esperada, a razão pela qual “nenhum resultado” é correto, a tolerância e a severidade se o sistema errar. Escreva esse registro antes de o sistema rodar. Adaptar o gabarito ao que o modelo produziu não é uma avaliação.
GISAgentBench, benchmark de 2026 construído a partir de profissionais com 349 tarefas GIS de múltiplas etapas, argumenta que muitos benchmarks de agentes GIS não têm saídas de ground truth e usam sinais substitutos como similaridade de código, correspondência de trajetória ou um modelo juiz, que podem tratar um workflow semelhante como resultado correto. Cada tarefa do GISAgentBench inclui um arquivo exato de saída de ground truth (Pothuri et al., 2026). Use código ou um registro autoritativo sempre que a pergunta for determinística: coordenadas, contenção, ID canônico, aberto ou fechado, permissão e qual ação de API foi chamada. Reserve revisão humana, ou revisão assistida por modelo calibrado, para perguntas realmente subjetivas, como se uma explicação é compreensível. O avaliador deve corresponder ao tipo de verdade que está sendo testada.
Como as equipes devem interpretar um resultado segmentado?
Uma média pode esconder uma geografia fraca. Divida os resultados por país, mercado, idioma, cobertura urbana e rural, provedor de dados, categoria de lugar, densidade de filiais, complexidade da consulta e tipo de rota. Suponha que a taxa geral de resultados válidos seja 95% e um mercado recém-lançado esteja em 78%. Esse par é uma ilustração hipotética, não uma medição da Kaleidr. A média pode ser aritmeticamente verdadeira e ainda ser o número errado para decidir escalar. Inspecione onde os erros ocorrem e depois atribua cada caso com falha a uma categoria: interpretação, resolução de entidade, grounding, elegibilidade, cálculo espacial, atualidade, ranking, explicação, ação, segurança ou recuperação. A categoria mostra à equipe o que precisa mudar. Uma falha de roteamento não é um problema de explicação.
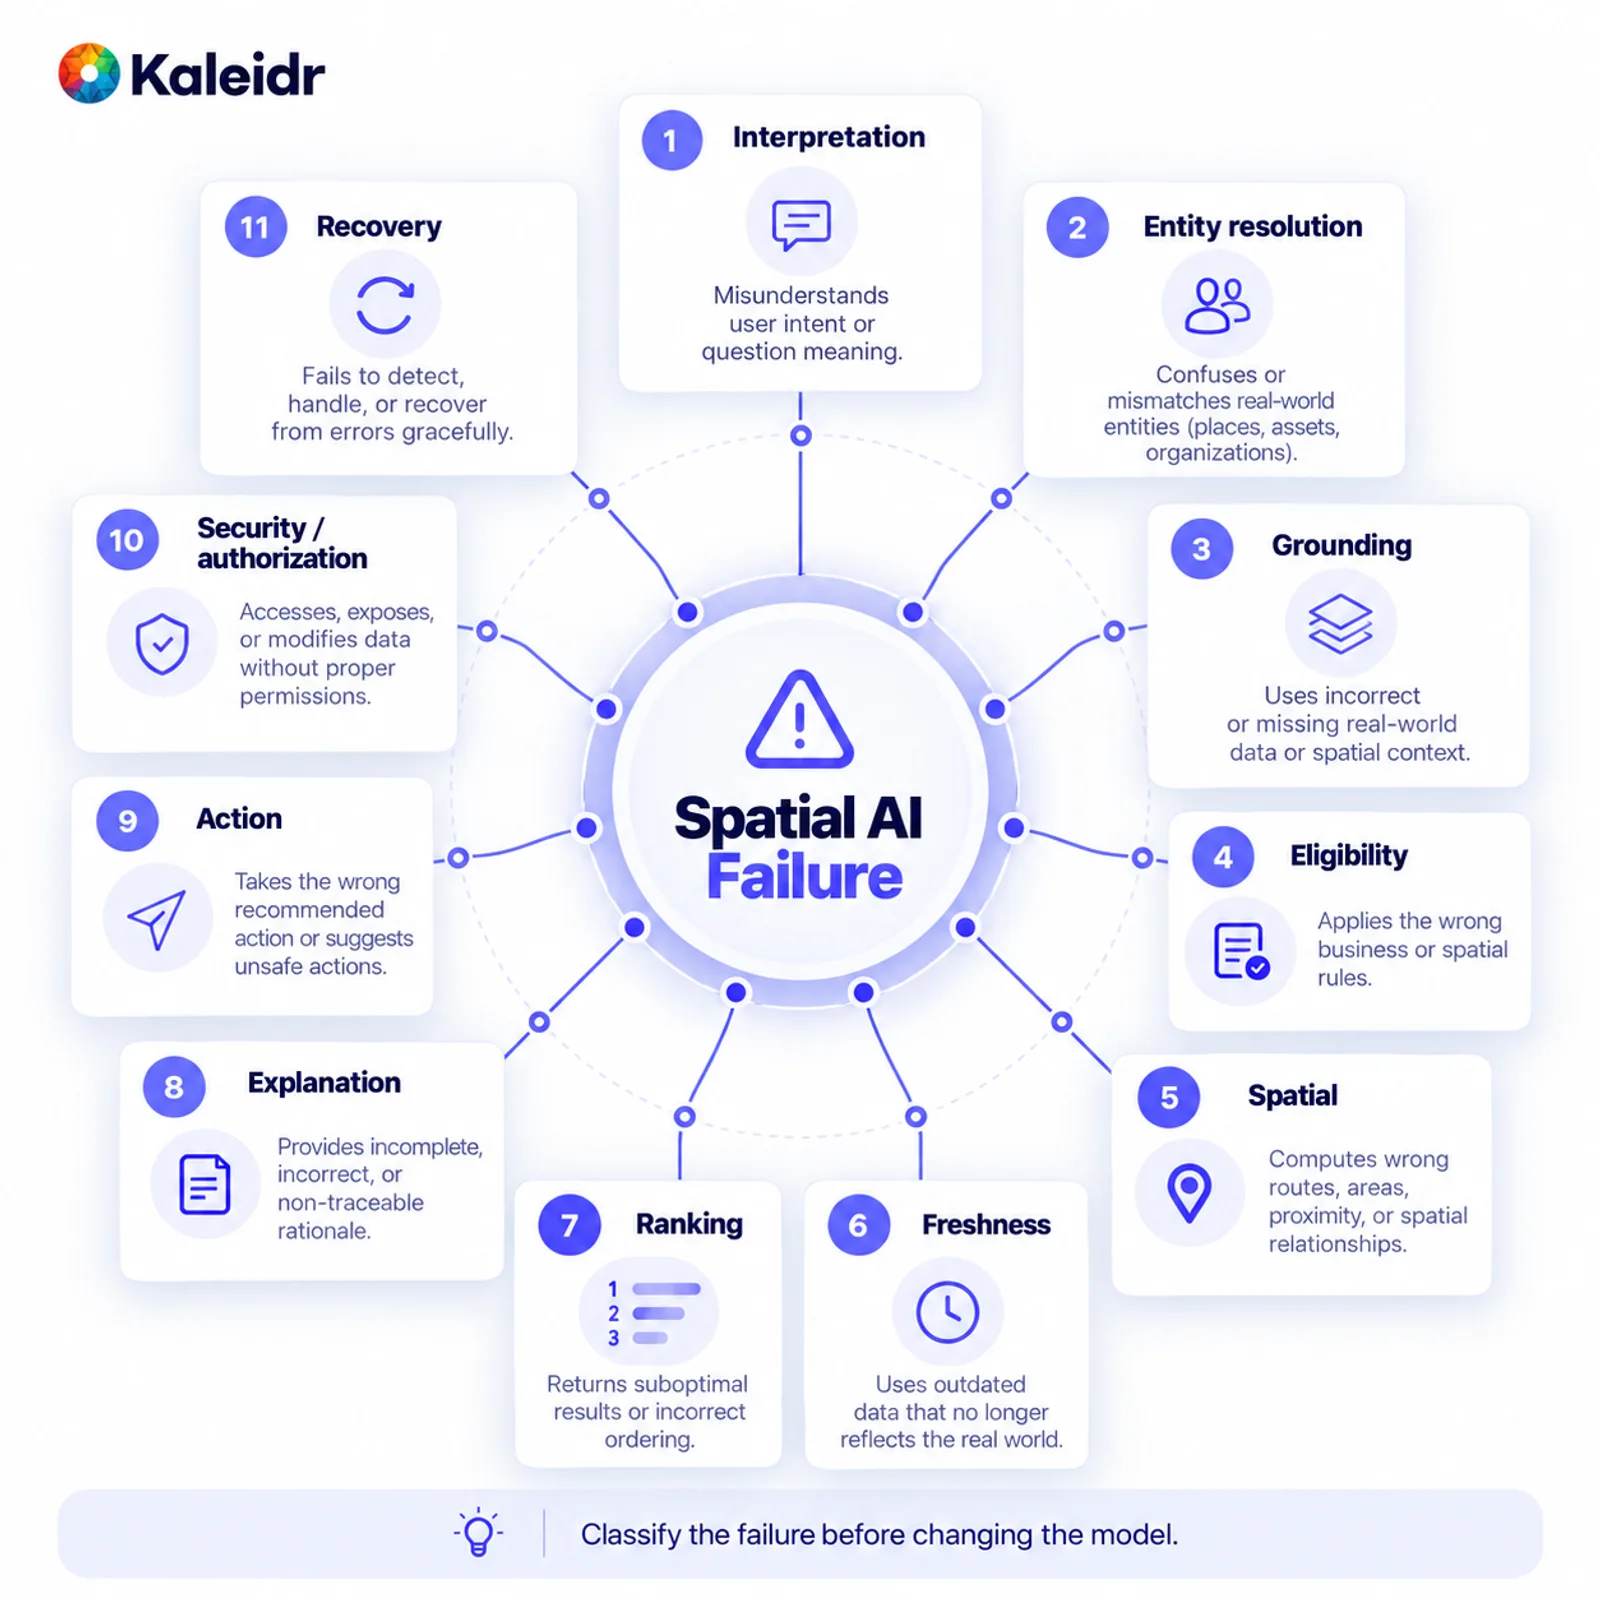
Classifique a falha antes de mudar o modelo. Categorias separadas impedem que uma falha rara e grave desapareça dentro de uma grande média.
Execuções generativas também variam. Para casos importantes, registre a média, a pior execução observada e com que frequência a falha se repete. Uma consulta segura nove vezes e errada uma vez tem risco diferente de uma consulta que retorna a mesma resposta segura todas as vezes. Repita o conjunto quando prompts, modelos, recuperação, ranking, provedores de dados, ferramentas ou cobertura mudarem. Avaliação pertence ao gerenciamento de releases, não a um único relatório pré-lançamento.
O que deve entrar em uma scorecard de produção?
Dê a cada dimensão sua própria métrica e seu próprio gate. Intenção pode usar extração de restrições. Identidade do lugar pode usar precisão de lugar canônico. Autorização e segurança podem usar uma taxa de acesso não autorizado na qual dados protegidos não toleram exposição. Elegibilidade, cálculo espacial, atualidade, ranking, tratamento de “nenhum resultado”, explicação, ações e resultado precisam, cada um, de um limite que o responsável pelo produto define antes da execução. Não copie um cutoff universal de outra aplicação. Uma sugestão casual de restaurante e uma decisão de roteamento com consequências de segurança não têm o mesmo orçamento de erro.
| Dimensão | Métrica de exemplo | Gate de exemplo |
|---|---|---|
| Intenção | Precisão da extração de restrições | Definir para este produto |
| Identidade do lugar | Precisão de lugar canônico | Muito alta |
| Autorização | Taxa de acesso não autorizado | Nenhum tolerado para dados protegidos |
| Elegibilidade | Precisão de resultados elegíveis | Muito alta |
| Cálculo espacial | Correto dentro de uma tolerância declarada previamente | Definir para este produto |
| Atualidade | Proporção de resultados dentro da janela de atualidade | Definir para este produto |
| Ranking | Aceitação Top-1 ou Top-K | Definir para este produto |
| Tratamento de “nenhum resultado” | Taxa de rejeição correta | Alta |
| Explicação | Taxa de afirmações com suporte | Alta |
| Ações | Taxa de ações válidas e corretamente parametrizadas | Muito alta |
| Resultado | Conclusão da tarefa dependente de localização | Deve melhorar o trabalho pretendido |
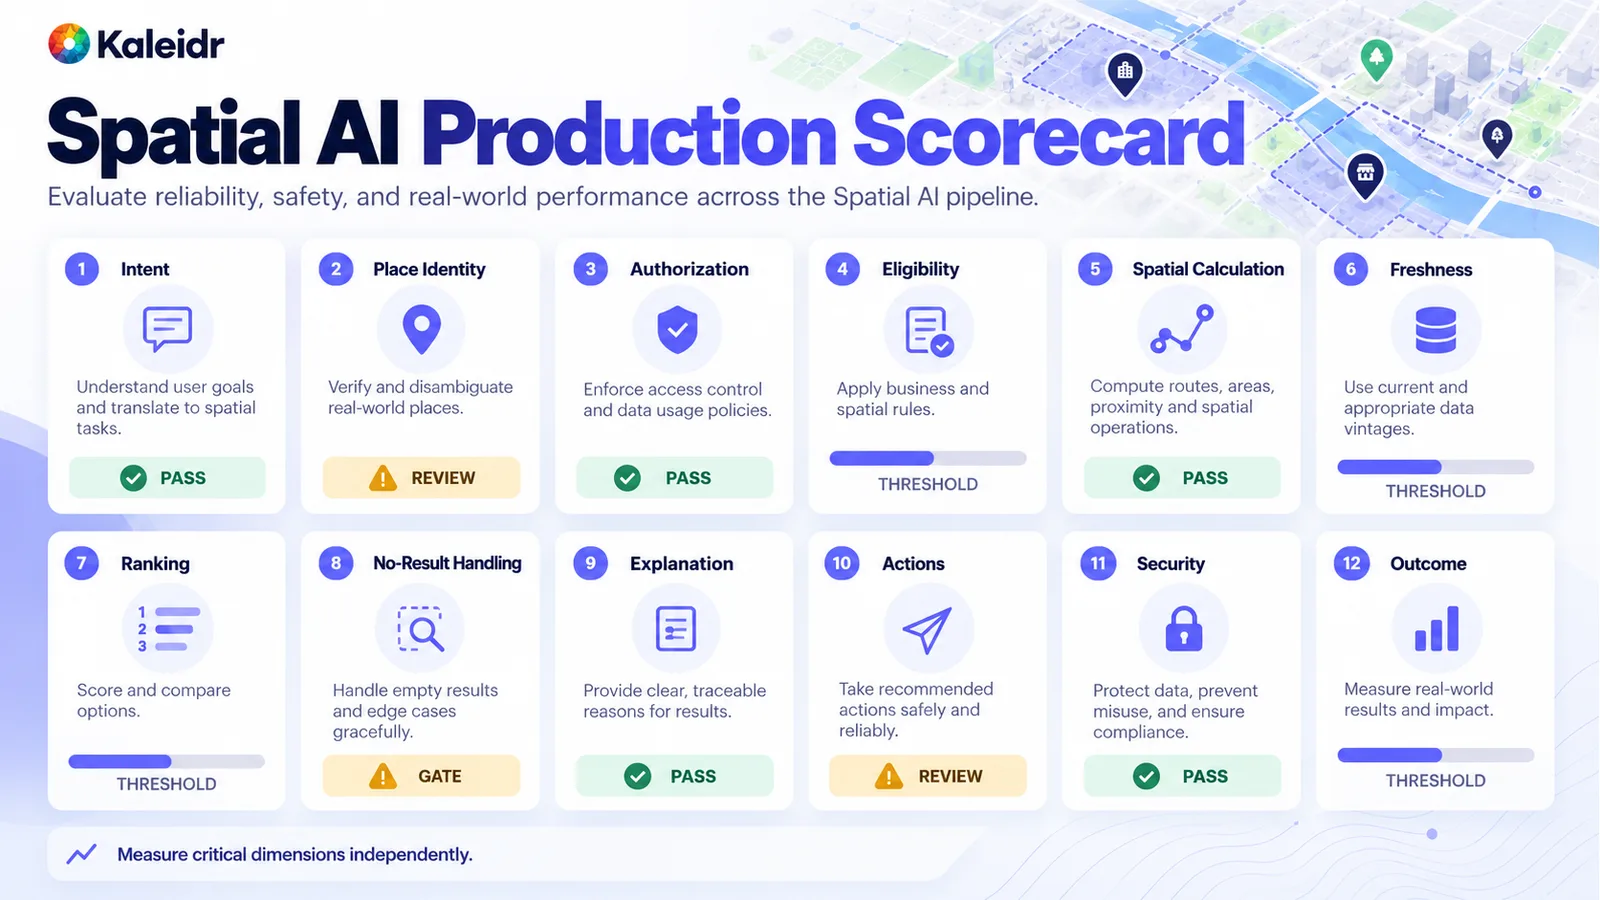
Meça dimensões críticas de forma independente. Os rótulos de status desta scorecard são placeholders, não pontuações de benchmark da Kaleidr.
Como uma equipe deve decidir se deve escalar?
Use os gates, não uma pontuação combinada. Escale quando resultados válidos, grounded e espacialmente corretos se mantiverem em condições próximas da produção, classes de erro críticas estiverem controladas, alguém for responsável pelos dados operacionais e o resultado pretendido melhorar. Itere quando o trabalho for valioso e uma camada corrigível ainda estiver fraca. Reduza o escopo quando o piloto misturar geografias, fontes ou trabalhos demais para dizer o que falhou. Pare quando a equipe não conseguir nomear dados autoritativos, não conseguir controlar uma falha crítica, não conseguir definir a tarefa ou não conseguir mostrar uma melhoria em relação ao fluxo atual. Um piloto empresarial de Spatial AI é o teste limitado. A scorecard transforma esse teste em uma decisão.
Onde a Kaleidr se encaixa na avaliação?
Kaleidr Enterprise descreve infraestrutura de location intelligence com APIs de inferência, sistemas de ranking, analytics e suporte de implantação, incluindo chat, edição, tiles e viewers incorporáveis que um host pode adicionar ao lado de um mapa que já opera (Kaleidr, 2026). O aplicativo host mantém os sistemas de negócio que controla: estoque, permissões, estado do cliente, reservas e outros registros operacionais privados. Ferramentas espaciais são responsáveis pelos cálculos que podem ser computados. A camada do modelo de linguagem interpreta intenção, coordena recursos suportados e explica resultados grounded. A página pública Analytics da Kaleidr, intitulada Map Engagement and Location Analytics, descreve alcance, visualizações, engajamento, localização e atividade do público, sessões e interações por mapa, comparação de lugares e padrões espaciais (Kaleidr, 2026). Esses relatórios descrevem comportamento em mapas e lugares. Reservas concluídas, pedidos e leads qualificados permanecem nos sistemas host que registram esses resultados.
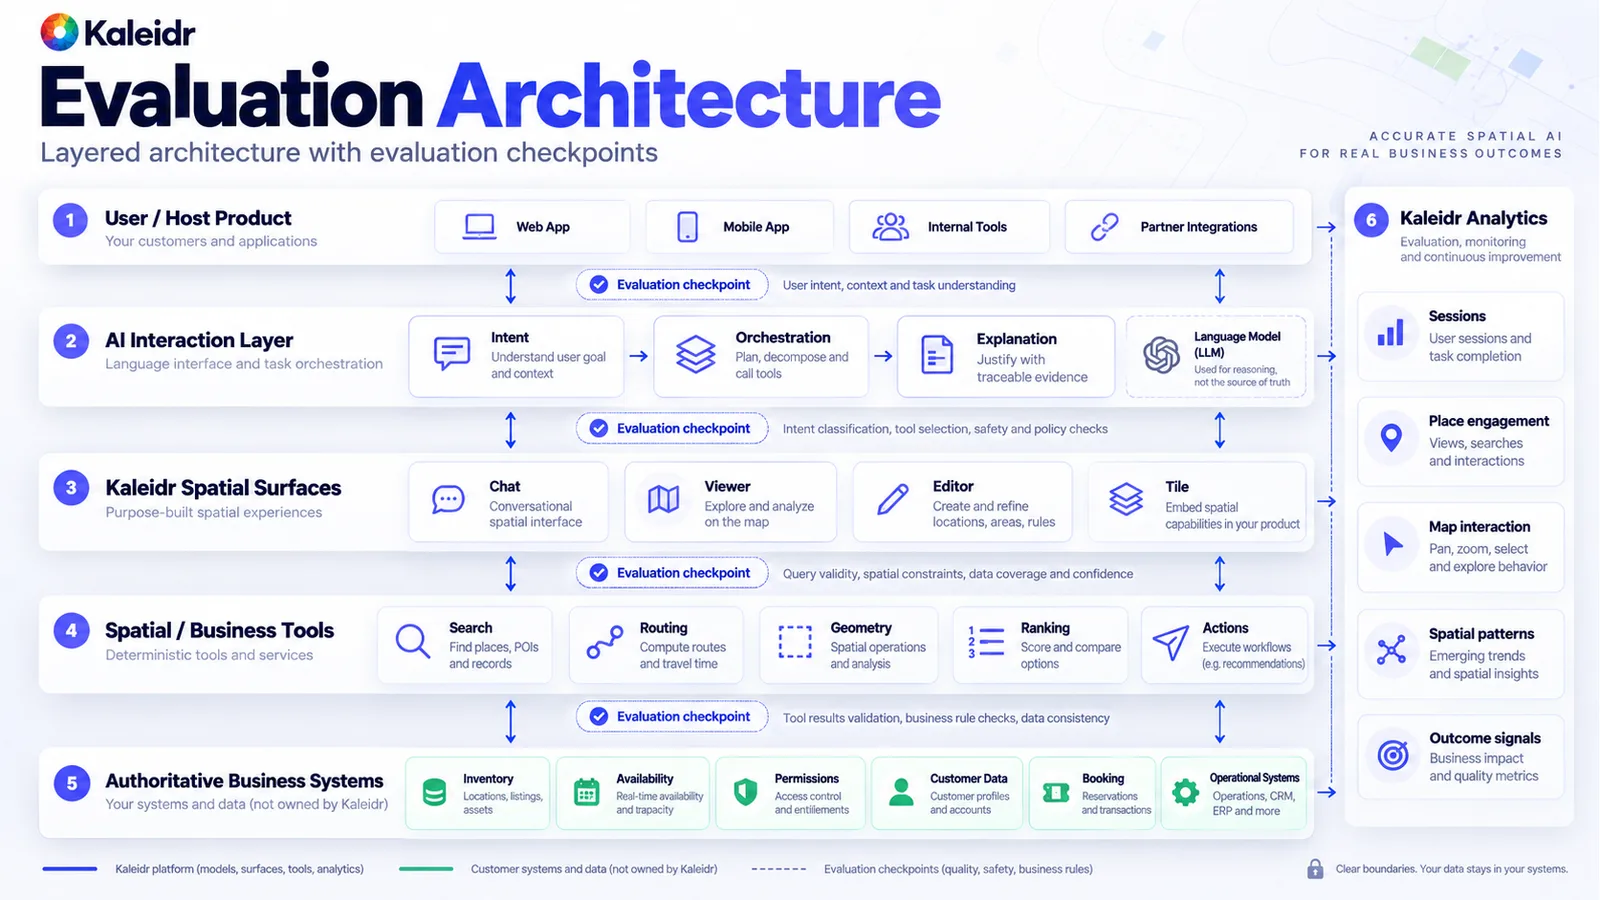
O modelo de linguagem não é a fonte de verdade para estoque, permissões ou uma rota. Checkpoints entre camadas mostram qual parte falhou.
Quais erros escondem um benchmark fraco?
Perguntas de happy path, sem ambiguidade, dados ausentes ou uma solicitação insolúvel, superestimam a confiabilidade. Avaliar apenas a similaridade do texto com uma referência perde uma decisão correta escrita de outro modo e recompensa um lugar errado escrito no estilo da referência. Classificar um conjunto que ainda contém lugares inelegíveis esconde a falha de elegibilidade. Pedir ao modelo que verifique uma distância que o mecanismo espacial pode calcular substitui fluência por cálculo. Ignorar atualidade trata os horários de ontem como os de hoje. Tratar mais interação com o mapa como precisão confunde interesse com sucesso e, às vezes, com confusão. Alterar uma tolerância depois de ver os números não é um benchmark. Testar apenas o modelo ignora recuperação, dados, ferramentas, permissões, ranking e interface. O comportamento em produção é o produto montado.
Benchmarks de pesquisa ainda ajudam como sondas de capacidade. GeoBenchLLM, submetido em agosto de 2026 e aceito na CIKM 2026, avalia modelos de linguagem em tarefas relacionadas à geografia extraídas de datasets públicos, incluindo compreensão geoespacial e temporal (Rodrigues et al., 2026). Benchmarks de GeoAI frequentemente cobrem sensoriamento remoto, workflows GIS, imagens ou tarefas de modelos geoespaciais. Um benchmark de produto também pode precisar de grounding em dados de negócio, permissões, disponibilidade em tempo real, ranking, ações de mapa e resultado do cliente. Nenhum benchmark público pode representar o trabalho de todos os produtos.
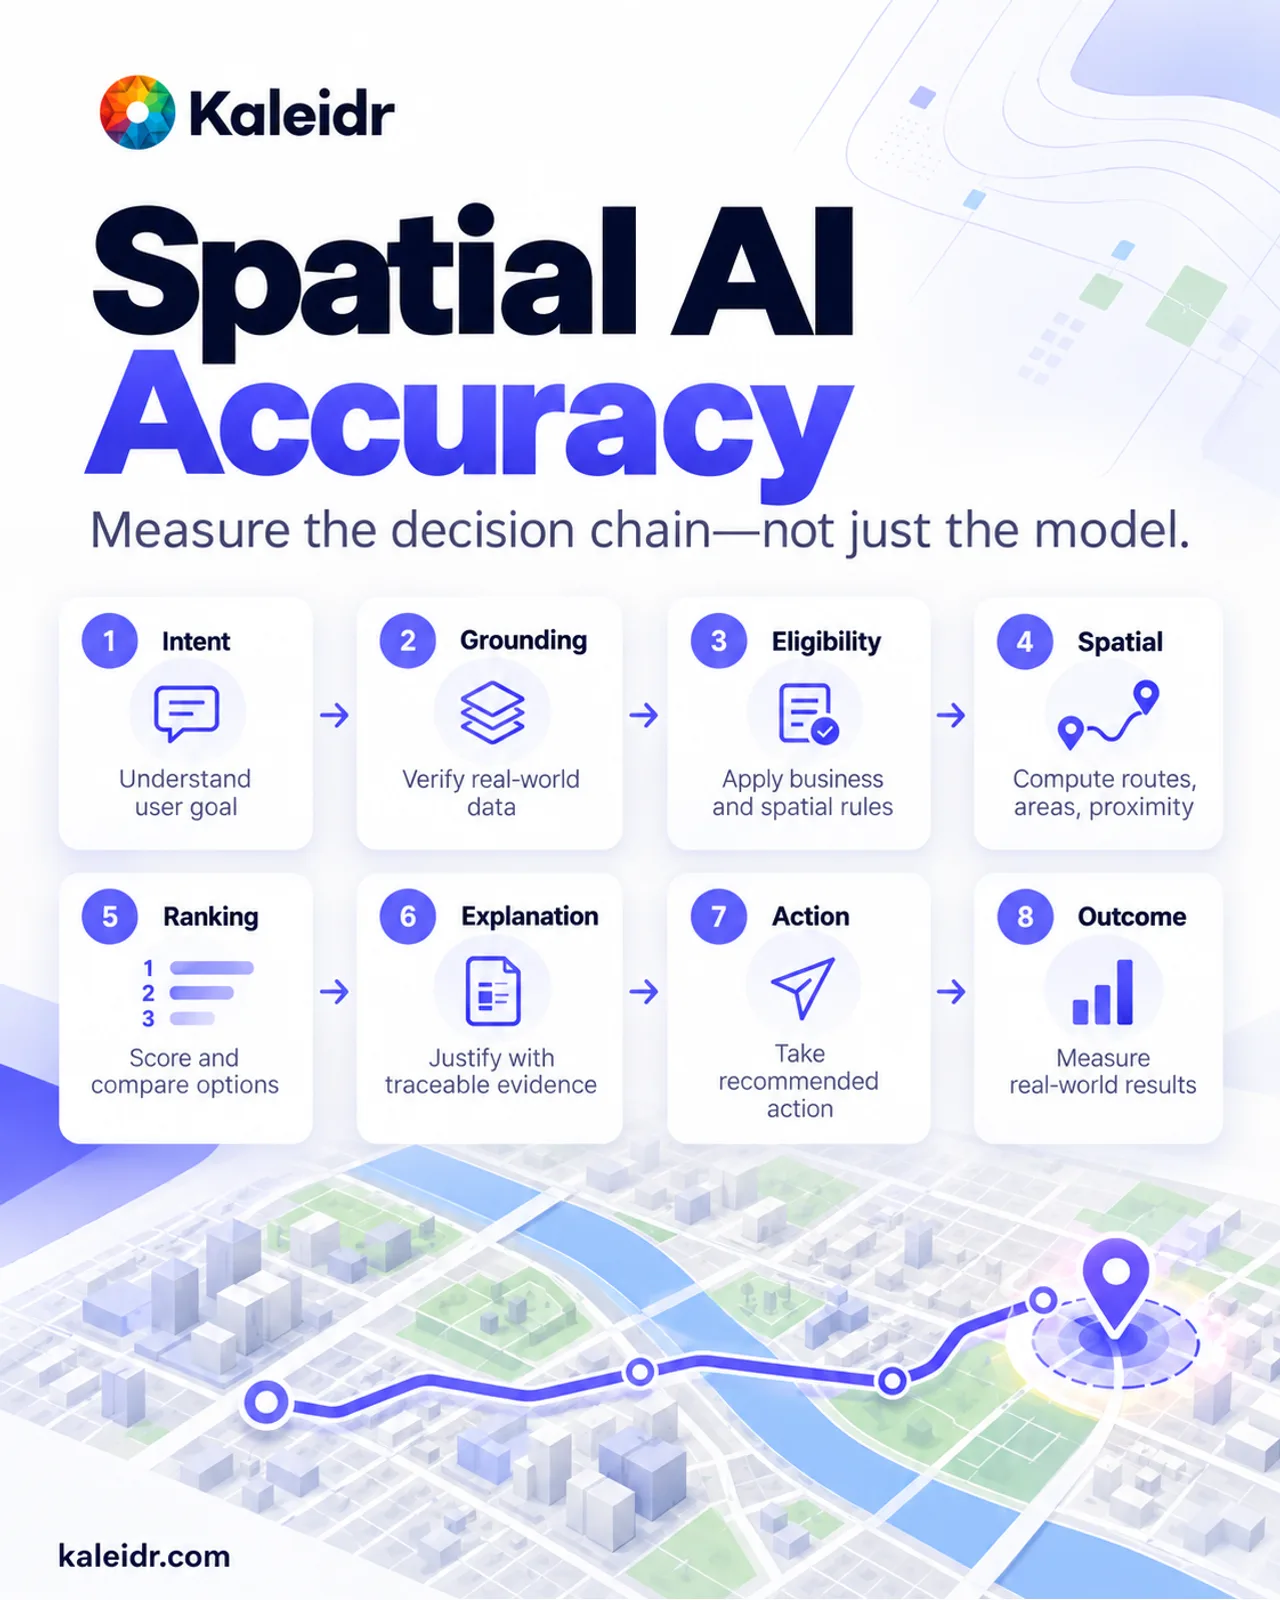
Meça a cadeia de decisão, não apenas o modelo. As oito etapas são o esboço da avaliação, não uma pontuação divulgada.
Como a avaliação se torna um gate de release?
Monte o conjunto de testes antes de escalar. Inclua os casos de falha. Mantenha a verdade determinística fora do modelo de linguagem quando uma ferramenta ou registro puder responder. Acompanhe dimensões críticas em seus próprios gates. Repita a execução quando o sistema mudar e conecte o resultado offline ao resultado de produção que o trabalho deveria melhorar. A pergunta útil é se este sistema consegue tomar a decisão dependente de localização que o produto promete, com os dados, a geografia, as permissões e as ações corretas, e se a equipe consegue provar isso.
Explore Kaleidr Enterprise para adicionar AI sensível à localização ao lado dos sistemas que um produto já usa e definir um piloto focado. Explore Kaleidr Analytics para ver como os públicos usam os mapas e lugares desse piloto. O host continua responsável pelo resultado de negócio e pela decisão de escalar.
Perguntas frequentes
Como medir a precisão de Spatial AI?
Meça as etapas da decisão de localização: intenção, resolução de lugar, autorização, elegibilidade, cálculos geográficos, atualidade, ranking, explicação, ação e resultado do usuário ou do negócio. Não reduza essa cadeia a uma única pontuação do modelo.
Isso é o mesmo que precisão do modelo de linguagem?
Não. Um modelo de linguagem é apenas um componente. Bancos de dados de lugares, registros de negócio, mecanismos espaciais, roteamento, ranking, permissões e estado do aplicativo podem mudar se o resultado está correto ou não.
Um modelo de linguagem deve calcular distância?
Use uma ferramenta geográfica ou de roteamento quando o produto precisar de uma distância ou relação de viagem. O modelo pode decidir quando o cálculo é necessário e explicar o resultado. O serviço espacial realiza o cálculo.
Benchmarks devem incluir perguntas impossíveis?
Sim. Tarefas intencionalmente insolúveis mostram se o sistema retorna uma resposta grounded de “nenhum resultado” em vez de inventar um lugar ou remover silenciosamente uma restrição.
Com que frequência a avaliação deve ser executada?
Execute antes da produção e novamente quando modelos, prompts, provedores de dados, ranking, ferramentas espaciais, permissões ou cobertura mudarem. Monitore continuamente o comportamento em produção. Um relatório no dia do lançamento não é um processo de release.
Um benchmark pode comparar todos os sistemas?
Benchmarks de pesquisa podem comparar uma capacidade declarada. A avaliação de produção precisa refletir o trabalho geográfico, os dados, os riscos, as ferramentas e o resultado daquela aplicação. Benchmarks de GeoAI e benchmarks de produto não são intercambiáveis.
Referências
- National Institute of Standards and Technology. AI RMF Playbook, Measure. Notes that the AI RMF 1.0 is being updated and that the playbook will be revised afterward. Accessed September 29, 2026. https://airc.nist.gov/airmf-resources/playbook/measure/
- National Institute of Standards and Technology. The TEVV-Athlon Framework for Evaluating AI Systems. NIST AI 200-2, initial public draft. Announced August 7, 2026; comments through October 6, 2026. https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems
- Krechetova, Varvara, and Denis Kochedykov. GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks. arXiv:2503.18129, submitted March 23, 2025, revised October 22, 2025. https://arxiv.org/abs/2503.18129
- Pothuri, Abhinav, Zhe Jiang, Zelin Xu, and Di Yang. GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks. arXiv:2608.01645, submitted August 3, 2026. https://arxiv.org/abs/2608.01645
- Rodrigues, Rodrigo Ferreira, Karim Radouane, Jose G. Moreno, and Lynda Tamine. GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks. arXiv:2608.07411, submitted August 7, 2026. Accepted at CIKM 2026. https://arxiv.org/abs/2608.07411
- OWASP Gen AI Security Project. LLM01:2025 Prompt Injection. Accessed September 29, 2026. https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed September 29, 2026. https://kaleidr.com/enterprise
- Kaleidr. Map Engagement and Location Analytics. Accessed September 29, 2026. https://kaleidr.com/analytics
- Kaleidr. Grounded Spatial AI for Business Data. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- Kaleidr. An Enterprise Spatial AI Pilot Before Scaling. https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling
@misc{nist_rmf_playbook_measure_2026,
  title  = {AI RMF Playbook, Measure},
  author = {{National Institute of Standards and Technology}},
  year   = {2026},
  note   = {Accessed September 29, 2026. Page states the playbook will be updated after the AI RMF revision},
  url    = {https://airc.nist.gov/airmf-resources/playbook/measure/}
}

@techreport{nist_ai_200_2_2026,
  title       = {The TEVV-Athlon Framework for Evaluating AI Systems},
  author      = {{National Institute of Standards and Technology}},
  institution = {National Institute of Standards and Technology},
  number      = {NIST AI 200-2},
  year        = {2026},
  note        = {Initial public draft, announced August 7, 2026},
  url         = {https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems}
}

@misc{krechetova_geobenchx_2025,
  title  = {GeoBenchX: Benchmarking LLMs in Agent Solving Multistep Geospatial Tasks},
  author = {Krechetova, Varvara and Kochedykov, Denis},
  year   = {2025},
  note   = {arXiv:2503.18129, revised October 22, 2025},
  url    = {https://arxiv.org/abs/2503.18129}
}

@misc{pothuri_gisagentbench_2026,
  title  = {GISAgentBench: A Practitioner-Sourced Benchmark for Evaluating LLM Agents on GIS Tasks},
  author = {Pothuri, Abhinav and Jiang, Zhe and Xu, Zelin and Yang, Di},
  year   = {2026},
  note   = {arXiv:2608.01645, submitted August 3, 2026},
  url    = {https://arxiv.org/abs/2608.01645}
}

@misc{rodrigues_geobenchllm_2026,
  title  = {GeoBenchLLM: A Comprehensive Benchmark for Evaluating LLMs on Geo-Related Tasks},
  author = {Rodrigues, Rodrigo Ferreira and Radouane, Karim and Moreno, Jose G. and Tamine, Lynda},
  year   = {2026},
  note   = {arXiv:2608.07411, submitted August 7, 2026, accepted at CIKM 2026},
  url    = {https://arxiv.org/abs/2608.07411}
}

@misc{owasp_llm01_2025,
  title  = {LLM01:2025 Prompt Injection},
  author = {{OWASP Gen AI Security Project}},
  year   = {2025},
  note   = {Accessed September 29, 2026},
  url    = {https://genai.owasp.org/llmrisk/llm01-prompt-injection/}
}

@misc{kaleidr_enterprise_accuracy_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_analytics_accuracy_2026,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 29, 2026},
  url    = {https://kaleidr.com/analytics}
}