
L'IA spatiale fondée sur des données fiables relie la requête en langage naturel d'un client aux données commerciales autorisées, aux règles d'éligibilité et aux calculs spatiaux déterministes afin que le produit puisse recommander un lieu où l'entreprise peut effectivement effectuer la livraison. Le modèle de langage interprète les intentions complexes, comme le retrait d'un produit en stock sur le chemin du retour. Les systèmes d'inventaire, de politiques et de planification d'itinéraires restent les références en matière de stock, d'horaires, d'autorisations et de déplacements. L'IA spatiale affiche ensuite la liste restreinte ancrée sur la carte.
Les sections suivantes distinguent les données actuelles du comportement du modèle, puis abordent l'autorisation, la récupération, le classement, la cartographie Kaleidr, l'évaluation et un projet pilote ciblé. Pour en savoir plus, consultez les documents Private Location Data for AI Map Workflows, How to Build a Map-Aware AI Assistant et Spatial AI for Multi-Location Businesses. Les équipes qui associent déjà des conversations à une carte existante peuvent passer directement à la cartographie Kaleidr; celles qui définissent encore la source des données doivent commencer par la définition de « ancré ».
Principes fondamentaux de l'IA spatiale fondée sur des données fiables
- Les faits restent la propriété de leurs détenteurs: L'inventaire, les politiques, les prix et les autorisations ne proviennent jamais du modèle.
- L'espace reste calculé: La distance, l'itinéraire, le périmètre et le temps de trajet relèvent des services géospatiaux.
- Autorisation avant récupération: Le modèle ne gère pas les autorisations.
- Éligibilité avant classement: Les enregistrements fermés, vides, hors zone ou non autorisés sont supprimés en premier.
- Évaluation de la tâche: La sélection valide, le transfert et la gestion des résultats géographiques infructueux sont plus importants que la simple durée de la conversation.
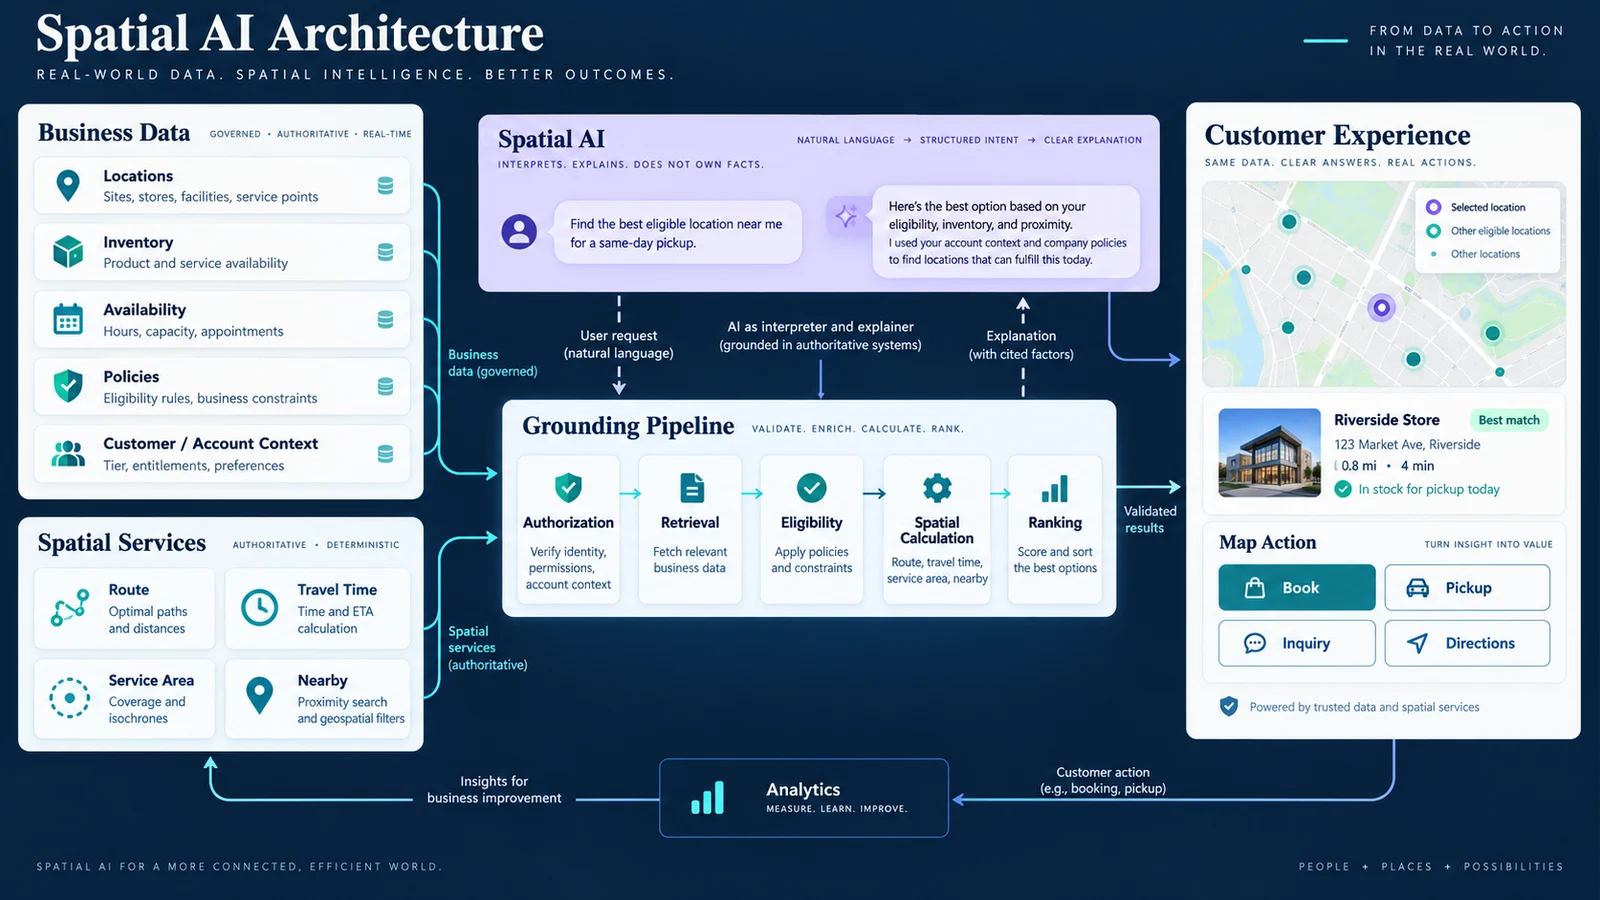
fonctionne lorsque le modèle interprète la requête tandis que les systèmes métiers et géospatiaux restent la référence en matière de faits.
Pourquoi l'IA spatiale fondée sur des données fiables est-elle un problème d'architecture d'entreprise?
Un assistant générique peut répondre à des questions générales sur les lieux publics. Un produit commercial, quant à lui, doit indiquer quel magasin propose le retrait de commandes, quel restaurant partenaire est encore ouvert après un spectacle, quelle annonce est toujours active malgré les contraintes de temps, ou encore quel prestataire peut effectivement livrer à une adresse dans le créneau horaire demandé. Ces réponses dépendent des stocks, des horaires d'ouverture, de la zone de desserte, du statut de l'annonce, de l'éligibilité des partenaires, des autorisations du compte et de l'état opérationnel. Un modèle de langage ne devrait pas inventer ces champs à partir de sa mémoire d'entraînement.
Kaleidr décrit actuellement la connexion des données commerciales, des informations de localisation et des systèmes existants afin que l'IA spatiale puisse exploiter les ressources déjà en place au sein d'une entreprise, ainsi qu'un socle de connaissances métier géolocalisées pour les réponses de l'IA (Kaleidr, 2026). La page AI Map Chat for Customer Discovery présente actuellement le chat sensible à la localisation comme fondant ses recommandations sur les lieux, l'inventaire et les règles métier de l'entreprise hôte. Ces pages font autorité quant au positionnement de Kaleidr. Elles ne prouvent cependant pas que Kaleidr exploite un registre d'inventaire, un CRM, un flux d'horaires ou un annuaire de franchisés natifs.
Maintenir la distinction entre trois problèmes voisins. L'article sur la localisation privée traite de l'autorisation et de la minimisation des enregistrements que l'hôte ne divulgue pas publiquement. L'article sur l'assistant cartographique aborde l'état partagé de la carte et les actions cartographiques validées. Le guide multi-localisation traite des identifiants canoniques, de l'éligibilité et du classement au sein d'un réseau de branches. Ce guide constitue l'architecture de référence commune à ces parcours: données probantes actuelles, calcul spatial déterministe et un ensemble de contextes concis que le modèle peut expliquer sans posséder les faits.
Que signifie « ancré » dans cette architecture?
Une réponse justifiée est une réponse dont les données proviennent de sources approuvées et accessibles à l'application au moment de la requête. Lorsqu'un client demande quel magasin près d'Union Square propose une veste en taille M, le produit doit identifier la référence et la taille, récupérer les magasins disponibles, consulter l'inventaire actuel, calculer la proximité géographique avec le magasin indiqué, classer les magasins pertinents, puis afficher le résultat sur la même carte. Le langage utilisé peut être conversationnel. Les données de stock et le calcul du trajet doivent provenir de systèmes capables de justifier la demande.
La justification concerne l'architecture de l'application, et non une invite plus générale. Le modèle interprète l'intention et formule la question à laquelle les systèmes doivent répondre. Les systèmes responsables de l'inventaire, des politiques, de la disponibilité et des itinéraires restent les systèmes de référence. Si aucune source ne justifie une demande, il convient de se demander si le produit est légitime pour la formuler.
Le tableau de propriété ci-dessous est fourni à titre indicatif et ne constitue pas un schéma Kaleidr documenté. Utilisez-le pour faciliter l'inspection des limites de la source. Les déploiements réels doivent renseigner les mêmes colonnes en fonction des systèmes déjà exécutés par l'hôte.
| Réclamation | Source faisant autorité |
|---|---|
| Article en stock | Système d'inventaire |
| L'enregistrement commence à une heure précise | Système de politiques |
| Annonce active | Système d'annonces |
| Le fournisseur dessert cette zone | Système de zone de service |
| Coordonnées | Source de lieu approuvée |
| Temps de trajet | Service de routage |
| L'utilisateur peut consulter l'enregistrement | Identité / autorisation |
| Pourquoi cette option est-elle classée première? | Explication par IA de ce qui précède |
En quoi l'ancrage dans les données diffère-t-il du réglage fin, du RAG et du prompting?
Les équipes regroupent souvent quatre tâches différentes sous un seul terme. L'ancrage fournit les données métier et spatiales actuelles au moment de la requête. La génération augmentée par récupération extrait les enregistrements ou documents pertinents et peut constituer une technique d'ancrage. Le réglage fin modifie le comportement du modèle ou le style de sortie à partir d'exemples. Le prompting fournit les instructions d'exécution et le contexte de la tâche. L'inventaire en temps réel, la disponibilité, le statut des annonces, les règles de zone de service et le temps de trajet actuel font partie des données probantes actuelles, et non de la mémoire du modèle.
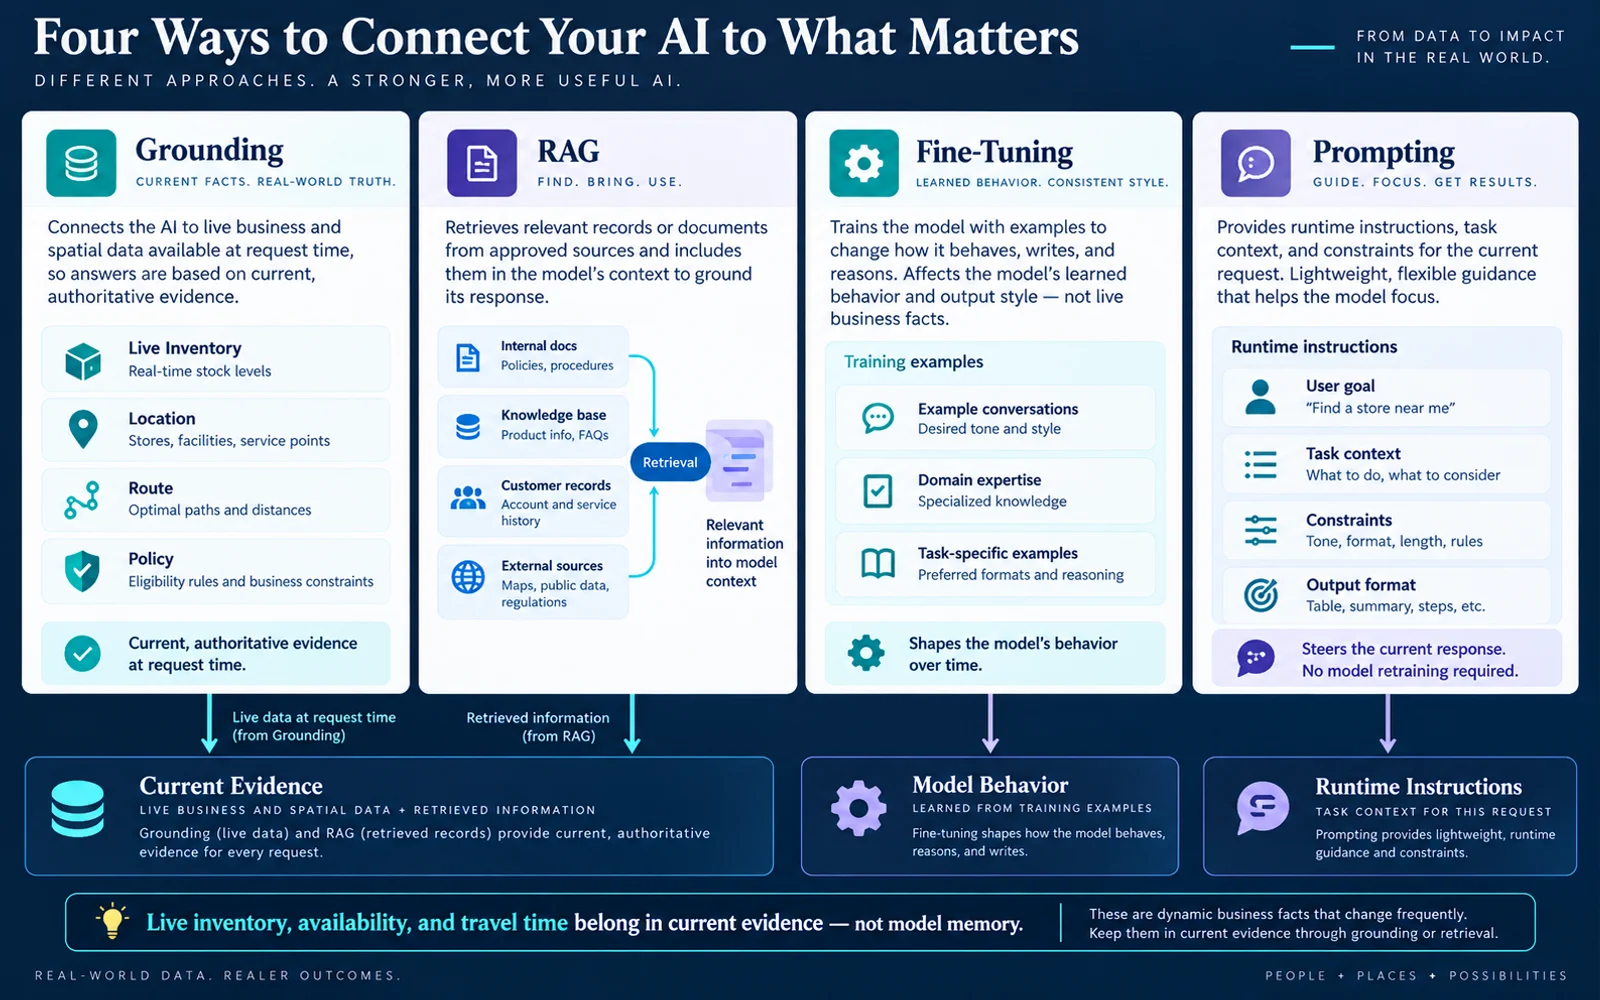
L'ancrage est une architecture d'application pour les données probantes actuelles; il ne s'agit pas d'un synonyme de réglage fin ni d'une invite plus étendue.
Le RAG est utile pour les textes de politique, les descriptions de services et les directives de marque. Les champs structurés tels que le stock, le statut, le prix, l'état d'ouverture et le polygone de la zone de service doivent rester typés afin que les filtres stricts puissent être appliqués avant tout classement. Un réglage fin peut améliorer le ton et la forme de la sortie. Cependant, il n'est généralement pas la bonne source de vérité pour un fait qui a changé cet après-midi. Le prompting peut encadrer la manière dont l'assistant s'exprime. À lui seul, il ne rend pas un fait fiable.
Pourquoi l'ancrage spatial nécessite-t-il sa propre couche?
Un assistant commercial peut être basé sur des documents et pourtant commettre des erreurs spatiales. Deux magasins peuvent avoir des stocks, mais un seul est accessible avant la prochaine étape. Un modèle de langage ne doit pas estimer cette relation à partir des descriptions des magasins. L'application a besoin d'un service géospatial capable de prendre en compte l'origine, la destination, le mode de transport et le réseau, et de renvoyer une relation de trajet que le client peut consulter.
L'IA spatiale fondée sur des données fiables combine donc l'ancrage métier et l'ancrage spatial. Les données métier indiquent la véracité du candidat. La couche géospatiale indique comment les candidats sont liés dans l'espace. Une limite importante réside dans le fait que l'IA choisit la question et que les services spatiaux calculent la relation. Place Ranking API traite du classement des emplacements disponibles restants après ces calculs, y compris lorsqu'une prochaine étape est déjà prévue dans le trajet.
Quels enregistrements canoniques l'ancrage doit-il utiliser?
Grounded nécessite des identités stables. Chaque lieu, fiche produit, référence, service ou fournisseur doit posséder un identifiant unique et durable, partagé entre la base de données de l'entreprise, le marqueur cartographique, le contexte de l'IA, les analyses et le processus de réservation ou de retrait. Le nom d'affichage ne doit pas être considéré comme une identité. Les informations organisationnelles, telles que l'identité de marque et la politique de l'entreprise, peuvent être héritées. Les informations relatives au lieu, comme les horaires d'ouverture, les stocks disponibles et les conditions de retrait, doivent rester propres à l'établissement. Un troisième niveau, l'état opérationnel, gère les stocks, les capacités et les fermetures temporaires, avec un horodatage précis de la date de disponibilité, car le stock de la veille n'est pas un critère de classement.
Normaliser les coordonnées, les horaires, les statuts, les unités et les catégories avant la requête afin de permettre l'exécution des filtres déterministes. Les entités typées empêchent qu'un identifiant de magasin soit considéré comme un identifiant de produit, ou qu'un bâtiment soit considéré comme une fiche produit. La liste exacte des champs est spécifique à chaque produit. Le contrat de base prévoit un identifiant par lieu et une attribution explicite de la source pour chaque requête autorisée à l'assistant.
Pourquoi l'extraction doit-elle suivre l'autorisation?
Le comportement dangereux consiste à récupérer un large éventail de données métier, à les transmettre au modèle, puis à interroger ce dernier sur les données que l'utilisateur peut consulter. Il est préférable d'authentifier l'utilisateur, de déterminer le locataire, d'autoriser les objets et les champs, de récupérer le minimum nécessaire, puis de ne transmettre que ce minimum au modèle. Un utilisateur peut être autorisé à consulter l'emplacement d'un fournisseur sans que sa marge interne soit prise en compte. La couche de récupération doit supprimer le deuxième champ avant que le contexte ne franchisse la limite de l'IA.
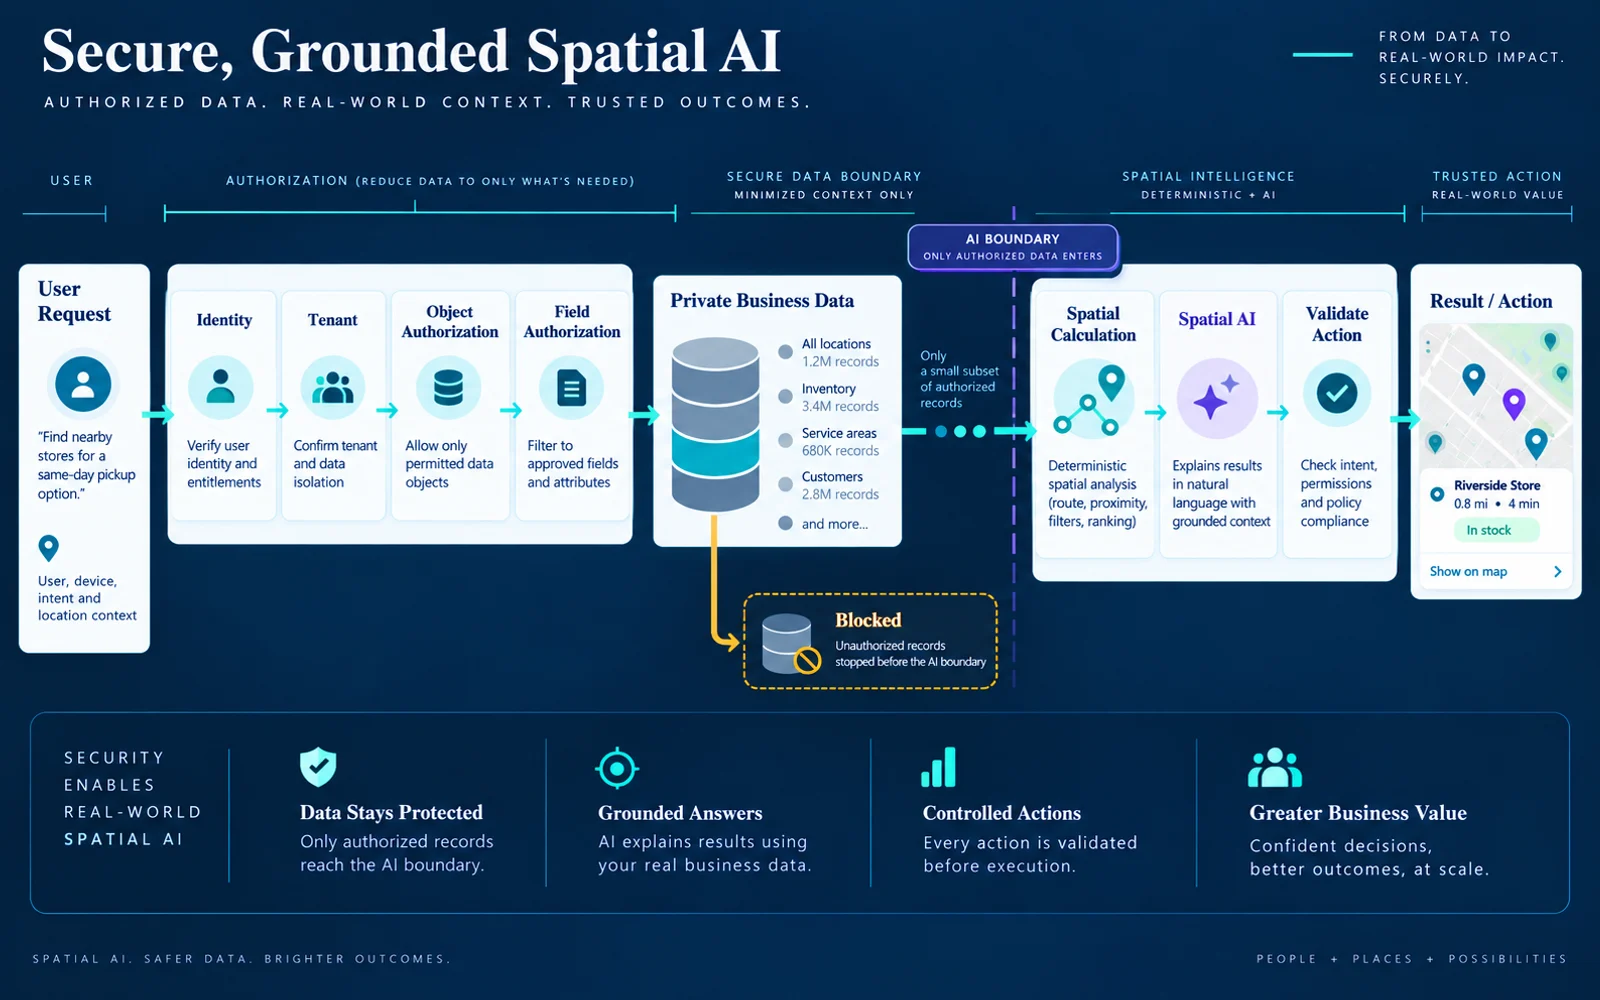
Le modèle ne doit jamais être le composant qui décide des données qu'un utilisateur est autorisé à récupérer; l'autorisation doit être effectuée avant la limite du contexte de l'IA.
Kaleidr documente actuellement une distinction entre les clés publiables du navigateur et les clés serveur, et précise qu'une clé publiable présentée comme jeton bearer est rejetée (Kaleidr, 2026). Cette même documentation décrit une portée vendor permettant au chat de consulter les données d'organisation téléversées que l'entreprise hôte a choisi d'exposer sur cette interface. Elle avertit également qu'une clé publiable n'est pas appropriée pour les tarifs ou toute information que l'hôte ne souhaite pas publier. Cette distinction doit être considérée comme le contrat public relatif aux identifiants. L'inventaire de l'hôte, les emplacements non publiés et les enregistrements clients restent protégés par l'autorisation de l'hôte et ne doivent pas être placés dans un prompt.
La zone d'affichage de la carte fait partie de la requête, et non d'une autorisation. Un élément privé d'un administrateur visible sur la carte ne doit pas être intégré au contexte d'IA d'un autre utilisateur du seul fait du déplacement de la caméra. Les points de terminaison de chat actuels documentent des champs tels que location, map_zoom, la langue et le contexte de session (Kaleidr, 2026). Ces champs permettent de lier la conversation à la carte. Le contexte de la carte ne remplace pas l'autorisation d'objet et de champ.
Comment l'éligibilité, le classement et l'explication doivent-ils rester distincts?
Les contraintes strictes sont binaires et relèvent des systèmes qui font autorité pour les lieux, l'inventaire et le routage, avant tout classement. Un candidat fermé, en rupture de stock pour la variante demandée, hors zone de service, inactif, dépourvu d'un service requis ou non autorisé doit être éliminé. Les préférences souples, telles qu'un trajet légèrement plus court, permettent ensuite de classer les options valides restantes. L'ancrage indique ce qui est vrai. Le classement indique quelle option valide correspond à la demande. L'explication rend compte, à partir de ces données, de la raison d'être de la liste restreinte.
Le modèle de langage peut transformer une requête telle que « trouver cet article à retirer aujourd'hui en rentrant » en champs inspectables: origine, article, conditions d'ouverture, mode de retrait et limite de déplacement. Ces champs correspondent à des requêtes auprès des systèmes qui détiennent déjà les informations. Il est inutile de demander au modèle d'inventer des minutes de déplacement après que le client a déjà précisé la contrainte. Ne privilégiez pas un produit phare fermé simplement parce qu'il est plus connu. Revalidez les stocks, la disponibilité et les horaires avant une action importante comme la réservation, l'achat ou le retrait, car la recommandation peut devenir obsolète pendant que le client compare les options.
Un package de contexte compact ne doit contenir que la liste restreinte nécessaire au client, la source et la mise à jour étant connues de l'application même si tous les champs de métadonnées ne sont pas affichés au modèle. Afficher l'intégralité de la base de données dans l'invite de commande engendre des fuites de données, de la latence, des enregistrements obsolètes et une surface de débogage inaccessible à tous. La minimisation est une mesure de sécurité et de contrôle produit.
Quelle est la place de Kaleidr dans une pile logicielle ancrée?
Une implémentation Kaleidr permet d'ajouter une couche spatiale conversationnelle à la carte et au système de géolocalisation déjà utilisés par l'hôte. Kaleidr décrit actuellement Chat comme un produit qui se superpose à une carte déjà affichée par l'hôte, affiche les lieux localisés et cadre la caméra au fur et à mesure de la résolution des localisations, avec détection automatique pour Mapbox, MapLibre, Google Maps et Leaflet (Kaleidr, 2026). Le contrat d'intégration confirme l'existence d'une conversation prenant en compte la cartographie dans l'interface développeur publique actuelle. La documentation ne mentionne cependant pas de catalogue d'inventaire natif, de moteur de réservation ni de flux d'horaires.
La liste actuelle des API publiques de la plateforme inclut l'échange de sessions SDK, le chat en continu, le routage, l'enrichissement des POI et les points de terminaison de conception. Elle ne propose actuellement aucune solution universelle pour le chargement des connaissances, l'index RAG ou la connexion à l'inventaire. Les pages produits de Kaleidr décrivent la connexion des lieux et l'ancrage de l'IA sur l'inventaire et les politiques de l'entreprise; il est important de vérifier le chemin d'intégration pour le déploiement plutôt que de considérer les supports marketing comme une API d'ingestion. How to Add AI Chat to Mapbox, Google Maps, and MapLibre détaille les étapes d'attachement spécifiques au moteur de rendu. La page Location Intelligence APIs and Map SDK décrit actuellement les SDK, le classement et l'analyse des produits spatiaux. La documentation développeur fait office de contrat d'intégration; les pages marketing décrivent le cas d'utilisation, et non la liste des flux d'inventaire.
Les actions sémantiques sur les cartes, telles que la mise au point, l'affichage des candidats ou l'affichage d'un itinéraire, doivent être proposées par l'assistant et validées par l'hôte à l'aide d'identifiants et d'autorisations avant leur exécution par le moteur de rendu. La sortie en langage naturel ne doit pas exécuter de code cartographique arbitraire. L'état partagé des cartes, des listes et des conversations doit conserver un identifiant de localisation canonique afin que la question « Quel est l'élément le plus proche?» conserve les mêmes règles concernant les éléments et les horaires.
L'ancrage géographique n'est pas spécifique à la cartographie. Google Cloud documente actuellement la recherche personnalisée sur des ensembles de données structurés d'entreprise, tels que les catalogues d'hôtels, les annonces immobilières et les annuaires de restaurants, et décrit séparément la génération de réponses d'IA fondée sur des données fiables à partir de données connectées (Introduction to custom search, 2026). Pour l'IA spatiale, l'exigence supplémentaire est le calcul géographique. Cette page Google Cloud décrit le produit de recherche de Google. Il ne s'agit pas d'un connecteur Kaleidr.
Comment les équipes doivent-elles évaluer l'IA spatiale fondée sur des données fiables?
Une réponse fluide peut néanmoins être erronée. Mesurez la pertinence de la recherche, de l'autorisation, des règles métier, de la géolocalisation, de la fidélité des explications, de la validité de l'action et de la fraîcheur des données par des contrôles distincts. Un système fiable doit parfois ne renvoyer aucune option éligible. Dans de nombreux flux de travail B2B, un faux positif est plus préjudiciable qu'une absence de résultat. Consignez les raisons structurées de l'absence de résultat, telles que « fermé », « rupture de stock », « hors zone géographique », « trop éloigné », « horaires inconnus » ou « accès non autorisé », plutôt qu'un simple signal d'échec.
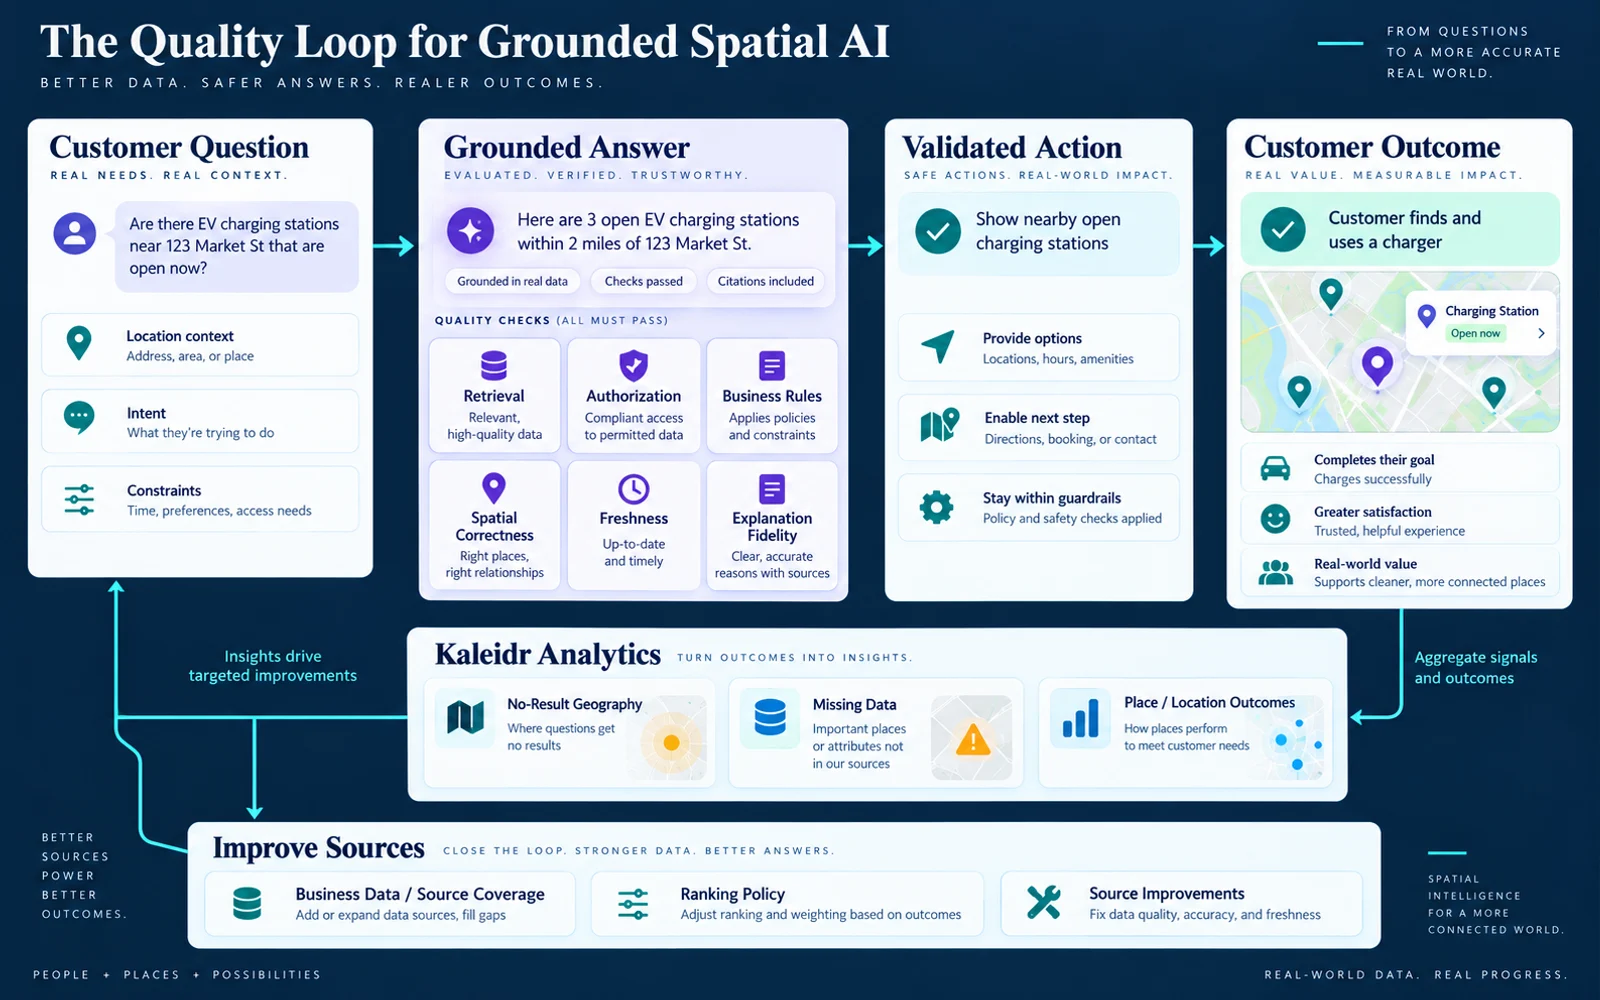
La qualité de l'intégration est mesurable: la pertinence factuelle et spatiale doit être liée à l'action du client que le produit est conçu pour améliorer.
L'OWASP identifie actuellement l'injection de prompts comme un risque majeur pour les applications de modèles de langage et indique que le RAG et le réglage fin ne permettent pas de l'empêcher totalement (LLM01:2025 Prompt Injection). Considérez les entrées utilisateur et le contenu récupéré comme potentiellement non fiables. L'OWASP documente également les faiblesses liées aux vecteurs et aux plongements, notamment le contenu récupéré empoisonné, les fuites entre locataires et l'accès non autorisé aux plongements (LLM08:2025 Vector and Embedding Weaknesses). L'ancrage exige des sources fiables, un cloisonnement des locataires et la validation des actions par l'hôte, et non pas simplement un ensemble de récupération plus étendu. Le NIST a publié le Profil d'intelligence artificielle générative en juillet 2024, en complément du Cadre de gestion des risques liés à l'IA, afin de traiter la fiabilité sur l'ensemble du cycle de vie de l'IA (Generative Artificial Intelligence Profile, 2024). Évaluez l'ancrage dans le cadre de ce système plus vaste, et non comme un simple interrupteur de factualité.
Kaleidr Analytics documente actuellement l'engagement sur les cartes et les lieux, la comparaison des lieux, les tendances spatiales et l'activité sur lesquels les équipes produit, inventaire et croissance peuvent agir (Kaleidr, 2026). Les systèmes hôtes conservent la gestion des stocks et des réservations. Utilisez cette boucle pour identifier les codes postaux avec des recherches de produits en stock et aucune agence éligible, les plages horaires de déplacement qui entraînent une perte de clients et les marchés présentant une demande et des champs manquants. Ces questions sont d'ordre géographique et non liées aux pages vues. Spatial Analytics vs. Web Analytics explique pourquoi les pages vues seules ne suffisent pas à y répondre. Les noms d'événements suggérés dans cet article sont des recommandations éditoriales et non des noms d'événements automatiques documentés par Kaleidr Analytics.
Comment démarrer un projet pilote d'IA spatiale fondée sur des données fiables?
Commencez par une tâche à forte valeur ajoutée, comme recommander un point de retrait avec des produits en stock sur le trajet domicile-travail dans une même agglomération. Conservez le répertoire des points de retrait, les horaires et les stocks dans les systèmes qui les gèrent déjà. Intégrez une interface conversationnelle à la carte existante. Limitez les résultats aux succursales autorisées, exigez que le point de retrait soit ouvert et que l'article soit en stock, calculez le trajet depuis le point de départ indiqué, revérifiez la sélection avant le retrait et évaluez la sélection ainsi que l'action du vendeur qui suit. N'étendez les catégories, les villes et les franchises qu'une fois la première étape concluante.
La découverte conversationnelle ne remplace pas la qualité du catalogue, la mise à jour des horaires ni la rigueur de l'exécution des commandes. Les temps de trajet restent des estimations. La fiabilité des données de stock dépend de la source d'inventaire sous-jacente. L'ajout d'un assistant à une carte existante est généralement moins coûteux que le remplacement du moteur de rendu, mais l'hébergeur reste responsable des autorisations, des contrats fournisseurs et des actions commerciales ultérieures. Considérez les données manquantes comme des inconnues plutôt que comme un échec, et déployez la solution par marché plutôt que sur l'ensemble des données simultanément.
Explore Kaleidr Spatial AI pour ajouter la recherche conversationnelle de localisation sur une carte existante. Explore Kaleidr Enterprise pour intégrer les SDK et le classement à votre infrastructure existante. Explore Kaleidr Analytics pour mesurer l'engagement sur le lieu et la demande géographique liée à ce parcours. Vérifiez les pages publiques actuelles avant d'utiliser un exemple de cet article comme engagement fonctionnel de production.
FAQ
Qu'est-ce que l'IA spatiale fondée sur des données fiables?
L'IA spatiale fondée sur des données fiables utilise des données métier actuelles et approuvées, ainsi que des calculs géographiques déterministes, pour fournir des réponses d'IA concernant les lieux, les stocks, la disponibilité, l'éligibilité et les déplacements. Le modèle de langage interprète et explique la requête; les systèmes métier et géospatiaux restent les sources de référence pour les données.
L'ancrage est-il identique à la génération augmentée par la récupération (RAG)?
Non. La génération augmentée par la récupération est une technique d'ancrage. Un système d'IA spatiale en production peut également utiliser des requêtes structurées, l'autorisation, les règles métier, le classement, le routage, les calculs géométriques et des API opérationnelles en temps réel.
L'ancrage est-il identique au réglage fin?
Non. Le réglage fin modifie le comportement du modèle. L'ancrage fournit des données à jour lors de l'exécution. Les données évoluant rapidement, telles que les stocks et la disponibilité, doivent rester dans les systèmes métier de référence.
Dois-je importer l'intégralité de ma base de données métier dans un modèle?
Non. Ne récupérez que les enregistrements autorisés et les champs nécessaires à la tâche. Minimisez le contexte avant qu'il n'atteigne le modèle.
À qui incombe la gestion des stocks et des disponibilités?
Le système métier hôte doit rester la référence pour les données opérationnelles telles que les stocks, les disponibilités, les prix, le statut des annonces ou la capacité des fournisseurs.
Qui doit calculer la distance et le temps de trajet?
Utilisez un service géospatial ou de routage approprié. L'assistant peut interpréter les relations pertinentes et expliquer le résultat, mais il ne doit pas effectuer de calculs spatiaux précis.
Une IA fondée sur des données fiables peut-elle encore produire des résultats erronés?
Oui. L'ancrage réduit les réponses non prises en charge, mais n'élimine pas les erreurs de modèle. Les applications doivent valider les sorties structurées, restreindre les actions, évaluer la fidélité des explications et prendre en charge les comportements sans résultat.
Le RAG empêche-t-il l'injection de prompts?
Non. OWASP indique que RAG et le réglage fin ne permettent pas d'éliminer complètement l'injection de prompts. La récupération, les autorisations des outils et les actions du modèle nécessitent toujours des contrôles de sécurité au niveau de l'application.
Kaleidr peut-il utiliser l'inventaire et les politiques de l'entreprise?
La page IA actuelle de Kaleidr décrit les recommandations d'ancrage sur les lieux, l'inventaire et les règles métier de l'hôte. Le chemin exact d'intégration des données dépend du déploiement et doit être confirmé pour le cas d'utilisation en entreprise.
Kaleidr publie-t-il une API générique d'ingestion de base de connaissances?
La documentation publique actuelle de l'API de la plateforme ne mentionne pas de point de terminaison universel pour le chargement des connaissances, l'index RAG ou l'ingestion de bases de données d'entreprise arbitraires. Elle documente les sessions SDK, le chat, le routage, l'enrichissement des POI et les points de terminaison de conception.
Kaleidr peut-il intégrer une IA fondée sur des données fiables à une carte existante?
Oui. La documentation actuelle sur les pièces jointes de chat public décrit l'intégration d'une conversation sur une carte déjà affichée par l'hôte, notamment Mapbox, MapLibre, Google Maps et Leaflet. L'hôte reste propriétaire du catalogue de localisation et de l'action métier suivante.
Comment mesurer l'efficacité de l'IA spatiale fondée sur des données fiables?
Exactitude de la recherche, exactitude de l'autorisation, conformité aux règles métier, exactitude spatiale, fidélité des explications, actualité, précision en cas d'absence de résultat, actions valides et résultats métier en aval. Le volume de conversations à lui seul est un indicateur de succès insuffisant.
Références
- Kaleidr. Build Your Own Spatial AI with Kaleidr. Accessed 13 September 2026. https://kaleidr.com/
- Kaleidr. AI Map Chat for Customer Discovery. Accessed 13 September 2026. https://kaleidr.com/ai
- Kaleidr. Auth & scopes. Developer documentation. Accessed 13 September 2026. https://docs.kaleidr.com/platform-api/auth-and-scopes
- Kaleidr. Endpoints. Developer documentation. Accessed 13 September 2026. https://docs.kaleidr.com/platform-api/endpoints
- Kaleidr. Chat attach. Developer documentation. Accessed 13 September 2026. https://docs.kaleidr.com/sdk/chat-attach
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed 13 September 2026. https://kaleidr.com/enterprise
- Kaleidr. Map Engagement and Location Analytics. Accessed 13 September 2026. https://kaleidr.com/analytics
- OWASP Gen AI Security Project. LLM01:2025 Prompt Injection. Accessed 13 September 2026. https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- OWASP Gen AI Security Project. LLM08:2025 Vector and Embedding Weaknesses. Accessed 13 September 2026. https://genai.owasp.org/llmrisk/llm082025-vector-and-embedding-weaknesses/
- Google Cloud. Introduction to custom search. Accessed 13 September 2026. https://docs.cloud.google.com/generative-ai-app-builder/docs/about-generic-search
- NIST. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. Published 26 July 2024. Accessed 13 September 2026. https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence
@misc{kaleidr_home_grounded_2026_09_13,
  title  = {Build Your Own Spatial AI with Kaleidr},
  author = {{Kaleidr}},
  note   = {Accessed 13 September 2026},
  url    = {https://kaleidr.com/}
}

@misc{kaleidr_ai_grounded_2026_09_13,
  title  = {AI Map Chat for Customer Discovery},
  author = {{Kaleidr}},
  note   = {Accessed 13 September 2026},
  url    = {https://kaleidr.com/ai}
}

@misc{kaleidr_auth_grounded_2026_09_13,
  title  = {Auth \& scopes},
  author = {{Kaleidr}},
  note   = {Developer documentation; accessed 13 September 2026},
  url    = {https://docs.kaleidr.com/platform-api/auth-and-scopes}
}

@misc{kaleidr_endpoints_grounded_2026_09_13,
  title  = {Endpoints},
  author = {{Kaleidr}},
  note   = {Developer documentation; accessed 13 September 2026},
  url    = {https://docs.kaleidr.com/platform-api/endpoints}
}

@misc{kaleidr_chat_attach_grounded_2026_09_13,
  title  = {Chat attach},
  author = {{Kaleidr}},
  note   = {Developer documentation; accessed 13 September 2026},
  url    = {https://docs.kaleidr.com/sdk/chat-attach}
}

@misc{kaleidr_enterprise_grounded_2026_09_13,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  note   = {Accessed 13 September 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_analytics_grounded_2026_09_13,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  note   = {Accessed 13 September 2026},
  url    = {https://kaleidr.com/analytics}
}

@misc{owasp_llm01_prompt_injection_2025,
  title  = {LLM01:2025 Prompt Injection},
  author = {{OWASP Gen AI Security Project}},
  note   = {Accessed 13 September 2026},
  url    = {https://genai.owasp.org/llmrisk/llm01-prompt-injection/}
}

@misc{owasp_llm08_vector_embedding_2025,
  title  = {LLM08:2025 Vector and Embedding Weaknesses},
  author = {{OWASP Gen AI Security Project}},
  note   = {Accessed 13 September 2026},
  url    = {https://genai.owasp.org/llmrisk/llm082025-vector-and-embedding-weaknesses/}
}

@misc{google_cloud_custom_search_2026,
  title  = {Introduction to custom search},
  author = {{Google Cloud}},
  note   = {Accessed 13 September 2026},
  url    = {https://docs.cloud.google.com/generative-ai-app-builder/docs/about-generic-search}
}

@misc{nist_genai_profile_2024,
  title  = {Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile},
  author = {{National Institute of Standards and Technology}},
  note   = {Published 26 July 2024; accessed 13 September 2026},
  url    = {https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence}
}