
La IA espacial basada en datos conecta la solicitud en lenguaje natural del cliente con los registros comerciales autorizados, las reglas de elegibilidad y los cálculos espaciales deterministas para que el producto pueda recomendar un lugar que la empresa pueda atender. El modelo de lenguaje interpreta intenciones complejas, como recoger un artículo disponible de camino a casa. Los sistemas de inventario, políticas y rutas siguen siendo la fuente principal de información sobre existencias, horarios, permisos y viajes. La IA espacial explica la lista de opciones recomendadas en el mapa.
Las secciones siguientes separan la evidencia actual del comportamiento del modelo y luego abordan la autorización, la recuperación, la clasificación, el mapeo de Kaleidr, la evaluación y un proyecto piloto limitado. Se recomienda consultar Private Location Data for AI Map Workflows, How to Build a Map-Aware AI Assistant y Spatial AI for Multi-Location Businesses. Los equipos que ya vinculan conversaciones a un mapa existente pueden pasar directamente al mapeo de Kaleidr; los equipos que aún nombran la propiedad de la fuente deben comenzar por comprender el significado de "basado en datos".
Aspectos esenciales de la IA espacial basada en datos
- Los datos permanecen en manos de los propietarios: El inventario, las políticas, los precios y los permisos nunca provienen de la invención del modelo.
- El espacio se calcula: La distancia, la ruta, la contención y el tiempo de viaje pertenecen a los servicios geoespaciales.
- Autorizar antes de recuperar: El modelo no es el motor de permisos.
- Elegibilidad antes de la clasificación: Los registros cerrados, vacíos, fuera de área o no autorizados se eliminan primero del conjunto.
- Medir la tarea: La selección válida, la transferencia y la geografía sin resultados superan la duración del chat por sí solas.
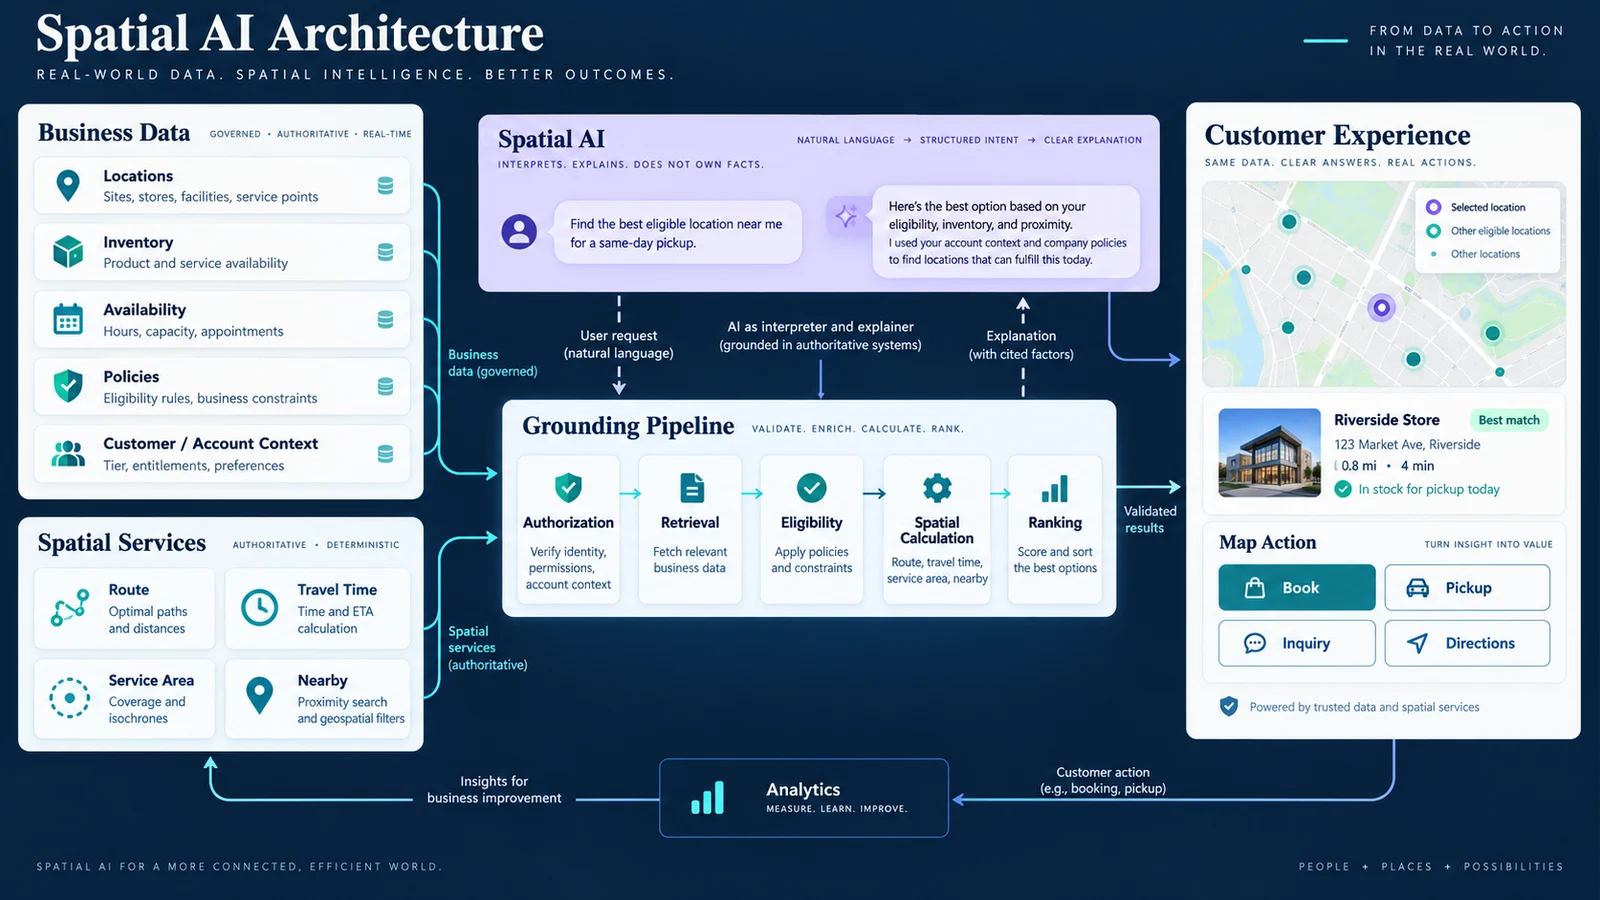
La IA espacial basada en datos funciona cuando el modelo interpreta la solicitud, mientras que los sistemas empresariales y geoespaciales conservan la autoridad en cuanto a los datos.
¿Por qué la IA espacial basada en datos es un problema de arquitectura empresarial?
Un asistente genérico puede responder preguntas generales sobre lugares públicos. Un producto empresarial debe responder qué tienda puede gestionar una recogida, qué restaurante asociado sigue abierto después de un evento, qué establecimiento sigue activo con restricciones de tiempo de desplazamiento o qué proveedor puede atender una dirección en el horario solicitado. Estas respuestas dependen del inventario, el horario, el área de servicio, el estado del establecimiento, la elegibilidad del socio, los permisos de la cuenta y el estado operativo. Un modelo de lenguaje no debería inventar estos campos a partir de la memoria de entrenamiento.
Kaleidr describe actualmente cómo conectar datos empresariales, información de ubicación y sistemas existentes para que la IA espacial pueda trabajar con los recursos ya existentes de una empresa, y describe una base de conocimiento empresarial basada en la ubicación para las respuestas de la IA (Kaleidr, 2026). La página AI Map Chat for Customer Discovery presenta el chat con reconocimiento de ubicación como un sistema que fundamenta las recomendaciones en los lugares, el inventario y las reglas de negocio del anfitrión. Estas páginas son la fuente autorizada del posicionamiento de Kaleidr. Sin embargo, no demuestran que Kaleidr opere un registro de inventario, CRM, registro de horas o directorio de franquicias propios.
Es importante diferenciar tres problemas relacionados. El artículo sobre ubicaciones privadas aborda la autorización y la minimización de registros que el anfitrión no expone públicamente. El artículo sobre el asistente con reconocimiento de mapas aborda el estado compartido del mapa y las acciones validadas en el mapa. La guía para múltiples ubicaciones abarca los identificadores canónicos, la elegibilidad y la clasificación en una red de sucursales. Esta guía constituye la arquitectura de la fuente de información que comparten estos enfoques: evidencia actual, cálculo espacial determinista y un paquete de contexto compacto que el modelo puede explicar sin necesidad de poseer los datos.
¿Qué significa "fundamentado en datos fiables" en esta arquitectura?
Una respuesta basada en datos es aquella cuyas afirmaciones de respaldo provienen de fuentes aprobadas disponibles para la aplicación en el momento de la solicitud. Cuando un cliente pregunta qué tienda cerca de Union Square tiene una chaqueta en talla mediana, el producto debe resolver el SKU y la talla, recuperar las tiendas elegibles, consultar el inventario actual, calcular la relación geográfica con el origen especificado, clasificar las tiendas válidas y solo entonces permitir que el modelo explique el resultado en el mismo mapa. La redacción puede ser coloquial. El registro de existencias y el cálculo de la distancia deben provenir de sistemas que puedan respaldar la afirmación.
"Basado en datos" es una arquitectura de aplicación, no una solicitud más amplia. El modelo interpreta la intención y define la pregunta que los sistemas deben responder. Los responsables del inventario, la política, la disponibilidad y el enrutamiento siguen siendo los sistemas de registro. Si ninguna fuente es responsable de una afirmación, se debe preguntar si el producto debería realizarla.
La siguiente tabla de propiedad es editorial, no un esquema documentado de Kaleidr. Úsela para mantener los límites de las fuentes visibles. Las implementaciones reales deben completar las mismas columnas con datos de los sistemas que ya ejecuta el host.
| Afirmación | Fuente autorizada Artículo en stock Sistema de inventario El registro comienza a una hora determinada Sistema de políticas Listado activo Sistema de listados El proveedor presta servicio en esta zona Sistema de área de servicio Coordenadas Fuente de ubicación aprobada Tiempo de viaje Servicio de enrutamiento El usuario puede ver el registro Identidad / autorización ¿Por qué esta opción ocupa el primer lugar? Explicación de IA de lo anterior ¿En qué se diferencia la georreferenciación del ajuste fino, la generación aumentada de registros (RAG) y las indicaciones? Los equipos suelen combinar cuatro tareas diferentes en una sola palabra. La georreferenciación proporciona información espacial y empresarial actualizada en el momento de la solicitud. La generación aumentada de registros recupera registros o documentos relevantes y puede ser una técnica de georreferenciación. El ajuste fino modifica el comportamiento del modelo o el estilo de salida a partir de ejemplos. Las indicaciones proporcionan instrucciones en tiempo de ejecución y contexto de la tarea. El inventario en tiempo real, la disponibilidad, el estado del listado, las reglas del área de servicio y el tiempo de viaje actual deben formar parte de la información actual, no de la memoria del modelo. La fundamentación, la generación aumentada por recuperación, el ajuste fino y las indicaciones se diferencian según aporten evidencia actual, recuperen contexto, alteren el comportamiento del modelo o proporcionen instrucciones en tiempo de ejecución. |
|---|---|
| Fuente autorizada | El artículo está en stock. |
| Sistema de inventario | Sistema de políticas |
| El anuncio está activo. | Sistema de listado |
| Sistema de listado | El proveedor presta sus servicios en esta zona. |
| Coordenadas | Fuente del lugar aprobado |
| Tiempo de viaje | Servicio de enrutamiento |
| El usuario puede ver el registro | Identidad / autorización |
| ¿Por qué esta opción ocupó el primer lugar? | Explicación de IA de lo anterior |
¿En qué se diferencia la fundamentación del ajuste fino, RAG y las indicaciones?
Los equipos suelen combinar cuatro tareas distintas en una sola. La fundamentación proporciona información espacial y empresarial actualizada en el momento de la solicitud. La generación aumentada por recuperación recupera registros o documentos relevantes y puede ser una técnica de fundamentación. El ajuste fino modifica el comportamiento del modelo o el estilo de salida a partir de ejemplos. La solicitud proporciona instrucciones en tiempo de ejecución y el contexto de la tarea. El inventario en tiempo real, la disponibilidad, el estado de los listados, las reglas del área de servicio y el tiempo de viaje actual deben estar en la evidencia actual, no en la memoria del modelo.
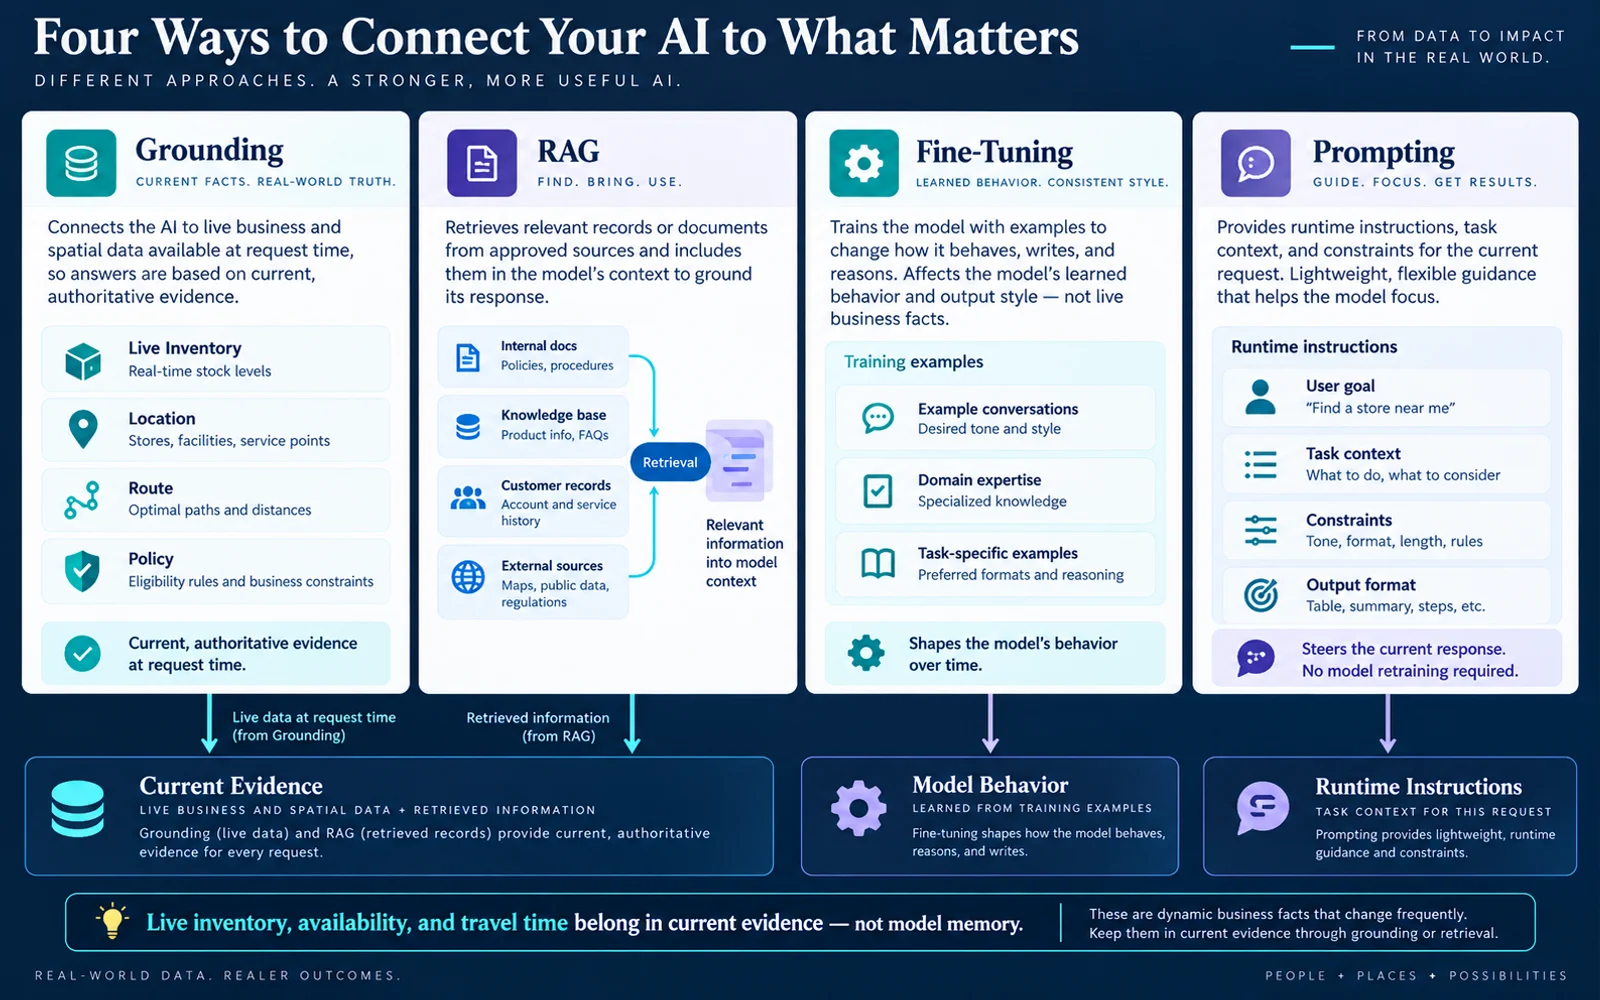
La geolocalización es una arquitectura de aplicación para la evidencia actual; no es sinónimo de ajuste fino ni de una solicitud más extensa.
RAG es útil para el texto de políticas, descripciones de servicios y guías de marca. Los campos estructurados, como el recuento de existencias, el estado, el precio, el estado de apertura y el polígono del área de servicio, deben permanecer escritos para que los filtros se ejecuten antes de cualquier clasificación. El ajuste fino puede ayudar a definir el tono y la estructura de la salida. Generalmente, el ajuste fino no es la fuente de información fiable para un dato que cambió esta misma tarde. Las solicitudes pueden limitar la forma en que el asistente se comunica. Sin embargo, las solicitudes por sí solas no convierten un dato en una autoridad.
¿Por qué la fundamentación espacial necesita su propia capa?
Un asistente de negocios puede basarse en documentos y aun así cometer errores espaciales. Dos tiendas pueden tener inventario, pero solo una es accesible antes de la siguiente parada. Un modelo de lenguaje no debería estimar esa relación a partir de las descripciones de las tiendas. La aplicación necesita un servicio geoespacial que pueda tomar el origen, el destino, el modo de transporte y la red, y devolver una relación de viaje que el cliente pueda consultar.
La IA espacial basada en datos combina la información empresarial con la información espacial. Los datos empresariales describen la información real sobre el candidato. La capa geoespacial indica cómo se relacionan los candidatos en el espacio. Un límite importante es que la IA elige la pregunta y los servicios espaciales calculan la relación. Place Ranking API abarca la clasificación de las ubicaciones elegibles restantes después de que se hayan realizado estos cálculos, incluso cuando la siguiente parada ya está en el trayecto.
¿Qué registros canónicos debe usar la fundamentación?
La IA espacial basada en datos necesita identidades estables. Cada ubicación, anuncio, SKU, servicio o proveedor debe mantener una identificación duradera que se comparta en la base de datos empresarial, el marcador del mapa, el contexto de la IA, el análisis y la transferencia de la reserva o recogida. No se debe tratar el nombre de usuario como identidad. Los datos de la organización, como la voz de la marca y la política de la empresa, se pueden heredar. Los datos de la ubicación, como el horario, el inventario local y la elegibilidad para la recogida, deben permanecer en la sucursal. Una tercera capa, el estado operativo, almacena el inventario, la capacidad y los cierres temporales con una marca de tiempo de actualización explícita, ya que el stock del día anterior no es un factor de clasificación.
Normalice las coordenadas, las horas, los valores de estado, las unidades y las etiquetas de categoría antes de la solicitud para que se puedan ejecutar los filtros deterministas. Las entidades tipadas impiden que un ID de tienda se trate como un ID de producto, o que un edificio se trate como un listado. La lista exacta de campos es específica de cada producto. El compromiso esencial establece un ID por lugar, además de la propiedad explícita de la fuente para cada afirmación que el asistente puede realizar.
¿Por qué la recuperación debe seguir a la autorización?
El patrón peligroso consiste en recuperar una gran cantidad de datos comerciales, proporcionárselos al modelo y preguntarle qué puede ver el usuario. El orden más seguro es autenticar, resolver el inquilino, autorizar objetos y campos, recuperar lo mínimo necesario y, a continuación, proporcionar solo ese paquete al modelo. Un usuario puede tener permiso para ver la ubicación de un proveedor, pero no el margen interno. La capa de recuperación debe descartar el segundo campo antes de que el contexto cruce el límite de la IA.
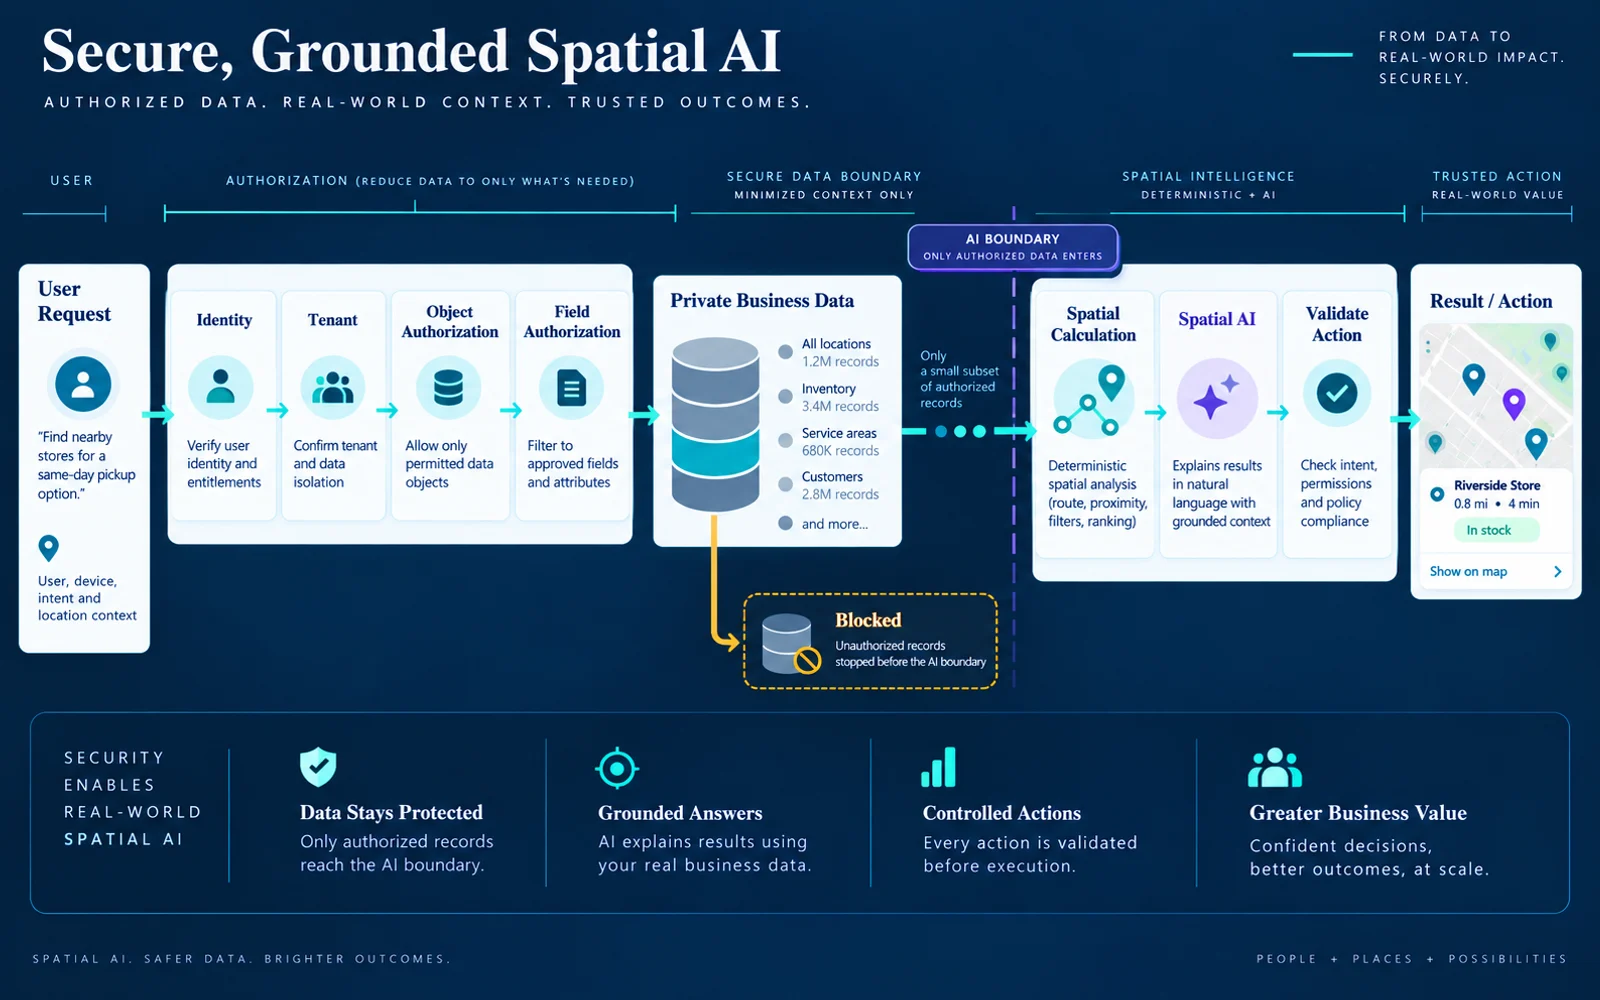
El modelo nunca debe ser el componente que decide qué información puede recuperar un usuario; la autorización debe preceder al límite del contexto de IA.
Actualmente, Kaleidr documenta una separación entre las claves publicables del navegador y las claves del servidor, e indica que una clave publicable presentada como portadora se rechaza (Kaleidr, 2026). La misma documentación describe un ámbito vendor que permite al chat consultar los datos de la organización cargados que el anfitrión haya decidido exponer en esa interfaz, y advierte que una clave publicable no es el lugar adecuado para las tarifas ni para ninguna otra información que el anfitrión no publicaría. Considere esta separación como el contrato de credenciales públicas. El inventario del anfitrión, las ubicaciones no publicadas y los registros de clientes siguen estando sujetos a la autorización del propio anfitrión, no dentro de una solicitud.
La vista del mapa forma parte de la solicitud, no de una concesión de permisos. Un recurso privado de un administrador que se encuentra a la vista no debe entrar en el contexto de IA de otro usuario simplemente porque la cámara se haya movido. Los puntos finales de chat actuales documentan campos como location, map_zoom, idioma y contexto de sesión (Kaleidr, 2026). Estos campos mantienen la conversación vinculada al mapa. El contexto del mapa no reemplaza la autorización de objetos y campos.
¿Cómo deben mantenerse separados la elegibilidad, la clasificación y la explicación?
Las restricciones estrictas son binarias y corresponden a los responsables de la ubicación, el inventario y la ruta antes de la clasificación. Si el producto está cerrado, sin existencias para la variante solicitada, fuera del área de servicio, inactivo, le falta un servicio requerido o le falta autorización, se debe descartar al candidato. Si se consideran preferencias flexibles, como un trayecto ligeramente más corto, se clasifica el conjunto de opciones válidas restantes. La justificación responde a las preguntas sobre lo que es cierto. La clasificación responde a la pregunta sobre qué opción válida se ajusta a la solicitud. La explicación justifica la existencia de la lista de preseleccionados.
El modelo de lenguaje puede convertir una solicitud como «encontrar este artículo para recoger hoy de camino a casa» en campos inspeccionables: origen, artículo, requisito de estado de apertura, modo de recogida y límite de tiempo de viaje. Estos campos son consultas a los sistemas que ya poseen la información. No le pida al modelo que invente minutos de viaje después de que el cliente ya haya especificado la restricción. No priorice un producto estrella cerrado solo porque sea más conocido. Revalide el inventario, la disponibilidad y el horario antes de una acción de alto impacto, como reservar, comprar o recoger, ya que la información de la recomendación puede quedar obsoleta mientras el cliente compara opciones.
Un paquete de contexto compacto debe contener solo la lista reducida que el cliente puede usar, con el origen y la actualidad conocidos por la aplicación, incluso cuando no se muestren todos los campos de metadatos al modelo. Incluir toda la base de datos en la solicitud genera fugas de memoria, latencia, registros obsoletos y una superficie de depuración inaccesible. La minimización es un control de seguridad y un control del producto.
¿Dónde encaja Kaleidr en una arquitectura fundamentada en datos fiables?
Una implementación de Kaleidr puede adjuntar una capa espacial conversacional a un mapa y una pila de ubicaciones que el anfitrión ya utiliza. Actualmente, Kaleidr documenta Chat como un producto que se superpone a un mapa que el anfitrión ya renderiza, traza lugares resueltos y ajusta la cámara a medida que la conversación resuelve ubicaciones, con detección automática para Mapbox, MapLibre, Google Maps y Leaflet (Kaleidr, 2026). El contrato de adjuntar confirma que la conversación con reconocimiento de mapas existe en la interfaz pública actual para desarrolladores. La misma documentación no promete un catálogo de inventario nativo, un motor de reservas ni un feed de horarios.
La lista actual de API públicas de la plataforma incluye intercambio de sesiones SDK, chat en tiempo real, rutas, enriquecimiento de puntos de interés (POI) y puntos de conexión de diseño. Actualmente, la lista no publica una ruta universal para la carga de conocimiento, un índice RAG ni la conexión de inventario. Las páginas de productos de Kaleidr describen la conexión de lugares y la integración de la IA en el inventario y las políticas empresariales; se debe confirmar la ruta de integración para la implementación en lugar de tratar el texto de marketing como una API de ingesta. La página How to Add AI Chat to Mapbox, Google Maps, and MapLibre cubre los pasos de conexión específicos del renderizador. La página Location Intelligence APIs and Map SDK describe actualmente los SDK, la clasificación y el análisis para productos espaciales. La documentación para desarrolladores debe considerarse el contrato de integración; las páginas de marketing describen el caso de uso, no la lista de fuentes de inventario. Las acciones de mapas semánticos, como enfocar, mostrar candidatos o mostrar una ruta, deben ser propuestas por el asistente y validadas por el host con respecto a los ID y permisos antes de que el renderizador las ejecute. La salida en lenguaje natural no debe ejecutar código arbitrario del mapa. El estado compartido de mapas, listas y chat debe mantener un ID de ubicación canónico para que preguntar qué está más cerca mantenga las mismas reglas de elementos y horarios.
Las acciones del mapa semántico, como enfocar, mostrar candidatos o mostrar una ruta, deben ser propuestas por el asistente y validadas por el anfitrión con respecto a los ID y permisos antes de que el renderizador las ejecute. La salida en lenguaje natural no debe ejecutar código arbitrario del mapa. El estado compartido del mapa, la lista y el chat debe mantener un ID de ubicación canónico, de modo que preguntar qué está más cerca mantenga las mismas reglas de elementos y horarios.
La geolocalización no es exclusiva de la cartografía. Google Cloud documenta actualmente la búsqueda personalizada sobre conjuntos de datos empresariales estructurados, como catálogos de hoteles, listados inmobiliarios y directorios de restaurantes, y describe por separado la generación de respuestas de IA geolocalizada a partir de datos conectados (Introduction to custom search, 2026). Para la IA espacial, el requisito adicional es el cálculo geográfico. Esa página de Google Cloud describe el producto de búsqueda propio de Google. La página no es un conector de Kaleidr.
¿Cómo deben evaluar los equipos la IA espacial fundamentada en datos fiables?
Una respuesta fluida aún puede ser incorrecta. Mida la corrección de la recuperación, la corrección de la autorización, la corrección de las reglas de negocio, la corrección espacial, la fidelidad de la explicación, la validez de la acción y la actualidad como comprobaciones independientes. Un sistema geolocalizado debería, en ocasiones, no devolver ninguna opción válida. En muchos flujos de trabajo B2B, un falso positivo es más perjudicial que la ausencia de resultados. Registre motivos estructurados para la ausencia de resultados, como "cerrado ahora", "sin existencias", "fuera de la zona", "demasiado lejos", "horario desconocido" o "no autorizado", en lugar de un simple indicador de fallo.
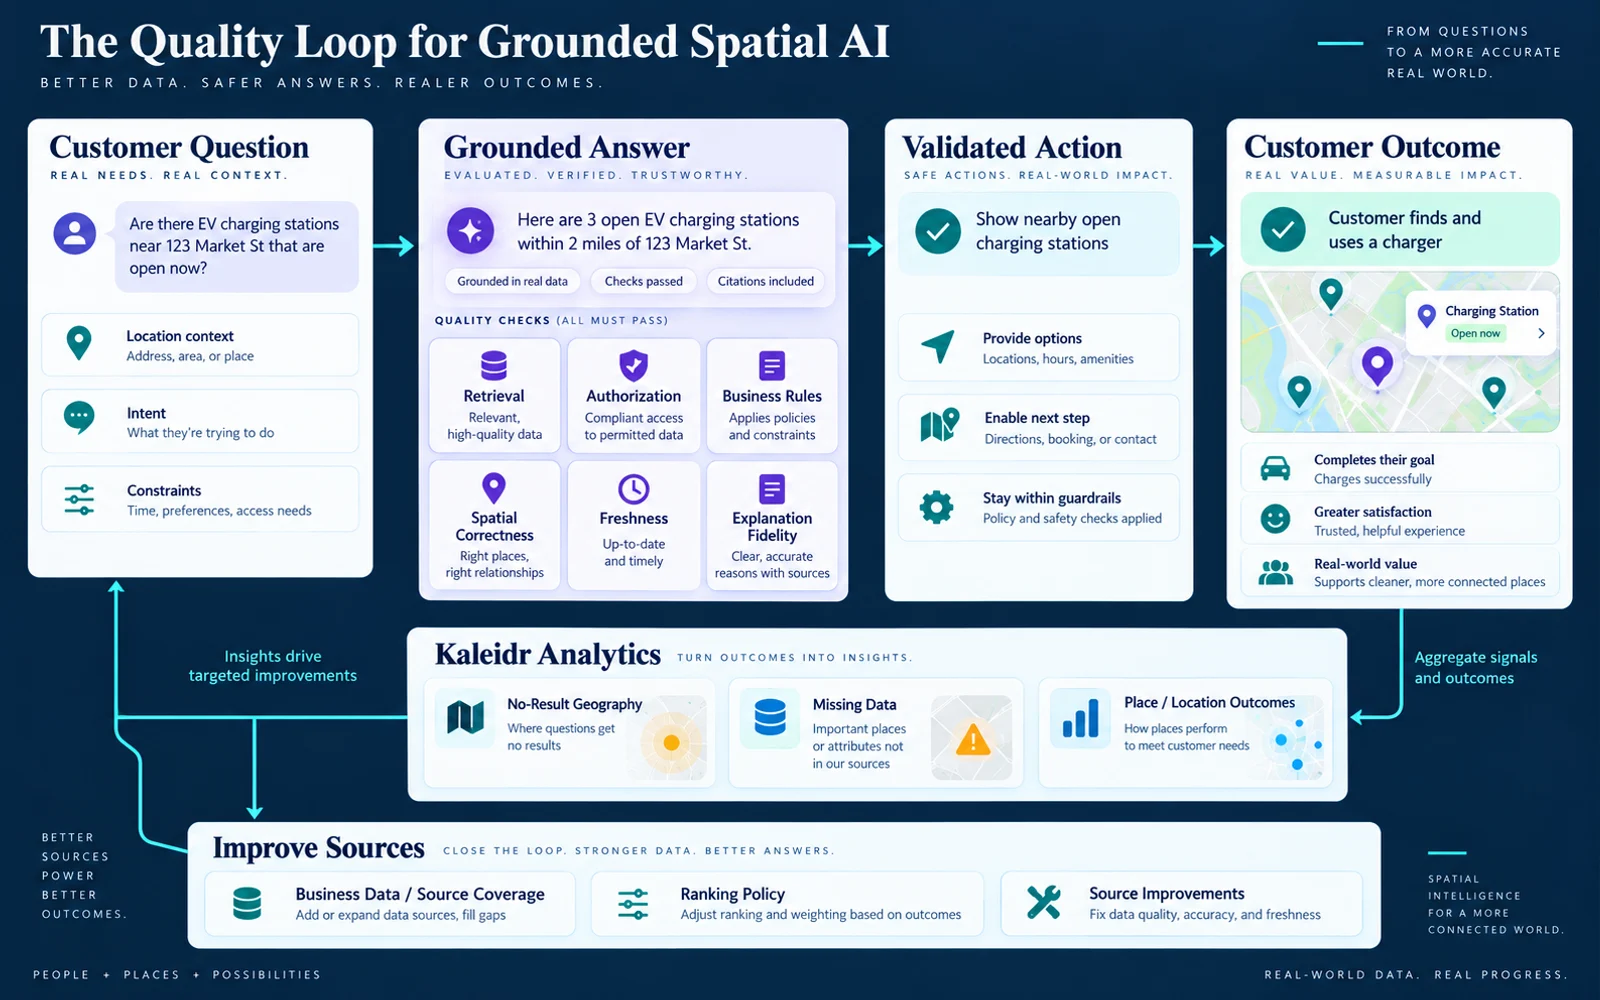
La calidad del análisis de datos es medible: la corrección fáctica y espacial debe estar vinculada a la acción del cliente que el producto está diseñado para mejorar.
Actualmente, OWASP identifica la inyección de mensajes como un riesgo importante para las aplicaciones de modelos de lenguaje y afirma que la optimización de la recuperación y el ajuste fino no la previenen por completo (LLM01:2025 Prompt Injection). Se debe tratar la entrada del usuario y el contenido recuperado como potencialmente no confiables. OWASP también documenta debilidades en vectores e incrustaciones, incluyendo contenido de recuperación contaminado, fugas entre inquilinos y acceso no autorizado a incrustaciones (LLM08:2025 Vector and Embedding Weaknesses). El análisis de datos requiere confianza en la fuente, partición de inquilinos y validación de acciones por parte del host, no solo un conjunto de recuperación más amplio. El NIST publicó el Perfil de Inteligencia Artificial Generativa en julio de 2024 como complemento del Marco de Gestión de Riesgos de IA para la confiabilidad a lo largo del ciclo de vida de la IA (Generative Artificial Intelligence Profile, 2024). Evalúe la fundamentación como parte de ese sistema más amplio, no como un simple cambio de veracidad.
Kaleidr Analytics actualmente documenta la interacción con mapas y lugares, la comparación de lugares, los patrones espaciales y la actividad sobre la que los equipos de producto, inventario y crecimiento pueden actuar (Kaleidr, 2026). Los sistemas anfitriones aún gestionan el inventario y las reservas. Utilice este bucle para encontrar códigos postales con búsquedas de productos en stock y sin sucursales elegibles, franjas horarias de viaje donde se pierde el cliente y mercados con demanda y campos incompletos. Estas preguntas son geográficas, no se basan en las visitas a la página. Spatial Analytics vs. Web Analytics explica por qué las visitas a la página por sí solas no pueden responderlas. Los nombres de eventos sugeridos en este artículo son recomendaciones editoriales, no nombres de eventos automáticos documentados por Kaleidr Analytics.
¿Cómo debería comenzar un proyecto piloto de IA espacial fundamentada?
Comience con una tarea de alto valor, como recomendar una ubicación de recogida disponible en el camino del trabajo a casa dentro de una misma área metropolitana. Mantenga el directorio de ubicaciones, los horarios y el inventario en los sistemas que ya los gestionan. Integre la interacción conversacional del mapa al mapa existente. Limite los candidatos a las sucursales autorizadas, requiera el estado de apertura y el stock del artículo solicitado, calcule el tiempo de viaje desde el origen indicado, vuelva a validar antes de la recogida y mida la selección, además de la acción posterior del proveedor. Amplíe las categorías, ciudades y franquicias solo cuando la primera ventana funcione correctamente.
El descubrimiento conversacional no reemplaza la calidad del catálogo, la actualización de los horarios ni la disciplina de cumplimiento. Los tiempos de viaje siguen siendo estimaciones. La fiabilidad de las afirmaciones de stock depende de la fuente de inventario que las respalda. Integrar un asistente a un mapa existente suele ser más económico que reemplazar el motor de renderizado, pero el proveedor aún debe gestionar la autorización, los contratos con los proveedores y la siguiente acción comercial. Considere los datos faltantes como desconocidos en lugar de como un error, e implemente la funcionalidad por mercado en lugar de todos los conjuntos de datos a la vez.
Explore Kaleidr Spatial AI para agregar búsqueda de ubicación conversacional a un mapa existente. Explore Kaleidr Enterprise para integrar SDK y clasificación a la plataforma que ya utiliza. Explore Kaleidr Analytics para medir la interacción con los lugares y la demanda geográfica en torno a ese recorrido. Confirme las páginas públicas actuales antes de considerar cualquier ejemplo de este artículo como un compromiso funcional de producción.
Preguntas frecuentes
¿Qué es la IA espacial basada en datos?
La IA espacial basada en datos utiliza datos comerciales actuales y aprobados, así como cálculos geográficos deterministas, para brindar respuestas de IA sobre lugares, inventario, disponibilidad, elegibilidad y viajes. El modelo de lenguaje interpreta y explica la solicitud; los sistemas comerciales y geoespaciales siguen siendo la fuente autorizada de los datos.
¿Es la fundamentación lo mismo que RAG?
No. La generación aumentada por recuperación (RAG) es una técnica de fundamentación. Un sistema de IA espacial en producción también puede utilizar consultas estructuradas, autorización, reglas comerciales, clasificación, enrutamiento, cálculos geométricos y API operativas en tiempo real.
¿Es la fundamentación lo mismo que el ajuste fino?
No. El ajuste fino modifica el comportamiento del modelo. La fundamentación proporciona evidencia actualizada en tiempo de ejecución. Los datos que cambian rápidamente, como el inventario y la disponibilidad, deben permanecer en los sistemas empresariales autorizados.
¿Debo cargar toda mi base de datos empresarial en un modelo?
No. Recupere solo los registros y campos autorizados necesarios para la tarea. Minimice el contexto antes de que llegue al modelo.
¿Quién debe ser responsable del inventario y la disponibilidad?
El sistema empresarial anfitrión debe seguir siendo la fuente autorizada de datos operativos como inventario, disponibilidad, precio, estado de la publicación o capacidad del proveedor.
¿Quién debe calcular la distancia y el tiempo de viaje?
Utilice un servicio geoespacial o de enrutamiento adecuado. El asistente puede interpretar qué relación es relevante y explicar el resultado, pero no debe inventar cálculos espaciales exactos.
¿Puede una IA fundamentada seguir alucinando?
Sí. La validación reduce las respuestas no respaldadas, pero no elimina los errores del modelo. Las aplicaciones deben validar las salidas estructuradas, restringir las acciones, evaluar la fidelidad de la explicación y admitir el comportamiento sin resultado.
¿Evita RAG la inyección de prompts?
No. OWASP señala que RAG y el ajuste fino no mitigan completamente la inyección de mensajes. La recuperación, los permisos de las herramientas y las acciones del modelo aún requieren controles de seguridad a nivel de aplicación.
¿Puede Kaleidr usar el inventario y las políticas empresariales?
La página actual de IA de Kaleidr describe recomendaciones basadas en los lugares, el inventario y las reglas de negocio del host. La ruta exacta de integración de datos depende de la implementación y debe confirmarse para el caso de uso empresarial.
¿Publica Kaleidr una API genérica para la ingesta de bases de conocimiento?
La documentación actual de la API de la plataforma pública no incluye una carga de conocimiento universal, un índice RAG ni un punto final arbitrario para la ingesta de bases de datos empresariales. Documenta las sesiones del SDK, el chat, el enrutamiento, el enriquecimiento de puntos de interés y los puntos finales de diseño.
¿Puede Kaleidr integrar IA basada en datos en un mapa existente?
Sí. La documentación actual de integración de chat pública describe cómo integrar conversaciones en un mapa que el host ya renderiza, incluyendo Mapbox, MapLibre, Google Maps y Leaflet. El anfitrión sigue siendo propietario del catálogo de ubicaciones y de la siguiente acción comercial.
¿Cómo se debe medir la IA espacial basada en datos?
La precisión en la recuperación de datos, la precisión en la autorización, el cumplimiento de las reglas de negocio, la precisión espacial, la fidelidad de las explicaciones, la actualidad de la información, la precisión en la ausencia de resultados, las acciones válidas y los resultados de negocio posteriores son indicadores clave. El volumen de chat por sí solo no es un indicador de éxito suficiente.
Referencias
- Kaleidr. Build Your Own Spatial AI with Kaleidr. Accessed 13 September 2026. https://kaleidr.com/
- Kaleidr. AI Map Chat for Customer Discovery. Accessed 13 September 2026. https://kaleidr.com/ai
- Kaleidr. Auth & scopes. Developer documentation. Accessed 13 September 2026. https://docs.kaleidr.com/platform-api/auth-and-scopes
- Kaleidr. Endpoints. Developer documentation. Accessed 13 September 2026. https://docs.kaleidr.com/platform-api/endpoints
- Kaleidr. Chat attach. Developer documentation. Accessed 13 September 2026. https://docs.kaleidr.com/sdk/chat-attach
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed 13 September 2026. https://kaleidr.com/enterprise
- Kaleidr. Map Engagement and Location Analytics. Accessed 13 September 2026. https://kaleidr.com/analytics
- OWASP Gen AI Security Project. LLM01:2025 Prompt Injection. Accessed 13 September 2026. https://genai.owasp.org/llmrisk/llm01-prompt-injection/
- OWASP Gen AI Security Project. LLM08:2025 Vector and Embedding Weaknesses. Accessed 13 September 2026. https://genai.owasp.org/llmrisk/llm082025-vector-and-embedding-weaknesses/
- Google Cloud. Introduction to custom search. Accessed 13 September 2026. https://docs.cloud.google.com/generative-ai-app-builder/docs/about-generic-search
- NIST. Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile. Published 26 July 2024. Accessed 13 September 2026. https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence
@misc{kaleidr_home_grounded_2026_09_13,
  title  = {Build Your Own Spatial AI with Kaleidr},
  author = {{Kaleidr}},
  note   = {Accessed 13 September 2026},
  url    = {https://kaleidr.com/}
}

@misc{kaleidr_ai_grounded_2026_09_13,
  title  = {AI Map Chat for Customer Discovery},
  author = {{Kaleidr}},
  note   = {Accessed 13 September 2026},
  url    = {https://kaleidr.com/ai}
}

@misc{kaleidr_auth_grounded_2026_09_13,
  title  = {Auth \& scopes},
  author = {{Kaleidr}},
  note   = {Developer documentation; accessed 13 September 2026},
  url    = {https://docs.kaleidr.com/platform-api/auth-and-scopes}
}

@misc{kaleidr_endpoints_grounded_2026_09_13,
  title  = {Endpoints},
  author = {{Kaleidr}},
  note   = {Developer documentation; accessed 13 September 2026},
  url    = {https://docs.kaleidr.com/platform-api/endpoints}
}

@misc{kaleidr_chat_attach_grounded_2026_09_13,
  title  = {Chat attach},
  author = {{Kaleidr}},
  note   = {Developer documentation; accessed 13 September 2026},
  url    = {https://docs.kaleidr.com/sdk/chat-attach}
}

@misc{kaleidr_enterprise_grounded_2026_09_13,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  note   = {Accessed 13 September 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_analytics_grounded_2026_09_13,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  note   = {Accessed 13 September 2026},
  url    = {https://kaleidr.com/analytics}
}

@misc{owasp_llm01_prompt_injection_2025,
  title  = {LLM01:2025 Prompt Injection},
  author = {{OWASP Gen AI Security Project}},
  note   = {Accessed 13 September 2026},
  url    = {https://genai.owasp.org/llmrisk/llm01-prompt-injection/}
}

@misc{owasp_llm08_vector_embedding_2025,
  title  = {LLM08:2025 Vector and Embedding Weaknesses},
  author = {{OWASP Gen AI Security Project}},
  note   = {Accessed 13 September 2026},
  url    = {https://genai.owasp.org/llmrisk/llm082025-vector-and-embedding-weaknesses/}
}

@misc{google_cloud_custom_search_2026,
  title  = {Introduction to custom search},
  author = {{Google Cloud}},
  note   = {Accessed 13 September 2026},
  url    = {https://docs.cloud.google.com/generative-ai-app-builder/docs/about-generic-search}
}

@misc{nist_genai_profile_2024,
  title  = {Artificial Intelligence Risk Management Framework: Generative Artificial Intelligence Profile},
  author = {{National Institute of Standards and Technology}},
  note   = {Published 26 July 2024; accessed 13 September 2026},
  url    = {https://www.nist.gov/publications/artificial-intelligence-risk-management-framework-generative-artificial-intelligence}
}