
La observabilidad de Spatial AI rastrea cómo un sistema consciente de la ubicación pasa de una solicitud a un lugar autorizado, un cálculo geográfico, un resultado ordenado, una acción en el mapa y un resultado en el sistema host. La latencia del modelo y el conteo de tokens pueden mostrar que una llamada terminó. Esos dos números no pueden mostrar que el lugar era elegible ni que el cliente completó la tarea. El registro útil es la ruta de decisión, mantenida lo bastante pequeña como para explicar el resultado sin copiar datos privados de ubicación.
Las secciones siguientes separan la telemetría del sistema de la decisión geográfica, indican qué conviene rastrear y señalan qué debería quedar fuera del registro. Lecturas relacionadas incluyen Spatial AI Accuracy Evaluation y An Enterprise Spatial AI Pilot. Un grafo de servicios saludable todavía puede ocultar un lugar incorrecto.
Elementos esenciales de observabilidad de Spatial AI
- Rastrea la decisión: autorización, recuperación, identidad del lugar, geografía, elegibilidad, ranking, herramientas y resultado del host son spans separados.
- Conserva IDs, no copias: los identificadores de lugar, ruta, política, modelo y acción explican más que los prompts pegados.
- Minimiza el contenido: secretos, registros privados sin procesar y ubicación precisa quedan fuera del almacén de telemetría de forma predeterminada.
- Cuenta las eliminaciones: un total de resultados está incompleto sin la razón por la que cada candidato salió del conjunto.
- Comparte un vocabulario de fallos: los casos offline y los incidentes de producción deben usar las mismas categorías.
¿Qué es la observabilidad de Spatial AI?
Un cliente puede preguntar qué tienda de camino a casa todavía tiene un artículo y estará abierta al llegar. La respuesta depende de identidad, inventario actual, horario, una ruta, reglas de elegibilidad, una política de ranking, una acción en el mapa y de si la persona realmente eligió una tienda. Una traza que termina en la llamada al modelo puede informar tokens y latencia y, aun así, omitir todos esos pasos. Aquí, observabilidad significa que el equipo puede reconstruir la decisión a partir de señales estructuradas, no que se archive cada prompt.
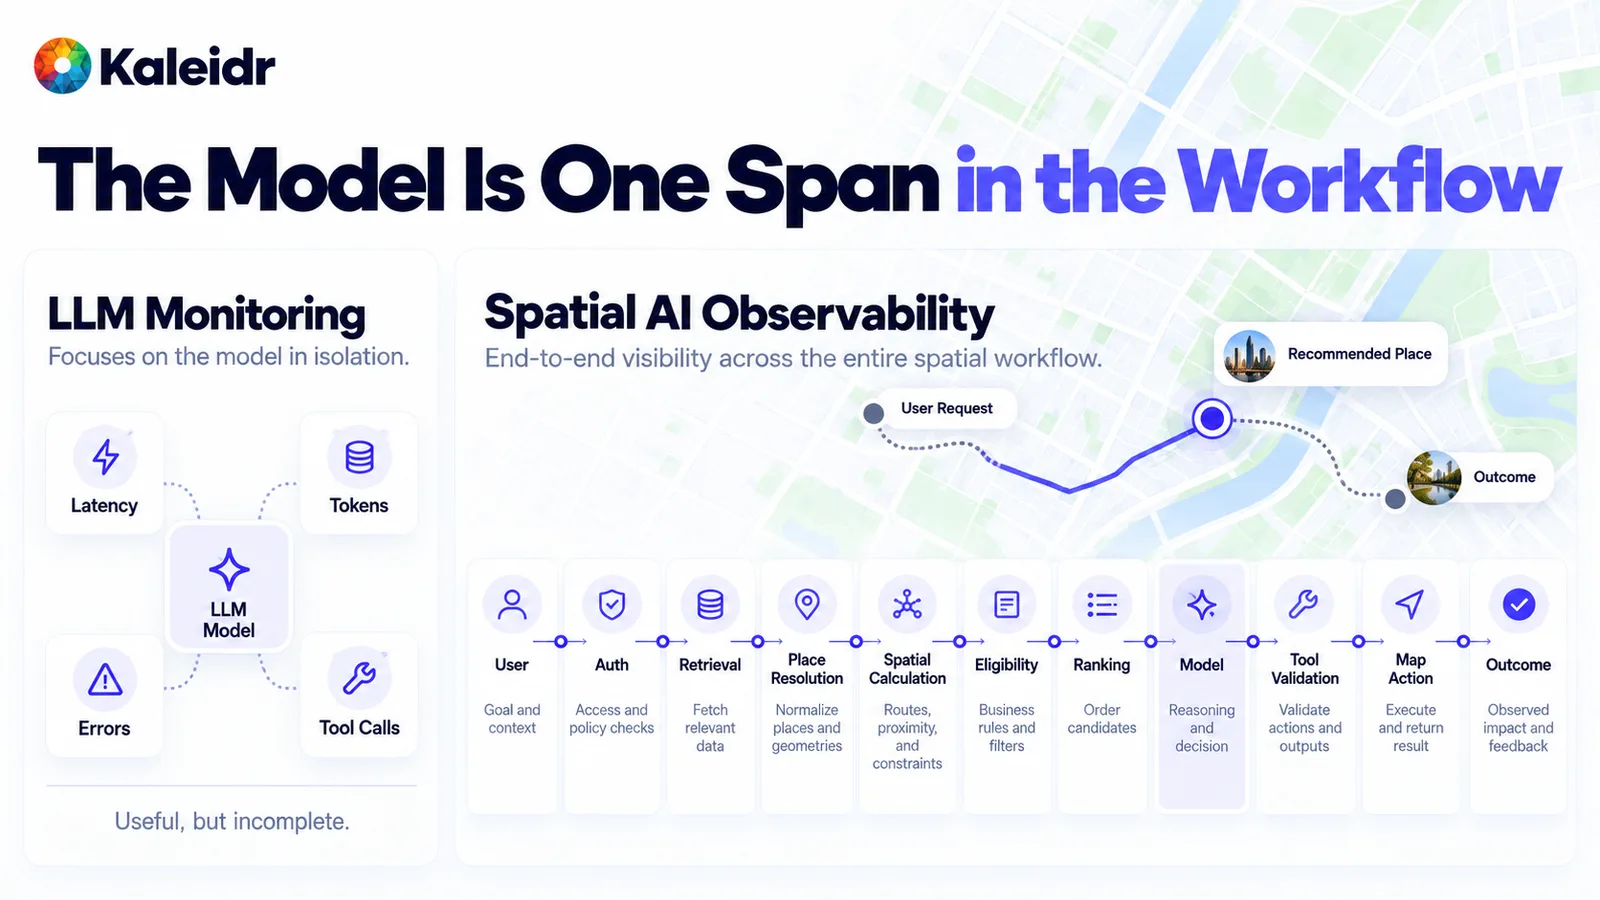
El panel izquierdo observa el modelo de forma aislada. El panel derecho mantiene el modelo como un span entre recuperación, resolución de lugares, elegibilidad, ranking, validación de herramientas y acción en el mapa. La separación es un patrón de observabilidad, no un benchmark de Kaleidr.
Deben encontrarse tres tipos de verdad. La verdad del sistema cubre latencia, errores, reintentos y salud de dependencias. La verdad de decisión cubre qué IDs de lugar fueron autorizados, qué candidatos fallaron una regla estricta, qué ruta se ejecutó y qué acción se validó. La verdad de resultado cubre si se seleccionó un lugar, se abrió una ruta o terminó un flujo de trabajo del host. Un panel con solo el primer tipo puede parecer tranquilo mientras el producto recomienda una tienda cerrada. Un panel con solo interacción del mapa puede parecer muy activo mientras una herramienta costosa reintenta en segundo plano.
¿Qué debe incluir una traza de Spatial AI?
Una solicitud debe llevar un ID de solicitud estable por las etapas que realmente se ejecutaron. La autorización registra la versión de la política y el resultado de permitir o denegar. La recuperación registra la fuente y el número de registros devueltos, no las filas privadas. La resolución de lugares registra los IDs candidatos. El enrutamiento registra un ID de ruta y un estado. La elegibilidad registra cuántos candidatos quedaron y por qué salieron los demás. El ranking registra la versión de la política y los IDs ordenados. El span del modelo registra el proveedor, la etiqueta de versión y el conteo de tokens. La validación de herramientas registra si una acción propuesta fue rechazada o ejecutada. Los eventos de cierre registran un lugar seleccionado y, cuando el host lo informa, un flujo de trabajo completado.
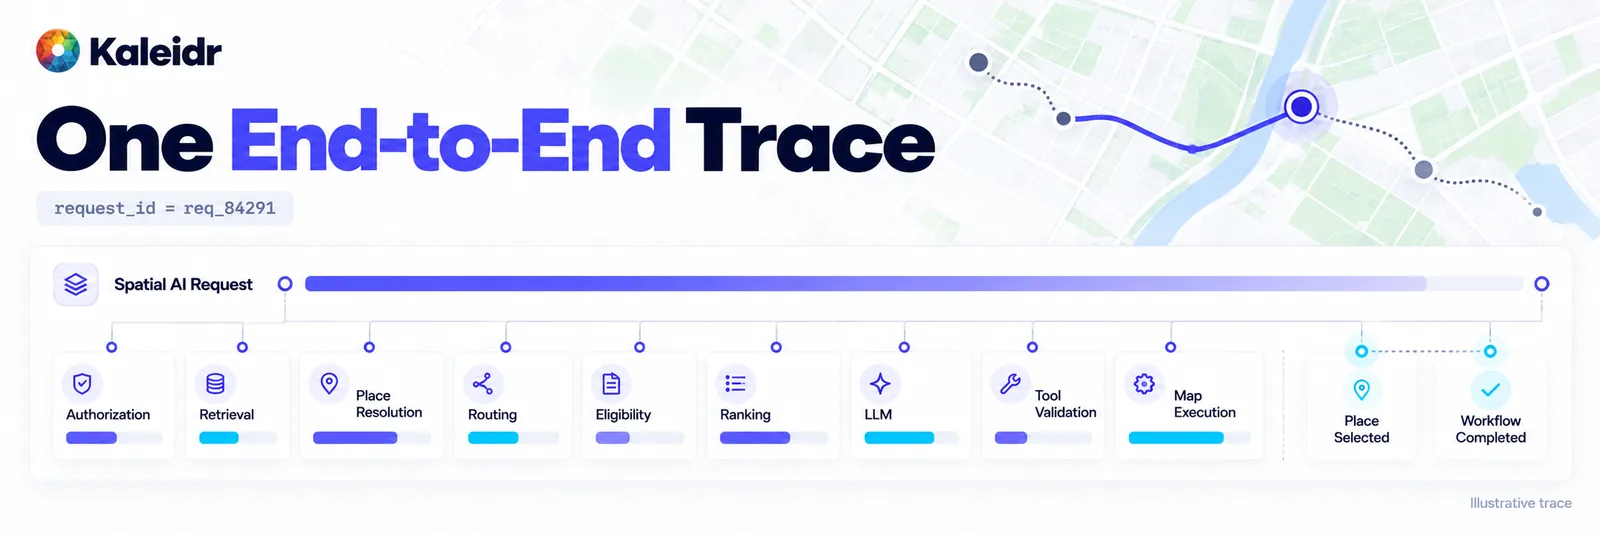
El span padre es la solicitud. Los spans secundarios cubren etapas que pueden fallar de forma independiente, y las marcas finales son lugar seleccionado y flujo de trabajo completado. Las duraciones de la figura son una traza ilustrativa, no latencia medida de Kaleidr.
No todas las solicitudes necesitan todos los spans. Una acción de “mostrar este lugar” puede omitir el ranking. Una recomendación de servicio puede usar toda la cadena. La traza debe indicar qué etapas se ejecutaron y cuáles se omitieron, para que la ausencia de un span de enrutamiento no se confunda con un enrutamiento exitoso. Las etiquetas de versión de la figura, incluido cualquier nombre de modelo impreso en una tarjeta, son metadatos de ejemplo y no un catálogo de modelos de Kaleidr.
¿Cómo deberían separarse trazas, métricas, eventos y logs?
Las trazas responden dónde se fue el tiempo dentro de una solicitud. Las métricas responden si una tasa empeora entre solicitudes, como latencia p95, tasa de ausencia de resultados o tasa de fallos de herramientas. Los eventos responden qué cambió en un momento puntual, como un candidato eliminado, un lugar seleccionado o una acción rechazada. Los logs guardan detalle de diagnóstico que no necesita convertirse en una métrica formal, como una advertencia del parser. Mezclar esos trabajos convierte el almacenamiento caro en el almacenamiento predeterminado.
La guía de eventos de OpenTelemetry traza la misma línea. Las operaciones con duración y un límite significativo pertenecen a spans. Un punto de control, un cambio de estado u otro resultado puntual dentro de una operación más larga es candidato a evento (OpenTelemetry, 2026). Un artículo del 14 de mayo de 2026 de James Newton-King muestra operaciones de IA generativa registradas como trazas, incluidas llamadas al modelo y actividad de herramientas, y señala que el contenido de prompts y los argumentos de herramientas quedan fuera de la telemetría por defecto porque pueden contener datos sensibles (Newton-King, 2026). La documentación de convenciones semánticas, etiquetada como 1.44.0 en la página consultada para este artículo, define nombres compartidos para trazas, métricas y logs (OpenTelemetry, 2026). Atributos espaciales como un ID de conjunto de resultados de lugares o una razón de no-result pueden convivir con esos nombres. Esos nombres espaciales son ejemplos de aplicación, no convenciones espaciales oficiales de OpenTelemetry.
¿Qué debería quedar fuera del almacén de telemetría?
La observabilidad falla si el sistema de telemetría se convierte en una segunda copia de datos de clientes, ubicaciones o negocio. Registra por defecto identificadores, versiones, conteos, estado, latencia y códigos de razón. Trata fragmentos redactados, contenido muestreado y geografía generalizada como condicionales, y solo con una necesidad declarada, un límite de retención y control de acceso. Evita secretos, registros privados sin procesar, prompts completos sin restricciones, coordenadas precisas que la pregunta no necesita y tokens de acceso. Un código de ciudad o mercado suele responder la misma pregunta operativa que una dirección exacta.
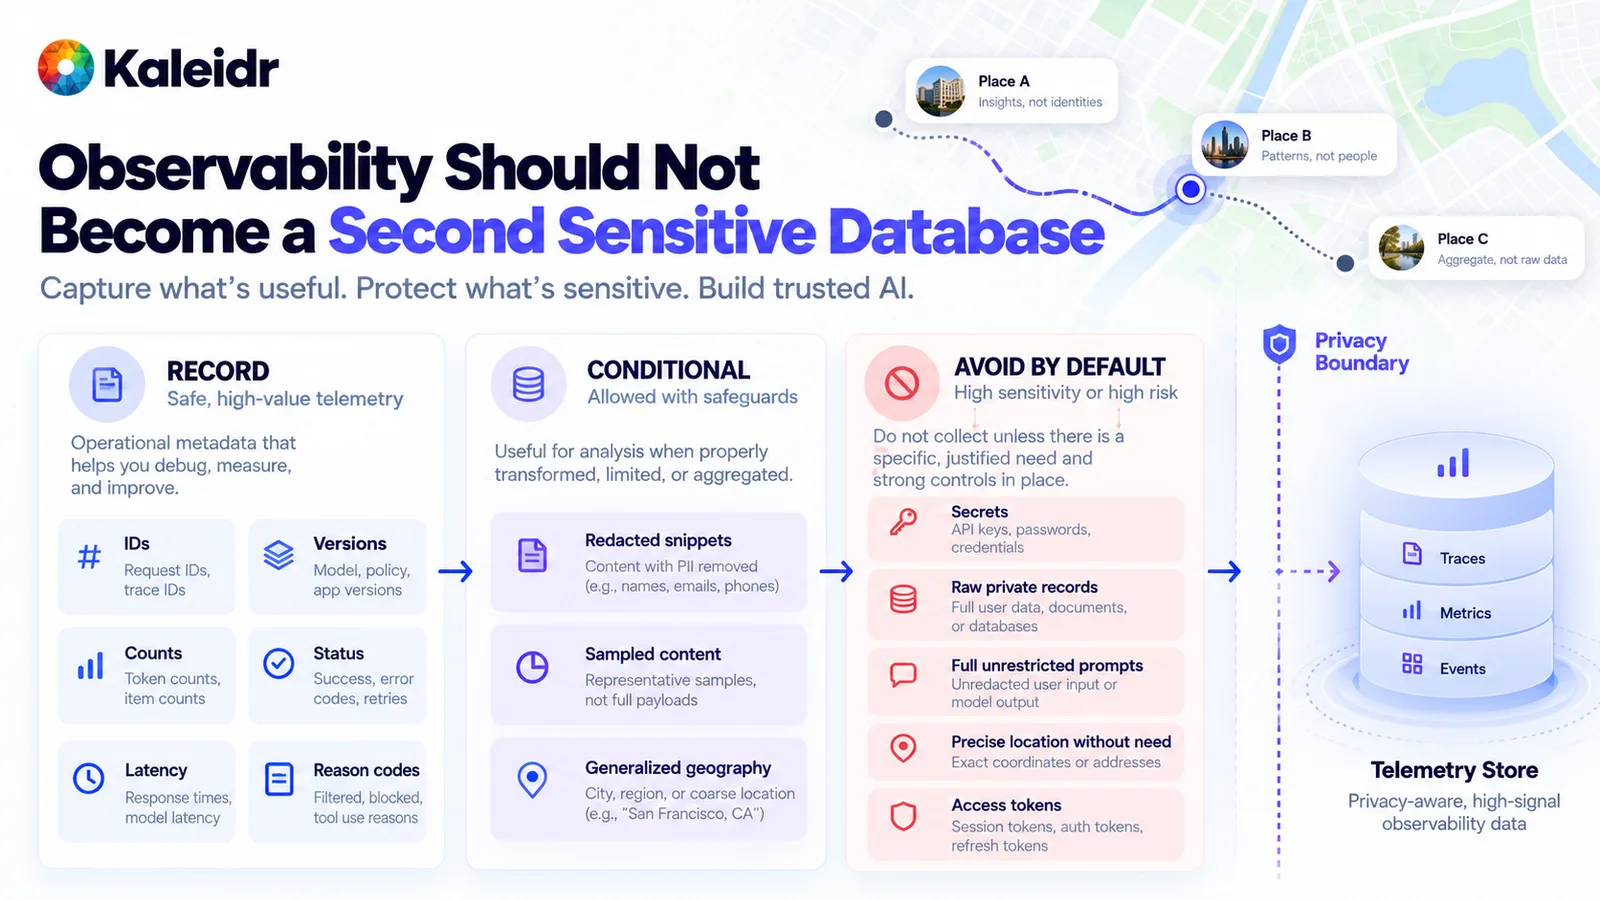
La columna izquierda es el registro predeterminado. La columna central necesita una salvaguarda. La columna derecha queda fuera salvo que un control específico la justifique. La figura es un patrón de minimización, no una certificación.
El registro de atributos de IA generativa de OpenTelemetry advierte que el texto de las consultas de recuperación puede contener información sensible y marca varios atributos que llevan contenido como probables portadores de datos de usuario o personales (OpenTelemetry, 2026). La guía de Kaleidr sobre ubicación privada ya coloca la autorización antes de que el modelo reciba registros y advierte contra subir una base de datos interna sin restricciones (Kaleidr, 2026). Una traza debe conservar ese límite. Registra que la autorización fue aprobada para un ID de conjunto de resultados. No registres las filas privadas que esa comprobación permitió.
¿Por qué registrar por qué desapareció un candidato?
Un solo conteo de resultados no puede explicar una mala recomendación. El embudo útil registra cuántos candidatos se recuperaron, cuántos quedaron después de la autorización y cuántos permanecieron tras las reglas estrictas. Cada eliminación necesita un código de razón: cerrado, sin stock, fuera del área de servicio, horario desconocido, no autorizado o frescura desconocida. Sin la razón, una caída de veinte candidatos a seis parece una decisión de ranking cuando en realidad fue un filtro de elegibilidad.
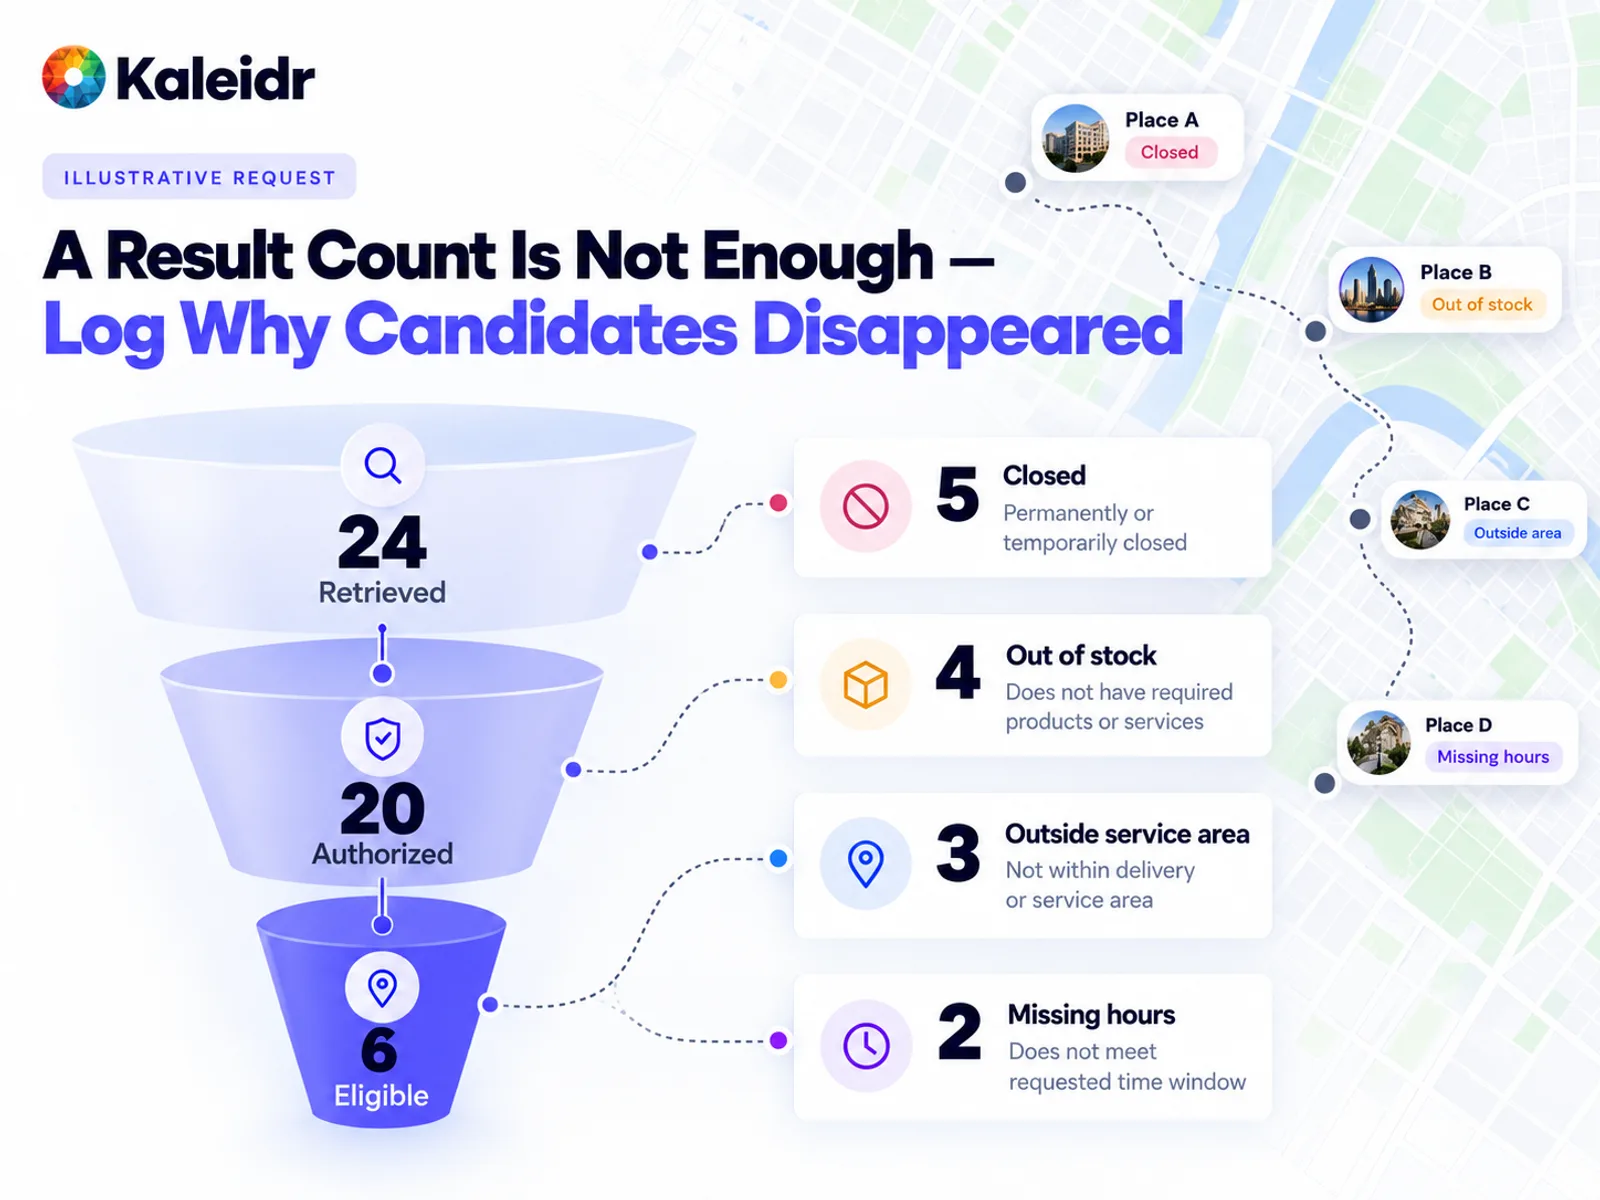
Los conteos de esta figura son una solicitud ilustrativa, no una medición de Kaleidr. Las tarjetas laterales muestran por qué los candidatos salieron del conjunto. Una traza de producción debe guardar esos códigos de razón, no solo el total final.
La guía de Spatial AI grounded de Kaleidr ya recomienda razones estructuradas de no-result, como cerrado, sin stock, fuera del área, horario desconocido o no autorizado, en lugar de un simple indicador de fallo (Kaleidr, 2026). Un no-result válido significa que todos los candidatos fallaron una regla estricta. Un fallo del sistema significa que la fuente no estaba disponible o era demasiado obsoleta para decidir. Esos dos finales necesitan alertas distintas. Relajar una restricción crítica en silencio convierte un conjunto vacío válido en una recomendación incorrecta.
¿Cómo debería rastrearse una llamada a herramienta?
Un modelo puede proponer una llamada a herramienta. Propuesta no es aprobación, aprobación no es ejecución y ejecución no es una acción de negocio completada. Registra el nombre de la herramienta, el resultado de validación del esquema, la decisión de autorización, la comprobación de política, el estado de ejecución, la latencia y la razón del fallo. Las salidas por rechazo importan tanto como la ruta de éxito: argumentos inválidos, un llamante no autorizado, una política bloqueante o un error de ejecución. El resultado del host, como una reserva terminada, permanece en el sistema que posee la transacción.
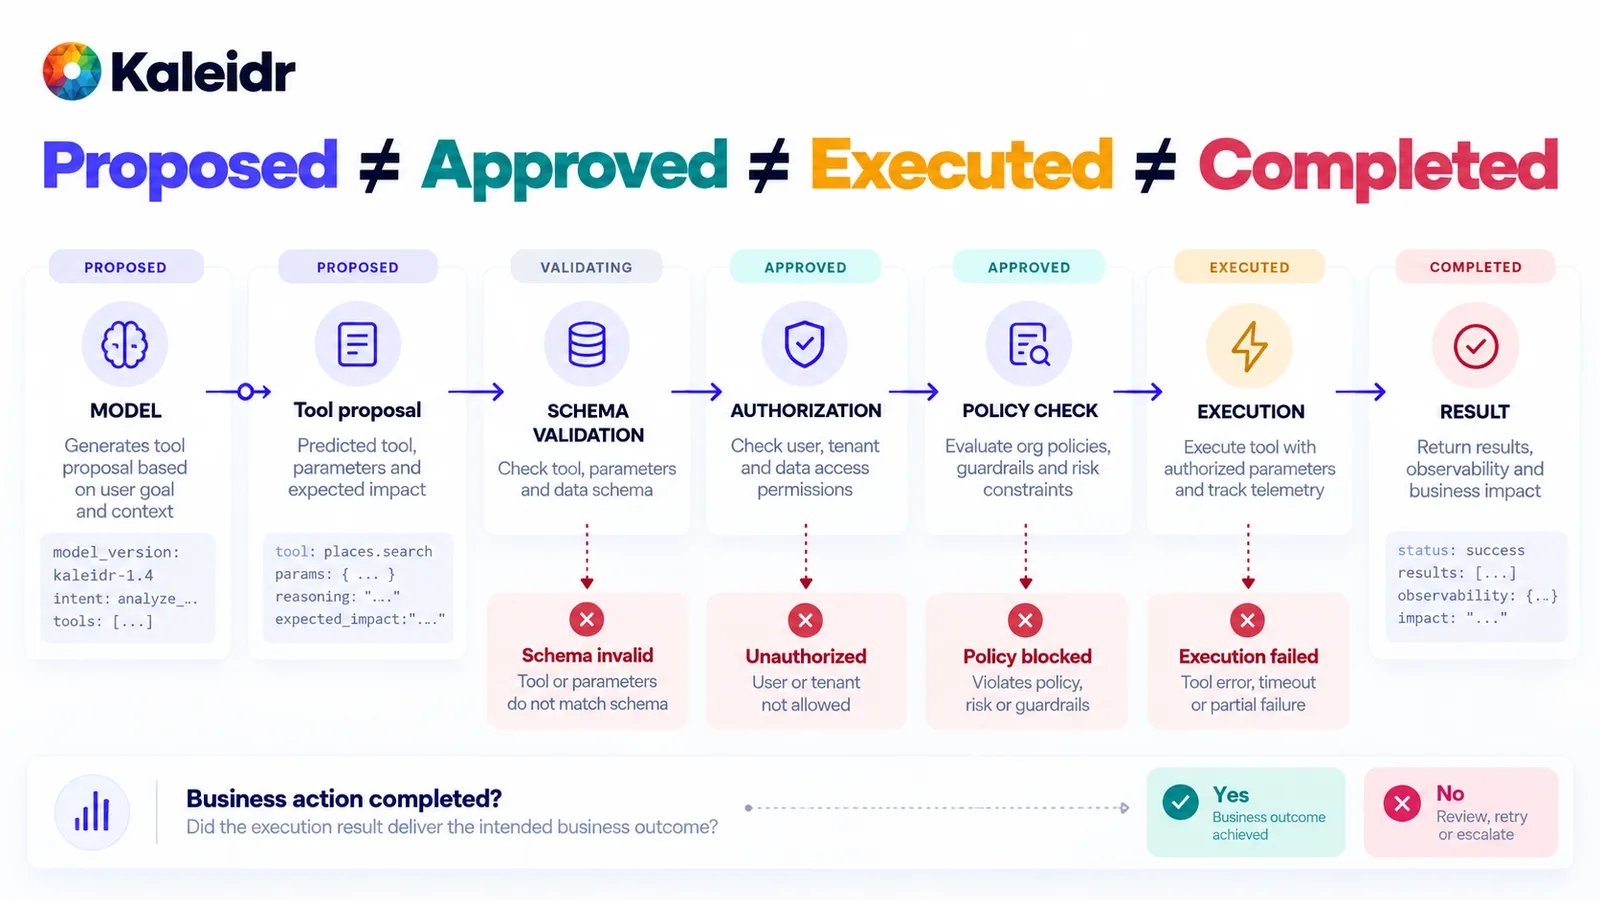
Cada gate puede detener la llamada antes de la ejecución. La pregunta final es si el trabajo del host terminó, no solo si la herramienta devolvió un payload. Los chips de estado son un bosquejo de arquitectura, no una lista fija de permisos de Kaleidr.
Las acciones del mapa pertenecen al mismo patrón. Mostrar lugares, ajustar límites y dibujar una ruta son acciones semánticas. El adaptador que habla con el renderer debe emitir un evento de ejecutado o rechazado. El span del modelo no debe ser el único registro de que apareció un marcador. Si el asistente describió un lugar que el mapa nunca mostró, la traza debe hacer visible esa discrepancia.
¿Cómo debería leerse el comportamiento de producción por lugar?
Un promedio global oculta un fallo local. Segmenta la calidad por mercado, idioma, fuente de datos, tipo de tarea y versión del sistema, usando la geografía más gruesa que aún responda la pregunta. Un código de ciudad o un ID de mercado suele ser suficiente. No se necesitan coordenadas exactas del dispositivo para ver que una región devuelve conjuntos vacíos o que un proveedor de routing está fallando. Mercados nuevos, un proveedor de lugares cambiado, un idioma nuevo y un cambio en las preguntas que hace la gente son todos formas de drift; el drift del modelo es solo una de ellas.
NIST Measure 2.4 dice que la funcionalidad y el comportamiento de un sistema de IA y sus componentes se monitorizan en producción, porque los sistemas pueden encontrar nuevos problemas y riesgos a medida que evoluciona el entorno. La página llama a ese efecto drift y dice que significa que los sistemas ya no cumplen los supuestos y limitaciones del diseño original. Una acción sugerida es documentar cómo difieren las métricas observadas en producción de esas mismas métricas recopiladas durante las pruebas previas al despliegue (NIST, 2026). La misma página afirma que AI RMF 1.0 se está actualizando y que el playbook se actualizará después de esa revisión. La página aporta contexto sobre qué vigilar. No es una lista de controles de Kaleidr.
¿Cómo se encuentran evaluación y producción?
La evaluación offline pregunta cómo rinde el sistema en casos controlados con verdad conocida. El monitoreo de producción pregunta cómo se comporta con usuarios, datos y geografía en vivo. Ambos programas deberían compartir categorías de fallo, como interpretación, grounding, cálculo espacial, ranking, acción y recuperación. Entonces un incidente de producción se convierte en un caso de prueba. Una regresión del benchmark se convierte en algo que el panel de producción puede reconocer después del lanzamiento. La guía de precisión de Kaleidr evalúa esa cadena de decisión en lugar de una única puntuación agregada del modelo (Kaleidr, 2026).
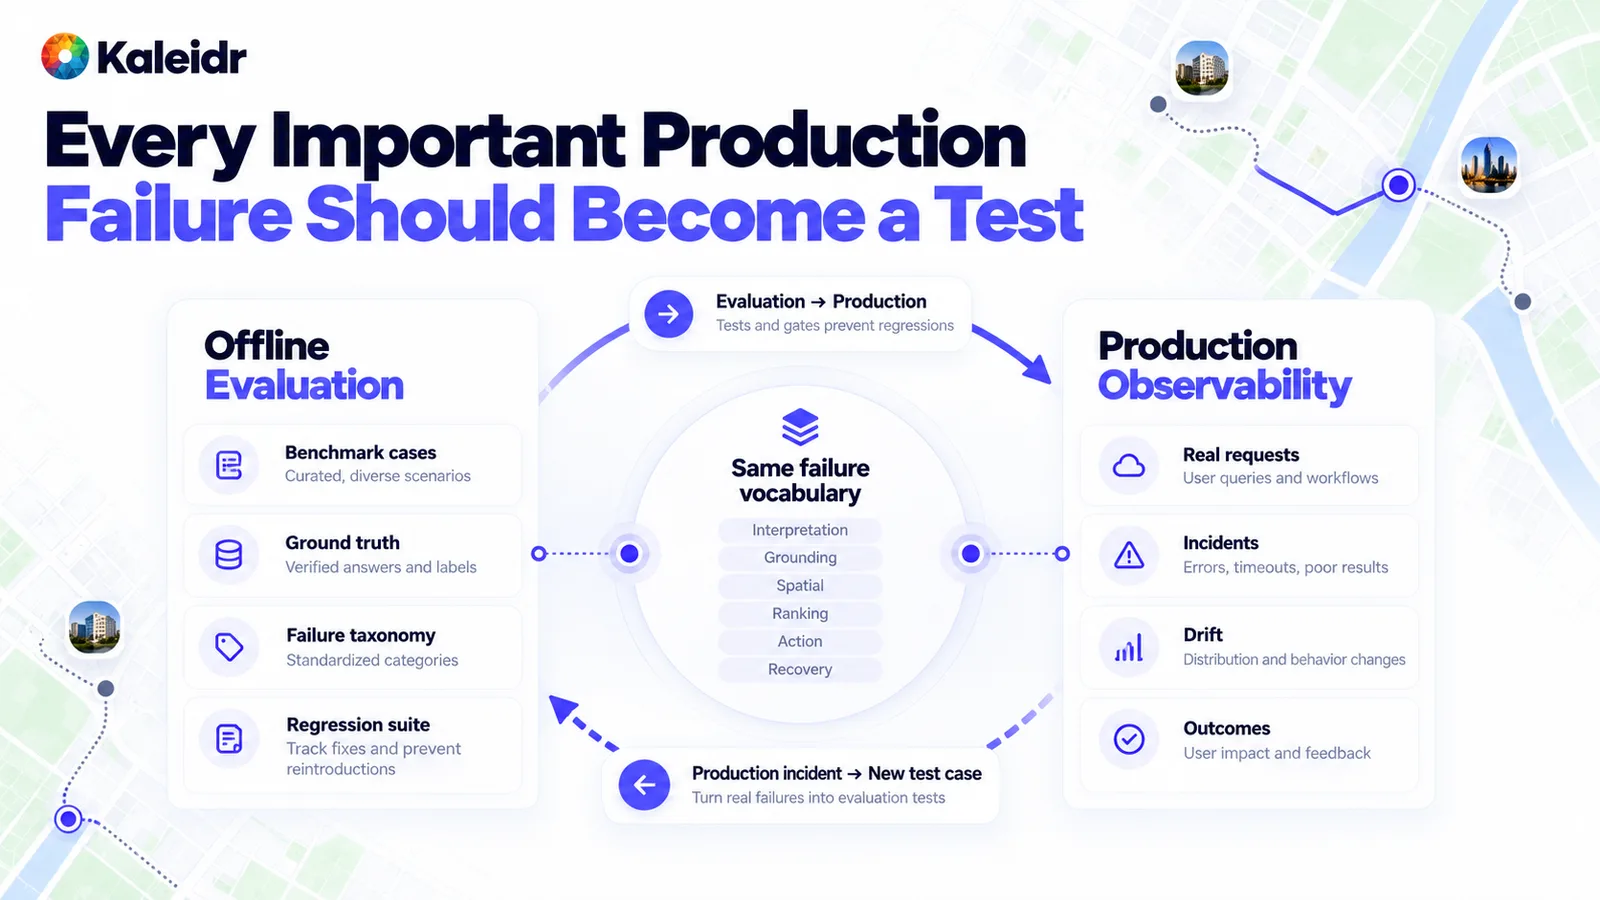
La evaluación aporta casos, ground truth y una suite de regresión. Producción aporta solicitudes reales, incidentes, drift y resultados. Las categorías compartidas del centro son el contrato entre ambas. El bucle es un método, no una puntuación reportada de Kaleidr.
¿Dónde encaja Kaleidr Analytics?
Kaleidr Analytics describe actualmente paneles de alcance, visualizaciones e interacción, ubicación y actividad de la audiencia, sesiones, visualizaciones e interacciones por mapa, comparación de lugares y patrones espaciales (Kaleidr, 2026). Esas señales describen cómo las personas usan mapas y lugares, y no son una traza distribuida de autorización, recuperación, routing, llamadas al modelo o transacciones del host. El host debe seguir instrumentando los servicios privados y los sistemas que registran reservas, compras y otros resultados. Un ID estable de mapa, lugar o flujo de trabajo puede unir ambos lados sin copiar cada registro interno a la capa de analytics.
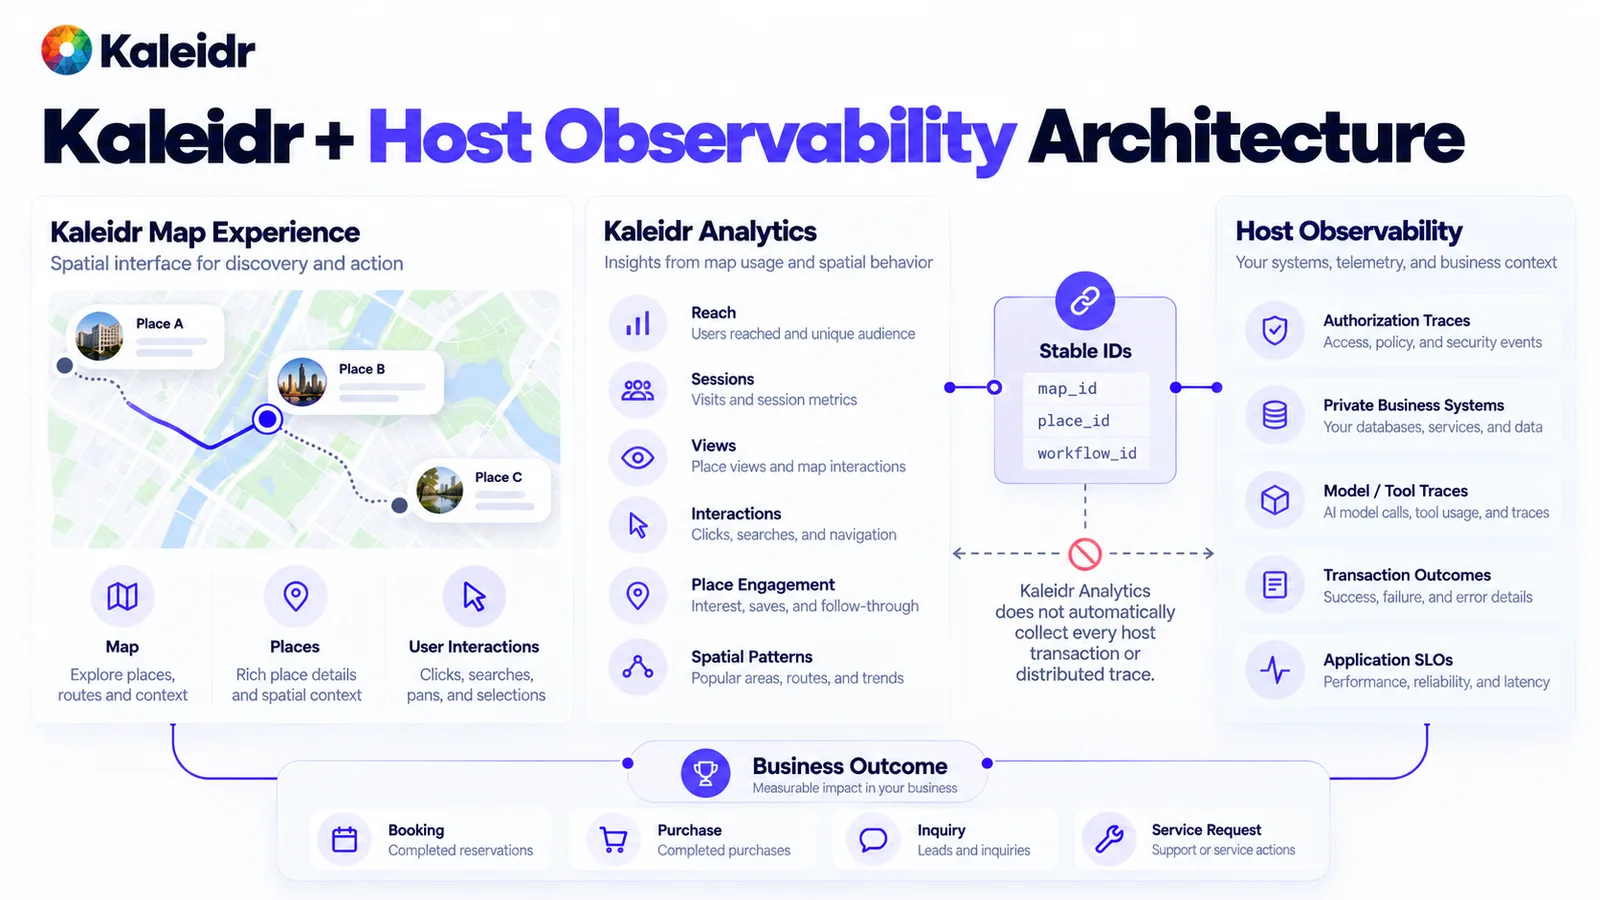
Analytics cubre la interacción documentada con mapas y lugares. La columna del host cubre trazas privadas y resultados de transacción. La unión es un identificador, y los chips de reserva y compra son registros del host, no una afirmación de que Kaleidr Analytics almacene esas transacciones.
Kaleidr Enterprise es la capa de inteligencia espacial que un equipo de producto puede añadir junto a ese stack del host, incluidas APIs de inferencia, ranking y analytics (Kaleidr, 2026). Las señales del mapa y del asistente tampoco reemplazan un resultado propiedad del host ni un valor unitario aprobado por finanzas. La guía de ROI de Kaleidr hace explícita esa separación: las señales adelantadas explican el camino y el registro del host contiene el valor (Kaleidr, 2026).
¿Cómo se convierte la observabilidad de Spatial AI en un gate de lanzamiento?
Antes de escalar un flujo consciente de ubicación, el equipo debería poder responder una lista breve usando solo la traza. ¿Qué versión de política autorizó los registros? ¿Qué IDs de lugar se recuperaron y qué códigos de razón eliminaron el resto? ¿Qué ruta y política de ranking se ejecutaron? ¿Qué versiones de modelo y herramienta estaban activas? ¿Qué acción del mapa se ejecutó y terminó el trabajo del host? El contenido sensible debe minimizarse, las versiones deben registrarse y los incidentes de producción deben entrar en el mismo vocabulario de fallos que la suite offline. Explora Kaleidr Analytics para ver interacción documentada con mapas y lugares. Explora Kaleidr Enterprise para añadir capacidades espaciales junto a los sistemas que ya poseen usuarios, datos y resultados.
Nota: Kaleidr utiliza herramientas asistidas por IA para la creación de imágenes, el refinamiento de contenido y la investigación en sus flujos de trabajo creativos y de desarrollo.
Preguntas frecuentes
¿La observabilidad de Spatial AI es lo mismo que el monitoreo de modelos de lenguaje?
No. La latencia del modelo, los tokens y los errores de herramientas cubren un span. La identidad del lugar, los permisos, los datos de negocio, los servicios geográficos, el ranking, el estado del mapa y el resultado del host pueden cambiar si el resultado fue correcto.
¿Deben registrarse los prompts de usuario?
Registra prompts solo con una necesidad definida, un límite de retención y control de acceso. Muchas solicitudes de ubicación contienen direcciones privadas o datos de negocio que una traza no necesita por completo.
¿Debe almacenarse la ubicación precisa del usuario en las trazas?
Usa la geografía más gruesa que responda la pregunta operativa, como un código de mercado, un ID de lugar o un ID de ruta.
¿Cuál es la diferencia entre monitoreo y evaluación?
El monitoreo observa el comportamiento en producción. La evaluación prueba casos definidos contra ground truth. Un programa sólido usa un vocabulario común de fallos para que un incidente pueda convertirse en prueba y una regresión pueda verse después del lanzamiento.
¿Cuál es la métrica más importante?
No existe una métrica universal. Vincula la medida al trabajo: calidad de resultados elegibles, resolución de lugares, corrección de no-result, éxito de rutas, corrección de autorización o finalización de la tarea.
¿Cómo deberían rastrearse las llamadas a herramientas?
Registra nombre de la herramienta, validación de esquema, autorización, resultado de política, estado de ejecución, latencia y motivo del fallo. Mantén separada una acción propuesta de una acción ejecutada y de un resultado del host completado.
¿Kaleidr Analytics reemplaza la observabilidad de la aplicación?
No. La página pública de Analytics describe interacción con mapas y lugares, sesiones, visualizaciones, interacciones, actividad de audiencia y patrones espaciales. Las trazas de servicios privados, la autorización interna y los resultados de transacción permanecen con el host salvo que una integración específica indique lo contrario.
¿Se puede usar OpenTelemetry para Spatial AI?
Sí. OpenTelemetry es una base práctica para trazas, métricas, logs, eventos y convenciones actuales de IA generativa. Los equipos pueden añadir atributos documentados para IDs de lugar, IDs de ruta, elegibilidad, ranking, acciones del mapa y razones de no-result cuando las convenciones compartidas todavía no los nombren.
Referencias
- Kaleidr. Spatial AI Accuracy Evaluation. https://kaleidr.com/blog/spatial-ai-accuracy-evaluation
- Kaleidr. An Enterprise Spatial AI Pilot Before Scaling. https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling
- OpenTelemetry. Semantic Conventions for Events. Operations with a duration belong in spans. Checkpoints and point-in-time outcomes are event candidates. Accessed October 1, 2026. https://opentelemetry.io/docs/specs/semconv/general/events/
- OpenTelemetry. Inside the LLM Call: GenAI Observability with OpenTelemetry. James Newton-King, May 14, 2026. https://opentelemetry.io/blog/2026/genai-observability/
- OpenTelemetry. Semantic Conventions. Documentation labeled 1.44.0. Accessed October 1, 2026. https://opentelemetry.io/docs/specs/semconv/
- OpenTelemetry. Generative AI Semantic Convention Attributes. Registry warns that retrieval query text may contain sensitive information. Accessed October 1, 2026. https://opentelemetry.io/docs/specs/semconv/registry/attributes/gen-ai/
- Kaleidr. Private Location Data for AI Map Workflows. https://kaleidr.com/blog/private-location-data-for-ai-map-workflows
- Kaleidr. Grounded Spatial AI for Business Data. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- National Institute of Standards and Technology. AI RMF Playbook, Measure. Production monitoring, drift, and the difference from pre-deployment testing. Notes that the AI RMF 1.0 is being updated and that the playbook will be revised afterward. Accessed October 1, 2026. https://airc.nist.gov/airmf-resources/playbook/measure/
- Kaleidr. Map Engagement and Location Analytics. Accessed October 1, 2026. https://kaleidr.com/analytics
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed October 1, 2026. https://kaleidr.com/enterprise
- Kaleidr. Spatial AI ROI Business Case. https://kaleidr.com/blog/spatial-ai-roi-business-case
@misc{kaleidr_accuracy_observability_2026,
  title  = {Spatial AI Accuracy Evaluation},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-ai-accuracy-evaluation}
}

@misc{kaleidr_pilot_observability_2026,
  title  = {An Enterprise Spatial AI Pilot Before Scaling},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling}
}

@misc{otel_events_2026,
  title  = {Semantic Conventions for Events},
  author = {{OpenTelemetry}},
  year   = {2026},
  note   = {Accessed October 1, 2026},
  url    = {https://opentelemetry.io/docs/specs/semconv/general/events/}
}

@misc{otel_genai_observability_2026,
  title  = {Inside the LLM Call: GenAI Observability with OpenTelemetry},
  author = {Newton-King, James},
  year   = {2026},
  note   = {May 14, 2026},
  url    = {https://opentelemetry.io/blog/2026/genai-observability/}
}

@misc{otel_semconv_2026,
  title  = {Semantic Conventions},
  author = {{OpenTelemetry}},
  year   = {2026},
  note   = {Documentation labeled 1.44.0. Accessed October 1, 2026},
  url    = {https://opentelemetry.io/docs/specs/semconv/}
}

@misc{otel_genai_attributes_2026,
  title  = {Generative AI Semantic Convention Attributes},
  author = {{OpenTelemetry}},
  year   = {2026},
  note   = {Accessed October 1, 2026},
  url    = {https://opentelemetry.io/docs/specs/semconv/registry/attributes/gen-ai/}
}

@misc{kaleidr_private_location_2026,
  title  = {Private Location Data for AI Map Workflows},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/private-location-data-for-ai-map-workflows}
}

@misc{kaleidr_grounded_observability_2026,
  title  = {Grounded Spatial AI for Business Data},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/grounded-spatial-ai-business-data}
}

@misc{nist_rmf_playbook_measure_2026,
  title  = {AI RMF Playbook, Measure},
  author = {{National Institute of Standards and Technology}},
  year   = {2026},
  note   = {Accessed October 1, 2026. Page states the playbook will be updated after the AI RMF revision},
  url    = {https://airc.nist.gov/airmf-resources/playbook/measure/}
}

@misc{kaleidr_analytics_observability_2026,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed October 1, 2026},
  url    = {https://kaleidr.com/analytics}
}

@misc{kaleidr_enterprise_observability_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed October 1, 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_roi_observability_2026,
  title  = {Spatial AI ROI Business Case},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-ai-roi-business-case}
}