
L’observabilité de la Spatial AI retrace la manière dont un système sensible à la localisation passe d’une requête à un lieu autorisé, un calcul géographique, un résultat classé, une action cartographique et un résultat dans le système hôte. La latence du modèle et le nombre de tokens peuvent montrer qu’un appel s’est terminé. Ces deux nombres ne peuvent pas montrer que le lieu était éligible ni que le client a terminé sa tâche. L’enregistrement utile est le chemin de décision, suffisamment compact pour expliquer le résultat sans copier des données de localisation privées.
Les sections ci-dessous séparent la télémétrie système de la décision géographique, indiquent ce qu’il faut tracer et précisent ce qui doit rester hors des logs. Parmi les lectures associées figurent Spatial AI Accuracy Evaluation et An Enterprise Spatial AI Pilot. Un graphe de services en bonne santé peut malgré tout masquer un mauvais lieu.
Principes essentiels de l’observabilité de la Spatial AI
- Tracer la décision : autorisation, récupération, identité du lieu, géographie, éligibilité, classement, outils et résultat du système hôte sont des spans distincts.
- Conserver les IDs, pas des copies : les identifiants de lieu, d’itinéraire, de politique, de modèle et d’action expliquent davantage que des prompts copiés.
- Minimiser le contenu : secrets, enregistrements privés bruts et localisation précise restent par défaut hors du stockage de télémétrie.
- Compter les retraits : un total de résultats est incomplet sans la raison pour laquelle chaque candidat a quitté l’ensemble.
- Partager un vocabulaire de défaillance : les cas hors ligne et les incidents de production doivent utiliser les mêmes catégories.
Qu’est-ce que l’observabilité de la Spatial AI ?
Un client peut demander quel magasin sur le chemin du retour a encore un article en stock et sera ouvert à son arrivée. La réponse dépend de l’identité, du stock actuel, des horaires, d’un itinéraire, de règles d’éligibilité, d’une politique de classement, d’une action sur la carte et du fait que la personne ait réellement choisi un magasin. Une trace qui s’arrête à l’appel du modèle peut rendre compte des tokens et de la latence tout en manquant chacune de ces étapes. Ici, l’observabilité signifie que l’équipe peut reconstruire la décision à partir de signaux structurés, et non que chaque prompt est archivé.
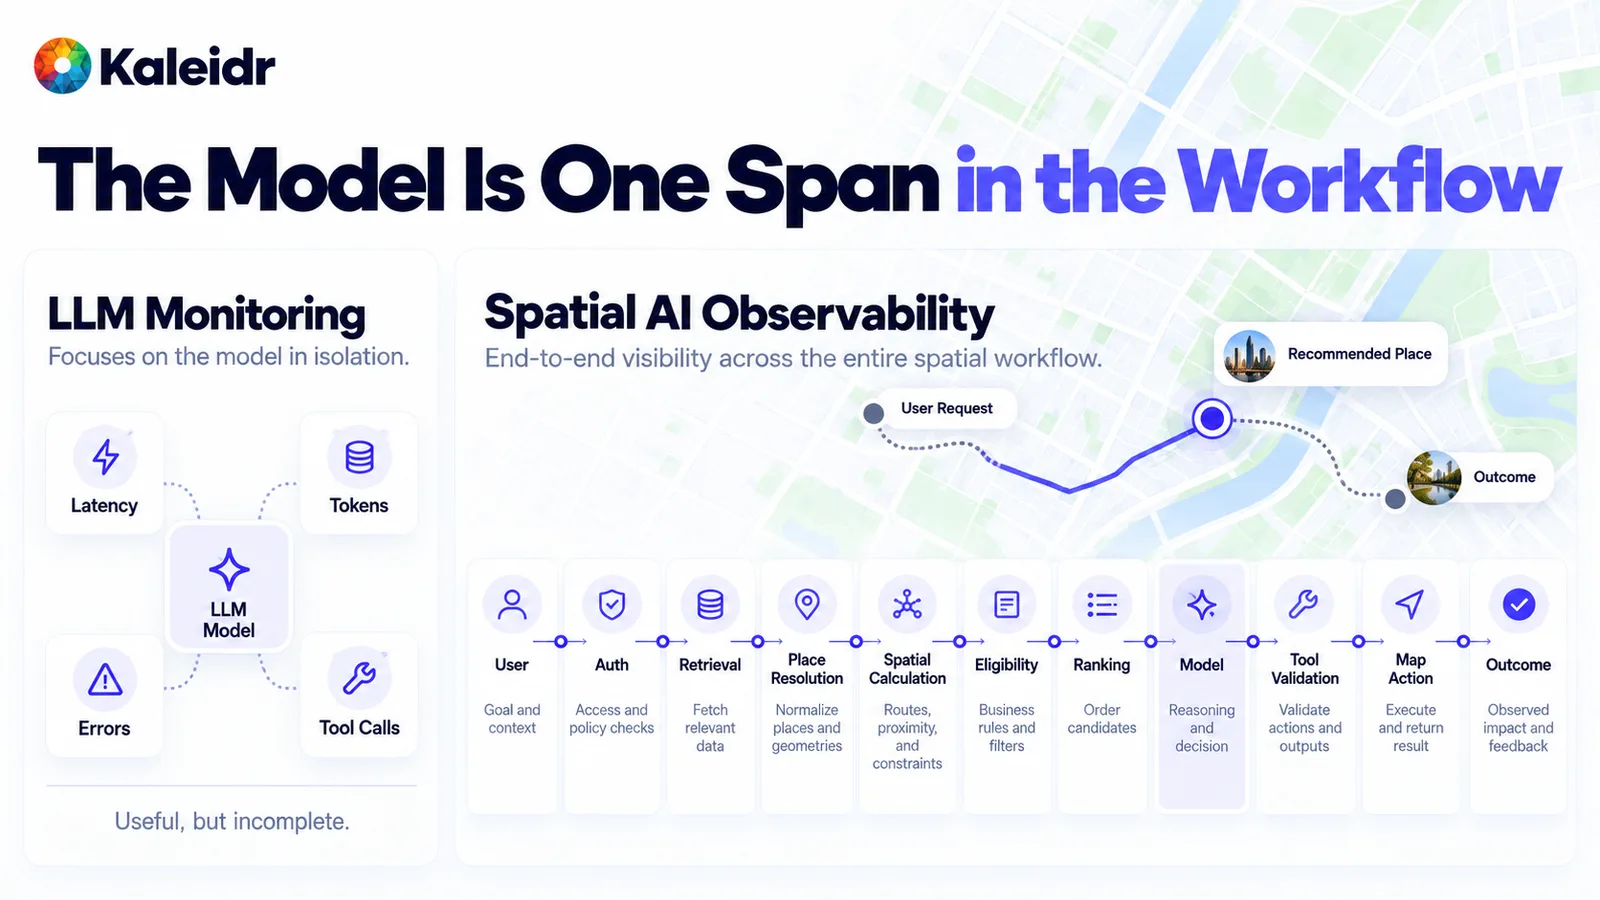
Le panneau de gauche observe le modèle isolément. Le panneau de droite conserve le modèle comme un span parmi la récupération, la résolution des lieux, l’éligibilité, le classement, la validation des outils et l’action cartographique. Cette séparation est un modèle d’observabilité, pas un benchmark Kaleidr.
Trois types de vérité doivent se rejoindre. La vérité système couvre la latence, les erreurs, les nouvelles tentatives et l’état des dépendances. La vérité de décision couvre les IDs de lieux autorisés, les candidats ayant échoué à une règle stricte, l’itinéraire exécuté et l’action validée. La vérité de résultat couvre le fait qu’un lieu ait été sélectionné, qu’un itinéraire ait été ouvert ou qu’un workflow du système hôte se soit terminé. Un tableau de bord limité au premier type peut sembler calme alors que le produit recommande un magasin fermé. Un tableau de bord limité à l’engagement cartographique peut sembler très actif tandis qu’un outil coûteux retente en arrière-plan.
Que doit contenir une trace Spatial AI ?
Une requête doit conserver un ID de requête stable à travers les étapes réellement exécutées. L’autorisation enregistre la version de la politique et le résultat autorisé ou refusé. La récupération enregistre la source et le nombre d’enregistrements retournés, pas les lignes privées. La résolution des lieux enregistre les IDs candidats. Le routage enregistre un ID d’itinéraire et un statut. L’éligibilité enregistre le nombre de candidats restants et la raison pour laquelle les autres ont été retirés. Le classement enregistre la version de la politique et les IDs ordonnés. Le span du modèle enregistre le fournisseur, l’étiquette de version et le nombre de tokens. La validation des outils enregistre si une action proposée a été rejetée ou exécutée. Les événements de clôture enregistrent un lieu sélectionné et, lorsque le système hôte le signale, un workflow terminé.
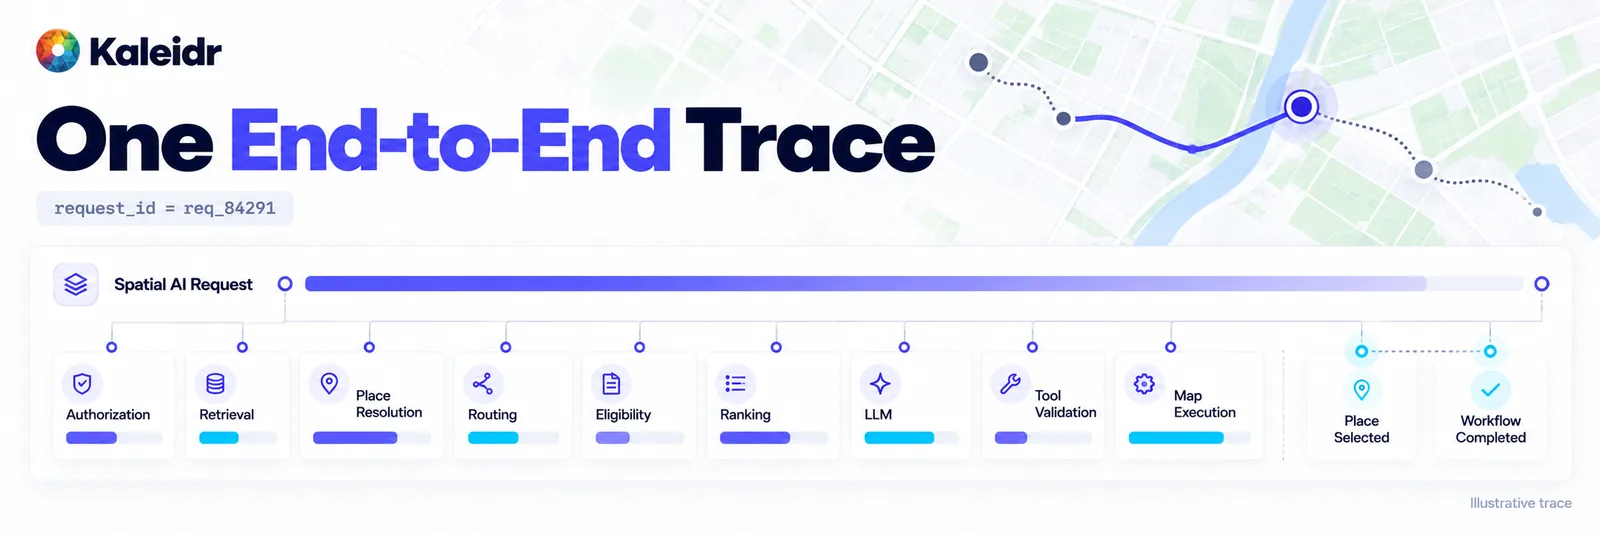
Le span parent est la requête. Les spans enfants couvrent les étapes pouvant échouer indépendamment, et les marques de clôture sont le lieu sélectionné et le workflow terminé. Les durées de la figure sont illustratives et ne représentent pas une latence mesurée de Kaleidr.
Toutes les requêtes n’ont pas besoin de tous les spans. Une action « afficher ce lieu » peut ignorer le classement. Une recommandation de service peut utiliser toute la chaîne. La trace doit indiquer quelles étapes ont été exécutées et lesquelles ont été ignorées, afin qu’un span de routage absent ne soit pas interprété comme un routage réussi. Les étiquettes de version dans la figure, y compris tout nom de modèle imprimé sur une carte, sont des exemples de métadonnées et non un catalogue de modèles Kaleidr.
Comment séparer traces, métriques, événements et logs ?
Les traces répondent à la question de savoir où le temps a été passé dans une requête. Les métriques indiquent si un taux se dégrade sur plusieurs requêtes, par exemple la latence p95, un taux de no-result ou un taux d’échec d’outil. Les événements indiquent ce qui a changé à un instant donné, par exemple un candidat retiré, un lieu sélectionné ou une action rejetée. Les logs conservent des détails de diagnostic qui n’ont pas besoin de devenir une métrique formelle, comme un avertissement de parser. Mélanger ces rôles fait du stockage coûteux le stockage par défaut.
Les recommandations d’OpenTelemetry sur les événements tracent la même frontière. Les opérations ayant une durée et une limite significative appartiennent aux spans. Un point de contrôle, un changement d’état ou un autre résultat ponctuel au sein d’une opération plus longue est un candidat à un événement (OpenTelemetry, 2026). Un article du 14 mai 2026 de James Newton-King montre des opérations d’IA générative enregistrées sous forme de traces, notamment les appels de modèles et l’activité des outils, et indique que le contenu des prompts et les arguments d’outils restent par défaut hors de la télémétrie car ils peuvent contenir des données sensibles (Newton-King, 2026). La documentation des conventions sémantiques, étiquetée 1.44.0 sur la page consultée pour cet article, définit des noms partagés pour les traces, métriques et logs (OpenTelemetry, 2026). Des attributs spatiaux comme un ID d’ensemble de résultats de lieux ou une raison de no-result peuvent être ajoutés à côté. Ces noms spatiaux sont des exemples d’application, pas des conventions spatiales officielles d’OpenTelemetry.
Que faut-il laisser hors du stockage de télémétrie ?
L’observabilité échoue si le système de télémétrie devient une deuxième copie des données clients, de localisation ou d’entreprise. Enregistrez par défaut des identifiants, versions, décomptes, statuts, latences et codes de raison. Traitez les extraits expurgés, le contenu échantillonné et la géographie généralisée comme conditionnels, uniquement avec un besoin explicite, une durée de conservation et un contrôle d’accès. Évitez les secrets, les enregistrements privés bruts, les prompts complets non restreints, les coordonnées précises inutiles à la question et les jetons d’accès. Un code de ville ou de marché répond souvent à la même question opérationnelle qu’une adresse brute.
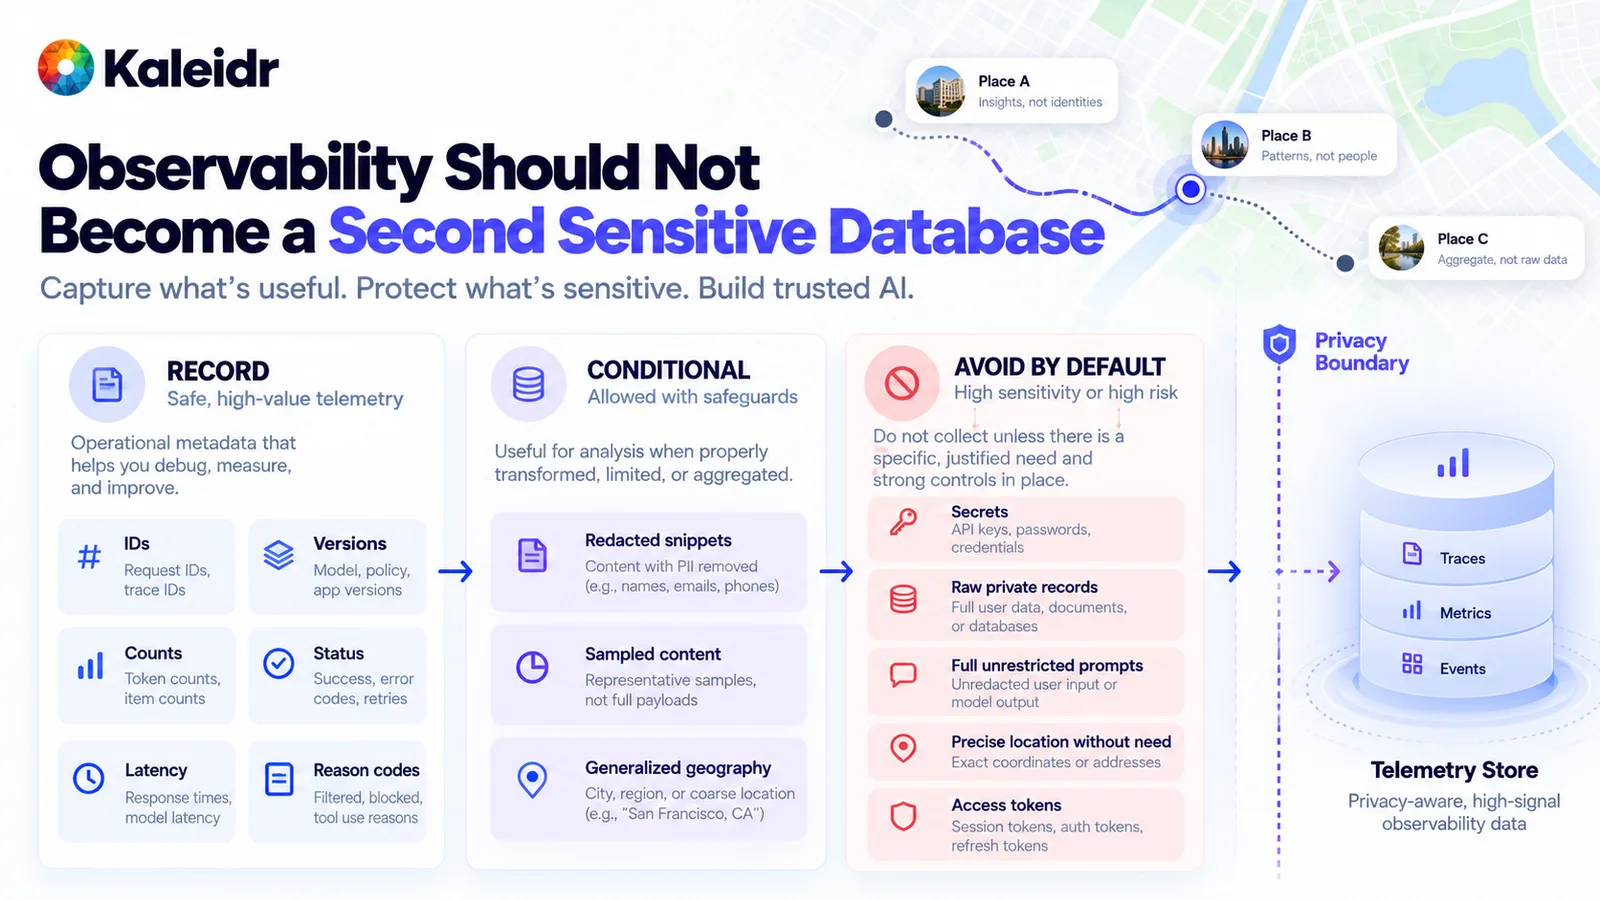
La colonne de gauche correspond à l’enregistrement par défaut. La colonne du milieu nécessite une protection. La colonne de droite reste exclue sauf si un contrôle spécifique la justifie. La figure présente un modèle de minimisation, pas une certification.
Le registre d’attributs Generative AI d’OpenTelemetry avertit que le texte des requêtes de récupération peut contenir des informations sensibles et signale plusieurs attributs porteurs de contenu comme susceptibles d’inclure des données utilisateur ou personnelles (OpenTelemetry, 2026). Les recommandations de Kaleidr sur les données de localisation privées placent déjà l’autorisation avant la transmission des enregistrements au modèle et déconseillent de téléverser une base de données interne sans restriction (Kaleidr, 2026). Une trace doit préserver cette frontière. Enregistrez que l’autorisation a réussi pour un ID d’ensemble de résultats. N’enregistrez pas les lignes privées que ce contrôle a autorisées.
Pourquoi consigner la raison de la disparition d’un candidat ?
Un simple nombre de résultats ne peut pas expliquer une mauvaise recommandation. Le funnel utile enregistre le nombre de candidats récupérés, le nombre restant après autorisation et le nombre restant après les règles strictes. Chaque retrait nécessite un code de raison : fermé, rupture de stock, hors zone de service, horaires manquants, non autorisé ou fraîcheur inconnue. Sans cette raison, une baisse de vingt candidats à six ressemble à une décision de classement alors qu’il s’agissait d’un filtre d’éligibilité.
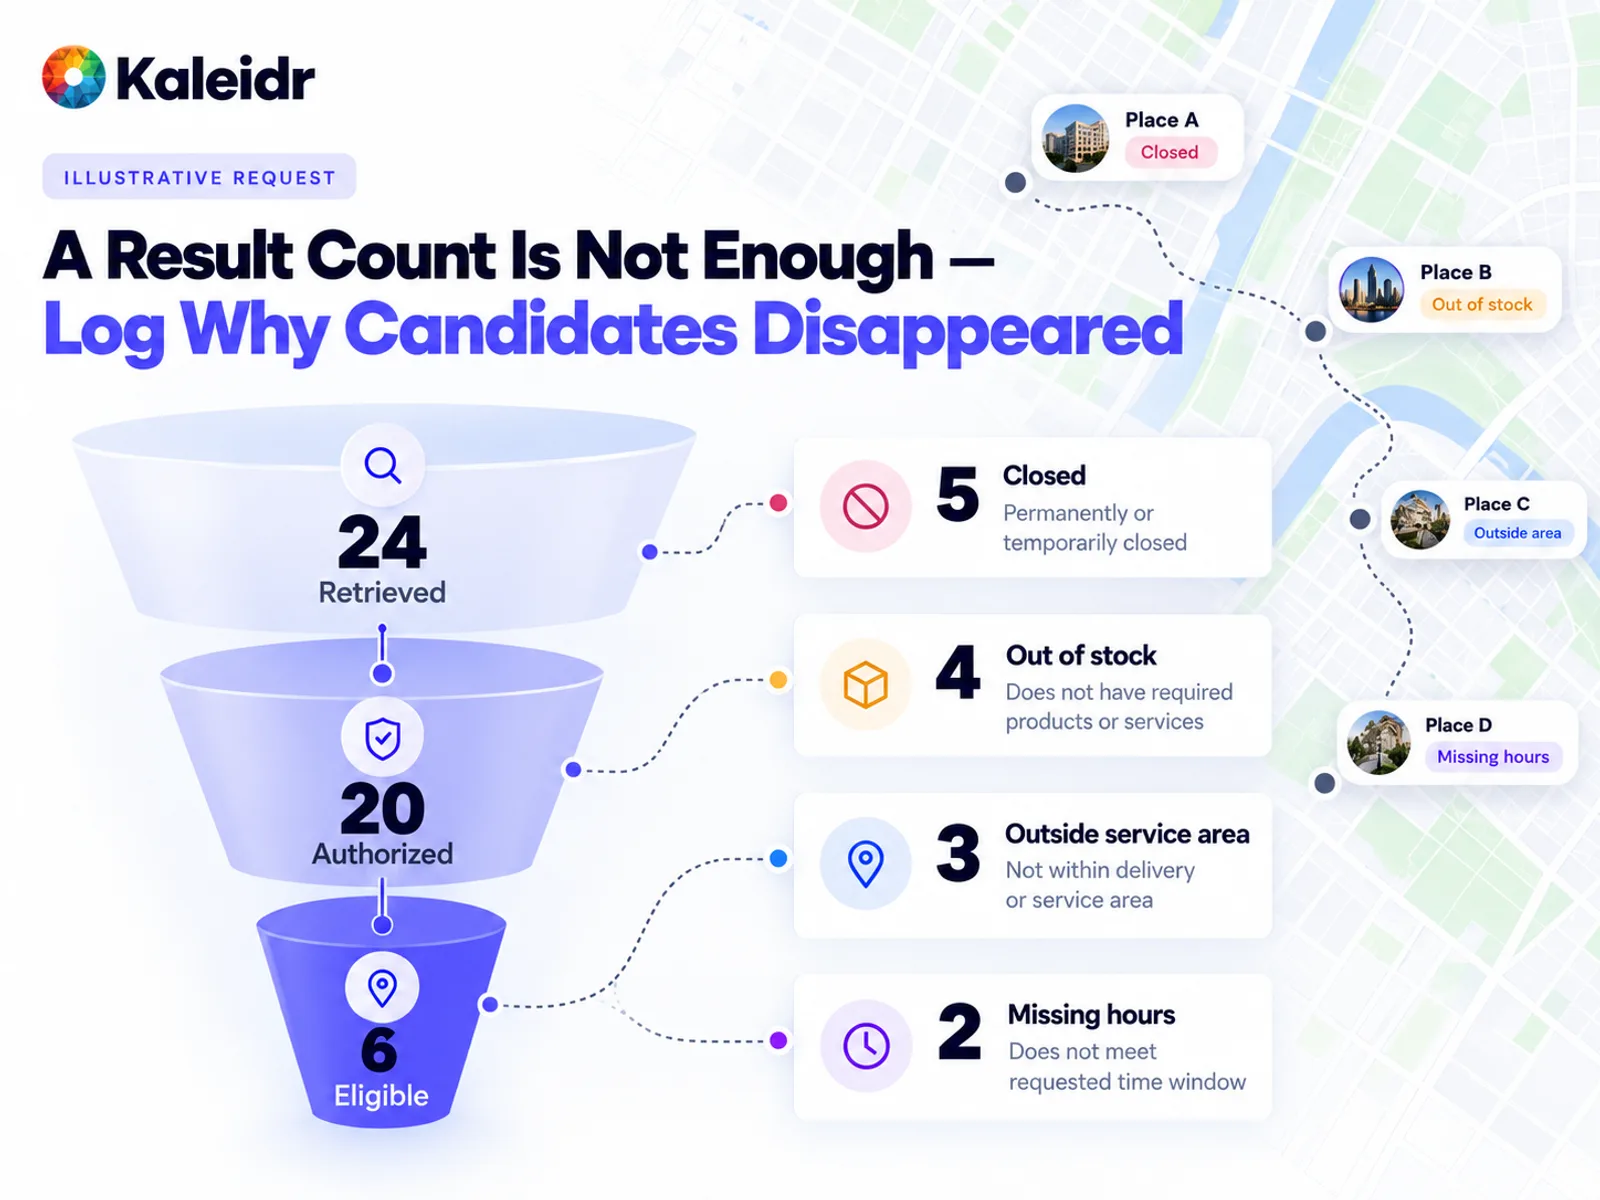
Les nombres de cette figure illustrent une requête et ne constituent pas une mesure Kaleidr. Les cartes latérales montrent pourquoi les candidats ont quitté l’ensemble. Une trace de production doit stocker ces codes de raison, pas seulement le total final.
Les recommandations de Kaleidr sur la Spatial AI grounded préconisent déjà des raisons structurées de no-result, comme fermé, rupture de stock, hors zone, horaires inconnus ou non autorisé, plutôt qu’un simple drapeau d’échec (Kaleidr, 2026). Un no-result valide signifie que chaque candidat a échoué à une règle stricte. Une défaillance du système signifie que la source était indisponible ou trop obsolète pour décider. Ces deux fins nécessitent des alertes différentes. Assouplir silencieusement une contrainte critique transforme un ensemble vide valide en mauvaise recommandation.
Comment tracer un appel d’outil ?
Un modèle peut proposer un appel d’outil. Proposition ne signifie pas approbation, approbation ne signifie pas exécution, et exécution ne signifie pas action métier terminée. Enregistrez le nom de l’outil, le résultat de validation du schéma, la décision d’autorisation, le contrôle de politique, le statut d’exécution, la latence et la raison d’échec. Les sorties de rejet comptent autant que le chemin de réussite : arguments invalides, appelant non autorisé, politique bloquante ou erreur d’exécution. Le résultat du système hôte, comme une réservation terminée, reste dans le système qui détient la transaction.
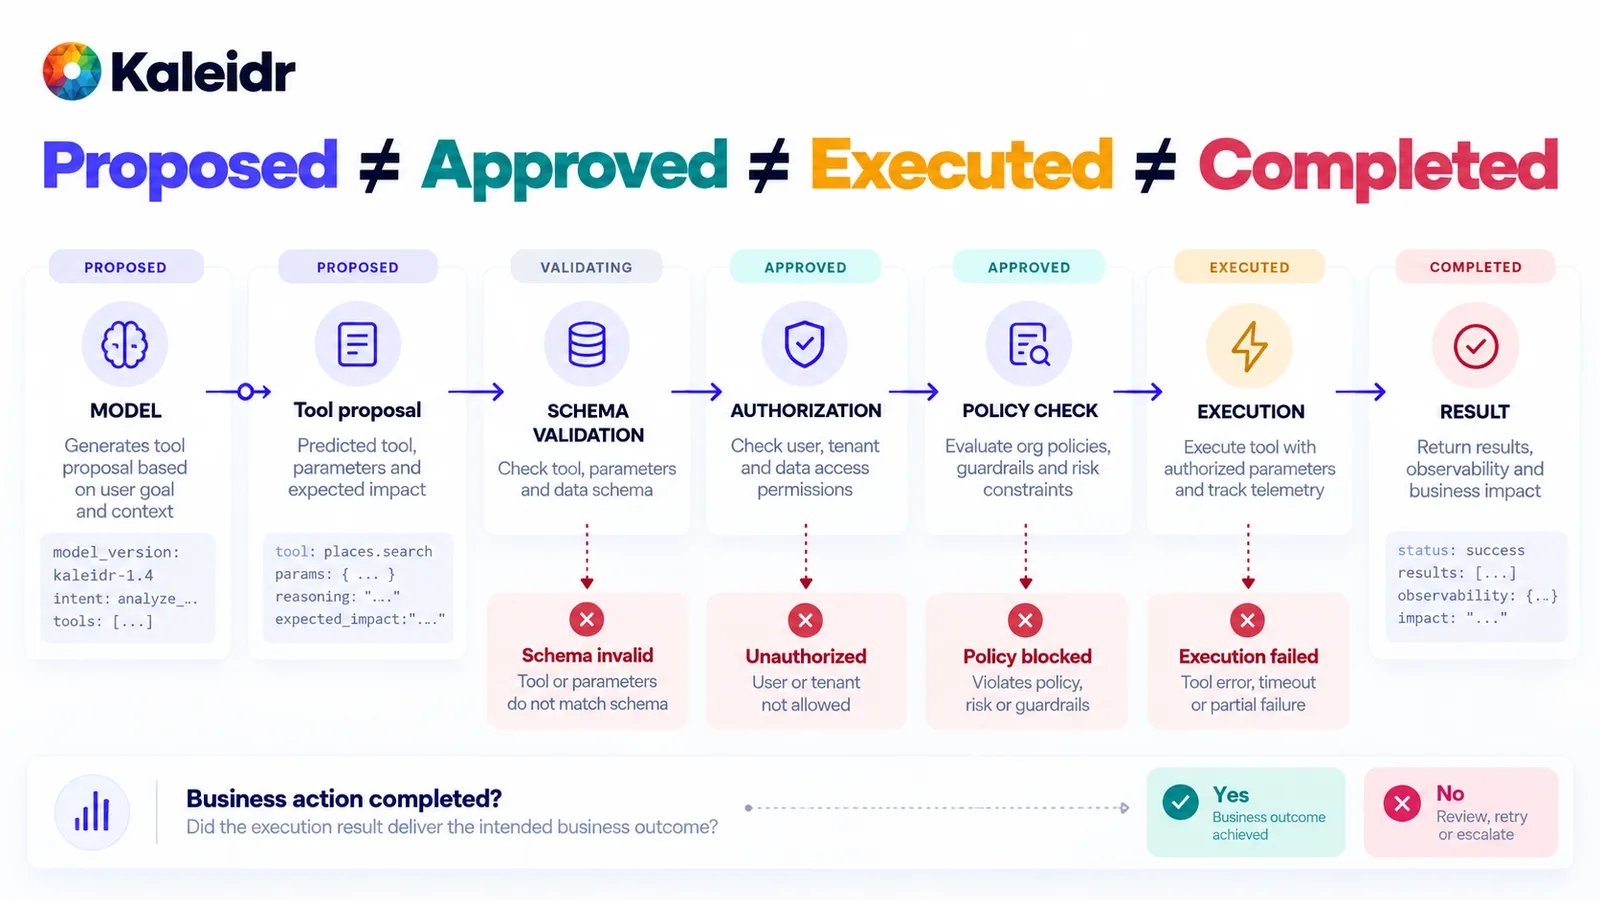
Chaque gate peut arrêter l’appel avant l’exécution. La question finale est de savoir si le travail du système hôte s’est terminé, pas seulement si l’outil a retourné une charge utile. Les indicateurs de statut sont une esquisse d’architecture, pas une liste fixe de permissions Kaleidr.
Les actions cartographiques suivent le même modèle. Afficher des lieux, ajuster les limites et tracer un itinéraire sont des actions sémantiques. L’adaptateur qui communique avec le moteur de rendu doit émettre un événement exécuté ou rejeté. Le span du modèle ne doit pas être le seul enregistrement prouvant qu’un marqueur est apparu. Si l’assistant décrit un lieu que la carte n’a jamais affiché, la trace doit rendre cette incohérence visible.
Comment lire le comportement en production selon le lieu ?
Une moyenne globale masque un échec local. Segmentez la qualité par marché, langue, source de données, type de tâche et version du système, en utilisant la géographie la plus grossière qui réponde encore à la question. Un code de ville ou un ID de marché suffit souvent. Des coordonnées exactes de l’appareil ne sont pas nécessaires pour voir qu’une région retourne des ensembles vides ou qu’un fournisseur de routage échoue. De nouveaux marchés, un fournisseur de lieux modifié, une nouvelle langue et une évolution des questions posées par les utilisateurs sont tous des formes de drift ; le drift du modèle n’en est qu’une.
NIST Measure 2.4 indique que la fonctionnalité et le comportement d’un système d’IA et de ses composants sont surveillés en production, car les systèmes peuvent rencontrer de nouveaux problèmes et risques à mesure que l’environnement évolue. La page appelle cet effet drift et explique que le drift signifie que les systèmes ne respectent plus les hypothèses et limites de la conception initiale. Une action suggérée consiste à documenter comment les métriques observées en production diffèrent des mêmes métriques recueillies lors des tests avant déploiement (NIST, 2026). La même page indique que AI RMF 1.0 est en cours de mise à jour et que le playbook sera mis à jour après cette révision. Cette page fournit un contexte sur ce qu’il convient de surveiller. Elle n’est pas une liste de contrôles Kaleidr.
Comment l’évaluation rejoint-elle la production ?
L’évaluation hors ligne demande comment le système se comporte sur des cas contrôlés avec une vérité connue. Le monitoring de production demande comment il se comporte avec des utilisateurs, des données et une géographie réels. Les deux programmes doivent partager des catégories de défaillance, telles que l’interprétation, le grounding, le calcul spatial, le classement, l’action et la récupération. Un incident de production devient alors un cas de test. Une régression de benchmark devient quelque chose que le tableau de bord de production peut reconnaître après le lancement. Le guide de précision de Kaleidr évalue cette chaîne de décision plutôt qu’un score de modèle agrégé (Kaleidr, 2026).
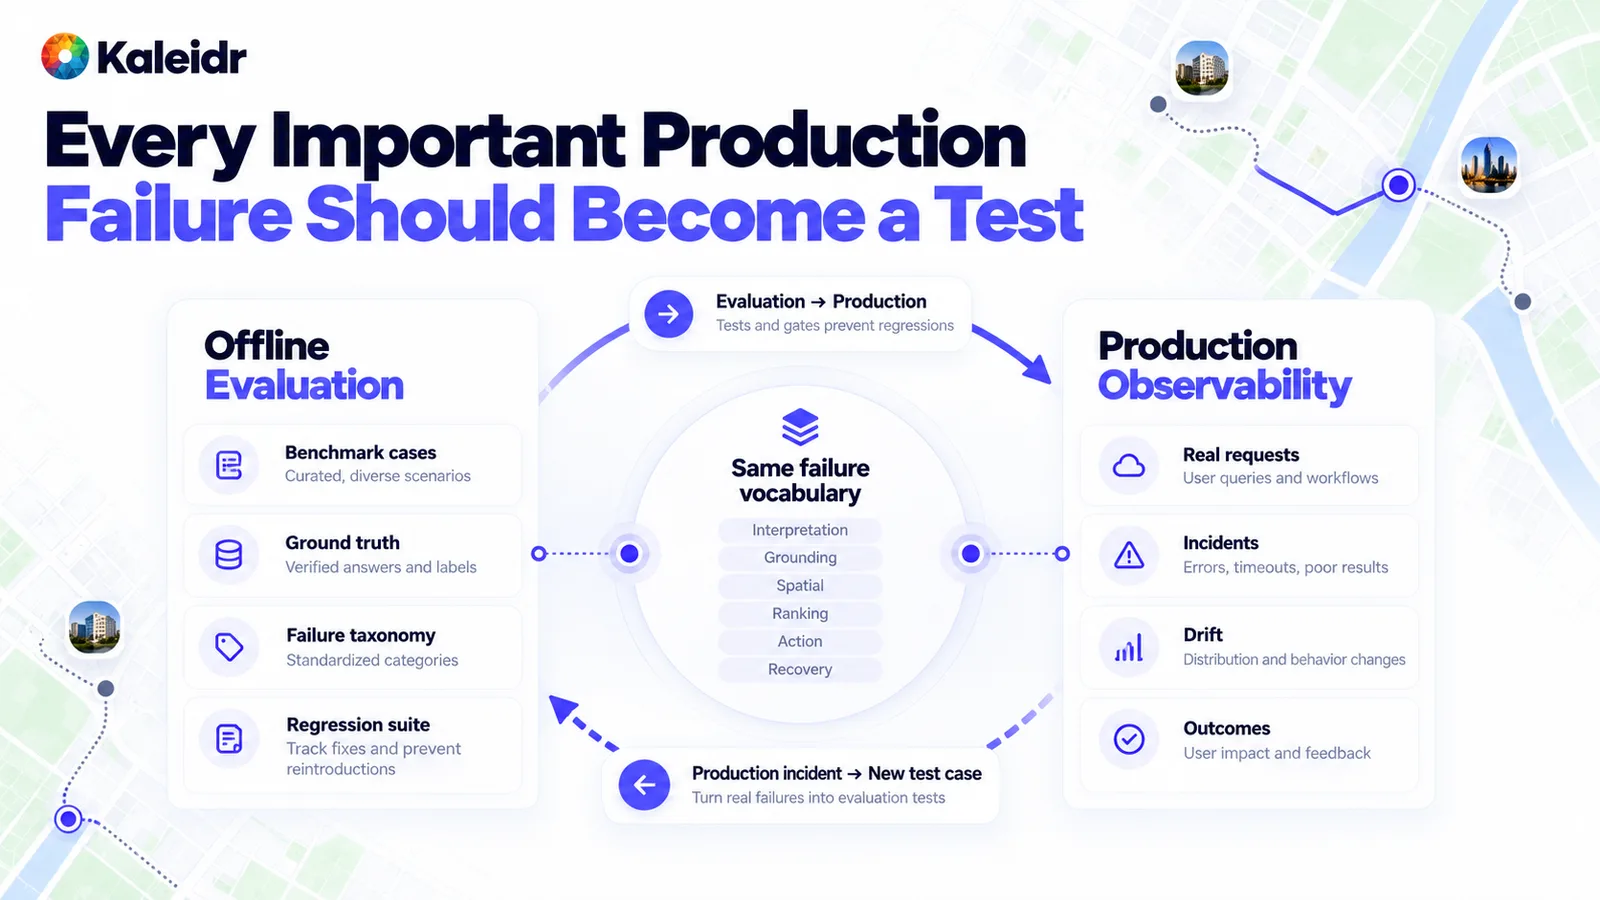
L’évaluation fournit les cas, la ground truth et une suite de régression. La production fournit les requêtes réelles, les incidents, le drift et les résultats. Les catégories communes au centre constituent le contrat entre les deux. La boucle est une méthode, pas un score Kaleidr publié.
Où se situe Kaleidr Analytics ?
Kaleidr Analytics décrit actuellement des tableaux de bord pour la portée, les vues et l’engagement, la localisation et l’activité de l’audience, les sessions, vues et interactions par carte, la comparaison des lieux et les motifs spatiaux (Kaleidr, 2026). Ces signaux décrivent la manière dont les personnes utilisent les cartes et les lieux ; ils ne constituent pas une trace distribuée de l’autorisation, de la récupération, du routage, des appels au modèle ou des transactions du système hôte. Le système hôte doit continuer à instrumenter les services privés et les systèmes qui enregistrent réservations, achats et autres résultats. Un ID stable de carte, de lieu ou de workflow peut relier les deux sans copier chaque enregistrement interne dans la couche Analytics.
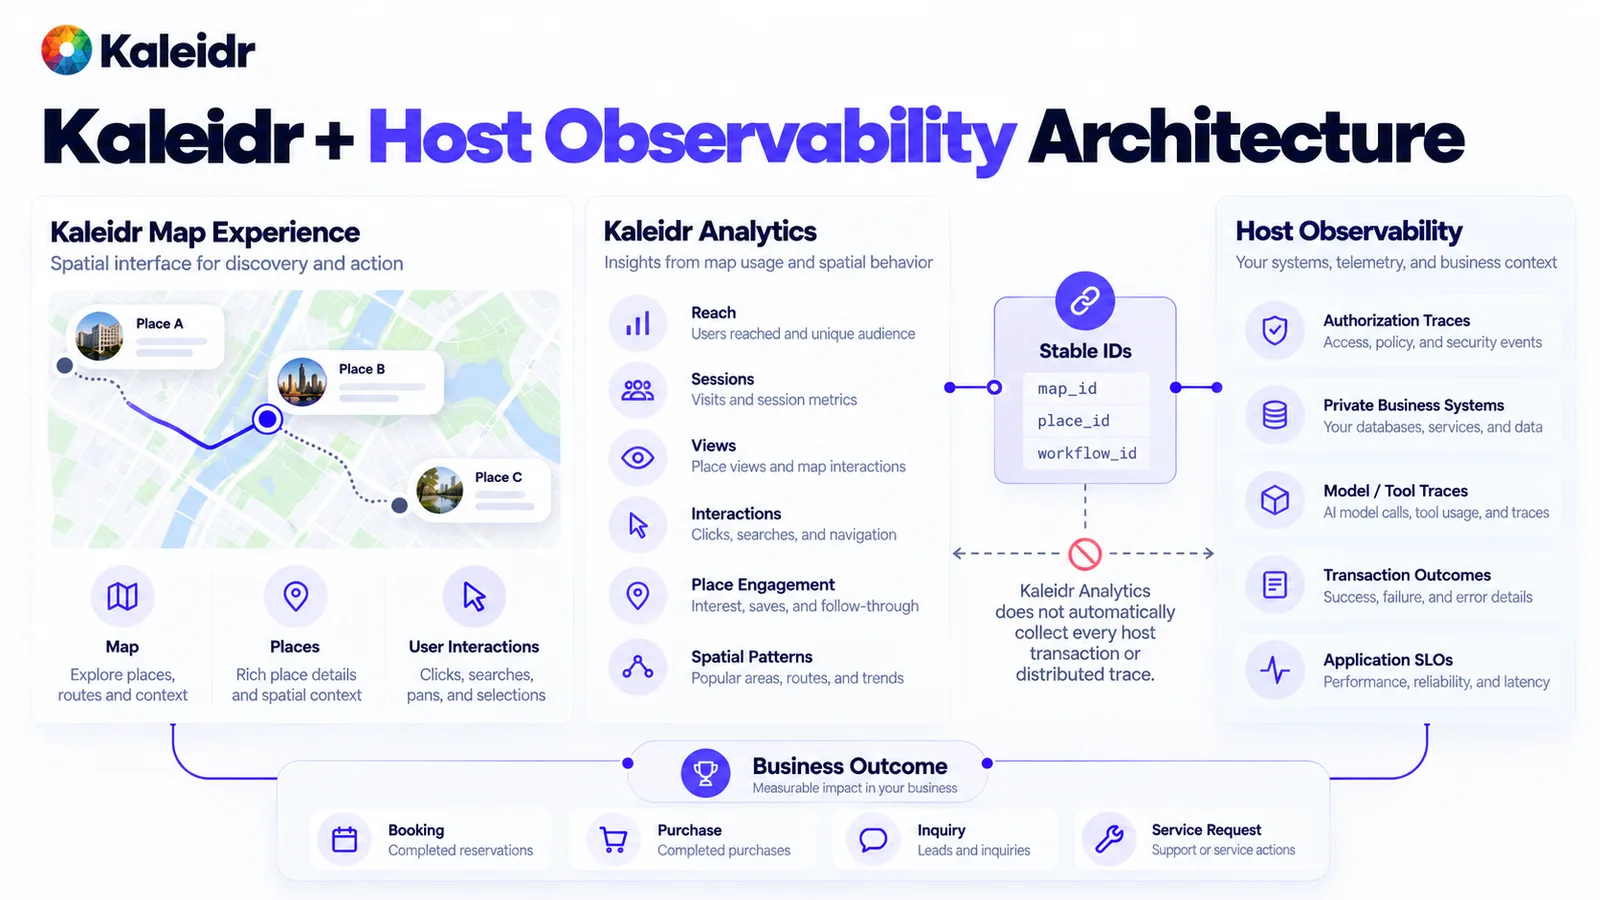
Analytics couvre l’engagement documenté avec les cartes et les lieux. La colonne hôte couvre les traces privées et les résultats des transactions. La jonction est un identifiant ; les indicateurs de réservation et d’achat sont des enregistrements de l’hôte, et non une affirmation selon laquelle Kaleidr Analytics stocke ces transactions.
Kaleidr Enterprise est la couche d’intelligence spatiale qu’une équipe produit peut ajouter à côté de cette pile hôte, avec notamment des APIs d’inférence, du classement et Analytics (Kaleidr, 2026). Les signaux de la carte et de l’assistant ne remplacent toujours pas un résultat détenu par le système hôte ni une valeur unitaire approuvée par la finance. Le guide ROI de Kaleidr rend cette séparation explicite : les signaux avancés expliquent le chemin, et l’enregistrement du système hôte porte la valeur (Kaleidr, 2026).
Comment l’observabilité de la Spatial AI devient-elle un gate de mise en production ?
Avant qu’un workflow sensible à la localisation ne passe à l’échelle, l’équipe doit pouvoir répondre à une courte liste de questions à partir de la trace seule. Quelle version de politique a autorisé les enregistrements ? Quels IDs de lieux ont été récupérés et quels codes de raison ont éliminé les autres ? Quel itinéraire et quelle politique de classement ont été exécutés ? Quelles versions de modèle et d’outil étaient actives ? Quelle action cartographique a été exécutée, et le travail du système hôte s’est-il terminé ? Le contenu sensible doit être minimisé, les versions doivent être enregistrées et les incidents de production doivent utiliser le même vocabulaire de défaillance que la suite hors ligne. Découvrir Kaleidr Analytics pour l’engagement documenté avec les cartes et les lieux. Découvrir Kaleidr Enterprise pour ajouter des capacités spatiales aux côtés des systèmes qui possèdent déjà les utilisateurs, les données et les résultats.
Remarque : Kaleidr utilise des outils assistés par IA pour la création d’images, l’amélioration du contenu et la recherche dans l’ensemble de ses workflows créatifs et de développement.
FAQ
L’observabilité de la Spatial AI est-elle la même chose que le monitoring d’un modèle de langage ?
Non. La latence du modèle, les tokens et les erreurs d’outils couvrent un seul span. L’identité des lieux, les permissions, les données métier, les services géographiques, le classement, l’état de la carte et le résultat du système hôte peuvent tous modifier le fait que le résultat soit correct ou non.
Faut-il enregistrer les prompts des utilisateurs ?
N’enregistrez les prompts qu’avec un besoin défini, une durée de conservation et un contrôle d’accès. De nombreuses requêtes de localisation contiennent des adresses privées ou des informations métier qu’une trace n’a pas besoin de conserver intégralement.
Faut-il stocker la localisation précise de l’utilisateur dans les traces ?
Utilisez la géographie la plus grossière qui répond à la question opérationnelle, par exemple un code de marché, un ID de lieu ou un ID d’itinéraire.
Quelle est la différence entre monitoring et évaluation ?
Le monitoring observe le comportement réel en production. L’évaluation teste des cas définis par rapport à une ground truth. Un programme solide utilise un vocabulaire commun de défaillance afin qu’un incident puisse devenir un test et qu’une régression puisse être visible après le lancement.
Quelle est la métrique la plus importante ?
Il n’existe pas de métrique universelle. Reliez la mesure au travail : qualité des résultats éligibles, résolution des lieux, justesse du no-result, succès du routage, exactitude de l’autorisation ou accomplissement de la tâche.
Comment tracer les appels d’outils ?
Enregistrez le nom de l’outil, la validation du schéma, l’autorisation, le résultat de la politique, le statut d’exécution, la latence et la raison d’échec. Gardez une action proposée distincte d’une action exécutée et d’un résultat du système hôte terminé.
Kaleidr Analytics remplace-t-il l’observabilité de l’application ?
Non. La page publique Analytics décrit l’engagement avec les cartes et les lieux, les sessions, les vues, les interactions, l’activité de l’audience et les motifs spatiaux. Les traces des services privés, l’autorisation interne et les résultats des transactions restent chez l’hôte, sauf indication contraire d’une intégration spécifique.
OpenTelemetry peut-il être utilisé pour la Spatial AI ?
Oui. OpenTelemetry constitue une base pratique pour les traces, métriques, logs, événements et conventions actuelles de l’IA générative. Les équipes peuvent ajouter des attributs documentés pour les IDs de lieux, IDs d’itinéraires, l’éligibilité, le classement, les actions cartographiques et les raisons de no-result lorsque les conventions partagées ne les nomment pas déjà.
Références
- Kaleidr. Spatial AI Accuracy Evaluation. https://kaleidr.com/blog/spatial-ai-accuracy-evaluation
- Kaleidr. An Enterprise Spatial AI Pilot Before Scaling. https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling
- OpenTelemetry. Semantic Conventions for Events. Operations with a duration belong in spans. Checkpoints and point-in-time outcomes are event candidates. Accessed October 1, 2026. https://opentelemetry.io/docs/specs/semconv/general/events/
- OpenTelemetry. Inside the LLM Call: GenAI Observability with OpenTelemetry. James Newton-King, May 14, 2026. https://opentelemetry.io/blog/2026/genai-observability/
- OpenTelemetry. Semantic Conventions. Documentation labeled 1.44.0. Accessed October 1, 2026. https://opentelemetry.io/docs/specs/semconv/
- OpenTelemetry. Generative AI Semantic Convention Attributes. Registry warns that retrieval query text may contain sensitive information. Accessed October 1, 2026. https://opentelemetry.io/docs/specs/semconv/registry/attributes/gen-ai/
- Kaleidr. Private Location Data for AI Map Workflows. https://kaleidr.com/blog/private-location-data-for-ai-map-workflows
- Kaleidr. Grounded Spatial AI for Business Data. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- National Institute of Standards and Technology. AI RMF Playbook, Measure. Production monitoring, drift, and the difference from pre-deployment testing. Notes that the AI RMF 1.0 is being updated and that the playbook will be revised afterward. Accessed October 1, 2026. https://airc.nist.gov/airmf-resources/playbook/measure/
- Kaleidr. Map Engagement and Location Analytics. Accessed October 1, 2026. https://kaleidr.com/analytics
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed October 1, 2026. https://kaleidr.com/enterprise
- Kaleidr. Spatial AI ROI Business Case. https://kaleidr.com/blog/spatial-ai-roi-business-case
@misc{kaleidr_accuracy_observability_2026,
  title  = {Spatial AI Accuracy Evaluation},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-ai-accuracy-evaluation}
}

@misc{kaleidr_pilot_observability_2026,
  title  = {An Enterprise Spatial AI Pilot Before Scaling},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling}
}

@misc{otel_events_2026,
  title  = {Semantic Conventions for Events},
  author = {{OpenTelemetry}},
  year   = {2026},
  note   = {Accessed October 1, 2026},
  url    = {https://opentelemetry.io/docs/specs/semconv/general/events/}
}

@misc{otel_genai_observability_2026,
  title  = {Inside the LLM Call: GenAI Observability with OpenTelemetry},
  author = {Newton-King, James},
  year   = {2026},
  note   = {May 14, 2026},
  url    = {https://opentelemetry.io/blog/2026/genai-observability/}
}

@misc{otel_semconv_2026,
  title  = {Semantic Conventions},
  author = {{OpenTelemetry}},
  year   = {2026},
  note   = {Documentation labeled 1.44.0. Accessed October 1, 2026},
  url    = {https://opentelemetry.io/docs/specs/semconv/}
}

@misc{otel_genai_attributes_2026,
  title  = {Generative AI Semantic Convention Attributes},
  author = {{OpenTelemetry}},
  year   = {2026},
  note   = {Accessed October 1, 2026},
  url    = {https://opentelemetry.io/docs/specs/semconv/registry/attributes/gen-ai/}
}

@misc{kaleidr_private_location_2026,
  title  = {Private Location Data for AI Map Workflows},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/private-location-data-for-ai-map-workflows}
}

@misc{kaleidr_grounded_observability_2026,
  title  = {Grounded Spatial AI for Business Data},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/grounded-spatial-ai-business-data}
}

@misc{nist_rmf_playbook_measure_2026,
  title  = {AI RMF Playbook, Measure},
  author = {{National Institute of Standards and Technology}},
  year   = {2026},
  note   = {Accessed October 1, 2026. Page states the playbook will be updated after the AI RMF revision},
  url    = {https://airc.nist.gov/airmf-resources/playbook/measure/}
}

@misc{kaleidr_analytics_observability_2026,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed October 1, 2026},
  url    = {https://kaleidr.com/analytics}
}

@misc{kaleidr_enterprise_observability_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed October 1, 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_roi_observability_2026,
  title  = {Spatial AI ROI Business Case},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-ai-roi-business-case}
}