
L’intégration des données pour l’IA spatiale relie le CRM, les stocks, les réservations, le transport et les systèmes de capteurs à une décision géographique, tandis que chaque système conserve le fait qu’il possède déjà. Une carte ne peut afficher ensemble un magasin, un bus et une réservation que si l’identité, la fraîcheur et les autorisations survivent à la jointure. Une architecture utile choisit un schéma pour chaque type de changement, puis explique le résultat à partir de ces enregistrements.
Les sections ci-dessous distinguent six façons de faire circuler les données, puis les appliquent au transport, aux capteurs, aux réservations et aux enregistrements privés. Un seul fichier nocturne peut encore être le bon choix pour un catalogue qui change rarement. Une position en direct exige un autre contrat.
Principes essentiels de l’intégration des données pour l’IA spatiale
- Nommer le propriétaire : chaque champ possède un système de référence, un identifiant canonique et une règle de fraîcheur avant le choix d’un connecteur.
- Adapter le schéma au changement : batch, requête en direct, événements, flux, API de features spatiales et écriture en retour validée répondent à des besoins différents.
- Lier tôt les faits stables : l’identité et la géométrie d’un magasin peuvent réduire l’ensemble. Stocks, horaires et trafic doivent être interrogés au dernier moment raisonnable.
- Placer l’autorisation avant la jointure : une jointure spatiale de tous les enregistrements privés constitue déjà une divulgation, même si la réponse masque certaines lignes.
- Laisser la transaction dans son système : une recommandation peut nommer un lieu. Le système hôte revalide, confirme et enregistre la réservation ou le paiement.
Qu’est-ce que l’intégration des données pour l’IA spatiale ?
L’intégration des données pour l’IA spatiale consiste à amener des enregistrements opérationnels jusqu’à une décision géographique sans les aplatir dans un flux anonyme unique. Le CRM détient le client. Le système de stock détient les quantités. Un système de réservation détient la disponibilité et la transaction. Le transport détient un réseau planifié et un état en direct. L’IoT détient des observations. La carte est l’endroit où ces faits deviennent un lieu, un itinéraire, un classement et une explication. L’intégration échoue lorsqu’un identifiant de magasin change de sens en cours de route ou lorsqu’une quantité périmée est traitée comme actuelle.
Cinq tâches se situent entre la source et l’expérience. L’identité résout le même magasin, client ou actif entre plusieurs systèmes. L’autorisation décide quel tenant, quel objet et quel champ peuvent entrer dans la requête. La normalisation place ces champs dans un schéma commun avec une localisation et un temps associés. La fraîcheur enregistre le dernier moment où un batch, une requête ou un flux a parlé. Une jointure spatiale fusionne ensuite les lignes autorisées par lieu. Le schéma de couverture suit cet ordre, depuis les cinq sources jusqu’à une carte unique avec des lieux classés, un itinéraire, une explication et une action validée.
Considérez les encadrés d’exemple de ce schéma comme des illustrations. « Client près du magasin », « stock élevé » et « prochain transport dans 6 min » montrent le type de phrase qu’un résultat fondé peut soutenir. Ces phrases ne sont pas un résultat mesuré de Kaleidr, et la carte n’affirme pas qu’un seul produit stocke déjà toutes les sources.
Pourquoi un produit a-t-il besoin de six schémas ?
Un produit géographique a souvent besoin de six schémas d’intégration parce que les faits évoluent à des vitesses différentes et comportent des risques différents. Un batch ou un snapshot convient à un catalogue lent. Une requête en direct convient à un fait volatil qui doit être actuel avant toute recommandation ou action. Un événement convient à un changement métier important, comme la fermeture d’un magasin pour l’après-midi. Un flux convient à un état opérationnel à haute fréquence, comme un véhicule en mouvement. Une API de features spatiales convient à une collection géographique interrogeable. Une écriture en retour validée convient à une action qui doit aboutir dans le système de référence. Forcer les six dans un seul fichier nocturne, ou dans un seul appel de modèle de langage, supprime la distinction dont dépend la décision.
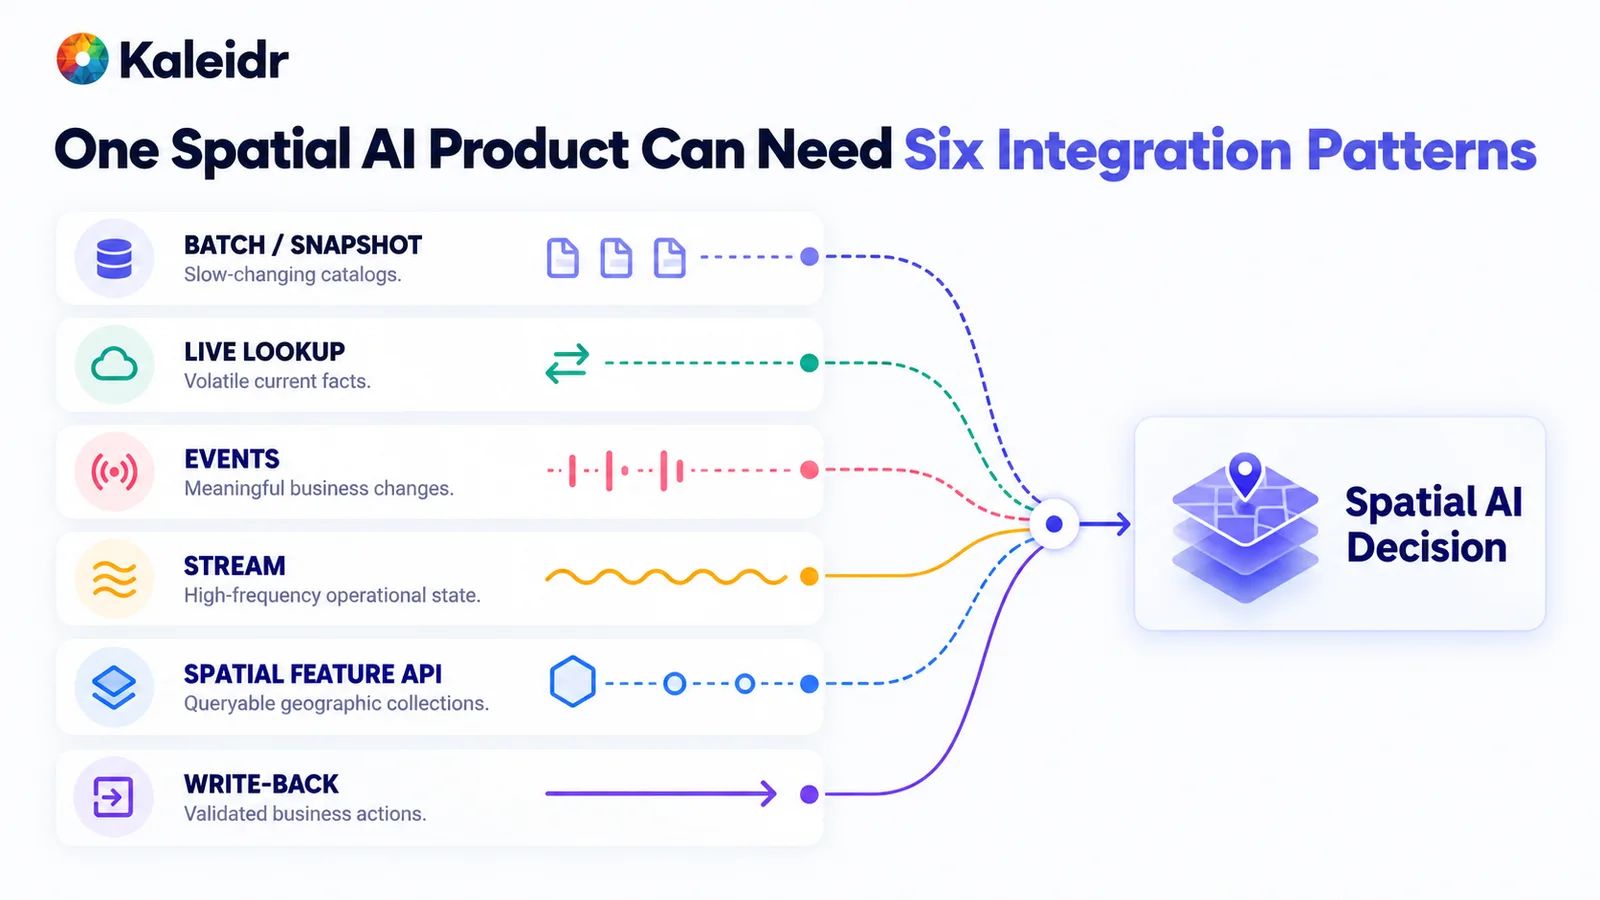
Les six schémas décrivent la façon dont un fait se déplace, pas quel fournisseur gagne. Le batch transporte un snapshot lent. Les requêtes en direct, événements et flux transportent des changements plus rapides. Une API de features spatiales expose des collections géographiques, et l’écriture en retour renvoie une action validée. Le schéma représente une séparation architecturale, pas un score Kaleidr.
OGC API - Features est une forme pratique du cinquième schéma. La norme décrit une API géospatiale pour les données de features, adaptée aux lieux, limites et autres collections qu’un produit doit interroger plutôt que copier intégralement (OGC, 2026). Utilisez cette forme lorsque la collection est déjà géographique et que les questions sont spatiales. Un niveau client, un prix ou une confirmation de réservation appartient toujours au système qui le possède, accessible par requête, événement ou écriture en retour. Les normes sont utiles lorsqu’elles correspondent au travail. Un logo sur un schéma ne l’est pas.
Quel système doit posséder chaque champ ?
Choisissez le propriétaire avant de choisir le connecteur. Un tableau utile nomme le domaine de données, le système de référence, l’identifiant canonique, la fraîcheur nécessaire, le schéma d’intégration et ce que la couche d’IA peut faire de ce fait. L’identité et les coordonnées d’un magasin peuvent vivre dans un référentiel de lieux et être déplacées en batch, parce qu’elles sont stables. Le stock peut vivre dans le système d’inventaire, indexé par SKU et magasin, et être interrogé en direct parce qu’il évolue. Les horaires peuvent venir d’un système de planification selon un calendrier. Le niveau client peut venir du CRM sous forme d’événement. Le temps de trajet peut venir d’un service de routage à la demande. Une réservation et un paiement restent dans le système de réservation et le point de vente, et la couche d’IA peut les résumer sans devenir le grand livre.
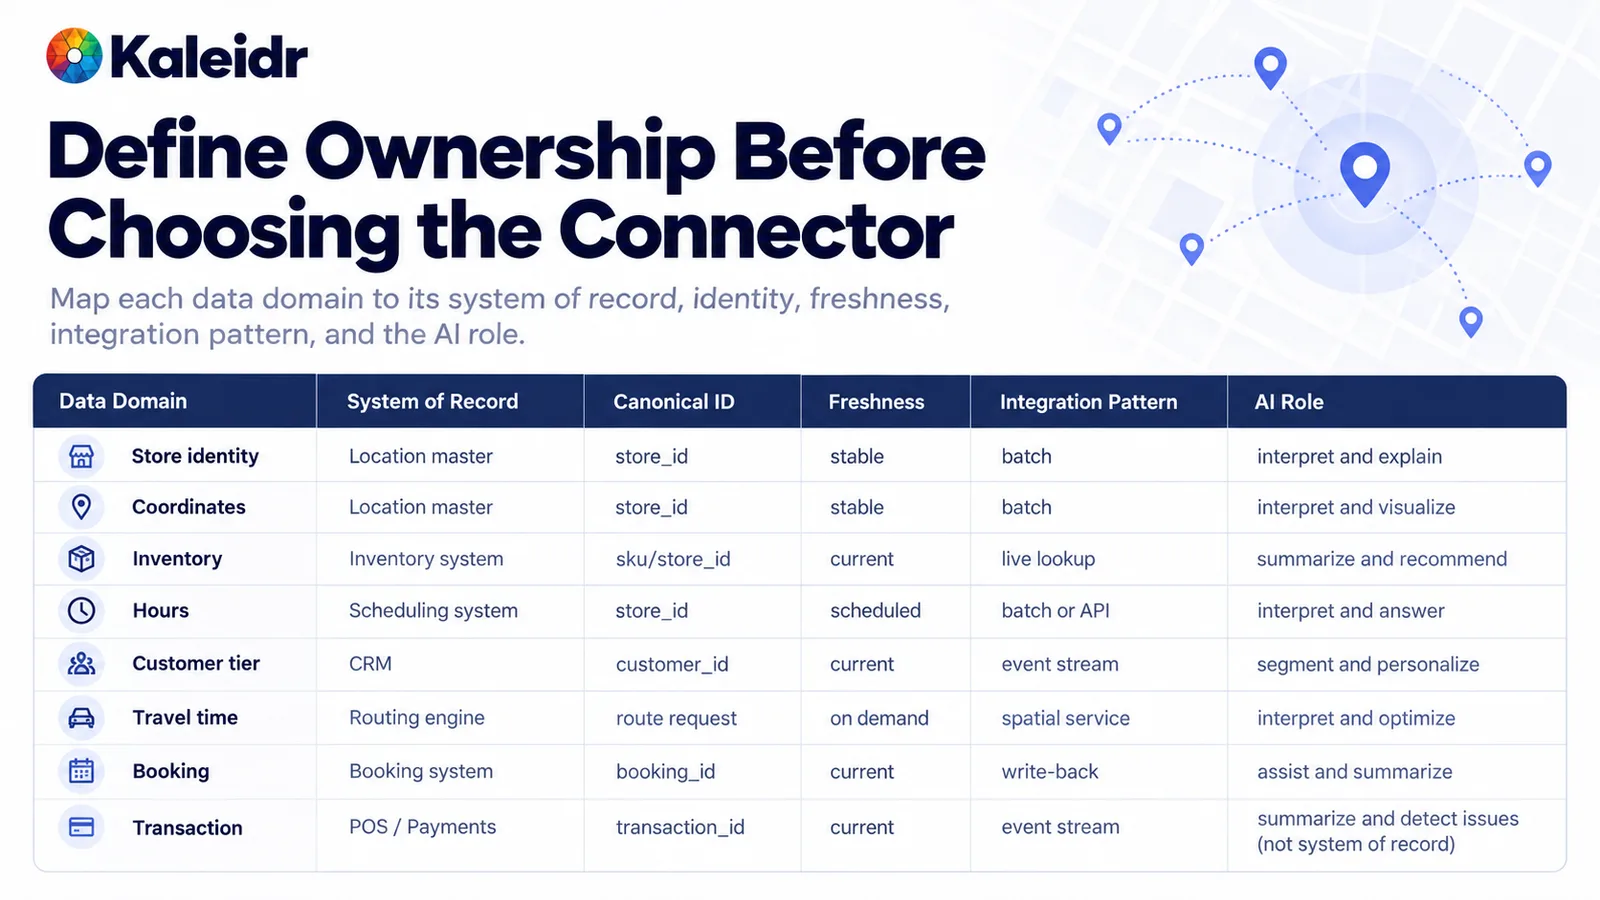
Chaque ligne relie un domaine au système qui le possède. Les faits stables sur les lieux utilisent un batch et un identifiant de magasin. Stock, horaires, niveau, temps de trajet et réservations, plus volatils, utilisent des schémas plus rapides. La colonne IA limite la couche à l’interprétation, au résumé ou à l’assistance. Le tableau est une grille de planification, pas un export Kaleidr.
Le même magasin doit conserver un identifiant canonique après chaque enrichissement. Un système source peut utiliser sa propre clé, et l’intégration mappe cette clé au lieu d’inventer un nouveau magasin pour chaque flux. L’autorité sur l’adresse et les coordonnées doit être explicite, afin qu’un géocodeur ne remplace pas silencieusement une position relevée. Inconnu est un état différent de faux : l’absence d’un enregistrement d’horaires ne prouve pas que le magasin est fermé. Conservez la source, la version du schéma et l’heure d’observation à côté des champs normalisés afin qu’une explication ultérieure puisse dire quel enregistrement elle a utilisé.
Pourquoi lier tôt les faits stables et tard les faits volatils ?
Les données stables peuvent réduire la recherche avant de payer un appel en direct. Un snapshot nocturne des magasins, un filtre géographique sur les magasins le long de l’itinéraire, puis seulement une vérification en direct du stock, des horaires et un classement par routage constituent un ordre moins coûteux et plus sûr que d’interroger chaque API pour chaque magasin. Les faits volatils appartiennent au dernier moment raisonnable, car une quantité ou une fermeture peut changer entre le fichier nocturne et la question du client. La figure suit un parcours illustratif : snapshot, filtre de corridor, requête en stock, vérification des horaires, classement par détour et un arrêt suggéré. Les volumes et les minutes de détour de la figure ne sont que des illustrations.
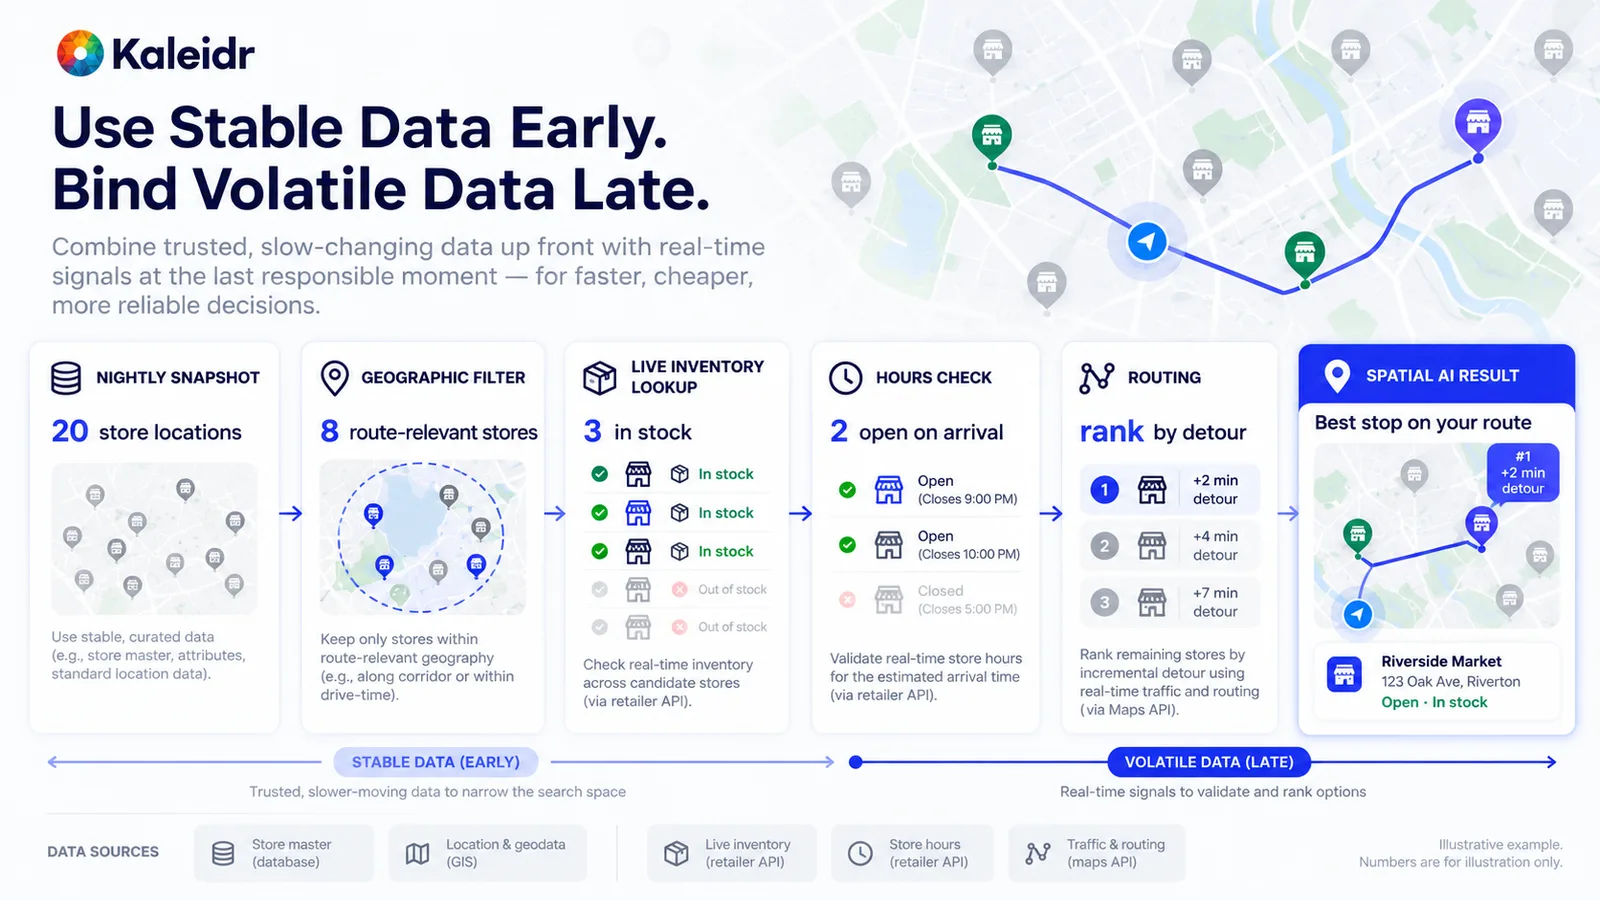
Les données stables sur les lieux réduisent l’ensemble avant le début des appels en direct. Le stock, les horaires et le trafic sont vérifiés tard, sur les candidats restants. La carte finale montre un arrêt suggéré avec un nom et un détour d’exemple. Les chiffres sont illustratifs et ne constituent pas une mesure Kaleidr.
Gardez les calculs spatiaux hors des adaptateurs de source. L’API d’inventaire renvoie le stock. Le service de routage renvoie le temps de trajet. L’éligibilité retire un magasin fermé ou en rupture avant que le classement n’ordonne le reste. Le modèle de langage peut interpréter la requête et expliquer le choix restant. Lui demander d’inventer la distance, la quantité en stock ou les horaires recrée le fait à l’endroit le moins fiable. Si la recommandation change après l’import nocturne, l’équipe doit savoir quelle version du jeu de données a fourni la liste des magasins.
Que doit changer un événement ?
Un événement indique qu’un changement significatif s’est produit. Un magasin a fermé pour l’après-midi, une annonce est devenue active, une réservation a été annulée ou une zone de service a bougé. Le producteur publie ce changement, un broker le diffuse, et les consommateurs mettent à jour l’état courant, un index de recherche, une couche cartographique et un cache de retrieval. Un événement n’est pas une base de données complète, et le consommateur a toujours besoin d’une sémantique d’état : savoir si le payload est le nouvel enregistrement complet, un champ modifié ou seulement un identifiant nécessitant une requête ultérieure. CloudEvents décrit les données d’événement de manière commune afin que les éditeurs cessent d’inventer une nouvelle enveloppe pour chaque consommateur (CloudEvents, 2026).
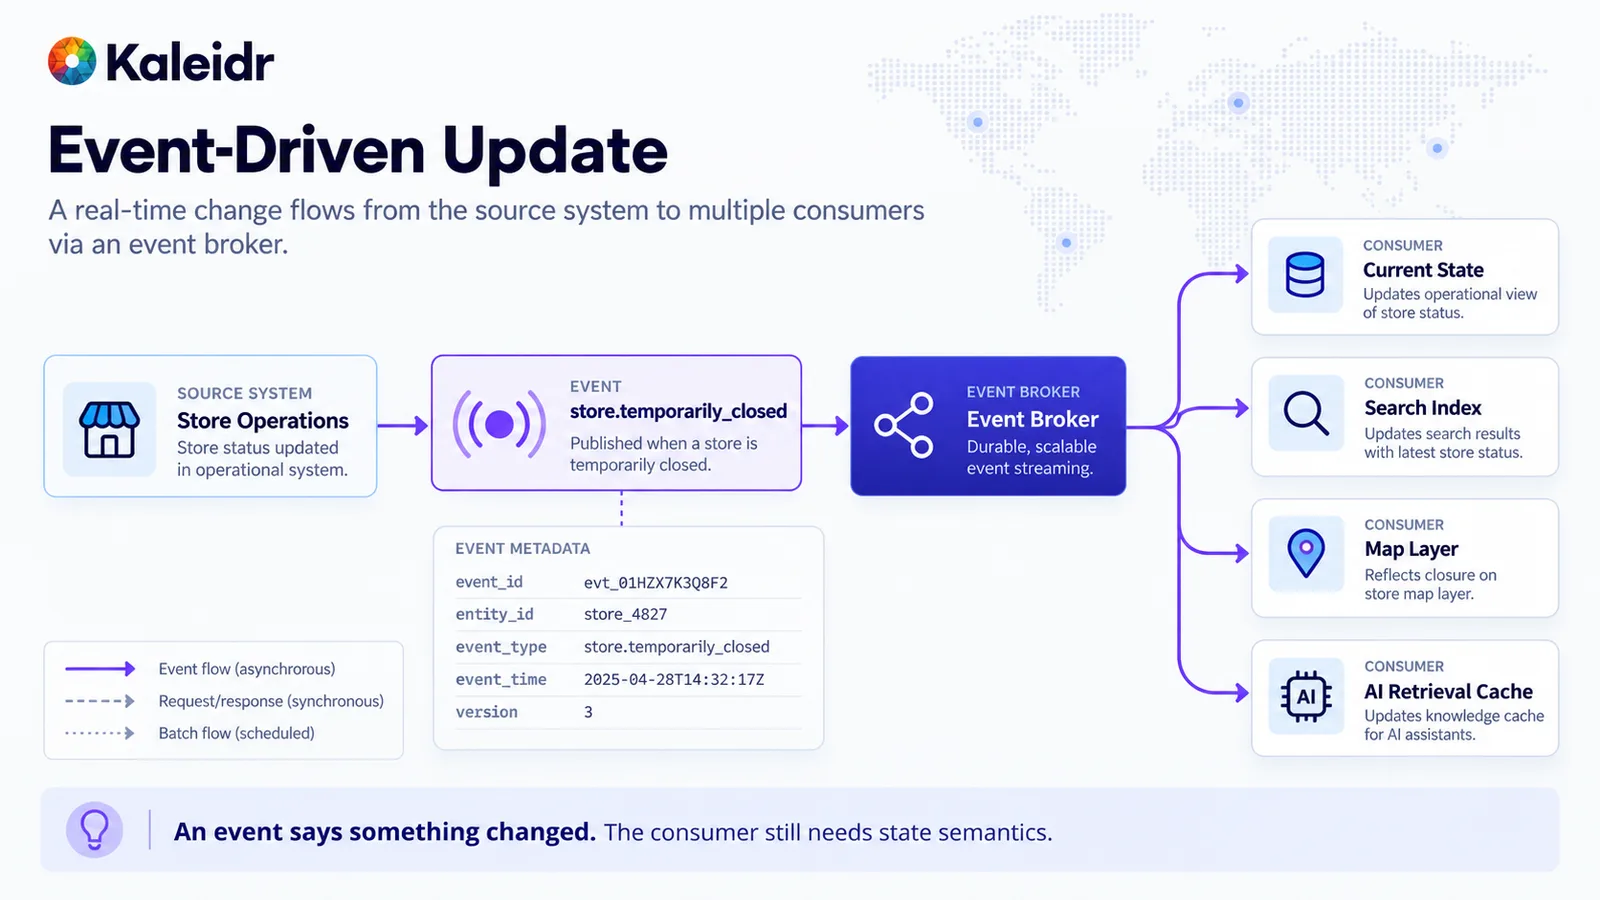
La source publie un changement métier, et le broker le distribue à plusieurs consommateurs. Des métadonnées telles qu’identifiant d’événement, entité, type, heure et version accompagnent la notification. Les identifiants d’exemple et l’horodatage sont illustratifs. Un événement signale un changement, et le consommateur doit encore appliquer la sémantique d’état.
Concevez le consommateur pour les réessais et les doublons. Le même avis de fermeture peut arriver deux fois, ou un avis plus récent peut arriver en premier. Un identifiant d’événement, un identifiant d’entité, une heure d’événement et une version de schéma permettent de le détecter en sécurité. Mettez à jour l’enregistrement normalisé, puis invalidez le cache lu par la carte et l’étape de retrieval. L’alternative consiste à sonder indéfiniment chaque système, ce qui masque le moment où l’activité a réellement changé. Un flux de positions est un schéma différent, traité ensuite, car une position est un état continu plutôt qu’un fait métier unique.
Comment séparer le planning de transport et l’état en direct ?
GTFS est un exemple clair d’un domaine qui nécessite deux schémas. GTFS Schedule est une spécification de flux pour les informations statiques de transport public, composée de fichiers simples décrivant les arrêts, lignes, trajets et éléments associés du réseau (GTFS, 2026). La référence GTFS Realtime documente séparément les mises à jour de trajets, les positions de véhicules et les alertes de service (GTFS, 2026). Le planning peut arriver sous forme de snapshot. Le flux temps réel décrit ce qui se passe maintenant. Un planificateur de trajets les combine. Spatial AI explique ensuite les options sur une carte. Aplatir les deux flux dans un seul champ appelé données de transport efface la différence entre le plan et la perturbation.
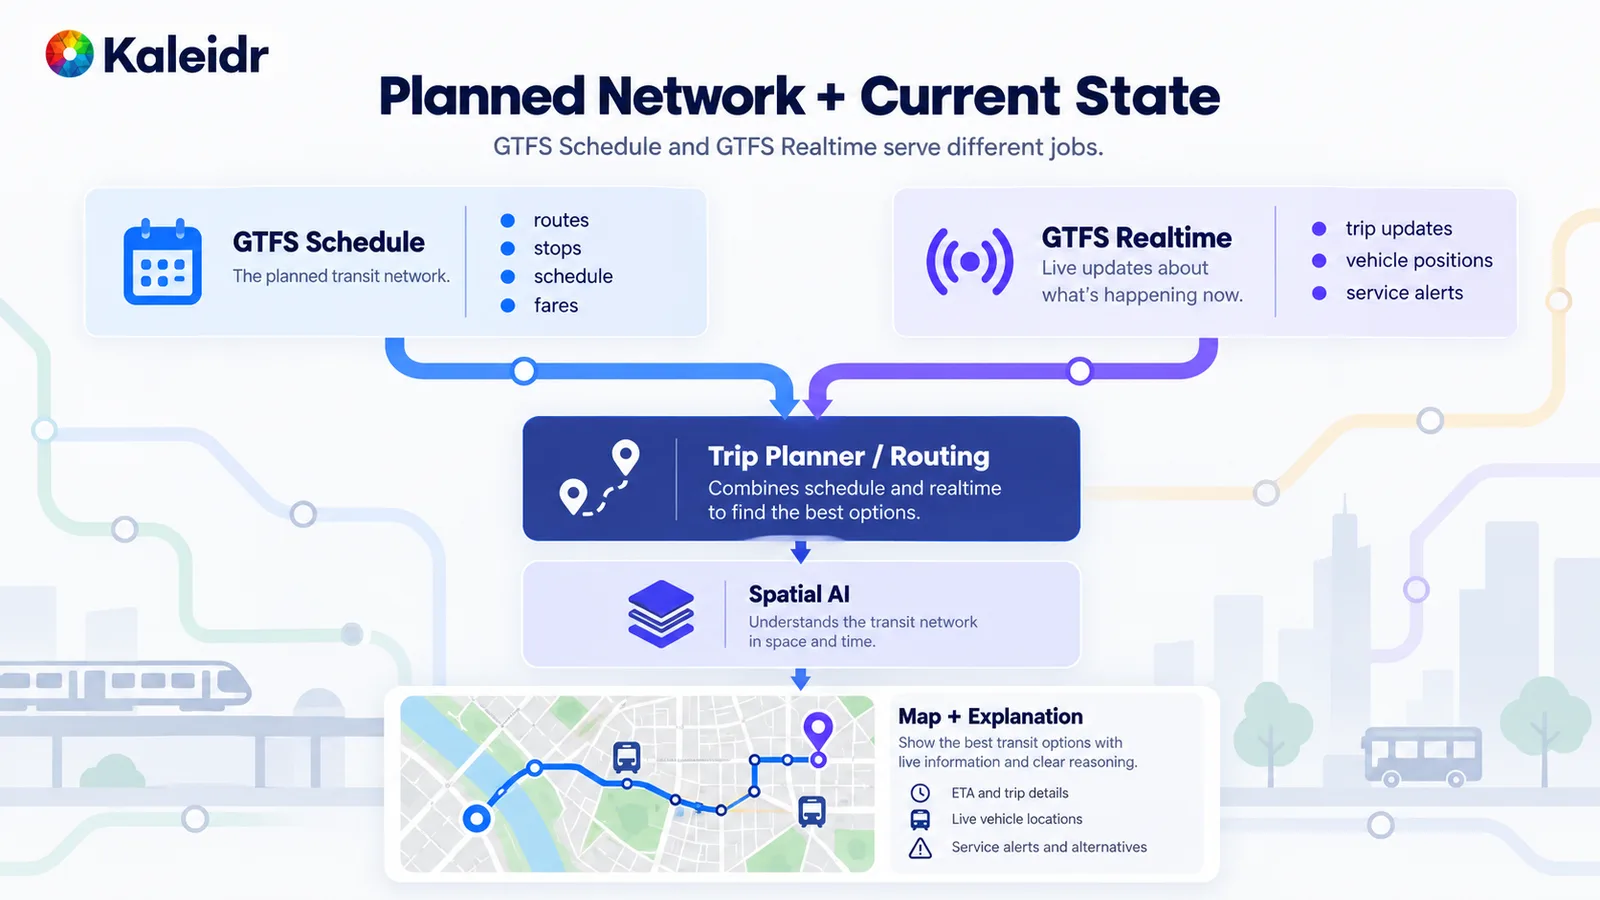
Le planning décrit le réseau prévu, y compris lignes, arrêts et trajets. Le flux temps réel transporte les mises à jour de trajets, les positions des véhicules et les alertes de service. Un planificateur combine ces entrées, puis la carte explique le résultat. Le diagramme sépare les deux rôles de GTFS, et le modèle de langage n’est pas le moteur de routage.
La même séparation existe en dehors du transport. L’adresse d’un magasin est le planning. Le stock et la fermeture du jour sont le flux temps réel. Un calcul d’itinéraire est un troisième service, avec sa propre fraîcheur. Ne demandez pas à un modèle de langage de reconstruire un graphe de transport à partir de fichiers de flux bruts, et ne considérez pas une position de véhicule datant de ce matin comme une preuve de l’endroit où se trouve le bus maintenant. Affichez l’arrêt, le véhicule et l’alerte comme des couches distinctes lorsque le produit doit permettre au voyageur de les distinguer.
Comment un flux de capteurs devient-il un lieu ?
Une lecture brute de capteur n’est pas encore une position cartographique. Les appareils, véhicules et capteurs peuvent publier via MQTT ou une autre API de télémétrie. OASIS décrit MQTT Version 5.0 comme un protocole léger de publication/abonnement adapté aux communications machine-à-machine et Internet des objets (OASIS, 2019). La norme OGC SensorThings API fournit une approche géospatiale pour interconnecter des appareils IoT, des données et des applications sur le web, avec la détection et le pilotage comme deux fonctions principales (OGC, 2026). Après ingestion, validez le schéma, normalisez l’enregistrement et stockez l’état courant avec une heure d’observation et un âge de fraîcheur. Ce n’est qu’alors qu’une couche spatiale place l’actif. La couche d’IA, la carte et les opérations lisent cet état. Elles ne doivent pas s’abonner au flot brut.
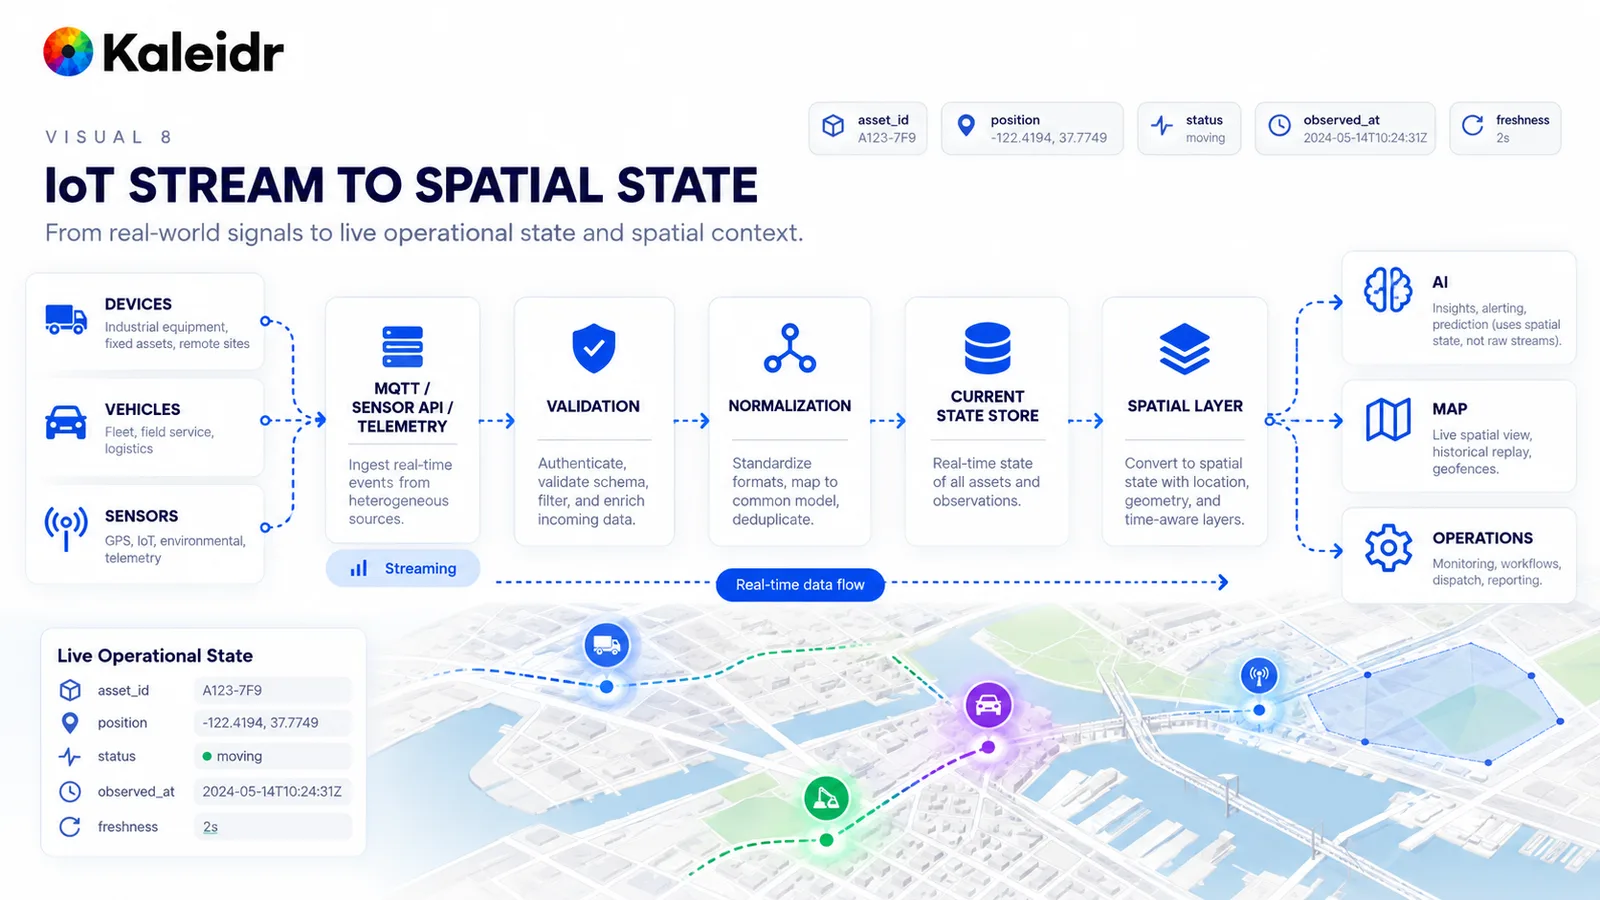
La télémétrie devient un enregistrement opérationnel courant avec un identifiant d’actif, une position, un état, une heure d’observation et un âge de fraîcheur. Les coordonnées d’exemple et l’horodatage de 2024 sont illustratifs. Validation et normalisation précèdent la couche spatiale. L’IA, la carte et les opérations lisent l’état, pas le flux non filtré.
Une température sans actif ni seuil n’est pas une réponse. La question « quel site frigorifique dépasse sa limite » nécessite le capteur, l’installation, la règle et le moment. Conservez l’analytique historique sur un chemin distinct du magasin d’état courant lorsque les volumes diffèrent. Ajoutez de la backpressure afin qu’une rafale de mesures ne bloque pas la carte. Un capteur déconnecté doit apparaître comme inconnu, pas comme un zéro silencieux.
Pourquoi une recommandation n’est-elle pas une transaction ?
Une recommandation spatiale peut nommer un lieu. Le système de réservation hôte vérifie encore la disponibilité, le prix et l’autorisation, confirme la demande et enregistre la transaction. Cette frontière compte lorsque deux personnes peuvent sélectionner la même chambre ou le même créneau de retrait. Le guide de réservation géolocalisée maintient le choix lié au stock en direct, au contexte de déplacement et à l’éligibilité (Kaleidr, 2026). L’identifiant de lieu et l’identifiant de transaction d’exemple figurant sur le schéma sont des étiquettes pour ce transfert, pas une réservation Kaleidr réelle. Kaleidr peut afficher le résultat confirmé sur la carte après que le système hôte l’a renvoyé. Kaleidr ne devient pas le grand livre parce qu’une épingle a bougé.
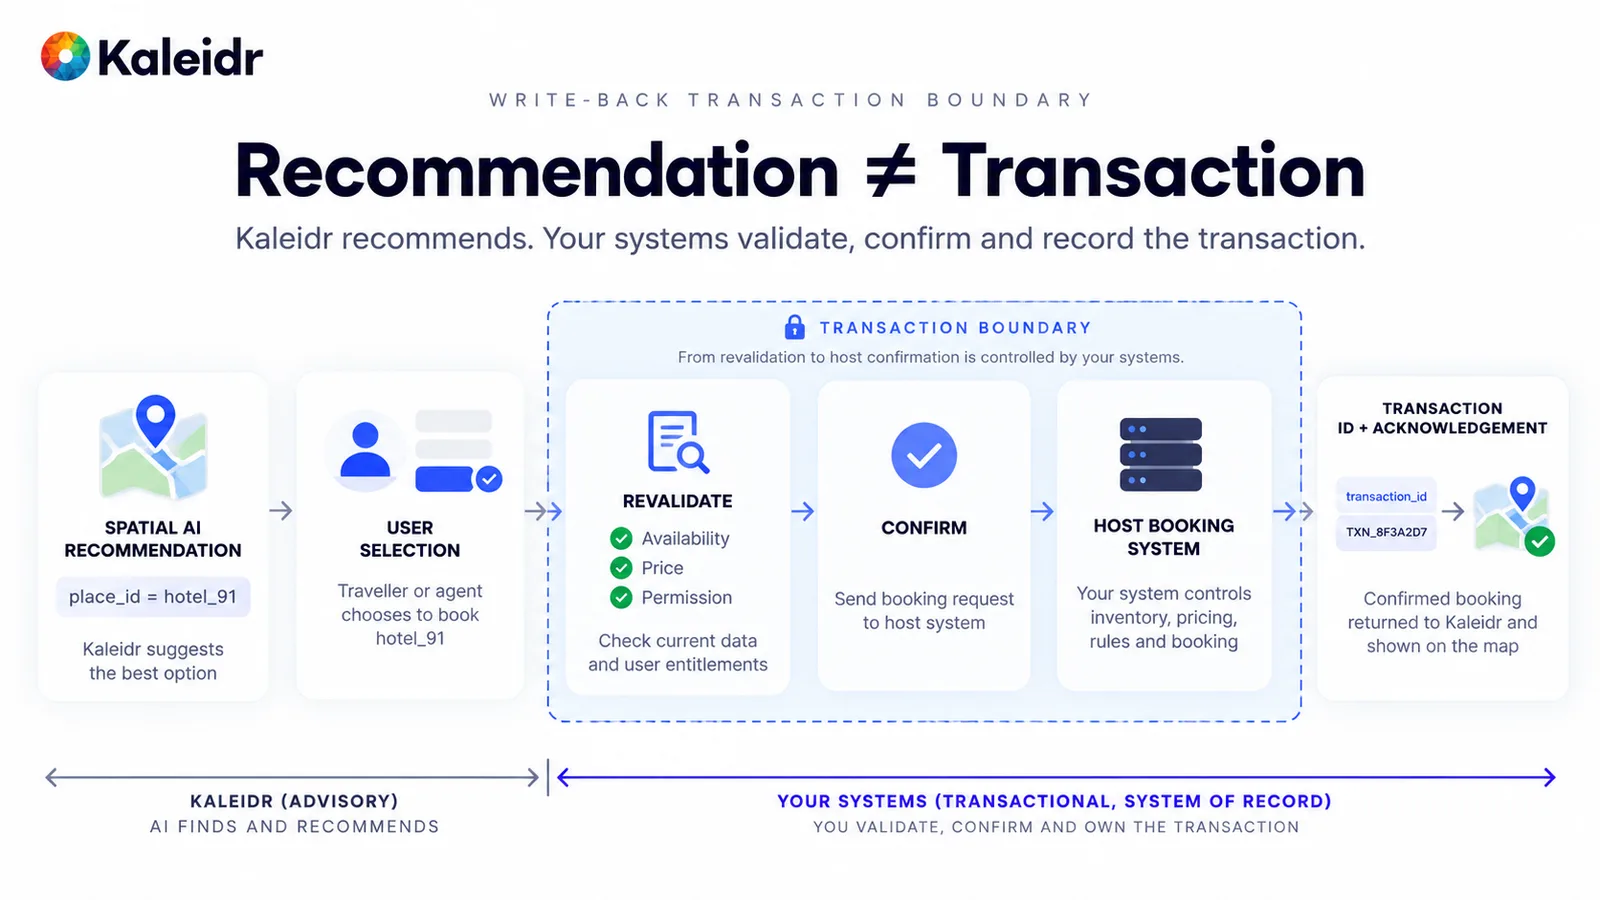
Le côté gauche trouve et recommande un lieu. La frontière transactionnelle revalide disponibilité, prix et autorisation, puis confirme dans le système hôte. Un identifiant de transaction d’exemple revient pour être affiché sur la carte. Les identifiants sont illustratifs et le système hôte reste le système de référence.
Appliquez la même règle à toute action qui modifie de l’argent, du stock ou les droits d’une personne. Revalidez immédiatement avant l’écriture, car la requête ayant alimenté l’explication peut déjà être obsolète. Renvoyez l’accusé du système hôte, y compris un conflit, afin que la carte n’affiche pas un succès refusé par le grand livre. Une ligne de prompt comme « ne jamais réserver sans autorisation » peut guider le comportement. Cette phrase n’est pas la frontière transactionnelle.
Pourquoi l’autorisation doit-elle précéder la jointure ?
La capacité à joindre des données n’est pas une autorisation de les utiliser. Un flux autorisé résout l’utilisateur, le tenant, l’objet et le champ, puis joint uniquement les enregistrements et les couches qui passent ces contrôles, et seulement ensuite construit le contexte de l’explication. Un chemin bloqué joint d’abord tous les enregistrements privés et espère que le modèle masquera ceux que l’utilisateur ne doit pas voir. La jointure a déjà utilisé des données non autorisées. Le guide sur les données de localisation privées place les contrôles de tenant, d’objet et de champ avant que les enregistrements privés atteignent un calcul spatial ou une réponse cartographique (Kaleidr, 2026).
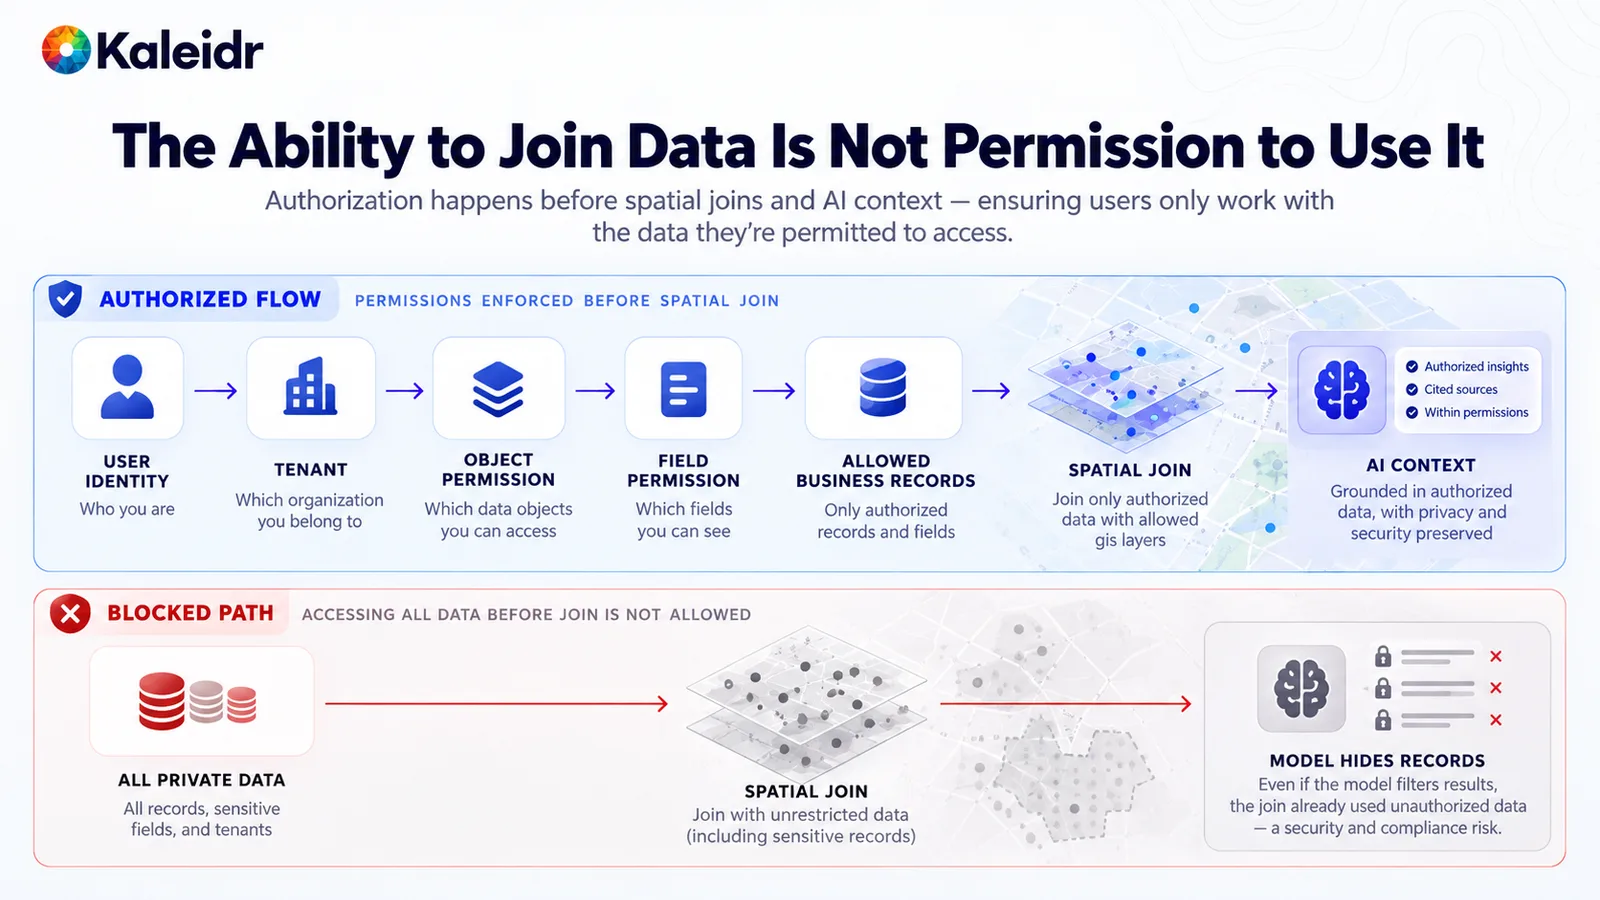
Le chemin supérieur filtre l’identité, le tenant, les objets et les champs avant la jointure spatiale et l’explication. Le chemin inférieur joint tous les enregistrements privés puis essaie seulement ensuite de masquer des lignes. Un filtre dans la réponse ne peut pas annuler une jointure qui a déjà lu des enregistrements interdits. L’autorisation est une condition préalable, pas une légende du résultat.
Préservez ce contexte d’autorisation à chaque étape. Un cache, un index de retrieval et une couche cartographique peuvent chacun devenir une seconde copie d’un champ privé. Partitionnez-les par tenant et supprimez les champs que l’utilisateur ne peut pas voir avant d’écrire la copie. Le retrieval inter-tenant est un bug d’intégration de données même si la phrase finale paraît inoffensive. Journalisez les identifiants et le résultat de la politique, pas le payload privé.
À quoi ressemble le chemin de production ?
Une requête de production peut suivre une séquence stable même lorsqu’une question particulière saute une étape. L’application hôte authentifie l’utilisateur. Les sources candidates fournissent des snapshots, une API de features spatiales ou du contexte CRM. L’enrichissement en direct ajoute le stock, l’état de réservation ou l’état opérationnel. Les services spatiaux calculent l’itinéraire, la distance et la zone de service. L’éligibilité élimine les candidats invalides, puis le classement ordonne ceux qui restent. La couche d’IA interprète la demande et explique le résultat fondé. La carte montre le lieu ou l’itinéraire. L’écriture en retour validée revient vers le système de référence lorsque l’utilisateur agit. L’observabilité enregistre les identifiants, la source, la fraîcheur, les versions et le résultat le long de ce rail (Kaleidr, 2026). Une recherche d’attraction publique peut s’arrêter avant les données privées et l’écriture en retour. Un retrait tenant compte du stock peut utiliser presque toutes les étapes.
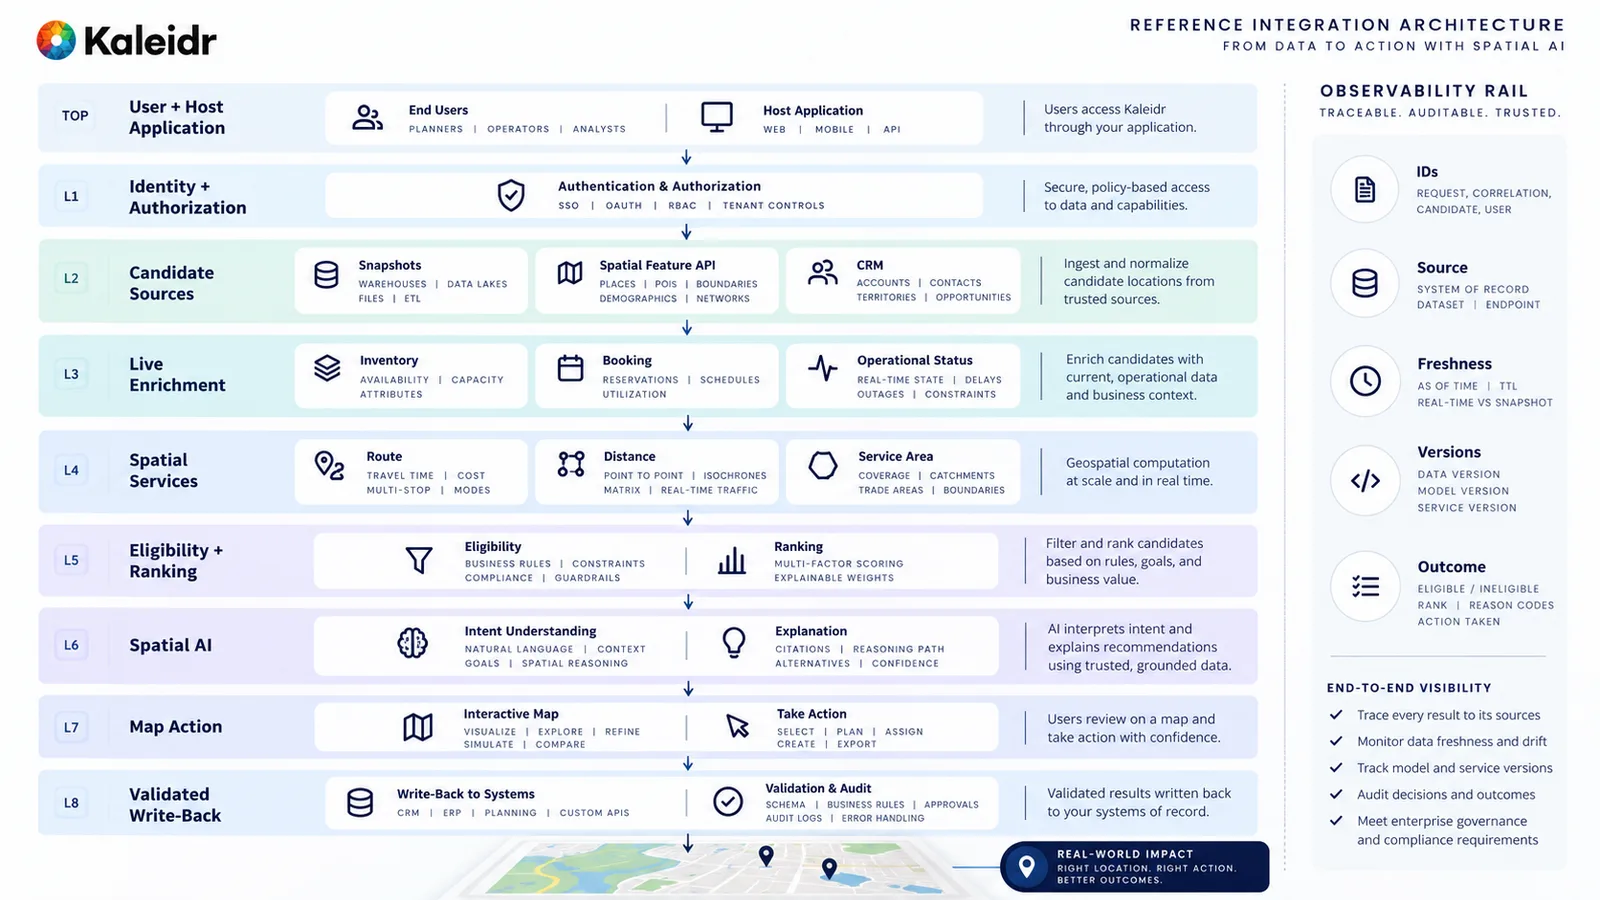
La pile descend de l’utilisateur hôte à l’autorisation, aux candidats, à l’enrichissement en direct, aux services spatiaux, à l’éligibilité, à l’explication, à la carte et à l’écriture en retour. Un rail d’observabilité enregistre identifiants, source, fraîcheur, versions et résultat. Toutes les requêtes n’utilisent pas toutes les couches. Le diagramme est un chemin de référence, pas l’affirmation qu’un déploiement doit tout activer.
Testez l’intégration avec des défaillances proches de la production, pas seulement avec une phrase bien formulée. Une réponse de stock absente, un capteur déconnecté, un conflit de réservation et un changement de schéma doivent chacun avoir une signification d’erreur et un comportement cartographique. Séparez l’état courant de l’analytique historique afin qu’une requête de tableau de bord ne bloque pas la vue en direct. Versionnez le schéma et la transformation, car un champ renommé ne doit pas devenir silencieusement un nouveau magasin.
Où Kaleidr s’insère-t-il dans cette pile ?
Kaleidr Enterprise est présenté sur sa page produit comme une infrastructure d’intelligence géographique avec des API d’inférence, des systèmes de classement et des fonctions d’analytics pour les produits spatiaux (Kaleidr, 2026). La documentation développeur décrit quatre surfaces sur une même plateforme : Chat apporte Spatial AI à la carte de l’hôte, Editor sert à dessiner et modifier, Tile fournit des fonds de carte conçus, et Viewer publie une carte (Kaleidr, 2026). La Platform API publique documente les appels chat, route, enrichissement POI et design. Cette page ne documente pas de connecteur universel pour CRM, inventaire, réservation, GTFS, MQTT ou base de données d’entreprise (Kaleidr, 2026). L’hôte conserve ces systèmes, l’autorisation de ses utilisateurs et la transaction.
Une séparation pratique place un contexte autorisé et déjà normalisé devant la couche spatiale. L’API d’inventaire de l’hôte reste autoritative, l’hôte vérifie l’autorisation et Chat explique une recommandation sur une carte que le produit exploite déjà. Pour une vue opérationnelle en direct, le système opérationnel reste la source de l’état courant tandis que Studio crée la présentation spatiale de marque (Kaleidr, 2026). Vérifiez le contrat Enterprise dans la documentation actuelle avant de construire sur un endpoint que l’API publique ne répertorie pas. Explorez Kaleidr Enterprise lorsque l’évaluation nécessite cette couche spatiale à côté des systèmes que l’organisation exploite déjà.
Remarque : Kaleidr utilise des outils assistés par IA pour la création d’images, l’amélioration de contenu et la recherche dans ses workflows créatifs et de développement.
FAQ
L’intégration des données pour l’IA spatiale signifie-t-elle un connecteur pour chaque système ?
Non. CRM, inventaire, réservation, transport et IoT évoluent à des vitesses différentes et présentent des risques différents. Batch, requêtes en direct, événements, flux, API de features spatiales et écriture en retour validée sont des schémas distincts. Un diagramme de connecteurs qui masque le système de référence n’a pas terminé la conception.
Un modèle de langage peut-il remplacer le système de réservation ou d’inventaire ?
Non. Le modèle de langage peut interpréter une demande et expliquer un résultat fondé. Le stock, la disponibilité, le prix et la transaction restent dans les systèmes qui les possèdent. Revalidez juste avant une écriture en retour et affichez l’accusé du système hôte sur la carte.
GTFS Schedule et GTFS Realtime doivent-ils partager un seul champ ?
Non. GTFS Schedule contient des informations statiques de transport public, notamment les arrêts, lignes et trajets. GTFS Realtime couvre les mises à jour de trajets, les positions de véhicules et les alertes de service. Un planificateur de trajets peut les combiner. Les regrouper dans un seul bloc de données de transport masque la différence entre le plan et la perturbation.
Une lecture de capteur est-elle déjà une position sur la carte ?
Non. Une lecture a besoin d’un actif, d’une position validée, d’une heure d’observation et d’un âge de fraîcheur avant d’appartenir à une couche spatiale. MQTT peut transporter le message, et un modèle de type SensorThings peut décrire la relation de détection. La carte et l’explication doivent lire l’état courant, pas le flux brut.
Kaleidr remplace-t-il le CRM, l’inventaire ou le système de réservation ?
Non. La documentation publique décrit Chat, Editor, Tile, Viewer et les appels Platform API pour chat, route, enrichissement POI et design. Elle ne documente pas de connecteur universel pour CRM, inventaire, réservation, GTFS ou MQTT. L’hôte conserve ces systèmes et la transaction. Kaleidr fournit à côté certaines capacités spatiales et cartographiques.
Références
- Open Geospatial Consortium. OGC API - Features. A geospatial API for feature data. Accessed October 3, 2026. https://ogcapi.ogc.org/features/
- CloudEvents. CloudEvents. A specification for describing event data in a common way. Accessed October 3, 2026. https://cloudevents.io/
- General Transit Feed Specification. GTFS Overview. GTFS Schedule is a common format for static public transportation information, including stops, routes, and trips. Accessed October 3, 2026. https://gtfs.org/documentation/overview/
- General Transit Feed Specification. GTFS Realtime Reference. Trip updates, vehicle positions, and service alerts. Accessed October 3, 2026. https://gtfs.org/documentation/realtime/reference/
- OASIS. MQTT Version 5.0. A lightweight publish/subscribe protocol for machine-to-machine and Internet of Things communication. Accessed October 3, 2026. https://www.oasis-open.org/standard/mqtt-v5-0-os/
- Open Geospatial Consortium. OGC SensorThings API Standard. A geospatial way to interconnect IoT devices, data, and applications over the web, with sensing and tasking. Accessed October 3, 2026. https://www.ogc.org/standards/sensorthings/
- Kaleidr. Location-Aware Booking. https://kaleidr.com/blog/location-aware-booking
- Kaleidr. Private Location Data for AI Map Workflows. https://kaleidr.com/blog/private-location-data-for-ai-map-workflows
- Kaleidr. Spatial AI Observability. https://kaleidr.com/blog/spatial-ai-observability
- Kaleidr. Location Intelligence APIs and Map SDK. Inference APIs, ranking systems, and analytics for spatial products. Accessed October 3, 2026. https://kaleidr.com/enterprise
- Kaleidr Developer Docs. Products. Chat is Spatial AI in the host map, Editor is draw and edit, Tile is designed basemaps, and Viewer publishes a map. Accessed October 3, 2026. https://docs.kaleidr.com/
- Kaleidr Developer Docs. Platform API Endpoints. Documents chat, route, POI enrichment, and design calls, and does not document a CRM, inventory, booking, GTFS, or MQTT connector. Accessed October 3, 2026. https://docs.kaleidr.com/platform-api/endpoints
- Kaleidr. Real-Time Maps in Kaleidr Studio. Studio authors the spatial presentation, and the operational system remains the source of current state. https://kaleidr.com/blog/real-time-maps-in-kaleidr-studio
@misc{ogc_api_features_2026,
  title  = {OGC API - Features},
  author = {{Open Geospatial Consortium}},
  year   = {2026},
  url    = {https://ogcapi.ogc.org/features/}
}

@misc{cloudevents_2026,
  title  = {CloudEvents},
  author = {{CloudEvents}},
  year   = {2026},
  url    = {https://cloudevents.io/}
}

@misc{gtfs_overview_2026,
  title  = {GTFS Overview},
  author = {{General Transit Feed Specification}},
  year   = {2026},
  url    = {https://gtfs.org/documentation/overview/}
}

@misc{gtfs_realtime_2026,
  title  = {GTFS Realtime Reference},
  author = {{General Transit Feed Specification}},
  year   = {2026},
  url    = {https://gtfs.org/documentation/realtime/reference/}
}

@misc{oasis_mqtt_5_2019,
  title  = {MQTT Version 5.0},
  author = {{OASIS}},
  year   = {2019},
  url    = {https://www.oasis-open.org/standard/mqtt-v5-0-os/}
}

@misc{ogc_sensorthings_2026,
  title  = {OGC SensorThings API Standard},
  author = {{Open Geospatial Consortium}},
  year   = {2026},
  url    = {https://www.ogc.org/standards/sensorthings/}
}

@misc{kaleidr_booking_integration_2026,
  title  = {Location-Aware Booking},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/location-aware-booking}
}

@misc{kaleidr_private_location_integration_2026,
  title  = {Private Location Data for AI Map Workflows},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/private-location-data-for-ai-map-workflows}
}

@misc{kaleidr_observability_integration_2026,
  title  = {Spatial AI Observability},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-ai-observability}
}

@misc{kaleidr_enterprise_integration_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_docs_home_integration_2026,
  title  = {Kaleidr Developer Docs},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://docs.kaleidr.com/}
}

@misc{kaleidr_docs_endpoints_2026,
  title  = {Platform API Endpoints},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://docs.kaleidr.com/platform-api/endpoints}
}

@misc{kaleidr_realtime_maps_integration_2026,
  title  = {Real-Time Maps in Kaleidr Studio},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/real-time-maps-in-kaleidr-studio}
}