
Spatial-AI-Datenintegration verbindet CRM-, Bestands-, Buchungs-, ÖPNV- und Sensorsysteme mit einer standortbezogenen Entscheidung, während jedes System die Tatsachen behält, für die es bereits zuständig ist. Eine Karte kann ein Geschäft, einen Bus und eine Buchung nur dann gemeinsam darstellen, wenn Identität, Aktualität und Berechtigung den Join überstehen. Ein brauchbares Design wählt für jede Art von Änderung das passende Integrationsmuster und erklärt das Ergebnis anschließend aus diesen Datensätzen heraus.
Die folgenden Abschnitte trennen sechs Arten, wie sich Daten bewegen können, und wenden sie anschließend auf ÖPNV, Sensoren, Buchungen und private Datensätze an. Eine einzelne nächtliche Datei kann für einen selten veränderten Katalog weiterhin die richtige Wahl sein. Eine Live-Position braucht einen anderen Vertrag.
Grundlagen der Spatial-AI-Datenintegration
- Eigentümer benennen: Jedes Feld hat ein System of Record, eine kanonische ID und eine Aktualitätsregel, bevor ein Connector gewählt wird.
- Muster an die Änderung anpassen: Batch, Live-Lookup, Events, Streams, Spatial-Feature-APIs und validierter Write-back lösen unterschiedliche Aufgaben.
- Stabile Fakten früh binden: Filialidentität und Geometrie können die Menge früh eingrenzen. Bestand, Öffnungszeiten und Verkehr gehören an den spätestmöglichen verantwortbaren Zeitpunkt.
- Berechtigung vor dem Join halten: Ein räumlicher Join über alle privaten Datensätze ist bereits eine Offenlegung, selbst wenn die Antwort einige Zeilen verbirgt.
- Transaktion im Ursprungssystem lassen: Eine Empfehlung kann einen Ort benennen. Das Host-System validiert erneut, bestätigt und verbucht die Buchung oder Zahlung.
Was ist Spatial-AI-Datenintegration?
Spatial-AI-Datenintegration bedeutet, operative Datensätze in eine standortbezogene Entscheidung einzubringen, ohne sie zu einem anonymen Feed zu verflachen. Das CRM hält den Kunden. Das Bestandssystem hält den Lagerbestand. Ein Buchungssystem hält Verfügbarkeit und Transaktion. Der ÖPNV hält ein geplantes Netz und einen Live-Zustand. IoT hält Beobachtungen. Auf der Karte werden diese Tatsachen zu einem Ort, einer Route, einer Rangfolge und einer Erklärung. Die Integration scheitert, wenn eine Filial-ID auf halber Strecke ihre Bedeutung ändert oder eine veraltete Menge als aktuell behandelt wird.
Zwischen Quelle und Nutzererlebnis liegen fünf Aufgaben. Die Identität löst dasselbe Geschäft, denselben Kunden oder dasselbe Asset über Systeme hinweg auf. Die Autorisierung entscheidet, welcher Mandant, welches Objekt und welches Feld in die Anfrage eingehen dürfen. Die Normalisierung bringt diese Felder in ein gemeinsames Schema mit Ort und Zeit. Die Aktualität hält fest, wann Batch, Lookup oder Stream zuletzt geliefert haben. Ein räumlicher Join führt anschließend die autorisierten Zeilen nach Ort zusammen. Das Cover-Diagramm folgt genau dieser Reihenfolge: von den fünf Quellen zu einer Karte mit gerankten Orten, einer Route, einer Erklärung und einer validierten Aktion.
Die Beispielhinweise in diesem Diagramm sind nur Illustrationen. „Kunde nahe Filiale“, „hoher Bestand“ und „nächster ÖPNV in 6 Min.“ zeigen, welche Art von Satz ein geerdetes Ergebnis stützen kann. Diese Aussagen sind kein gemessenes Kaleidr-Ergebnis, und die Karte behauptet nicht, dass ein einzelnes Produkt bereits jede Quelle speichert.
Warum braucht ein Produkt sechs Integrationsmuster?
Ein standortbezogenes Produkt braucht häufig sechs Integrationsmuster, weil sich Fakten mit unterschiedlicher Geschwindigkeit ändern und unterschiedliche Risiken tragen. Ein Batch oder Snapshot passt zu einem langsam veränderlichen Katalog. Ein Live-Lookup passt zu einer volatilen Tatsache, die aktuell sein muss, bevor jemand empfiehlt oder handelt. Ein Event passt zu einer bedeutsamen Geschäftsänderung, etwa wenn eine Filiale am Nachmittag schließt. Ein Stream passt zu hochfrequentem Betriebszustand, etwa einem fahrenden Fahrzeug. Eine Spatial-Feature-API passt zu einer abfragbaren geografischen Sammlung. Ein validierter Write-back passt zu einer Aktion, die im System of Record landen muss. Alle sechs über eine einzige nächtliche Datei oder einen einzigen Sprachmodell-Aufruf zu zwingen, zerstört genau die Unterscheidung, von der die Entscheidung abhängt.
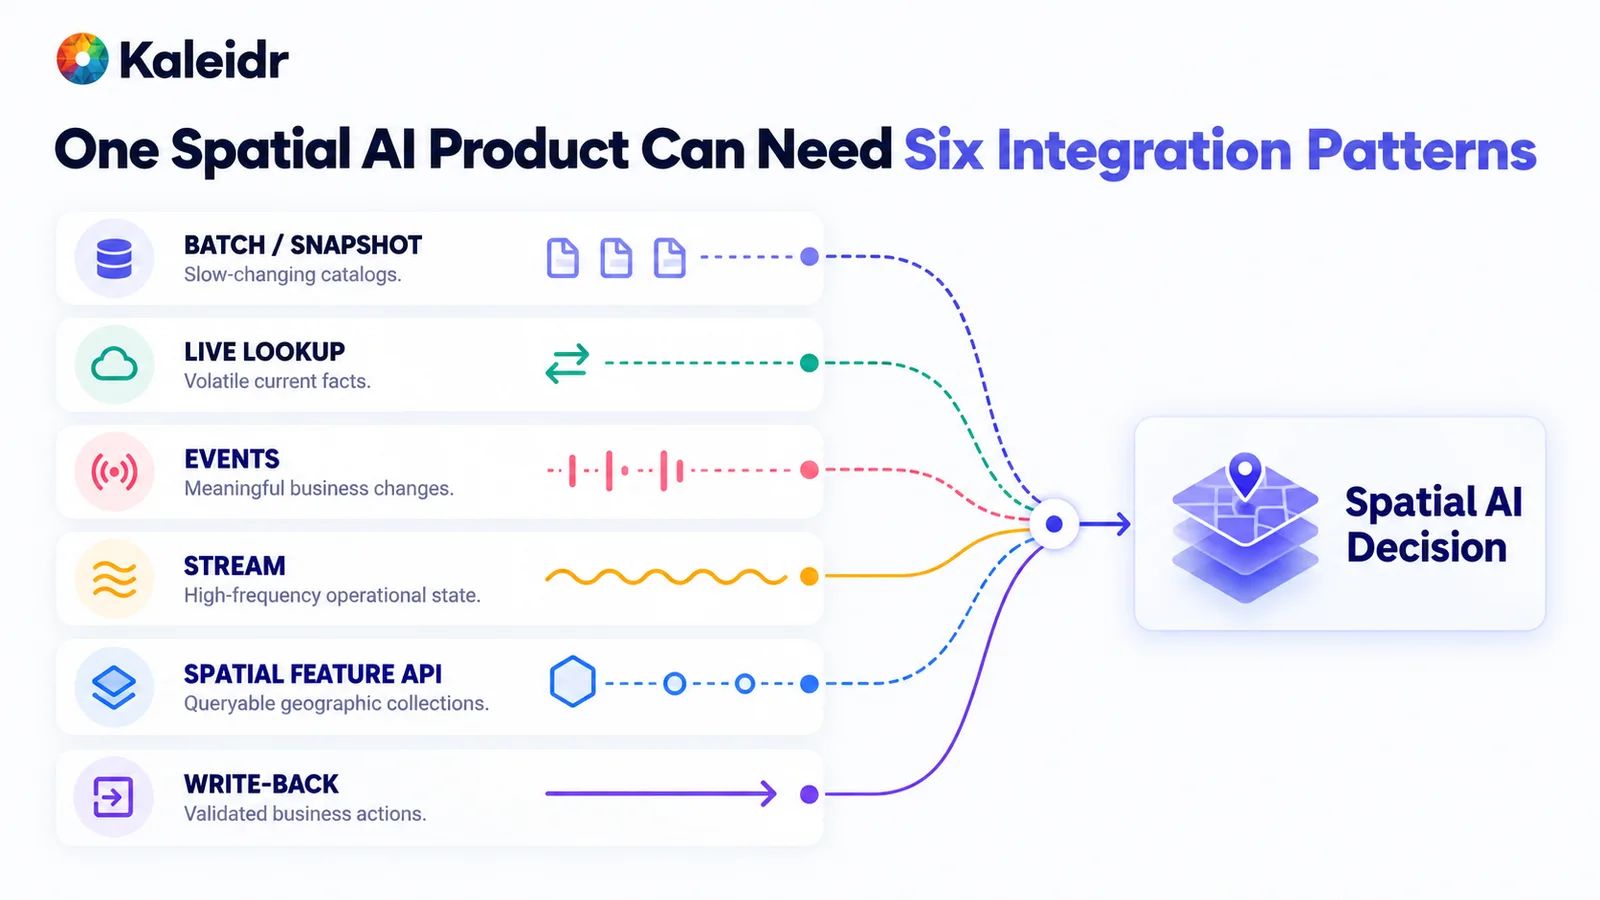
Die sechs Muster beschreiben, wie sich eine Tatsache bewegt, nicht welcher Anbieter gewinnt. Batch transportiert einen langsam veränderlichen Snapshot. Live-Lookup, Events und Streams transportieren schnellere Änderungen. Eine Spatial-Feature-API stellt geografische Sammlungen bereit, und Write-back führt eine validierte Aktion zurück. Das Diagramm ist eine Architekturaufteilung, kein Kaleidr-Score.
OGC API - Features ist eine praktische Ausprägung des fünften Musters. Der Standard beschreibt eine Geospatial-API für Feature-Daten und eignet sich damit für Orte, Grenzen und andere Sammlungen, die ein Produkt abfragen statt vollständig kopieren muss (OGC, 2026). Verwenden Sie dieses Muster, wenn die Sammlung bereits geografisch ist und die Fragen räumlich sind. Eine Kundenstufe, ein Preis oder eine Buchungsbestätigung gehört weiterhin in das System, das sie besitzt, und wird über Lookup, Event oder Write-back erreicht. Standards helfen, wenn sie zur Aufgabe passen. Ein Logo in einem Diagramm tut das nicht.
Welches System sollte jedes Feld besitzen?
Wählen Sie den Eigentümer, bevor Sie den Connector wählen. Eine nützliche Tabelle nennt Datendomäne, System of Record, kanonische Kennung, erforderliche Aktualität, Integrationsmuster und die Rolle der AI-Schicht. Filialidentität und Koordinaten können in einem Standort-Master liegen und per Batch übertragen werden, weil sie stabil sind. Bestand kann im Bestandssystem liegen, per SKU und Filiale verschlüsselt sein und per Live-Lookup kommen, weil sich Lagerbestände ändern. Öffnungszeiten können planmäßig aus einem Planungssystem kommen. Eine Kundenstufe kann als Event aus dem CRM kommen. Reisezeit kann bei Bedarf aus einem Routing-Dienst kommen. Buchung und Zahlung bleiben im Buchungssystem und am Point of Sale, und die AI-Schicht darf sie zusammenfassen, ohne zum Ledger zu werden.
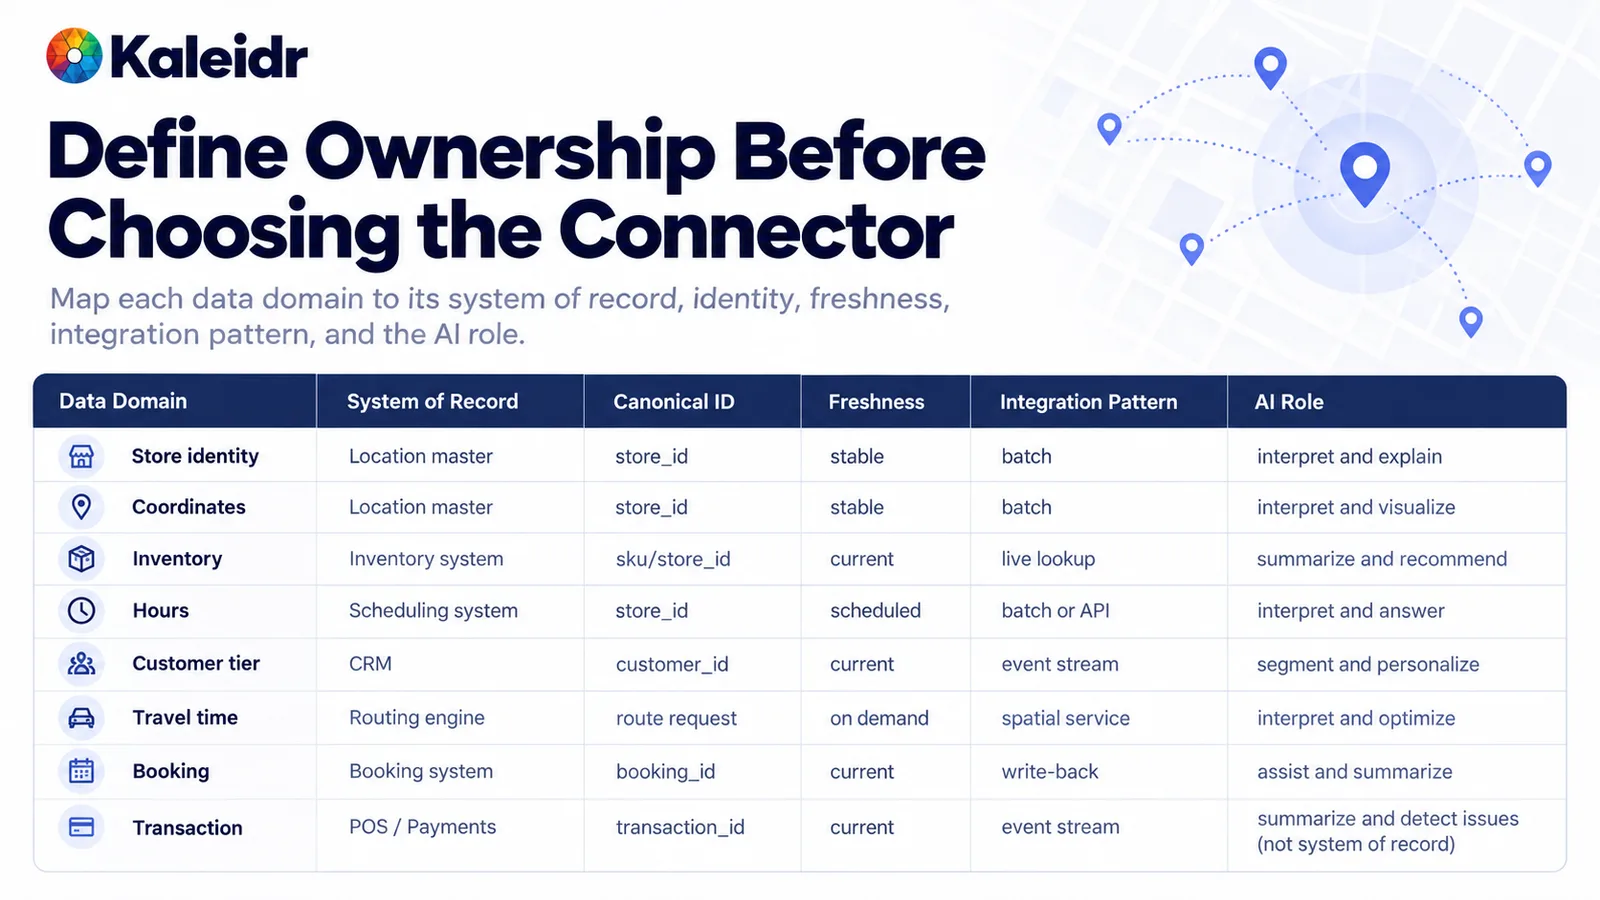
Jede Zeile bindet eine Domäne an das System, das sie besitzt. Stabile Ortsfakten nutzen Batch und eine Filialkennung. Volatiler Bestand, Öffnungszeiten, Stufe, Reisezeit und Buchungen verwenden schnellere Muster. Die AI-Spalte begrenzt die Schicht auf Interpretation, Zusammenfassung oder Unterstützung. Die Tabelle ist ein Planungsraster, kein Kaleidr-Export.
Dieselbe Filiale braucht nach jeder Anreicherung dieselbe kanonische Kennung. Ein Quellsystem darf seinen eigenen Schlüssel verwenden; die Integration ordnet diesen Schlüssel zu, statt für jeden Feed eine neue Filiale zu erfinden. Die Autorität für Adresse und Koordinaten sollte ausdrücklich festgelegt sein, damit ein Geocoder einen vermessenen Standort nicht stillschweigend überschreibt. Unbekannt ist ein anderer Zustand als falsch: Ein fehlender Öffnungszeiten-Datensatz beweist nicht, dass die Filiale geschlossen ist. Führen Sie Quelle, Schemaversion und Beobachtungszeit neben den normalisierten Feldern mit, damit eine spätere Erklärung sagen kann, welchen Datensatz sie verwendet hat.
Warum stabile Fakten früh und volatile Fakten spät binden?
Stabile Daten können die Suche eingrenzen, bevor jemand für einen Live-Aufruf bezahlt. Ein nächtlicher Snapshot der Filialstandorte, danach ein geografischer Filter auf Filialen entlang der Route und erst dann ein Live-Bestandscheck, ein Öffnungszeitencheck und ein Routing-Ranking sind günstiger und sicherer, als jede API zu jeder Filiale zu befragen. Volatile Fakten gehören an den spätestmöglichen verantwortbaren Zeitpunkt, weil sich Menge oder Schließung zwischen der Nachtdatei und der Kundenfrage ändern können. Die Abbildung zeigt einen illustrativen Weg: Snapshot, Korridorfilter, In-Stock-Lookup, Öffnungszeitencheck, Umweg-Ranking und ein vorgeschlagener Stopp. Die Zählwerte und Umwegminuten sind nur Illustrationen.
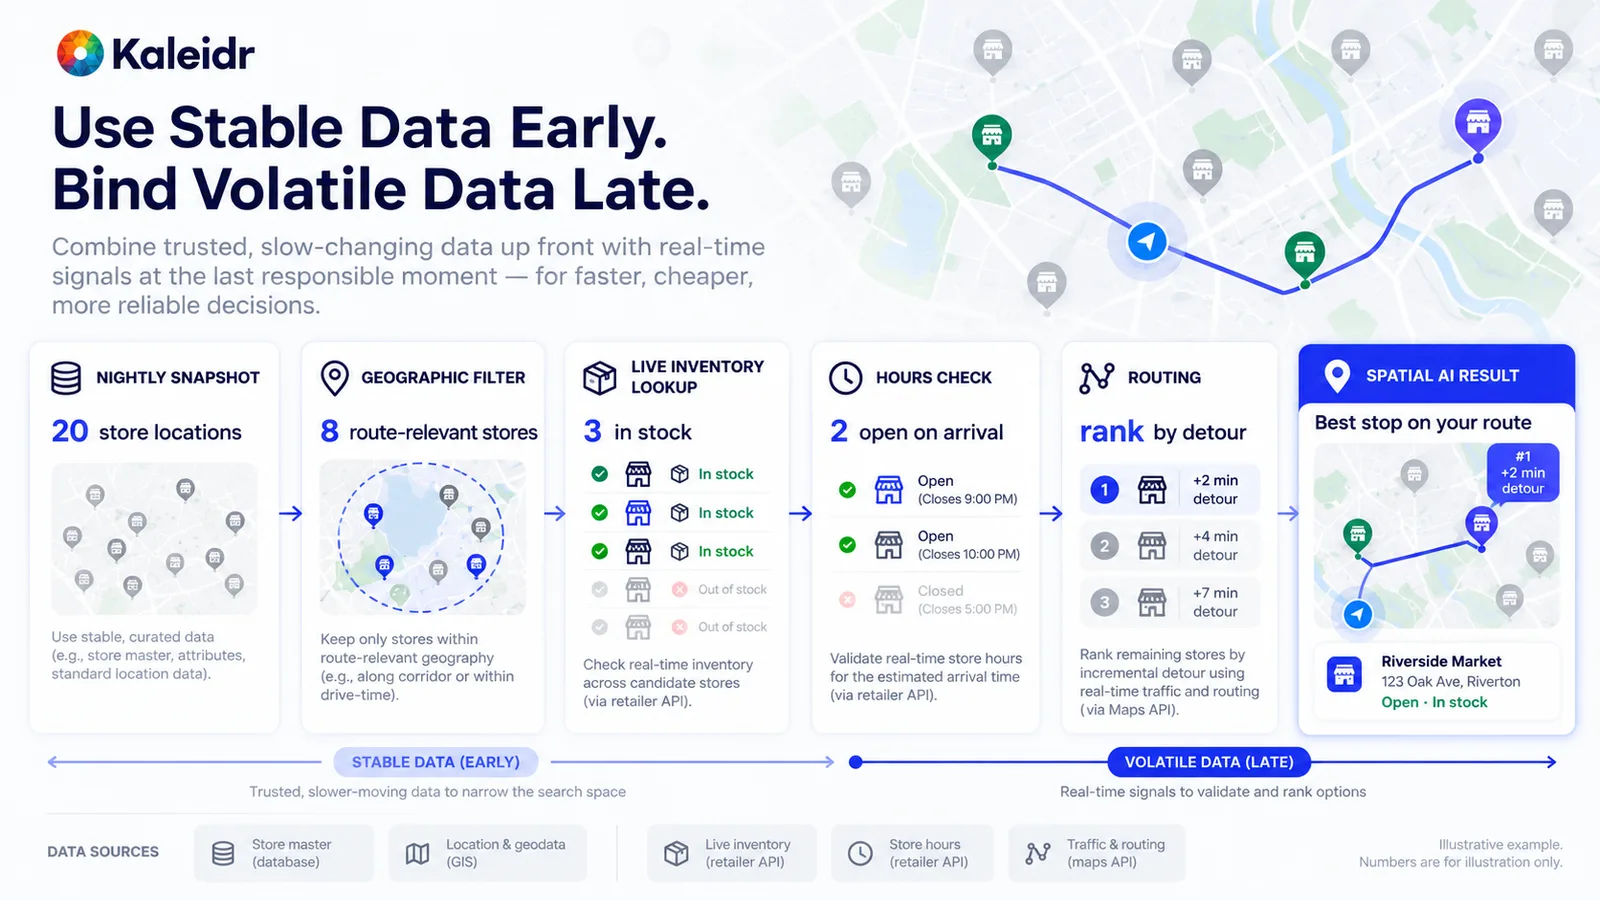
Stabile Ortsdaten grenzen die Menge ein, bevor Live-Aufrufe beginnen. Bestand, Öffnungszeiten und Verkehr werden spät für die verbleibenden Kandidaten geprüft. Die letzte Karte zeigt einen vorgeschlagenen Stopp mit Beispielname und Beispielumweg. Die Zahlen sind illustrativ und keine Kaleidr-Messung.
Halten Sie räumliche Berechnungen aus den Quelladaptern heraus. Die Bestands-API liefert den Bestand. Der Routing-Dienst liefert die Reisezeit. Die Eignungsprüfung entfernt eine geschlossene oder ausverkaufte Filiale, bevor das Ranking den Rest sortiert. Das Sprachmodell kann die Anfrage interpretieren und die verbleibende Wahl erklären. Das Modell Distanz, Bestandszahl oder Öffnungszeiten erfinden zu lassen, rekonstruiert die Tatsache an der unzuverlässigsten Stelle. Wenn sich die Empfehlung nach dem nächtlichen Import ändert, sollte das Team wissen, welche Dataset-Version die Filialliste geliefert hat.
Was sollte ein Event ändern?
Ein Event sagt, dass sich etwas Bedeutungsvolles geändert hat. Eine Filiale schloss für den Nachmittag, ein Eintrag wurde aktiv, eine Buchung wurde storniert oder ein Servicegebiet verschob sich. Der Produzent veröffentlicht diese Änderung, ein Broker verteilt sie, und Consumer aktualisieren aktuellen Zustand, Suchindex, Kartenebene und Retrieval-Cache. Ein Event ist keine vollständige Datenbank; der Consumer braucht weiterhin Zustandssemantik: ob der Payload der vollständige neue Datensatz, ein geändertes Feld oder nur eine Kennung ist, die späteren Lookup erfordert. CloudEvents beschreibt Event-Daten in einer gemeinsamen Form, damit Publisher nicht für jeden Consumer einen neuen Umschlag erfinden (CloudEvents, 2026).
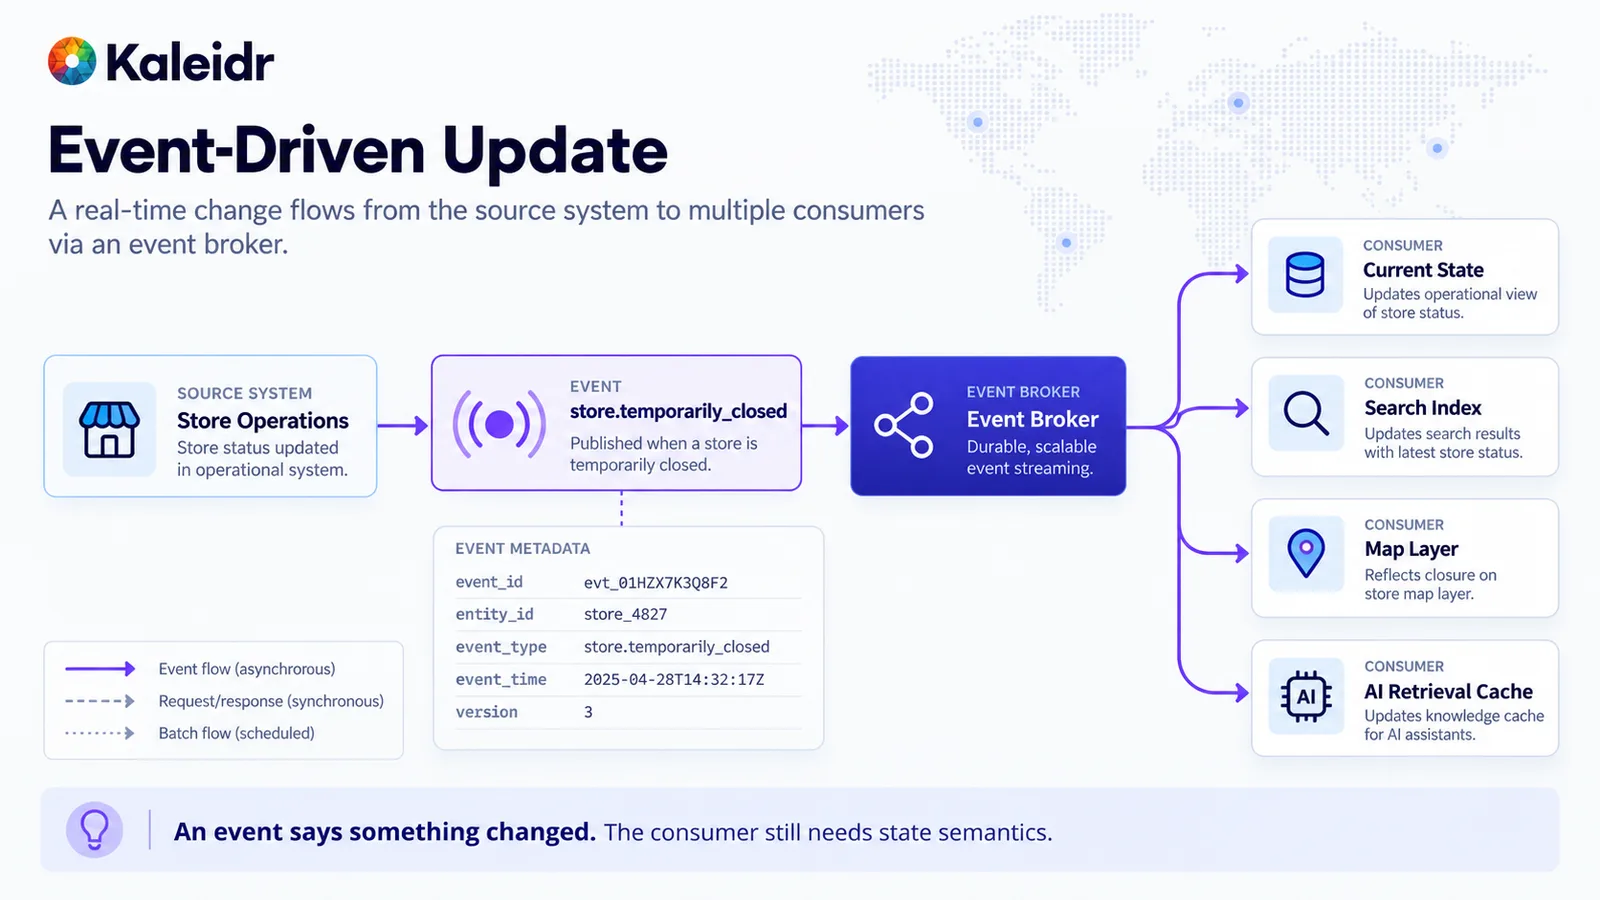
Die Quelle veröffentlicht eine Geschäftsänderung, und der Broker liefert sie an mehrere Consumer. Metadaten wie Event-ID, Entität, Typ, Zeit und Version reisen mit der Nachricht. Beispielkennungen und Zeitstempel sind illustrativ. Ein Event meldet eine Änderung; der Consumer muss weiterhin die Zustandssemantik anwenden.
Entwerfen Sie den Consumer für Wiederholungen und Duplikate. Dieselbe Schließungsmeldung kann zweimal eintreffen, oder eine spätere Meldung kann zuerst ankommen. Event-ID, Entitäts-ID, Event-Zeit und Schemaversion machen das sicher erkennbar. Aktualisieren Sie den normalisierten Datensatz und invalidieren Sie anschließend den Cache, den Karte und Retrieval-Schritt lesen. Die Alternative ist, jedes System dauerhaft zu pollen, wodurch genau der Moment verborgen wird, in dem sich das Geschäft tatsächlich änderte. Ein Positionsstream ist ein anderes Muster, das als Nächstes behandelt wird, weil eine Position kontinuierlicher Zustand und keine einzelne Geschäftstatsache ist.
Wie bleiben ÖPNV-Fahrplan und Live-Zustand getrennt?
GTFS ist ein klares Beispiel für eine Domäne, die zwei Muster braucht. GTFS Schedule ist eine Feed-Spezifikation für statische Informationen des öffentlichen Verkehrs und besteht aus einfachen Dateien, die Haltestellen, Linien, Fahrten und verwandte Teile des Netzes beschreiben (GTFS, 2026). Die GTFS-Realtime-Referenz dokumentiert separat Trip-Updates, Fahrzeugpositionen und Servicehinweise (GTFS, 2026). Der Fahrplan kann als Snapshot eintreffen. Der Realtime-Feed beschreibt, was gerade geschieht. Ein Routenplaner kombiniert beides. Spatial AI erklärt anschließend die Optionen auf einer Karte. Beide Feeds in ein einziges Feld „transit data“ zu verflachen, löscht den Unterschied zwischen Plan und Störung.
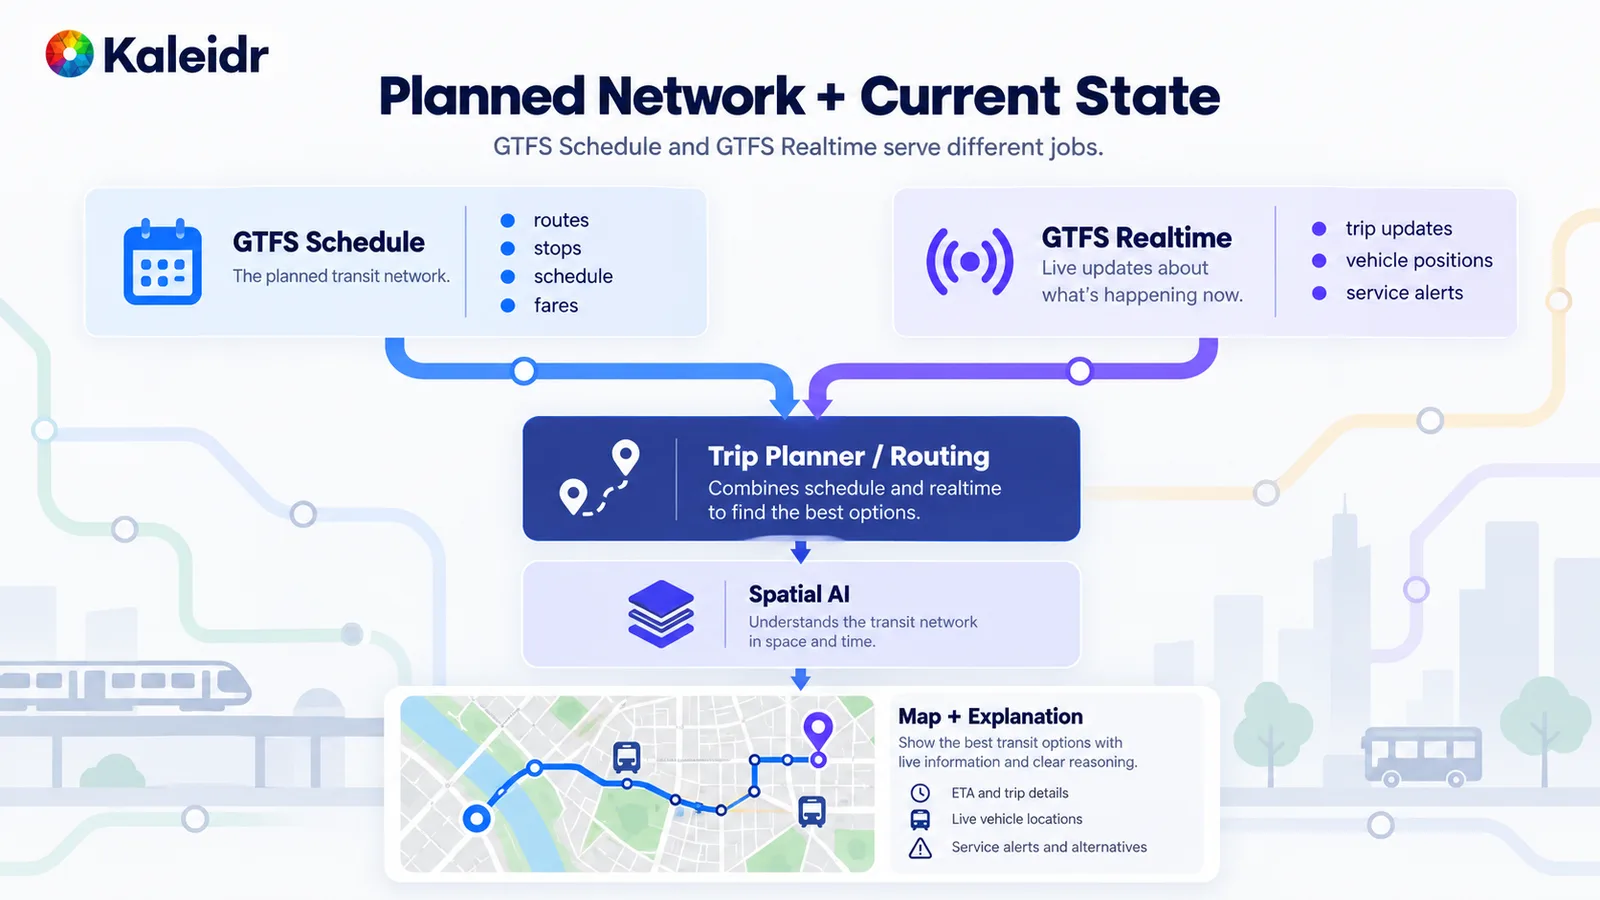
Der Fahrplan beschreibt das geplante Netz einschließlich Linien, Haltestellen und Fahrten. Der Realtime-Feed trägt Trip-Updates, Fahrzeugpositionen und Servicehinweise. Ein Routenplaner kombiniert diese Eingaben, und die Karte erklärt das Ergebnis. Das Diagramm trennt die beiden GTFS-Aufgaben; das Sprachmodell ist nicht die Routing-Engine.
Dieselbe Trennung erscheint außerhalb des ÖPNV. Die Adresse einer Filiale ist der Fahrplan. Heutiger Bestand und heutige Schließung sind der Realtime-Feed. Eine Routenberechnung ist ein dritter Dienst mit eigener Aktualität. Bitten Sie ein Sprachmodell nicht, aus Rohfeeds einen Transitgraphen neu aufzubauen, und behandeln Sie eine Fahrzeugposition vom Morgen nicht als Beweis dafür, wo sich der Bus jetzt befindet. Zeigen Sie Haltestelle, Fahrzeug und Hinweis als getrennte Ebenen, wenn das Produkt dem Fahrgast ermöglichen muss, sie auseinanderzuhalten.
Wie wird aus einem Sensorstream ein Ort?
Ein roher Sensorwert ist noch kein Kartenstandort. Geräte, Fahrzeuge und Sensoren können über MQTT oder eine andere Telemetrie-API publizieren. OASIS beschreibt MQTT Version 5.0 als leichtgewichtiges Publish/Subscribe-Protokoll für Machine-to-Machine- und Internet-of-Things-Kommunikation (OASIS, 2019). Der OGC SensorThings API Standard ist eine geospatiale Möglichkeit, IoT-Geräte, Daten und Anwendungen über das Web zu verbinden; Sensing und Tasking sind die beiden Hauptfunktionen (OGC, 2026). Nach der Aufnahme wird das Schema validiert, der Datensatz normalisiert und der aktuelle Zustand mit Beobachtungszeit und Aktualitätsalter gespeichert. Erst dann platziert eine räumliche Schicht das Asset. AI-Schicht, Karte und Betrieb lesen diesen Zustand. Sie sollten den Rohdatenstrom nicht abonnieren.
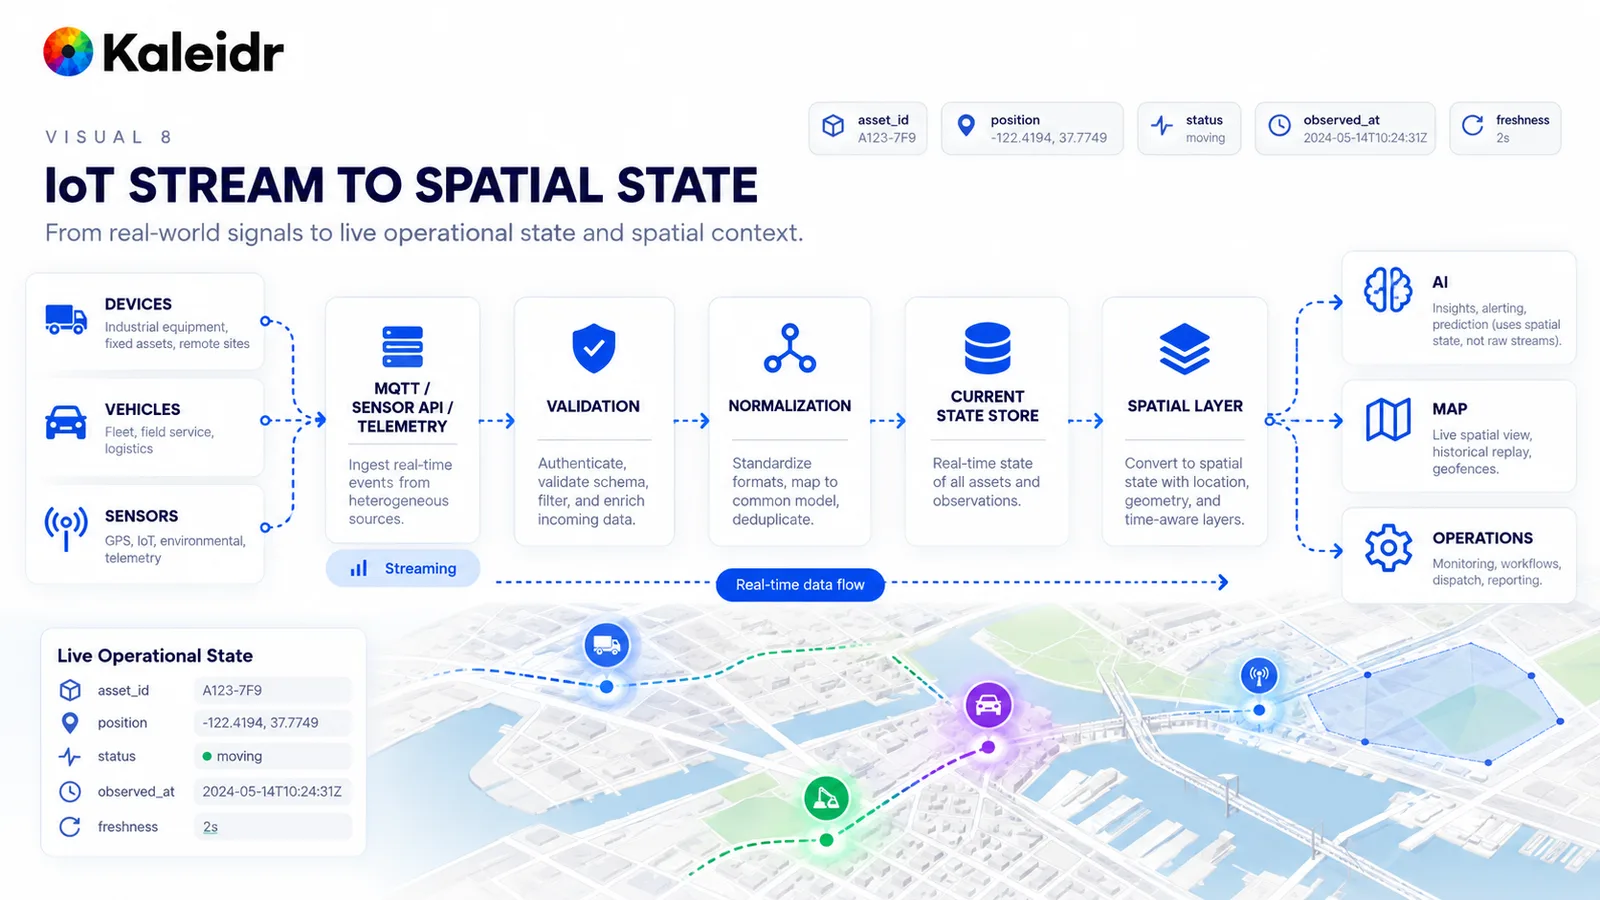
Telemetrie wird zu einem aktuellen Betriebsdatensatz mit Asset-ID, Position, Status, Beobachtungszeit und Aktualitätsalter. Die Beispielkoordinaten und der Zeitstempel 2024 sind illustrativ. Validierung und Normalisierung liegen vor der räumlichen Schicht. AI, Karte und Betrieb lesen Zustand, nicht den ungefilterten Stream.
Eine Temperatur ohne Asset und Schwellenwert ist keine Antwort. Die Frage „welcher Kühlstandort liegt über seinem Grenzwert?“ braucht Sensor, Anlage, Regel und Zeit. Halten Sie historische Analysen auf einem anderen Pfad als den Current-State-Store, wenn sich die Volumen unterscheiden. Fügen Sie Backpressure hinzu, damit ein Messwert-Burst die Karte nicht blockiert. Ein getrennter Sensor sollte als unbekannt erscheinen, nicht als stilles Nullsignal.
Warum ist eine Empfehlung keine Transaktion?
Eine räumliche Empfehlung kann einen Ort benennen. Das Host-Buchungssystem prüft weiterhin Verfügbarkeit, Preis und Berechtigung, bestätigt die Anfrage und verbucht die Transaktion. Diese Grenze ist wichtig, wenn zwei Personen denselben Raum oder dasselbe Abholfenster wählen können. Der Leitfaden zu standortbezogenen Buchungen hält die Auswahl an Live-Bestand, Reisekontext und Eignung gebunden (Kaleidr, 2026). Beispiel-Orts-ID und Transaktions-ID in der Abbildung sind Bezeichnungen für diese Übergabe, keine Live-Kaleidr-Buchung. Kaleidr kann das bestätigte Ergebnis auf der Karte zeigen, nachdem das Host-System es zurückgibt. Kaleidr wird nicht zum Ledger, nur weil sich ein Pin bewegt.
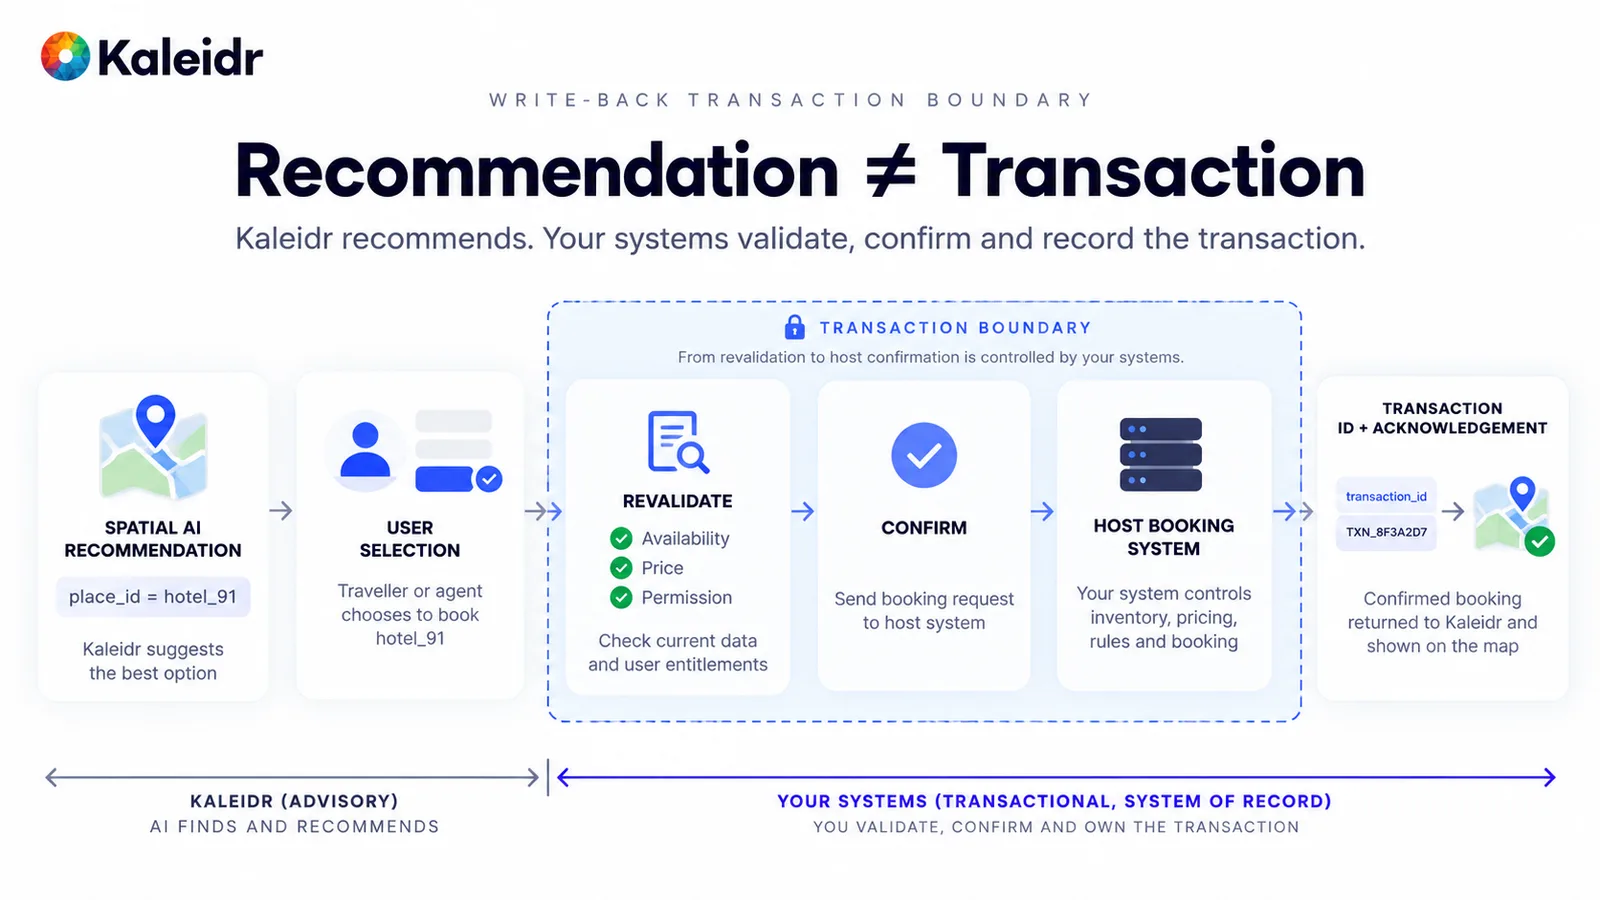
Die linke Seite findet und empfiehlt einen Ort. Die Transaktionsgrenze validiert Verfügbarkeit, Preis und Berechtigung erneut und bestätigt anschließend im Host-System. Eine Beispiel-Transaktions-ID kehrt zurück, damit die Karte sie anzeigen kann. Die Kennungen sind illustrativ, und das Host-System bleibt das System of Record.
Schreiben Sie dieselbe Regel für jede Aktion, die Geld, Bestand oder Rechte einer Person verändert. Validieren Sie unmittelbar vor dem Schreiben erneut, weil der Lookup, der die Erklärung stützte, bereits veraltet sein kann. Geben Sie die Bestätigung des Host-Systems einschließlich Konflikten zurück, damit die Karte keinen Erfolg zeigt, den das Ledger abgelehnt hat. Eine Prompt-Zeile wie „niemals ohne Berechtigung buchen“ kann Verhalten steuern. Dieser Satz ist nicht die Transaktionsgrenze.
Warum muss Berechtigung vor dem Join kommen?
Die Fähigkeit, Daten zu verknüpfen, ist keine Berechtigung, sie zu verwenden. Ein autorisierter Ablauf löst Nutzer, Mandant, Objekt und Feld auf, verknüpft anschließend nur die Datensätze und Ebenen, die diese Prüfungen bestehen, und baut erst danach den Kontext für die Erklärung. Ein blockierter Pfad verknüpft zuerst alle privaten Datensätze und hofft, dass das Modell diejenigen verbirgt, die der Nutzer nicht sehen darf. Der Join hat die nicht autorisierten Daten bereits verwendet. Der Leitfaden zu privaten Standortdaten setzt Mandanten-, Objekt- und Feldprüfungen vor den Punkt, an dem private Datensätze eine räumliche Berechnung oder Kartenantwort erreichen (Kaleidr, 2026).
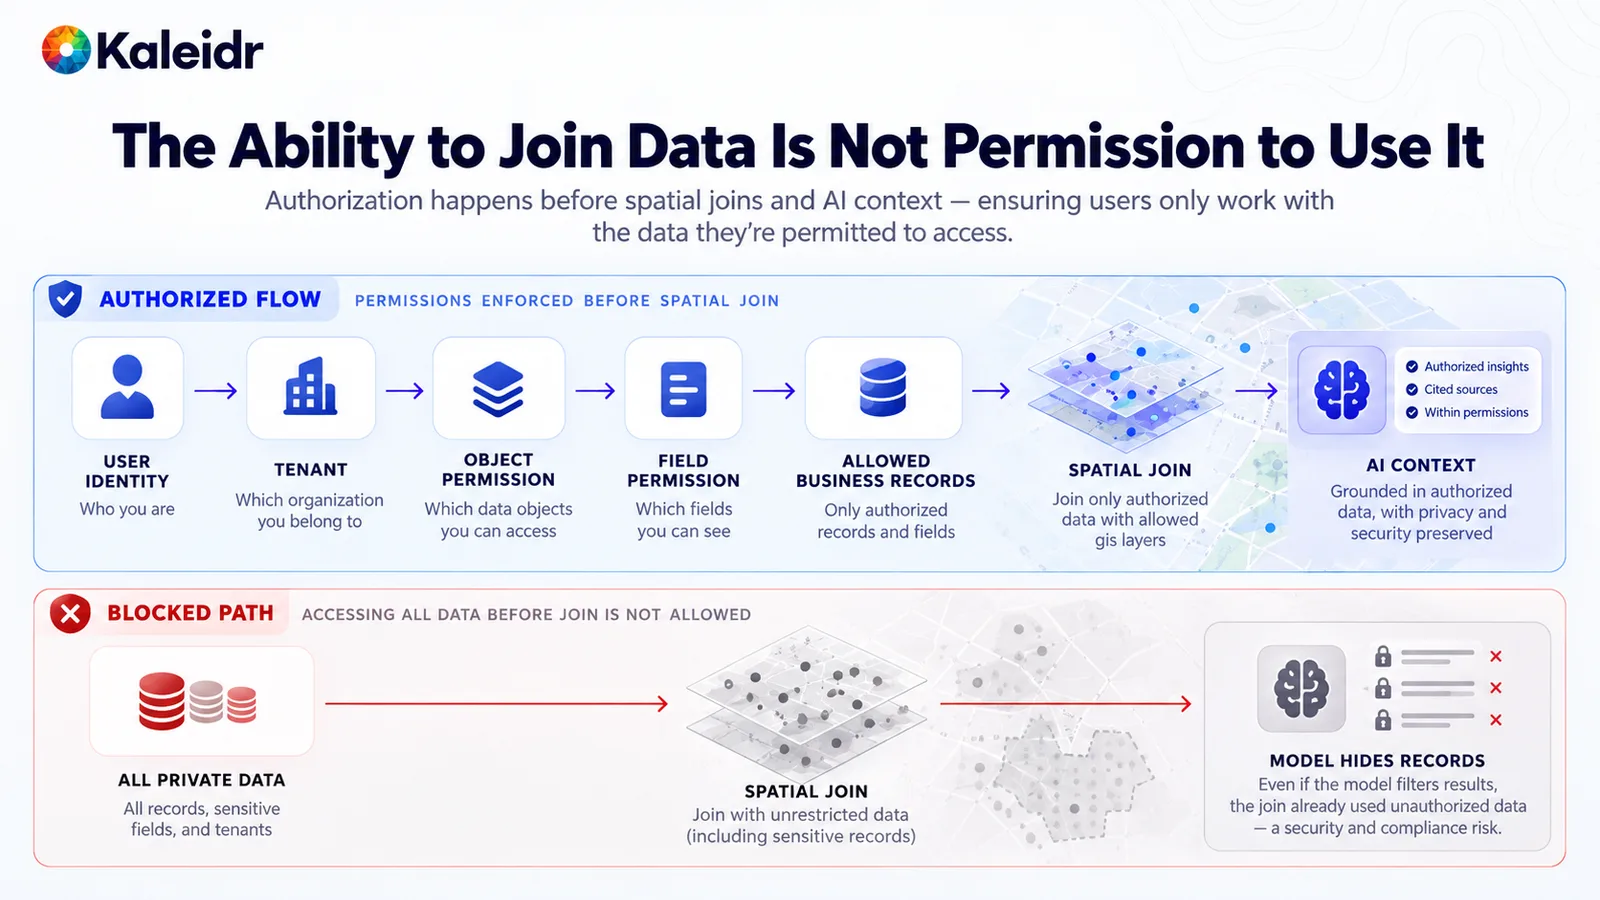
Der obere Pfad filtert Identität, Mandant, Objekte und Felder vor dem räumlichen Join und der Erklärung. Der untere Pfad verknüpft alle privaten Datensätze und versucht erst danach, Zeilen zu verbergen. Ein Filter in der Antwort kann einen Join, der verbotene Datensätze bereits gelesen hat, nicht rückgängig machen. Berechtigung ist eine Vorbedingung, keine Bildunterschrift des Ergebnisses.
Bewahren Sie diesen Berechtigungskontext über jeden Hop hinweg. Cache, Retrieval-Index und Kartenebene können jeweils zu einer zweiten Kopie eines privaten Feldes werden. Partitionieren Sie sie nach Mandant und entfernen Sie Felder, die der Nutzer nicht sehen darf, bevor die Kopie geschrieben wird. Mandantenübergreifendes Retrieval ist ein Datenintegrationsfehler, selbst wenn der letzte Satz harmlos aussieht. Protokollieren Sie Kennungen und Policy-Ergebnis, nicht den privaten Payload.
Wie sieht der Produktionspfad aus?
Eine Produktionsanfrage kann einer stabilen Sequenz folgen, auch wenn eine konkrete Frage eine Stufe überspringt. Die Host-Anwendung authentifiziert den Nutzer. Kandidatenquellen liefern Snapshots, eine Spatial-Feature-API oder CRM-Kontext. Live-Anreicherung ergänzt Bestand, Buchungsstatus oder Betriebszustand. Räumliche Dienste berechnen Route, Distanz und Servicegebiet. Die Eignungsprüfung entfernt ungültige Kandidaten, und das Ranking ordnet den Rest. Die AI-Schicht interpretiert die Anfrage und erklärt das geerdete Ergebnis. Die Karte zeigt Ort oder Route. Validierter Write-back kehrt zum System of Record zurück, wenn der Nutzer handelt. Observability zeichnet entlang dieses Pfads Kennungen, Quelle, Aktualität, Versionen und Ergebnis auf (Kaleidr, 2026). Eine öffentliche Attraktionssuche kann vor privaten Daten und Write-back enden. Eine bestandsbewusste Abholung kann nahezu jede Stufe benötigen.
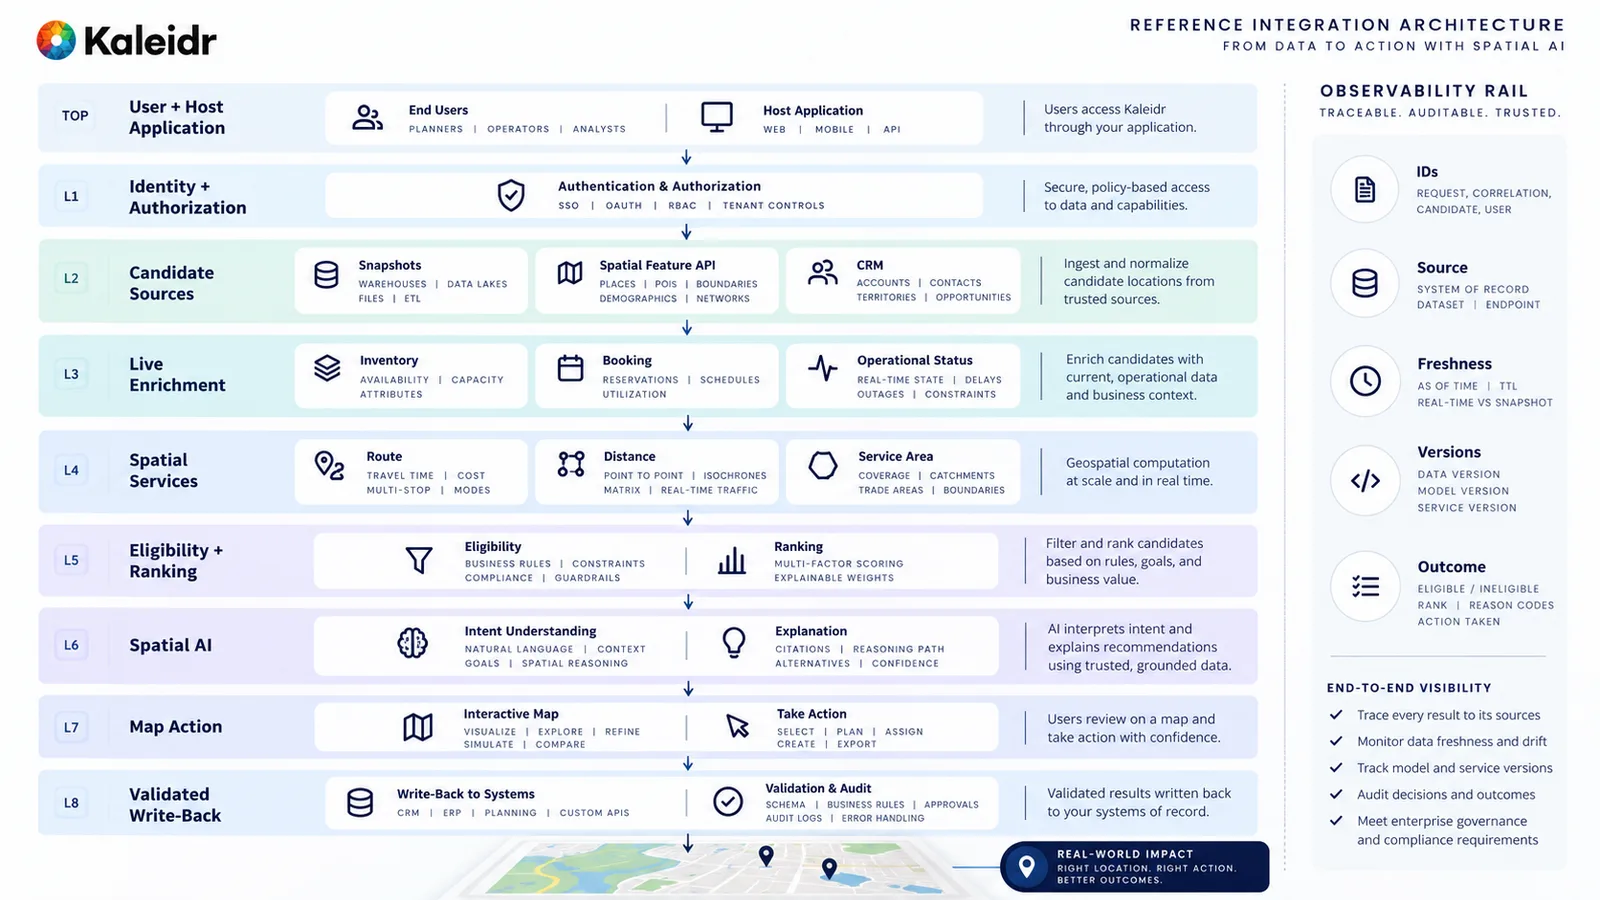
Der Stack läuft vom Host-Nutzer über Autorisierung, Kandidaten, Live-Anreicherung, räumliche Dienste, Eignung, Erklärung und Karte bis zum Write-back. Eine Observability-Schiene zeichnet Kennungen, Quelle, Aktualität, Versionen und Ergebnis auf. Nicht jede Anfrage nutzt jede Schicht. Das Diagramm ist ein Referenzpfad, keine Behauptung, dass eine Bereitstellung alles einschalten muss.
Testen Sie die Integration mit produktionsnahen Fehlern und nicht nur mit einem polierten Satz. Eine ausbleibende Bestandsantwort, ein getrennter Sensor, ein Buchungskonflikt und eine Schemaänderung sollten jeweils eine definierte Fehlerbedeutung und ein Kartenverhalten haben. Trennen Sie aktuellen Zustand von historischen Analysen, damit eine Dashboard-Abfrage das Live-Bild nicht blockiert. Versionieren Sie Schema und Transformation, weil ein umbenanntes Feld nicht stillschweigend zu einer neuen Filiale werden darf.
Wo passt Kaleidr in diesen Stack?
Kaleidr Enterprise wird auf seiner Produktseite als Location-Intelligence-Infrastruktur mit Inference-APIs, Ranking-Systemen und Analytics für räumliche Produkte beschrieben (Kaleidr, 2026). Die Entwicklerdokumentation beschreibt vier Oberflächen auf einer Plattform: Chat ist Spatial AI in der Karte des Hosts, Editor dient zum Zeichnen und Bearbeiten, Tile liefert gestaltete Basemaps, und Viewer veröffentlicht eine Karte (Kaleidr, 2026). Die öffentliche Platform API dokumentiert Chat-, Route-, POI-Enrichment- und Design-Aufrufe. Diese Seite dokumentiert keinen universellen Connector für CRM, Bestand, Buchung, GTFS, MQTT oder eine Enterprise-Datenbank (Kaleidr, 2026). Der Host behält diese Systeme, die Autorisierung seiner Nutzer und die Transaktion.
Eine praktische Trennung stellt autorisierten, bereits normalisierten Kontext vor die räumliche Schicht. Die Bestands-API des Hosts bleibt autoritativ, der Host prüft Berechtigungen, und Chat erklärt eine Empfehlung auf einer Karte, die das Produkt bereits betreibt. Für ein Live-Betriebsbild bleibt das operative System die Quelle des aktuellen Zustands, während Studio die gebrandete räumliche Darstellung gestaltet (Kaleidr, 2026). Prüfen Sie den Enterprise-Vertrag in der aktuellen Dokumentation, bevor Sie gegen einen Endpoint bauen, den die öffentliche API nicht aufführt. Erkunden Sie Kaleidr Enterprise, wenn die Evaluierung diese räumliche Schicht neben den Systemen benötigt, die die Organisation bereits betreibt.
Hinweis: Kaleidr nutzt KI-gestützte Werkzeuge für Bilderstellung, Inhaltsverfeinerung und Recherche in seinen kreativen und Entwicklungs-Workflows.
FAQs
Bedeutet Spatial-AI-Datenintegration einen Connector für jedes System?
Nein. CRM, Bestand, Buchung, ÖPNV und IoT ändern sich mit unterschiedlichen Geschwindigkeiten und tragen unterschiedliche Risiken. Batch, Live-Lookup, Events, Streams, Spatial-Feature-APIs und validierter Write-back sind getrennte Muster. Ein Connector-Diagramm, das das System of Record verbirgt, hat das Design noch nicht fertiggestellt.
Kann ein Sprachmodell das Buchungs- oder Bestandssystem ersetzen?
Nein. Das Sprachmodell kann eine Anfrage interpretieren und ein geerdetes Ergebnis erklären. Bestand, Verfügbarkeit, Preis und Transaktion bleiben in den Systemen, die sie besitzen. Validieren Sie unmittelbar vor einem Write-back erneut und zeigen Sie die Bestätigung des Host-Systems auf der Karte.
Sollten GTFS Schedule und GTFS Realtime ein Feld teilen?
Nein. GTFS Schedule enthält statische Informationen des öffentlichen Verkehrs einschließlich Haltestellen, Linien und Fahrten. GTFS Realtime umfasst Trip-Updates, Fahrzeugpositionen und Servicehinweise. Ein Routenplaner kann beides kombinieren. Beide in einen einzigen Transit-Blob zu werfen, verbirgt, ob der Fahrgast den Plan oder die Störung sieht.
Ist ein Sensorwert bereits ein Kartenstandort?
Nein. Ein Messwert braucht ein Asset, eine validierte Position, eine Beobachtungszeit und ein Aktualitätsalter, bevor er in eine räumliche Schicht gehört. MQTT kann die Nachricht transportieren, und ein SensorThings-artiges Modell kann die Sensorbeziehung beschreiben. Karte und Erklärung sollten aktuellen Zustand lesen, nicht den Rohstream.
Ersetzt Kaleidr CRM, Bestands- oder Buchungssystem?
Nein. Die öffentliche Dokumentation beschreibt Chat, Editor, Tile, Viewer sowie Platform-API-Aufrufe für Chat, Route, POI-Enrichment und Design. Sie dokumentiert keinen universellen Connector für CRM, Bestand, Buchung, GTFS oder MQTT. Der Host behält diese Systeme und die Transaktion. Kaleidr stellt ausgewählte räumliche und Kartenfunktionen daneben bereit.
Referenzen
- Open Geospatial Consortium. OGC API - Features. A geospatial API for feature data. Accessed October 3, 2026. https://ogcapi.ogc.org/features/
- CloudEvents. CloudEvents. A specification for describing event data in a common way. Accessed October 3, 2026. https://cloudevents.io/
- General Transit Feed Specification. GTFS Overview. GTFS Schedule is a common format for static public transportation information, including stops, routes, and trips. Accessed October 3, 2026. https://gtfs.org/documentation/overview/
- General Transit Feed Specification. GTFS Realtime Reference. Trip updates, vehicle positions, and service alerts. Accessed October 3, 2026. https://gtfs.org/documentation/realtime/reference/
- OASIS. MQTT Version 5.0. A lightweight publish/subscribe protocol for machine-to-machine and Internet of Things communication. Accessed October 3, 2026. https://www.oasis-open.org/standard/mqtt-v5-0-os/
- Open Geospatial Consortium. OGC SensorThings API Standard. A geospatial way to interconnect IoT devices, data, and applications over the web, with sensing and tasking. Accessed October 3, 2026. https://www.ogc.org/standards/sensorthings/
- Kaleidr. Location-Aware Booking. https://kaleidr.com/blog/location-aware-booking
- Kaleidr. Private Location Data for AI Map Workflows. https://kaleidr.com/blog/private-location-data-for-ai-map-workflows
- Kaleidr. Spatial AI Observability. https://kaleidr.com/blog/spatial-ai-observability
- Kaleidr. Location Intelligence APIs and Map SDK. Inference APIs, ranking systems, and analytics for spatial products. Accessed October 3, 2026. https://kaleidr.com/enterprise
- Kaleidr Developer Docs. Products. Chat is Spatial AI in the host map, Editor is draw and edit, Tile is designed basemaps, and Viewer publishes a map. Accessed October 3, 2026. https://docs.kaleidr.com/
- Kaleidr Developer Docs. Platform API Endpoints. Documents chat, route, POI enrichment, and design calls, and does not document a CRM, inventory, booking, GTFS, or MQTT connector. Accessed October 3, 2026. https://docs.kaleidr.com/platform-api/endpoints
- Kaleidr. Real-Time Maps in Kaleidr Studio. Studio authors the spatial presentation, and the operational system remains the source of current state. https://kaleidr.com/blog/real-time-maps-in-kaleidr-studio
@misc{ogc_api_features_2026,
  title  = {OGC API - Features},
  author = {{Open Geospatial Consortium}},
  year   = {2026},
  url    = {https://ogcapi.ogc.org/features/}
}

@misc{cloudevents_2026,
  title  = {CloudEvents},
  author = {{CloudEvents}},
  year   = {2026},
  url    = {https://cloudevents.io/}
}

@misc{gtfs_overview_2026,
  title  = {GTFS Overview},
  author = {{General Transit Feed Specification}},
  year   = {2026},
  url    = {https://gtfs.org/documentation/overview/}
}

@misc{gtfs_realtime_2026,
  title  = {GTFS Realtime Reference},
  author = {{General Transit Feed Specification}},
  year   = {2026},
  url    = {https://gtfs.org/documentation/realtime/reference/}
}

@misc{oasis_mqtt_5_2019,
  title  = {MQTT Version 5.0},
  author = {{OASIS}},
  year   = {2019},
  url    = {https://www.oasis-open.org/standard/mqtt-v5-0-os/}
}

@misc{ogc_sensorthings_2026,
  title  = {OGC SensorThings API Standard},
  author = {{Open Geospatial Consortium}},
  year   = {2026},
  url    = {https://www.ogc.org/standards/sensorthings/}
}

@misc{kaleidr_booking_integration_2026,
  title  = {Location-Aware Booking},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/location-aware-booking}
}

@misc{kaleidr_private_location_integration_2026,
  title  = {Private Location Data for AI Map Workflows},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/private-location-data-for-ai-map-workflows}
}

@misc{kaleidr_observability_integration_2026,
  title  = {Spatial AI Observability},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-ai-observability}
}

@misc{kaleidr_enterprise_integration_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_docs_home_integration_2026,
  title  = {Kaleidr Developer Docs},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://docs.kaleidr.com/}
}

@misc{kaleidr_docs_endpoints_2026,
  title  = {Platform API Endpoints},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://docs.kaleidr.com/platform-api/endpoints}
}

@misc{kaleidr_realtime_maps_integration_2026,
  title  = {Real-Time Maps in Kaleidr Studio},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/real-time-maps-in-kaleidr-studio}
}