
L’architecture Spatial AI d’entreprise sépare les modèles de langage, les cartes, les données métier, les calculs spatiaux, les autorisations, les outils et les actions afin que chaque tâche reste dans la couche capable de l’appliquer. Une réponse fluide peut encore envoyer quelqu’un vers la mauvaise agence. L’hôte conserve l’identité et les transactions. Les services spatiaux calculent la géographie. Le modèle de langage interprète la demande et explique un résultat déjà fondé par ces systèmes.
Les sections ci-dessous couvrent la propriété, l’autorisation, les identifiants, les outils, le chemin de requête et trois modèles de déploiement. Les lectures associées incluent Spatial AI Accuracy Evaluation et An Enterprise Spatial AI Pilot. Un refus correct peut constituer un meilleur résultat qu’une recommandation plausible qu’aucun système de référence ne peut étayer.
Principes essentiels de l’architecture Spatial AI d’entreprise
- Séparer les tâches : Le modèle de langage interprète et explique. Il ne possède ni l’inventaire, ni les autorisations, ni les itinéraires, ni les transactions.
- Autoriser avant la récupération : Résoudre l’utilisateur, le tenant, les objets et les champs avant que le contexte privé n’atteigne le modèle.
- Garder les faits typés : Les identifiants stables et les champs opérationnels restent structurés. La prose ne les remplace pas.
- Borner chaque outil : Les actions de lecture, de carte, de brouillon et d’écriture suivent des règles d’approbation différentes.
- Mesurer le workflow : Observer la décision de localisation et le résultat côté hôte, pas seulement les tokens et la latence.
Qu’est-ce que l’architecture Spatial AI d’entreprise ?
Un client peut demander quel centre de service peut traiter une intervention aujourd’hui, se trouve dans la zone contractuelle et ajoute le moins de temps de trajet à l’itinéraire actuel. Cette phrase nécessite une couche d’intention, des dossiers client et contrat, des données d’établissement, des règles de zone de service, un calcul d’itinéraire et un workflow cartographique. Un système de production a aussi besoin d’identité, d’isolation des tenants, de limites d’outils, de contrôles d’action, de journaux et d’un endroit où une personne peut approuver une étape à fort impact. Mettre toutes ces tâches dans un seul prompt rend le produit difficile à sécuriser et à faire évoluer. Le modèle peut indiquer ce qui devrait se passer ensuite. L’application des règles reste en dehors du modèle.
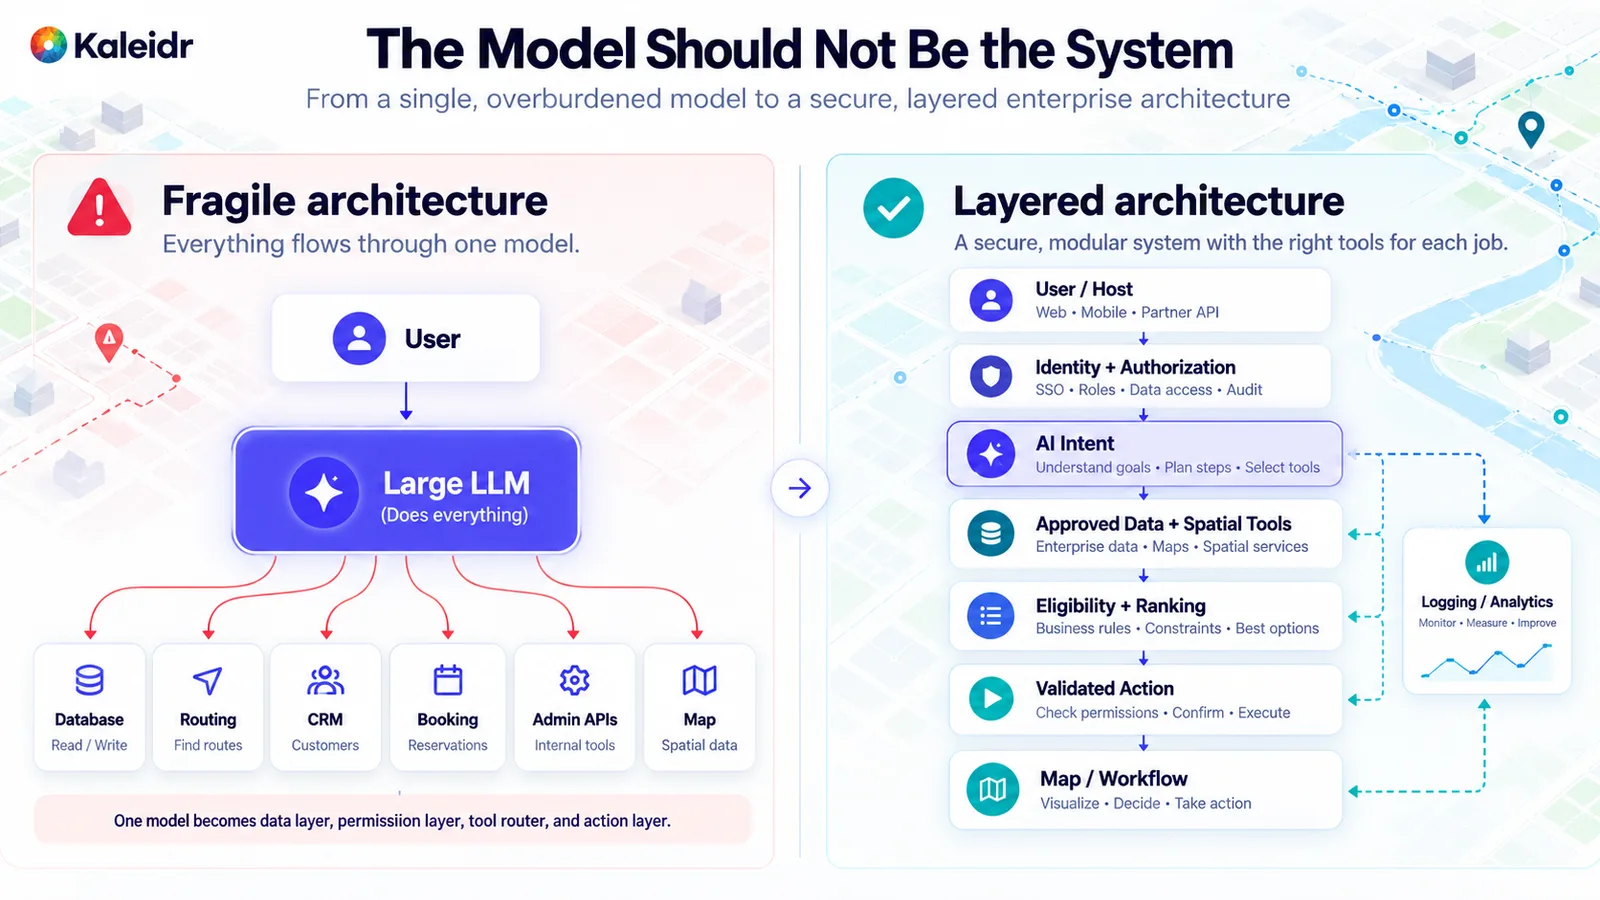
Le côté gauche connecte directement un modèle aux bases de données, au routage et aux transactions. Le côté droit maintient l’identité, les données, les outils spatiaux, le classement et l’action validée dans des couches distinctes. Ce contraste illustre un modèle d’architecture, pas un benchmark Kaleidr.
Un chemin pratique ressemble moins à un utilisateur parlant à un modèle capable d’atteindre tout le système qu’à une séquence que l’hôte peut inspecter. L’application détient l’utilisateur et l’état actuel de la carte. L’identité et l’autorisation sont résolues avant la récupération. L’interprétation de l’intention ne demande ensuite que des données approuvées et des calculs spatiaux. L’éligibilité retire les options invalides avant le classement. Une action validée met à jour la carte ou le workflow, et l’analytique enregistre si la tâche a réussi. Cette séquence permet à une équipe de changer de modèle, de fournisseur de cartes ou de règles de classement sans reconstruire le produit autour d’une dépendance opaque.
Quel système doit être propriétaire de chaque fait ?
Un atelier d’architecture doit nommer le propriétaire de chaque fait critique avant même de choisir un modèle. Le fournisseur d’identité de l’hôte possède l’utilisateur. L’application hôte possède l’appartenance au tenant, les droits produit, le workflow et le résultat métier. Les systèmes métier possèdent l’identité des établissements, l’inventaire, la disponibilité, le prix, le statut de réservation et les politiques. Une source de localisation approuvée possède les coordonnées. Le calcul spatial possède la distance, le temps de trajet et le point-dans-polygone. L’application cliente possède la fenêtre cartographique et le lieu sélectionné. La couche IA possède l’interprétation de l’intention et une explication fondée sur des preuves établies. Le workflow de l’hôte possède la transaction finale.
| Fait ou décision | Propriétaire faisant autorité |
|---|---|
| Identité utilisateur et tenant | Système d’identité de l’hôte |
| Inventaire, prix, réservation, politique | Système métier de référence |
| Distance, temps de trajet, inclusion | Calcul spatial |
| Fenêtre de carte et lieu sélectionné | Application cliente |
| Intention et explication | Couche IA, sur des preuves fondées |
| Transaction finale | Workflow de l’hôte |
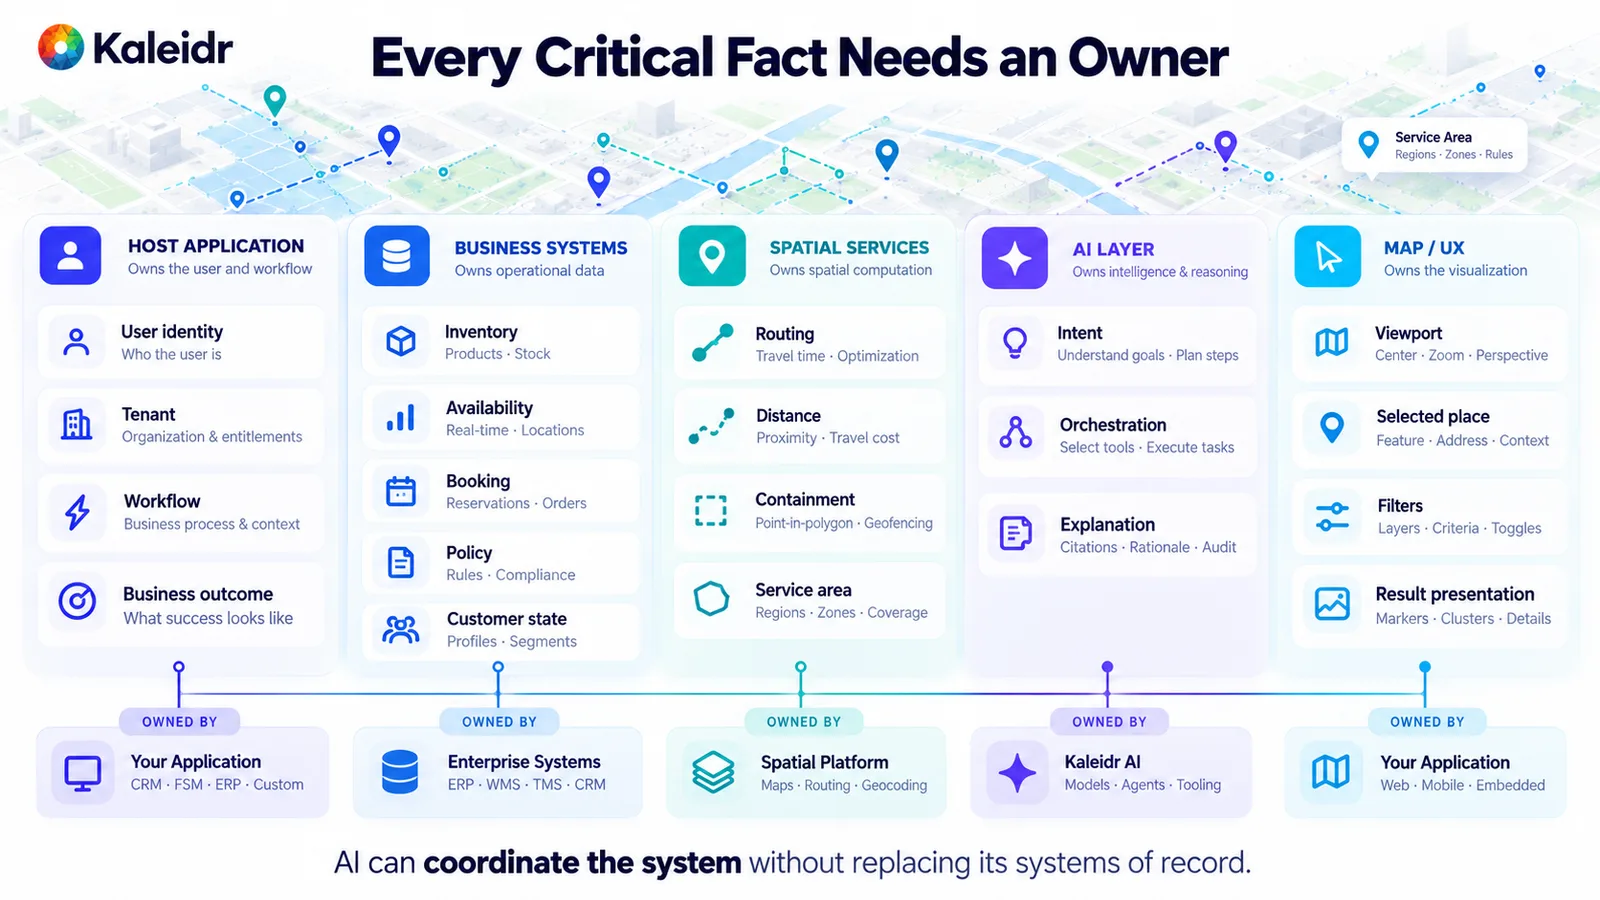
Chaque colonne a un propriétaire principal. La couche IA coordonne l’intention et l’explication. L’hôte et les systèmes métier restent les systèmes de référence, et le tableau est un cadre plutôt qu’un inventaire de produit.
Si une équipe ne peut pas nommer le propriétaire d’un fait critique, un assistant masque généralement la lacune. Les recommandations de Kaleidr sur la Spatial AI fondée utilisent la même séparation : le modèle interprète une intention composée, tandis que l’inventaire, les politiques, les autorisations et le routage restent dans les systèmes conçus pour détenir ces faits (Kaleidr, 2026). La récupération trouve du contexte. L’autorité détermine quelle source peut répondre à une question factuelle. Un document récupéré n’est pas automatiquement le système de référence.
Pourquoi autoriser avant la récupération ?
Une erreur courante consiste à récupérer des données privées, les envoyer au modèle, puis demander au modèle quelles lignes la personne est autorisée à voir. Il faut inverser cet ordre. Authentifier l’utilisateur, résoudre le tenant, résoudre les rôles et droits, autoriser les objets, minimiser les champs, récupérer les enregistrements approuvés, puis seulement transmettre le contexte nécessaire. La frontière d’autorisation doit être déterministe et auditable. Un modèle de langage ne doit pas décider si un responsable régional peut voir un établissement, si un client peut lire l’historique de localisation d’un autre client ou si un employé peut récupérer des données professionnelles restreintes.
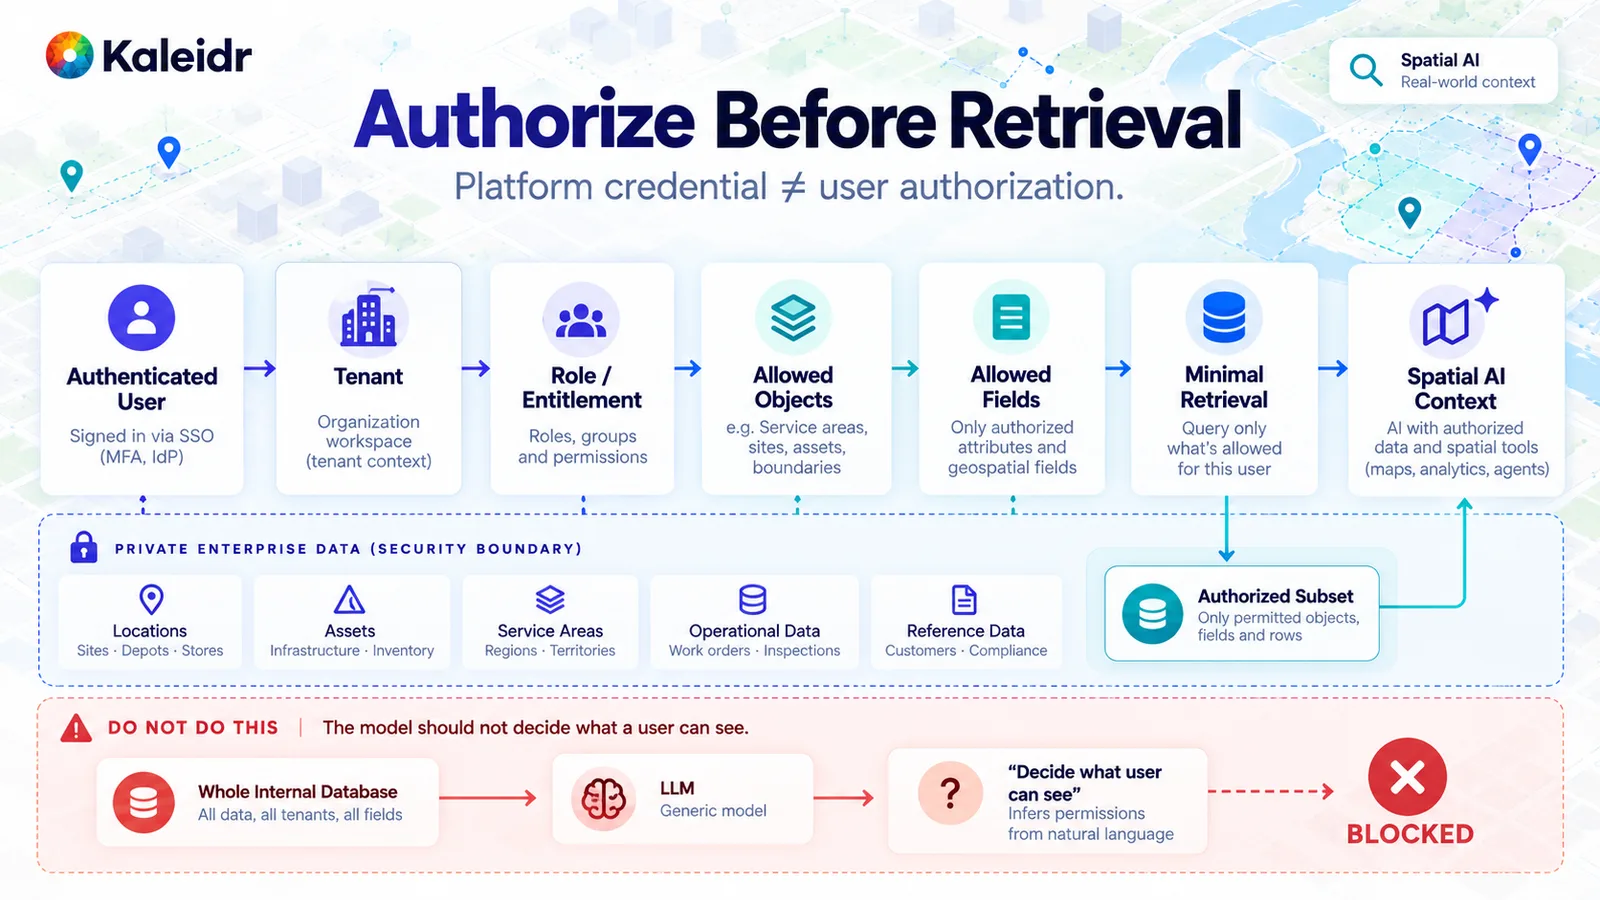
Les enregistrements privés franchissent la frontière seulement après les contrôles du tenant, du rôle, de l’objet et du champ. Le chemin inférieur, qui demanderait à un modèle d’inférer les autorisations à partir d’une base complète, reste bloqué. Les identifiants de plateforme et l’autorisation de l’utilisateur final demeurent des contrôles distincts.
Un identifiant de plateforme peut montrer qu’une application est autorisée à utiliser une capacité. Il ne décide pas quel utilisateur final peut lire quelles lignes. CORS, l’authentification des identifiants, les scopes de capacités API et l’autorisation utilisateur au niveau de l’application résolvent des problèmes différents ; les mélanger produit le mauvais type d’échec (Kaleidr, 2026). Le chemin des données privées est donc un empilement de contrôles, pas un seul token qui signifie tout.
Comment séparer les identifiants du navigateur et du serveur ?
Un navigateur est inspectable ; tout ce qui lui est livré doit donc être considéré comme visible par la personne qui l’exécute. Le backend est l’endroit approprié pour les secrets longue durée, l’accès aux données métier privées, l’application des politiques et les appels serveur-à-serveur. Le navigateur peut conserver un identifiant publiable et sûr pour le client, limité à une capacité cartographique définie. Les requêtes produit authentifiées vont au backend de l’hôte, qui applique le contexte utilisateur, accède aux données privées et appelle les opérations spatiales ou IA avec un identifiant serveur. Les deux environnements d’exécution ne doivent pas partager le même secret.
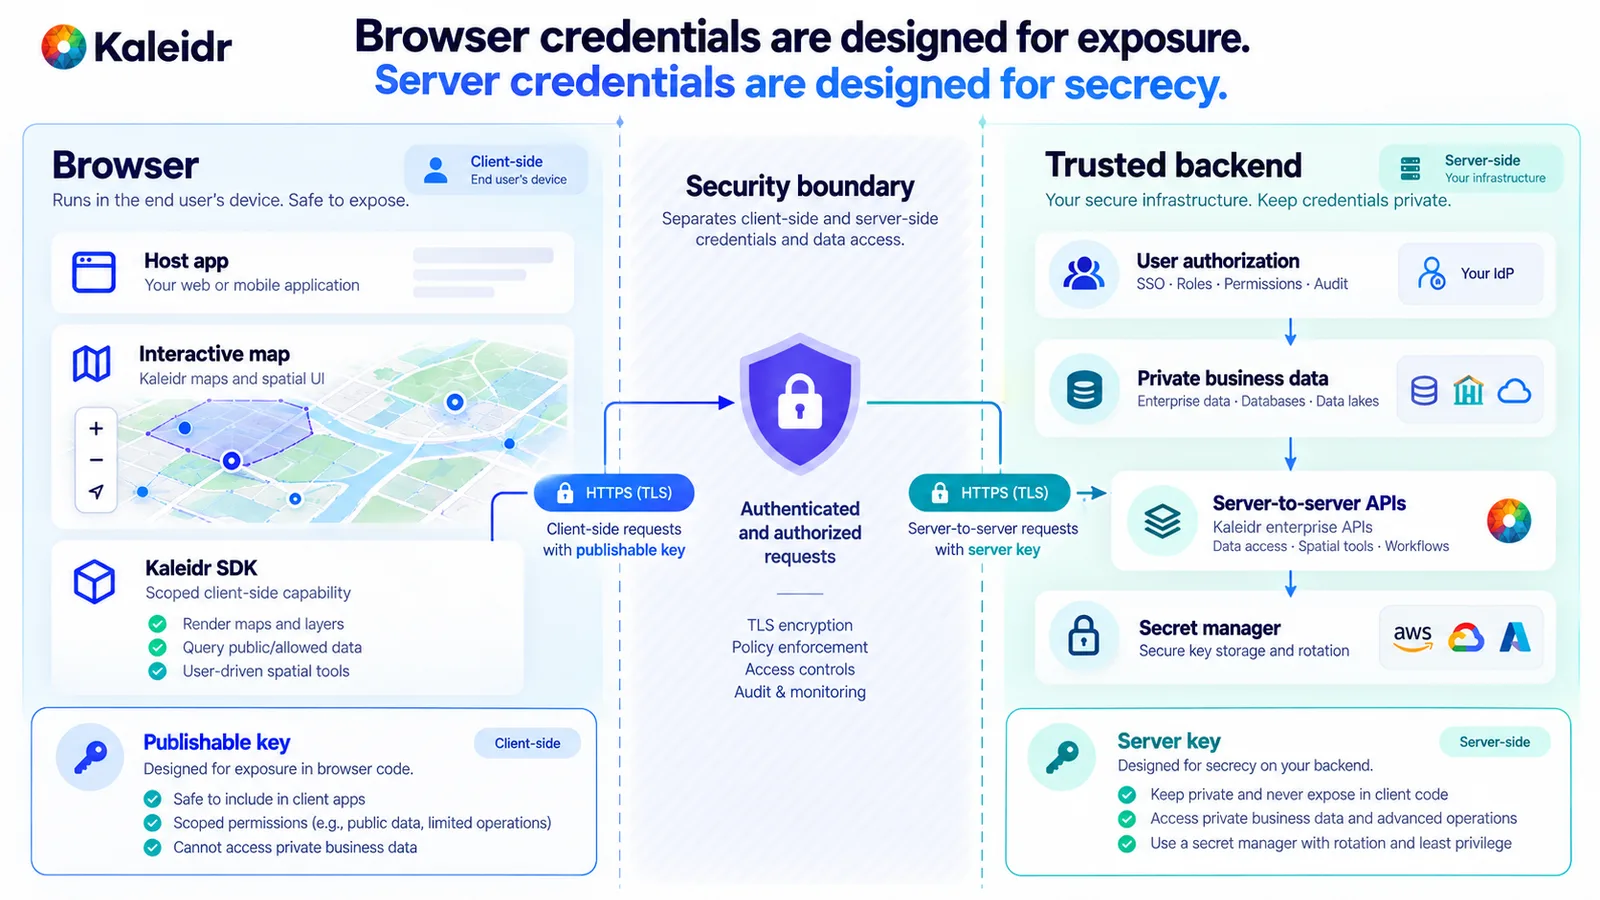
Le côté navigateur est conçu pour être exposé et reste limité à des capacités client bornées. Le côté serveur conserve l’identifiant serveur, les enregistrements privés et l’autorisation utilisateur. Les coches illustrent une frontière et ne constituent pas une certification de sécurité.
La documentation actuelle de Kaleidr sur les clés définit une clé publiable pour le navigateur et une clé serveur pour les intégrations backend. La clé publiable est verrouillée par origine, et le SDK l’échange à l’exécution contre une session courte plutôt que d’utiliser cette chaîne comme bearer serveur permanent. La clé serveur reste sur des serveurs de confiance (Kaleidr, 2026). Le même ensemble documentaire décrit Chat, Editor, Tile et Viewer comme des surfaces distinctes, avec des points d’entrée attach, embed et tile qui ne se montent pas tous de la même manière (Kaleidr, 2026). Suivez le contrat actuel de chaque surface au lieu de supposer qu’un seul identifiant et un seul montage couvrent toute la pile.
Où doivent vivre les faits métier et la géographie ?
Enterprise Spatial AI est utile lorsqu’elle peut raisonner sur des faits qu’un modèle public ne connaît pas : inventaire actuel, éligibilité d’un partenaire, capacité d’un établissement, couverture contractuelle, fermetures temporaires et disponibilité en temps réel. Ces faits appartiennent aux systèmes de référence. Ne demandez pas à un modèle de mémoriser une valeur susceptible de changer cet après-midi. N’affinez pas un modèle sur un champ opérationnel qu’une requête peut retourner. Ne collez pas une vaste base interne dans un system prompt. Interprétez la demande, déterminez quels enregistrements autorisés sont nécessaires, récupérez le minimum, conservez des ID stables et des champs typés, appliquez les filtres stricts, calculez la géographie, puis seulement expliquez le résultat fondé.
{
  "branch_id": "b_1042",
  "open_now": true,
  "inventory_status": "in_stock",
  "service_eligible": true,
  "lat": 38.91,
  "lng": -77.22
}
Un enregistrement typé peut être filtré, journalisé, contrôlé selon les permissions et transmis à une action ultérieure. Une phrase disant qu’une agence « semble ouverte » et « a probablement » l’article ne le peut pas. Le langage naturel reste utile pour l’explication. Il ne doit pas remplacer des champs que l’application peut stocker directement.
Les calculs spatiaux méritent leur propre couche pour la même raison. Point-dans-polygone, distance d’itinéraire, temps de conduite, temps de marche, appartenance à une zone de service, déviation d’itinéraire et analyse d’accessibilité dans un délai donné doivent provenir d’un service géographique lorsque le produit peut les calculer. La couche IA peut déterminer qu’un calcul est nécessaire. Le service spatial l’effectue. L’explication indique ensuite pourquoi cette relation compte pour la demande. Changer de modèle de langage n’oblige pas l’équipe à réapprendre comment l’application mesure le temps de trajet ou l’inclusion.
Les contraintes strictes et les préférences souples doivent rester séparées. Une demande de clinique peut exiger un régime accepté, des horaires après 18 h, un établissement actif et un enregistrement auquel l’utilisateur est autorisé à accéder. Seuls les candidats qui passent ces règles doivent être classés selon le temps de conduite, la déviation d’itinéraire ou une préférence déclarée. L’ordre est récupération, autorisation, éligibilité, calcul spatial, classement et explication. Classer d’abord, en espérant que le modèle se souvienne de toutes les contraintes, masque une option invalide dans une liste fluide. Commerce, immobilier, réservation, lieux de travail et réseaux multi-sites peuvent partager cet ordre, car la contrainte porte sur la validité, pas sur le vocabulaire du secteur.
Comment borner les outils et les actions ?
La Spatial AI agentique fait du catalogue d’outils l’une des frontières importantes. Des outils ouverts comme une chaîne SQL arbitraire, une commande shell ou une URL interne libre constituent un environnement d’exécution, pas une capacité métier. Préférez des outils étroits avec entrées et sorties connues : rechercher des sites éligibles, calculer un temps de trajet, lire la disponibilité d’une agence, afficher des lieux, demander un itinéraire ou créer un brouillon de réservation. Chaque outil peut porter son propre contrôle de permission, sa validation, sa limite de débit, sa ligne de journal et son mode d’échec.
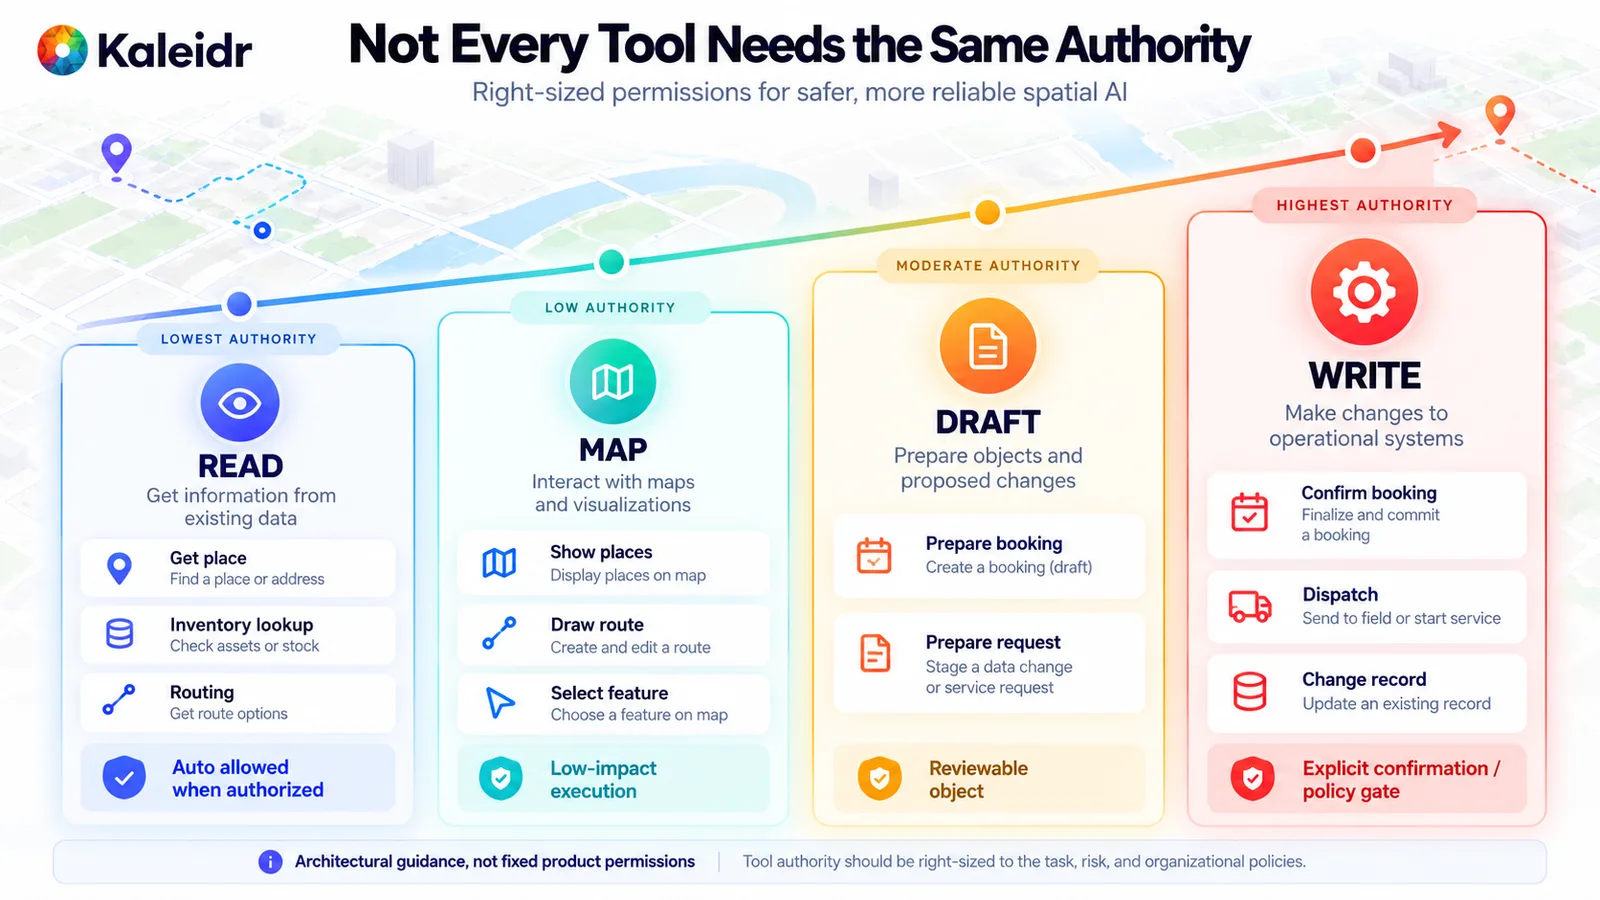
Les outils de lecture et de carte peuvent s’exécuter lorsque l’appelant est déjà autorisé. Les brouillons créent un objet révisable. Les écritures qui confirment une réservation, lancent une affectation ou modifient un enregistrement attendent une règle d’approbation explicite. Ces niveaux constituent une orientation architecturale, pas une liste fixe de permissions Kaleidr.
Lire un enregistrement et modifier l’état métier relèvent de classes de risque différentes. Un catalogue de production peut regrouper les capacités en lecture, carte, brouillon et écriture. Les actions de lecture et de carte à faible impact peuvent s’exécuter automatiquement une fois l’autorisation validée. Un brouillon peut préparer une réservation ou une demande de service pour révision. Une écriture qui confirme une réservation, affecte un véhicule ou publie un changement peut nécessiter une confirmation, un second contrôle de politique et parfois une personne. Un score de confiance n’est pas un système de permissions.
Les recommandations OWASP 2025 sur l’excessive agency traitent les fonctionnalités excessives, les permissions excessives et l’autonomie excessive comme des causes distinctes. Elles recommandent de limiter au minimum nécessaire les extensions qu’un agent peut appeler, de préférer des fonctions granulaires aux fonctions ouvertes, d’exiger une approbation pour les actions à fort impact et de faire respecter l’autorisation dans les systèmes en aval plutôt que de compter sur le modèle pour permettre l’appel (OWASP, 2025). L’application doit tout de même valider chaque appel proposé. Pour une action cartographique, vérifiez que l’action est autorisée, que les ID de lieux appartiennent à l’ensemble de résultats autorisé, que l’utilisateur peut y accéder et que les arguments sont bien formés. Pour une écriture, appliquez un contrôle plus strict. Un prompt, un document récupéré ou un résultat d’outil mal formé ne doit jamais devenir un contournement d’autorisation.
Les recommandations OWASP sur les system prompts posent la même frontière depuis l’autre côté. Le system prompt n’est ni un secret ni un contrôle de sécurité. La séparation des privilèges et les contrôles d’autorisation ne doivent pas être délégués au modèle, via le prompt ou autrement (OWASP, 2025). Les actions cartographiques doivent employer un vocabulaire sémantique, par exemple afficher des lieux, ajuster la vue aux lieux, sélectionner un lieu, tracer un itinéraire ou effacer un itinéraire, et un adaptateur déterministe doit traduire ces actions pour Mapbox, MapLibre, Google Maps ou un autre moteur de rendu. Le modèle ne doit pas produire du code de rendu à chaque tour.
Comment l’état de la carte doit-il entrer dans la requête ?
L’état de la carte change ce qu’une personne entend par « ceux-ci », « au nord d’ici » ou « la deuxième option ». Un instantané utile peut inclure les limites de la fenêtre, l’ID du lieu sélectionné, les ID des résultats visibles, les filtres actifs, l’ID de l’itinéraire actuel et une localisation approuvée avec la précision requise par la tâche. Indiquez quels champs sont toujours disponibles, optionnels, privés, approuvés par l’utilisateur, périmés, faisant autorité ou inférés. N’envoyez pas la position précise de l’appareil à chaque requête simplement parce que la carte peut la lire. La meilleure référence pour « lequel de ceux-ci ferme plus tard » est l’ensemble d’ID stables des résultats actuels, pas une capture d’écran. Les recommandations de Kaleidr sur les assistants map-aware tracent cette frontière : partager fenêtre, sélection, filtres et ID de résultats, et ne pas demander au modèle de déduire l’application à partir des pixels (Kaleidr, 2026).
Une couche d’orchestration peut décider si la demande nécessite une récupération métier, un routage, une action cartographique, une question de clarification ou un résumé des preuves. Cette couche peut être pilotée par modèle, par règles ou par un mélange des deux. Elle ne doit pas constituer l’unique frontière de sécurité. L’orchestration peut demander s’il faut appeler la disponibilité. L’autorisation détermine si cet appelant peut récupérer la disponibilité de ces enregistrements. L’orchestration peut demander s’il faut démarrer une réservation. La couche transactionnelle détermine si la personne a confirmé et si l’opération est valide. Cette séparation résiste à une erreur du modèle.
L’isolation des tenants appartient au même chemin. Résolvez l’identité authentifiée, le tenant, le rôle et les objets autorisés avant la requête, puis limitez la requête à ce tenant. Ne vous fiez pas à un prompt indiquant simplement au modèle de ne pas mentionner les autres tenants. Le modèle ne doit jamais recevoir les données d’un autre tenant, sauf si l’application dispose d’un objectif et d’une politique inter-tenants explicites. Requêtes limitées au tenant, contrôles d’objets, minimisation des champs et journaux expurgés constituent les contrôles. Une phrase dans un prompt n’en fait pas partie.
Comment une requête de production traverse-t-elle la pile ?
Une requête complète peut être représentée en douze étapes, et toutes les requêtes n’ont pas besoin de chacune d’elles. Capturez l’utilisateur authentifié, le tenant, l’état de la carte et l’état du workflow. Interprétez la tâche, les contraintes géographiques, les contraintes métier et l’action visée. Résolvez les sources, enregistrements, champs, outils et actions autorisés avant toute récupération privée.
Récupérez les faits autorisés et les ID de lieux canoniques, puis calculez la distance, le temps de trajet, l’inclusion ou l’appartenance à une zone de service. Retirez les candidats non autorisés, indisponibles, fermés ou hors zone, puis classez ce qui reste. Expliquez le résultat fondé, proposez une action sémantique cartographique ou de workflow et validez cette action en dehors du modèle. Exécutez l’action, puis enregistrez la décision et le résultat.
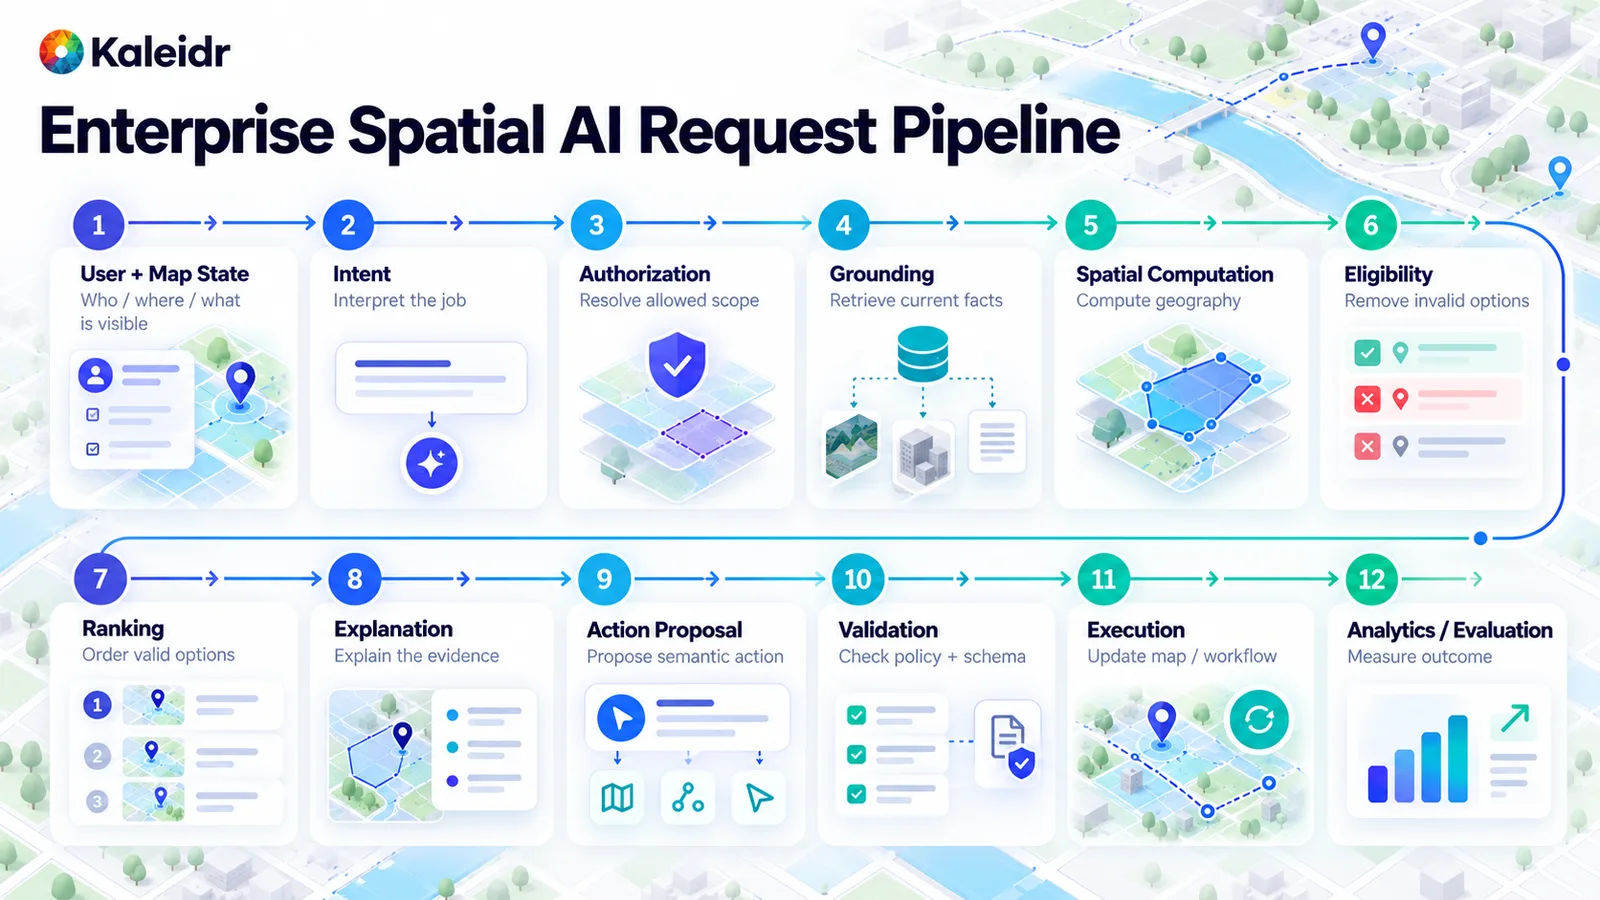
Les étapes vont de l’état de la carte et de l’intention à l’autorisation, au grounding, à la géographie, à l’éligibilité et au classement, puis à l’explication, l’action proposée, la validation, l’exécution et la mesure. Une simple demande « afficher ce lieu » peut sauter la récupération et le classement. Une recommandation de service peut utiliser presque tout le chemin.
Le comportement en cas d’échec fait partie du même chemin. Si les données métier ne sont pas disponibles, n’inventez pas la disponibilité. Indiquez qu’elle ne peut pas être vérifiée actuellement. Si le routage est indisponible, ne prétendez pas classer par temps de trajet et étiquetez toute solution de repli en ligne droite comme telle. Si aucun candidat ne satisfait les règles strictes, retournez aucun résultat au lieu d’assouplir silencieusement une contrainte critique. Si l’autorisation échoue, ne demandez pas au modèle d’expliquer des informations privées qu’il n’a jamais reçues. Si le modèle est indisponible, une recherche et des filtres déterministes peuvent encore servir la carte. Si un résultat d’outil est mal formé, rejetez-le lors de la validation. Lorsqu’un produit n’a pas de mode dégradé explicite, le modèle de langage devient le fallback accidentel d’une infrastructure manquante.
L’approbation humaine suit l’impact, pas une règle unique pour chaque bouton. Afficher trois lieux publics est à faible impact. Confirmer un rendez-vous, affecter un véhicule, modifier la fiche d’un établissement ou envoyer une réservation payante ne l’est pas. Classez recherche, récupération et aperçu d’itinéraire comme faible impact. Une préférence enregistrée ou un brouillon comme impact moyen. Un achat, une affectation, une écriture opérationnelle ou un changement d’autorisation comme fort impact. Exécution automatique, confirmation utilisateur et approbation séparée peuvent alors correspondre à la classe. L’AI Risk Management Framework du NIST est volontaire et vise à intégrer la fiabilité dans la conception, le développement, l’utilisation et l’évaluation des produits d’IA. La même page du NIST indique que l’AI RMF 1.0 est en cours de révision (NIST, 2023). Le cadre fournit un contexte aux propres décisions de risque du produit ; il ne constitue pas une liste de contrôles Kaleidr.
Où se situe le plan de contrôle ?
Le chemin de requête gère le travail en temps réel : utilisateur, autorisation, récupération, outils spatiaux, modèle, action et réponse. Le plan de contrôle décide comment ce chemin est autorisé à s’exécuter. Identifiants, scopes, choix du modèle, prompts, politiques d’outils, configuration des sources de données, limites de débit, environnements, suites d’évaluation, feature flags et paramètres d’audit y résident. Séparer les deux permet à une équipe de changer une politique sans réécrire chaque flux conversationnel. Désactiver un outil d’écriture ne devrait pas nécessiter une nouvelle interface. Le plan de contrôle est un modèle d’architecture pour ces réglages, et le schéma n’affirme pas qu’un produit fournit chaque case.
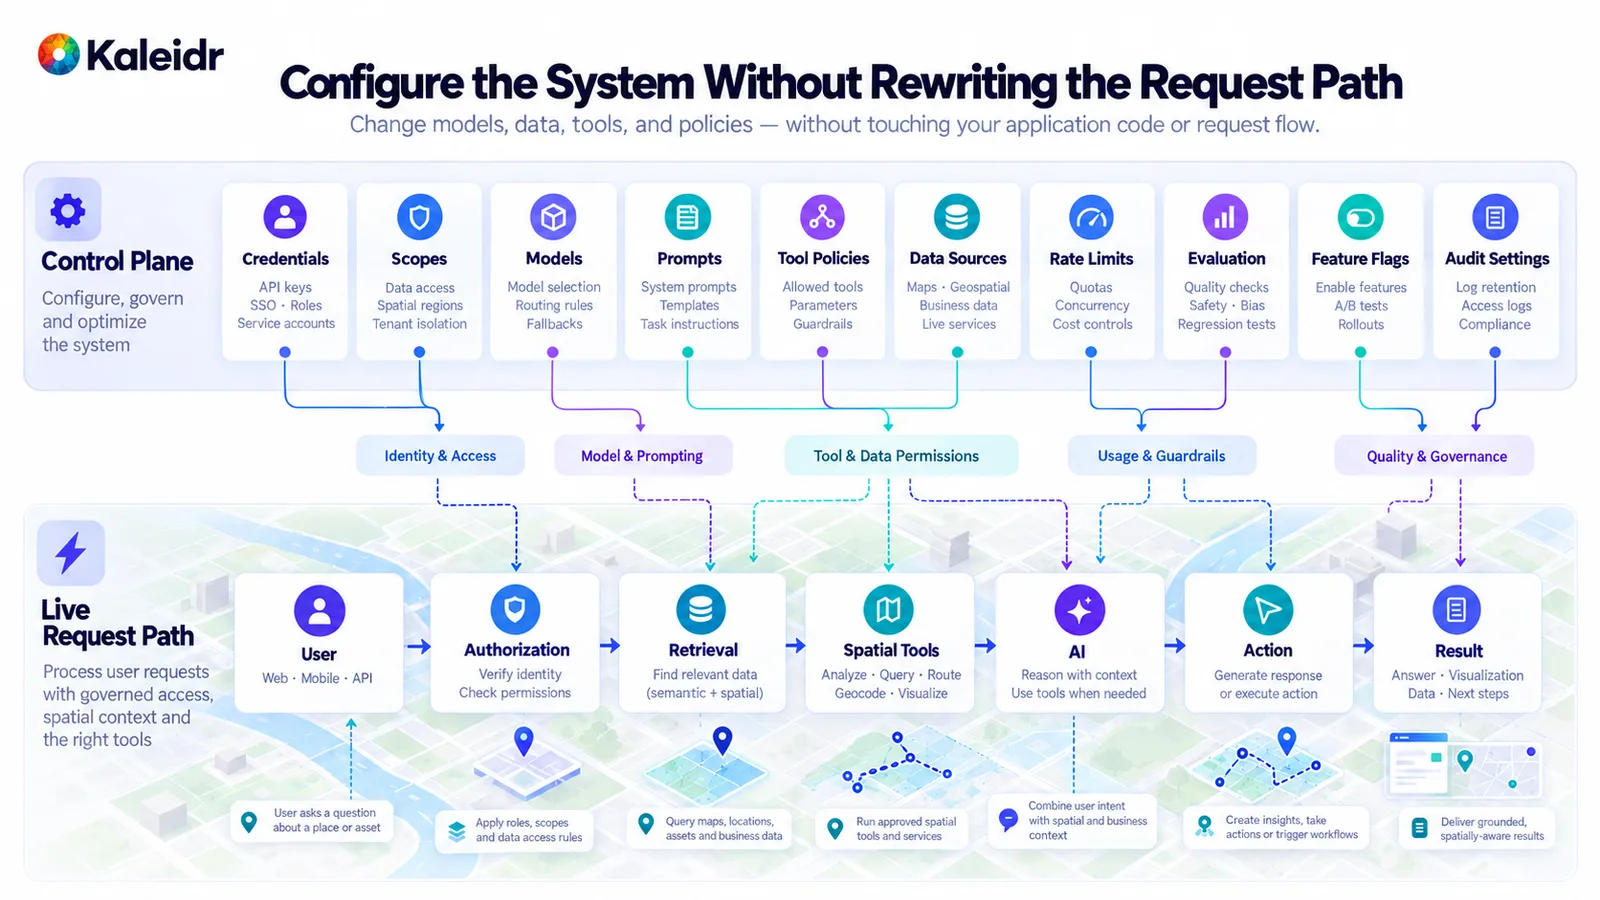
La rangée supérieure contient la configuration : identifiants, scopes, modèles, prompts, politiques d’outils, sources de données, limites, évaluation, flags et paramètres d’audit. La rangée inférieure correspond à la requête en direct. La politique pointe vers les étapes qu’elle gouverne, afin qu’une équipe puisse changer une règle sans réécrire le chemin.
L’observabilité doit suivre la décision, pas seulement la facture de tokens. Parmi les événements utiles figurent intention résolue, autorisation acceptée ou refusée, récupération terminée, candidats retirés par l’éligibilité, calcul spatial terminé, classement terminé, réponse sans résultat, outil proposé, outil rejeté, action cartographique exécutée, lieu sélectionné et workflow terminé. Ces noms constituent un modèle à concevoir, pas une liste automatiquement émise par une plateforme. Les questions auxquelles ils répondent sont pratiques. Les erreurs viennent-elles de la résolution de lieux ou du classement ? Les personnes rejettent-elles une liste valide ? Un marché produit-il davantage de résultats vides ? Les appels d’outils échouent-ils sur les permissions ou sur des arguments mal formés ? La personne termine-t-elle la tâche de l’hôte après avoir sélectionné un lieu ? Le cœur de l’AI RMF du NIST indique que les jeux de test, les métriques et les détails sur les outils utilisés pendant les tests, l’évaluation, la vérification et la validation sont documentés (NIST, 2023). Pour Spatial AI, les tests documentés doivent couvrir la décision géographique et métier, pas seulement la phrase générée.
L’analytique spatiale et les résultats de l’hôte répondent à des questions différentes, et l’architecture doit les relier avec des ID stables. Kaleidr Analytics décrit actuellement des tableaux de bord pour la portée, les vues et l’engagement, la localisation et l’activité du public, les sessions, vues et interactions par carte, ainsi que les motifs spatiaux (Kaleidr, 2026). Les réservations, achats, leads qualifiés, affectations et services terminés restent dans les systèmes hôtes qui les possèdent. Un ID de recommandation peut pointer vers un ID de lieu sélectionné, puis vers un ID de workflow hôte, puis vers le résultat. Les informations publiques sur Analytics n’affirment pas que chaque conversion métier est capturée automatiquement.
Quels sont les trois modèles de déploiement ?
Trois modèles couvrent la plupart des déploiements d’entreprise, et aucun n’est universellement meilleur. Un assistant cartographique public convient au tourisme, à la découverte, aux cartes éditoriales et à l’exploration d’événements. La carte du navigateur utilise une capacité client publiable, une IA consciente de la carte, des données de lieux publiques ou approuvées et des outils spatiaux, puis renvoie une action cartographique. La frontière des données est plus simple car le workflow est principalement public. Un assistant métier authentifié convient aux portails clients, à la sélection de magasins tenant compte du stock, à l’immobilier, aux réseaux de partenaires et aux sites privés. Le navigateur atteint une connexion hôte et un backend hôte, qui appliquent l’autorisation du tenant et de l’objet avant que les données privées, les outils spatiaux et l’explication ne reviennent vers la carte. Un agent spatial avec actions métier convient aux workflows de réservation, d’affectation et d’exploitation. Le chemin ajoute une proposition d’outil typée, une validation déterministe, une confirmation lorsque l’impact l’exige, le système transactionnel et un audit du résultat. Ce troisième modèle modifie l’état métier et porte donc la gouvernance la plus stricte.
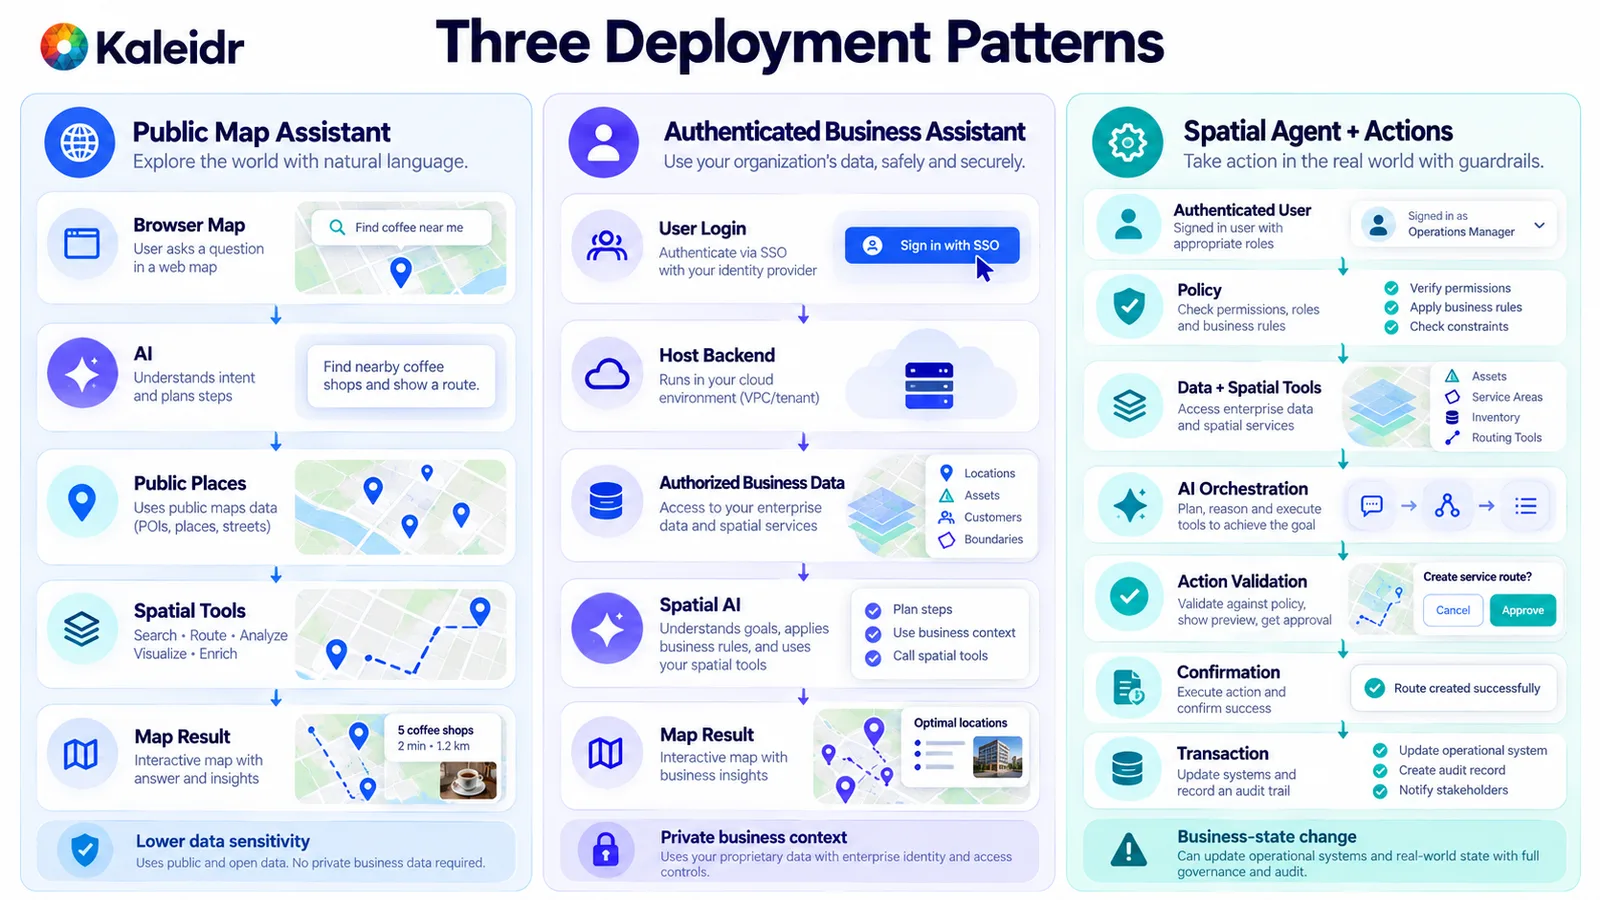
Le modèle public reste sur des lieux publics approuvés. Le modèle authentifié conserve les enregistrements privés derrière l’hôte. Le modèle d’action ajoute validation et confirmation avant une transaction. Les cartes de lieux d’exemple dans l’illustration sont indicatives, pas des résultats Kaleidr mesurés.
Où Kaleidr s’insère-t-il dans cette architecture ?
Kaleidr décrit actuellement Enterprise comme une infrastructure de location intelligence pour les équipes produit, avec des inference APIs, du classement, de l’analytique et des surfaces SDK qu’un hôte peut ajouter (Kaleidr, 2026). La documentation développeur répertorie quatre surfaces dans un seul SDK. Chat ajoute l’interaction IA à une carte déjà exploitée par l’hôte. Editor intègre l’édition cartographique dans un produit. Tile sert un fond de carte conçu. Viewer publie une carte pour l’intégration. La documentation actuelle de Chat cite Mapbox, MapLibre et Google Maps comme chemins d’intégration pour cette carte exploitée par l’hôte (Kaleidr, 2026). L’hôte conserve les utilisateurs finaux, l’authentification, l’autorisation des tenants, les systèmes métier privés, les règles de workflow, les transactions et les résultats métier. Kaleidr ajoute certaines surfaces spatiales et ne remplace pas les systèmes qui restent autoritatifs dans la pile de l’hôte.
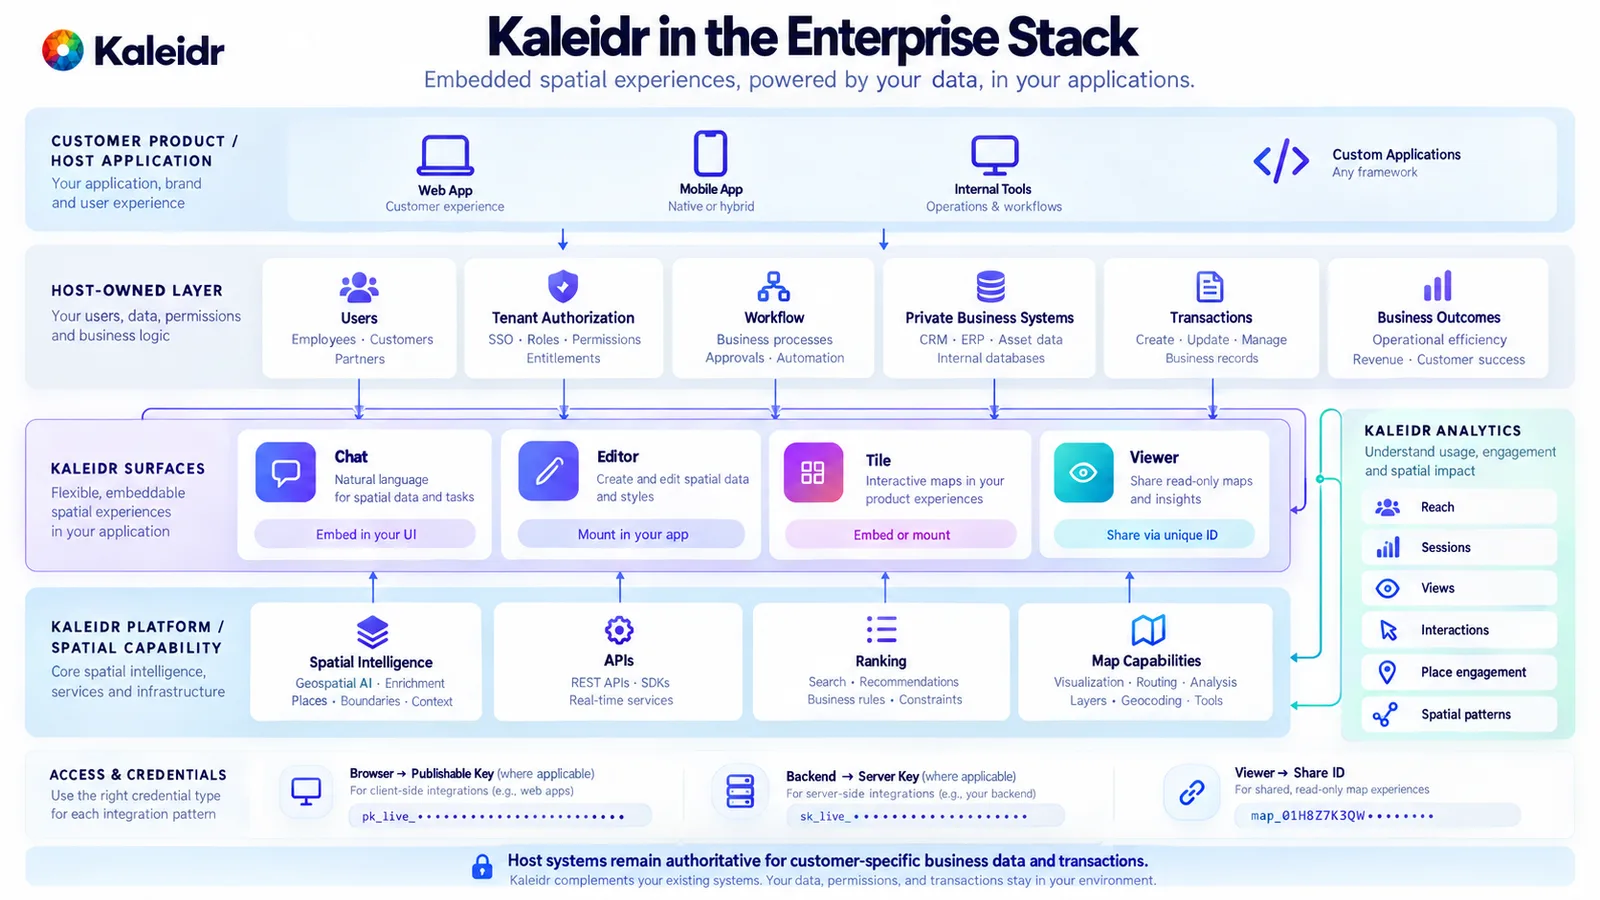
La rangée hôte conserve les utilisateurs, l’autorisation des tenants, les workflows, les systèmes privés, les transactions et les résultats. Chat, Editor, Tile et Viewer se trouvent aux côtés des APIs de plateforme et d’Analytics. Les libellés d’identifiants suivent la séparation navigateur public/serveur, et la figure ne montre aucun secret réel.
Quelles erreurs restent cachées jusqu’à la production ?
Connecter directement le modèle à chaque système crée des privilèges excessifs et rend difficile l’identification de la couche en échec. Traiter un prompt comme couche d’autorisation échoue pour la même raison : un prompt peut orienter la formulation, mais il ne peut pas autoriser ou refuser de façon déterministe un enregistrement. Envoyer toute la base de données interne dans le contexte viole la minimisation. Mélanger les filtres stricts et le classement laisse un lieu inéligible survivre dans une moyenne. Demander au modèle d’estimer une distance que le service spatial peut calculer remplace un calcul par de la fluidité. Un outil sans restriction, ou un outil d’écriture héritant de la politique d’un outil de lecture, donne à une recommandation l’autorité d’une transaction. Traiter la carte comme une image fait perdre les ID stables dont le prochain tour a besoin. Surveiller uniquement la latence et le coût en tokens manque la résolution des lieux, l’éligibilité, le routage, le classement, les échecs d’outils et le résultat côté hôte. Un benchmark du modèle, à lui seul, ne peut pas dire que le workflow assemblé est prêt.
Le premier projet public du cadre TEVV-Athlon du NIST, NIST AI 200-2, annoncé le 7 août 2026 avec commentaires ouverts jusqu’au 6 octobre 2026, décrit l’évaluation comme une preuve qu’un système atteint des objectifs individuels ou organisationnels, avec des mesures adaptées à l’application et à son impact réel, y compris pour les systèmes agentiques (NIST, 2026). Le document est un projet sollicitant des commentaires. Ce projet n’est pas une liste de contrôles Kaleidr. Pour cette architecture, le contexte d’évaluation est la décision dépendante de la localisation : intention, autorisation, grounding, géographie, éligibilité, classement, outils, actions, gestion des échecs et résultat de l’hôte.
Comment l’architecture Spatial AI d’entreprise devient-elle une porte de mise en production ?
Avant qu’un pilote ne progresse vers la production, confirmez les propriétaires. L’utilisateur est authentifié lorsque le workflow l’exige, et l’appartenance au tenant est résolue hors du modèle. Chaque champ critique possède une source faisant autorité, la récupération privée intervient avant l’inférence, les champs sont minimisés et les ID stables survivent au transfert. Les services géographiques effectuent les calculs que le produit revendique, et les tolérances utilisées dans l’évaluation sont documentées. Les outils sont étroits, lecture et écriture sont séparées, les arguments sont validés et les actions à fort impact peuvent être confirmées et auditées. Les identifiants navigateur et serveur restent séparés, les scopes limités et les environnements distincts. L’équipe peut voir la chaîne de décision et relier une sélection de lieu à un résultat hôte. Données indisponibles, ensembles de candidats vides et modes dégradés sont explicites, et les opérations critiques échouent en mode fermé au lieu d’inventer un fait. Explorez Kaleidr Enterprise pour les APIs de spatial intelligence, le classement, l’analytique et les surfaces SDK à côté de la pile déjà exploitée par le produit. Consultez la documentation développeur Kaleidr pour les contrats actuels de Chat, Editor, Tile, Viewer, clés et scopes avant l’implémentation.
FAQ
Qu’est-ce que l’architecture Spatial AI d’entreprise ?
L’architecture Spatial AI d’entreprise est la conception système qui relie modèles de langage, cartes, services géographiques, données métier, permissions, outils, actions et analytique, et conserve chaque responsabilité dans la couche capable de l’appliquer.
Un modèle de langage doit-il avoir un accès direct à une base de données métier ?
En général, pas sous forme d’interface sans restriction. Autorisez l’utilisateur actuel, récupérez le minimum d’enregistrements nécessaire à la tâche, gardez les champs structurés et exposez des outils étroits. Un accès ouvert à la base transforme le modèle en moteur de permissions.
De quoi le modèle de langage doit-il être responsable ?
Le modèle convient à l’intention en langage naturel, à l’orchestration entre capacités approuvées et à l’explication d’un résultat fondé. Autorisation, transactions, vérité métier et calculs géographiques restent dans les systèmes conçus pour ces tâches.
Quelle différence entre authentification de plateforme et autorisation utilisateur ?
L’authentification de plateforme établit qu’une application peut utiliser une capacité de plateforme. L’autorisation utilisateur détermine quelle personne ou quel tenant peut accéder à un enregistrement ou lancer une action métier. Un contrôle ne remplace pas l’autre.
Spatial AI doit-elle utiliser la génération augmentée par récupération ?
La récupération peut fournir des documents ou enregistrements pertinents. La récupération seule n’établit pas l’autorité. Inventaire, disponibilité, prix, permissions et appartenance à une zone de service doivent rester liés à leurs systèmes de référence et à des règles déterministes.
Comment sécuriser les outils Spatial AI ?
Utilisez des fonctions étroites, des permissions minimales, l’autorisation dans le contexte utilisateur, la validation des arguments, des limites de débit, la supervision et une approbation indépendante pour les actions à fort impact. Ne traitez ni le modèle ni le system prompt comme mécanisme d’autorisation.
Les actions Spatial AI doivent-elles nécessiter une approbation humaine ?
L’approbation dépend de l’impact. Les actions cartographiques à faible risque, comme afficher des lieux, peuvent s’exécuter automatiquement. Achats, réservations, affectations, écritures administratives et changements de permissions peuvent exiger une confirmation explicite ou une approbation séparée.
Comment un assistant cartographique doit-il utiliser la carte actuelle ?
Transmettez un état structuré, comme les limites du viewport, les ID de lieux sélectionnés, les filtres actifs, les ID de résultats visibles, les ID d’itinéraires et une localisation à la précision nécessaire à la tâche. Ne demandez pas au modèle d’inférer l’état de l’application depuis une capture d’écran lorsqu’un état structuré existe.
Spatial AI peut-elle fonctionner avec une carte existante ?
Oui. Une couche Spatial AI peut se rattacher à une carte et à une application que l’hôte exploite déjà. La documentation actuelle de Kaleidr Chat décrit l’ajout d’une Spatial AI conversationnelle à des instances Mapbox, MapLibre ou Google Maps exploitées par l’hôte.
Comment une équipe doit-elle évaluer l’architecture avant de passer à l’échelle ?
Évaluez le workflow assemblé : intention, autorisation, grounding, calculs géographiques, éligibilité, classement, explication, outils, actions, gestion des échecs et résultats métier. Un benchmark général de modèle de langage ne remplace pas ce test.
Références
- Kaleidr. Grounded Spatial AI for Business Data. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- Kaleidr. Map API Authentication. https://kaleidr.com/blog/map-api-authentication
- Kaleidr. Get an API Key. Publishable browser keys and server keys. Accessed September 30, 2026. https://docs.kaleidr.com/get-an-api-key
- Kaleidr. Introduction. Chat, Editor, Tile, and Viewer in one SDK. Accessed September 30, 2026. https://docs.kaleidr.com/
- OWASP Gen AI Security Project. LLM06:2025 Excessive Agency. Accessed September 30, 2026. https://genai.owasp.org/llmrisk/llm062025-excessive-agency/
- OWASP Gen AI Security Project. LLM07:2025 System Prompt Leakage. Accessed September 30, 2026. https://genai.owasp.org/llmrisk/llm072025-system-prompt-leakage/
- Kaleidr. How to Build a Map-Aware AI Assistant. https://kaleidr.com/blog/how-to-build-a-map-aware-ai-assistant
- National Institute of Standards and Technology. AI Risk Management Framework. Voluntary framework for trustworthiness in design, development, use, and evaluation. Released January 26, 2023. Page states that AI RMF 1.0 is being revised. Accessed September 30, 2026. https://www.nist.gov/itl/ai-risk-management-framework
- National Institute of Standards and Technology. AI RMF Core. Measure 2.1: test sets, metrics, and details about the tools used during TEVV are documented. Accessed September 30, 2026. https://airc.nist.gov/airmf-resources/airmf/5-sec-core/
- Kaleidr. Map Engagement and Location Analytics. Accessed September 30, 2026. https://kaleidr.com/analytics
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed September 30, 2026. https://kaleidr.com/enterprise
- Kaleidr. Chat. Attach AI to a host-run Mapbox, MapLibre, or Google Maps instance. Accessed September 30, 2026. https://docs.kaleidr.com/chat
- National Institute of Standards and Technology. The TEVV-Athlon Framework for Evaluating AI Systems. NIST AI 200-2, initial public draft. Announced August 7, 2026; comments through October 6, 2026. https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems
- Kaleidr. Spatial AI Accuracy Evaluation. https://kaleidr.com/blog/spatial-ai-accuracy-evaluation
- Kaleidr. An Enterprise Spatial AI Pilot Before Scaling. https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling
@misc{kaleidr_grounded_architecture_2026,
  title  = {Grounded Spatial AI for Business Data},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/grounded-spatial-ai-business-data}
}

@misc{kaleidr_map_api_auth_2026,
  title  = {Map API Authentication},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/map-api-authentication}
}

@misc{kaleidr_get_api_key_2026,
  title  = {Get an API Key},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 30, 2026},
  url    = {https://docs.kaleidr.com/get-an-api-key}
}

@misc{kaleidr_docs_intro_2026,
  title  = {Introduction},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 30, 2026. Chat, Editor, Tile, and Viewer},
  url    = {https://docs.kaleidr.com/}
}

@misc{owasp_llm06_2025,
  title  = {LLM06:2025 Excessive Agency},
  author = {{OWASP Gen AI Security Project}},
  year   = {2025},
  note   = {Accessed September 30, 2026},
  url    = {https://genai.owasp.org/llmrisk/llm062025-excessive-agency/}
}

@misc{owasp_llm07_2025,
  title  = {LLM07:2025 System Prompt Leakage},
  author = {{OWASP Gen AI Security Project}},
  year   = {2025},
  note   = {Accessed September 30, 2026},
  url    = {https://genai.owasp.org/llmrisk/llm072025-system-prompt-leakage/}
}

@misc{kaleidr_map_aware_2026,
  title  = {How to Build a Map-Aware AI Assistant},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/how-to-build-a-map-aware-ai-assistant}
}

@misc{nist_ai_rmf_2023,
  title  = {AI Risk Management Framework},
  author = {{National Institute of Standards and Technology}},
  year   = {2023},
  note   = {Released January 26, 2023. Accessed September 30, 2026. Page states AI RMF 1.0 is being revised},
  url    = {https://www.nist.gov/itl/ai-risk-management-framework}
}

@misc{nist_ai_rmf_core_2023,
  title  = {AI RMF Core},
  author = {{National Institute of Standards and Technology}},
  year   = {2023},
  note   = {Measure 2.1. Accessed September 30, 2026},
  url    = {https://airc.nist.gov/airmf-resources/airmf/5-sec-core/}
}

@misc{kaleidr_analytics_architecture_2026,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 30, 2026},
  url    = {https://kaleidr.com/analytics}
}

@misc{kaleidr_enterprise_architecture_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 30, 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_chat_docs_2026,
  title  = {Chat},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 30, 2026},
  url    = {https://docs.kaleidr.com/chat}
}

@techreport{nist_ai_200_2_2026,
  title       = {The TEVV-Athlon Framework for Evaluating AI Systems},
  author      = {{National Institute of Standards and Technology}},
  institution = {National Institute of Standards and Technology},
  number      = {NIST AI 200-2},
  year        = {2026},
  note        = {Initial public draft, announced August 7, 2026},
  url         = {https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems}
}