
Enterprise-Spatial-AI-Architektur trennt Sprachmodelle, Karten, Geschäftsdaten, räumliche Berechnungen, Berechtigungen, Tools und Aktionen, damit jede Aufgabe in der Ebene bleibt, die sie durchsetzen kann. Eine flüssig formulierte Antwort kann jemanden trotzdem zur falschen Filiale schicken. Der Host behält Identität und Transaktionen. Räumliche Dienste berechnen die Geografie. Das Sprachmodell interpretiert die Anfrage und erklärt ein Ergebnis, das diese Systeme bereits verankert haben.
Die folgenden Abschnitte behandeln Zuständigkeit, Autorisierung, Zugangsdaten, Tools, den Anfragepfad und drei Bereitstellungsmuster. Weiterführende Beiträge sind Spatial AI Accuracy Evaluation und An Enterprise Spatial AI Pilot. Eine korrekte Ablehnung kann ein besseres Ergebnis sein als eine plausible Empfehlung, die von keinem maßgeblichen System gestützt wird.
Grundlagen der Enterprise-Spatial-AI-Architektur
- Aufgaben trennen: Das Sprachmodell interpretiert und erklärt. Es besitzt weder Bestand noch Berechtigungen, Routen oder Transaktionen.
- Vor dem Abruf autorisieren: Benutzer, Mandant, Objekte und Felder auflösen, bevor privater Kontext das Modell erreicht.
- Fakten typisiert halten: Stabile IDs und operative Felder bleiben strukturiert. Fließtext ersetzt sie nicht.
- Jedes Tool begrenzen: Lese-, Karten-, Entwurfs- und Schreibaktionen haben unterschiedliche Freigaberegeln.
- Den Workflow messen: Die Standortentscheidung und das Ergebnis im Host beobachten, nicht nur Tokens und Latenz.
Was ist Enterprise-Spatial-AI-Architektur?
Ein Kunde kann fragen, welches Servicecenter einen Auftrag heute bearbeiten kann, innerhalb des Vertragsgebiets liegt und gegenüber der aktuellen Route die geringste zusätzliche Fahrzeit verursacht. Dafür braucht es eine Intent-Ebene, Kunden- und Vertragsdaten, Standortdaten, Regeln für Servicegebiete, eine Routenberechnung und einen Karten-Workflow. Ein Produktionssystem braucht außerdem Identität, Mandantentrennung, Tool-Grenzen, Aktionsprüfungen, Protokolle und eine Stelle, an der ein Mensch einen folgenreichen Schritt freigeben kann. All diese Aufgaben in einen einzigen Prompt zu packen, macht das Produkt schwer abzusichern und schwer zu verändern. Das Modell kann benennen, was als Nächstes geschehen sollte. Die Durchsetzung bleibt außerhalb des Modells.
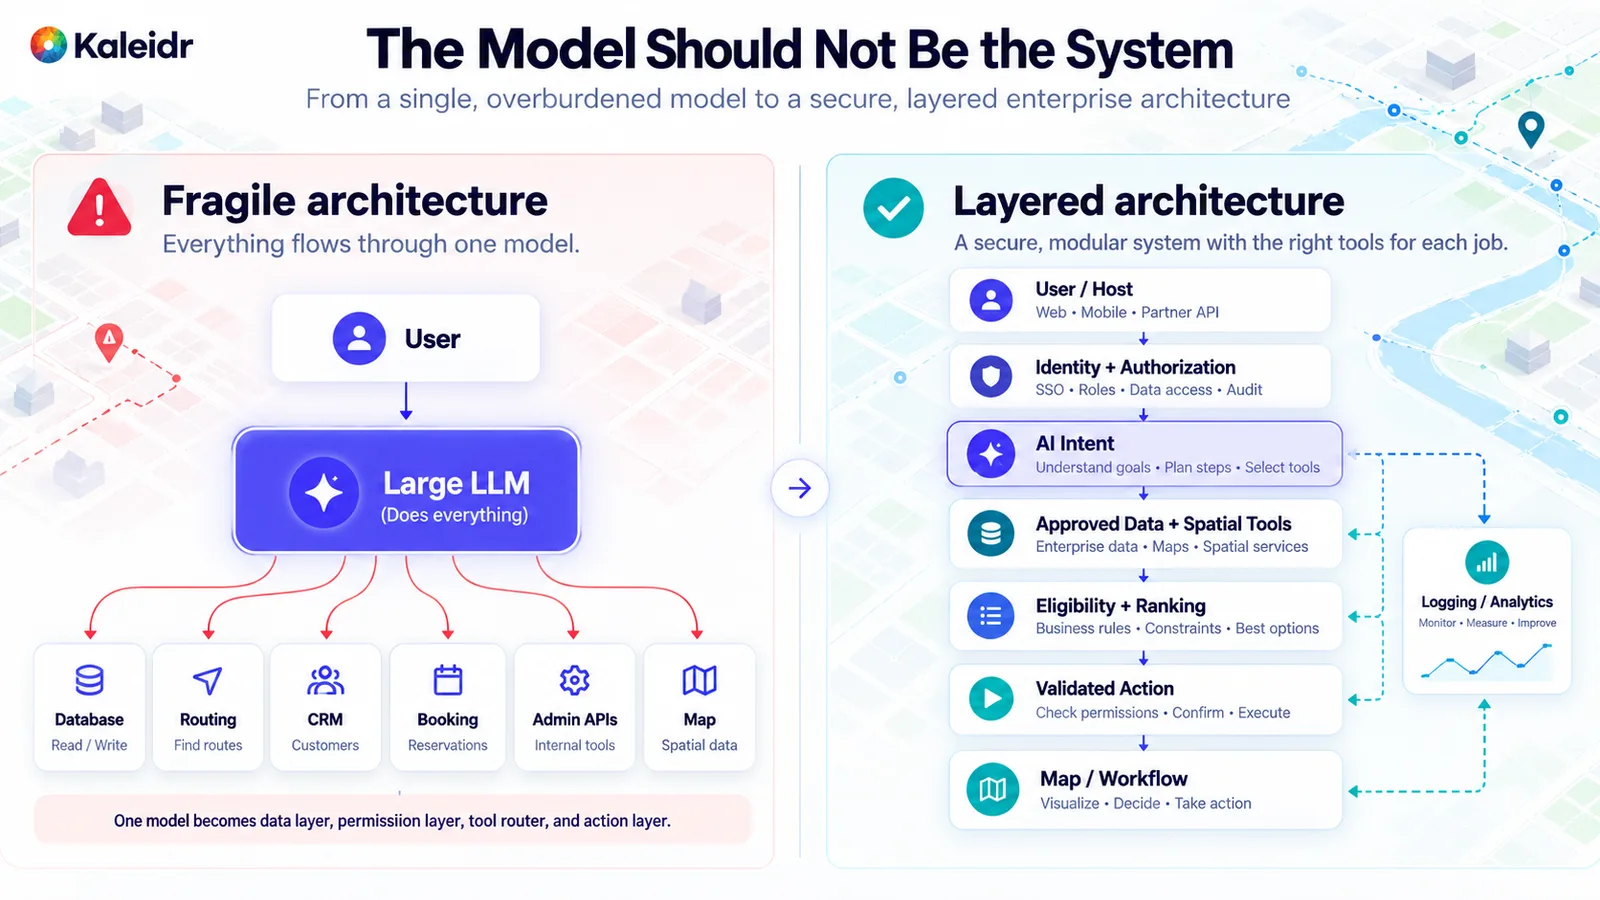
Die linke Seite verbindet ein Modell direkt mit Datenbanken, Routing und Transaktionen. Die rechte Seite hält Identität, Daten, räumliche Tools, Ranking und validierte Aktionen in getrennten Ebenen. Der Kontrast zeigt ein Architekturmuster, keinen Kaleidr-Benchmark.
Ein praktikabler Pfad ähnelt weniger einem Benutzer, der mit einem Modell spricht, das alles erreichen kann, sondern eher einer Abfolge, die der Host prüfen kann. Die Anwendung hält den Benutzer und den aktuellen Kartenstatus. Identität und Autorisierung werden vor dem Abruf geklärt. Die Intent-Interpretation fordert anschließend nur genehmigte Daten und räumliche Berechnungen an. Die Eignungsprüfung entfernt ungültige Optionen vor dem Ranking. Eine validierte Aktion aktualisiert die Karte oder den Workflow, und Analytics zeichnet auf, ob die Aufgabe erfolgreich war. So kann ein Team Modelle, Kartenanbieter oder Rankingregeln ändern, ohne das Produkt um eine einzige undurchsichtige Abhängigkeit herum neu aufzubauen.
Welches System sollte welche Tatsache besitzen?
In einem Architektur-Workshop sollte für jede kritische Tatsache ein Eigentümer benannt werden, bevor jemand ein Modell auswählt. Der Identitätsanbieter des Hosts besitzt den Benutzer. Die Host-Anwendung besitzt Mandantenmitgliedschaft, Produktberechtigung, Workflow und Geschäftsergebnis. Geschäftssysteme besitzen Standortidentität, Bestand, Verfügbarkeit, Preis, Buchungsstatus und Richtlinien. Eine genehmigte Standortquelle besitzt die Koordinaten. Die räumliche Berechnung besitzt Entfernung, Fahrzeit und Punkt-in-Polygon. Die Client-Anwendung besitzt den Kartenausschnitt und den ausgewählten Ort. Die KI-Ebene besitzt Intent-Interpretation und eine Erklärung auf Grundlage verankerter Evidenz. Der Host-Workflow besitzt die abschließende Transaktion.
| Tatsache oder Entscheidung | Maßgeblicher Eigentümer |
|---|---|
| Benutzeridentität und Mandant | Identitätssystem des Hosts |
| Bestand, Preis, Buchung, Richtlinie | Geschäftliches System of Record |
| Entfernung, Fahrzeit, Einschluss | Räumliche Berechnung |
| Kartenausschnitt und ausgewählter Ort | Client-Anwendung |
| Intent und Erklärung | KI-Ebene auf verankerter Evidenz |
| Abschließende Transaktion | Host-Workflow |
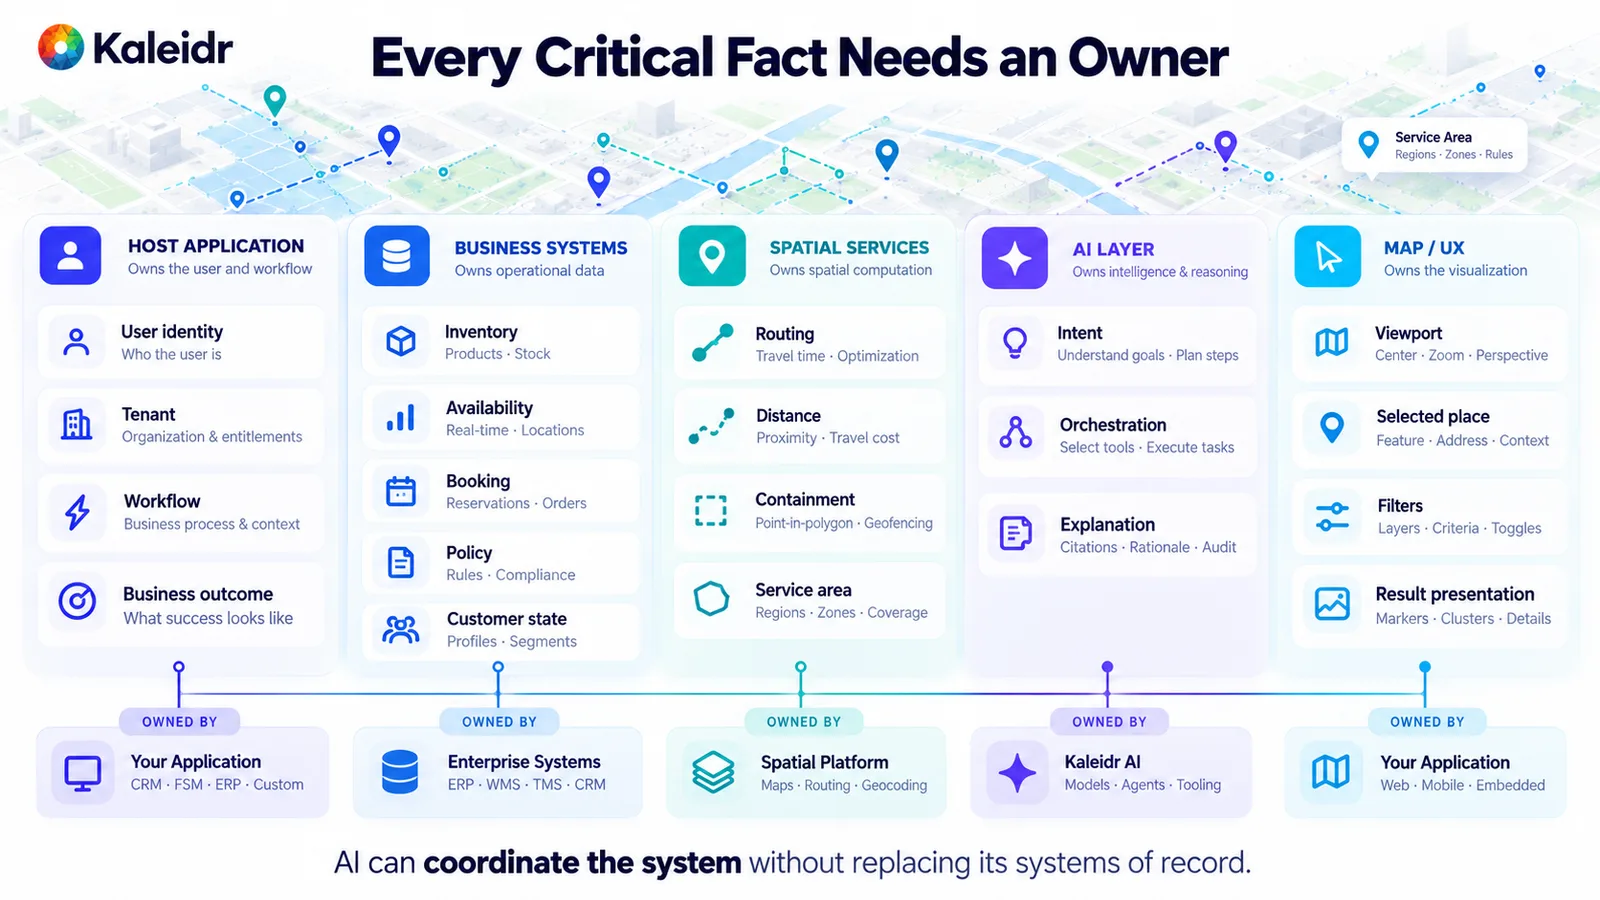
Jede Spalte hat einen primären Eigentümer. Die KI-Ebene koordiniert Intent und Erklärung. Host- und Geschäftssysteme bleiben die Systems of Record; das Board ist ein Rahmenwerk und kein Produktinventar.
Wenn ein Team den Eigentümer einer kritischen Tatsache nicht benennen kann, verdeckt ein Assistent die Lücke meist nur. Kaleidrs Leitfaden zu grounded Spatial AI nutzt dieselbe Trennung: Das Modell interpretiert zusammengesetzte Absichten, während Bestand, Richtlinien, Berechtigungen und Routing in den Systemen bleiben, die für diese Fakten gebaut wurden (Kaleidr, 2026). Retrieval findet Kontext. Autorität entscheidet, welche Quelle eine Tatsachenfrage beantworten darf. Ein abgerufenes Dokument ist nicht automatisch das System of Record.
Warum vor dem Abruf autorisieren?
Ein häufiger Fehler besteht darin, private Daten abzurufen, sie an das Modell zu senden und anschließend das Modell entscheiden zu lassen, welche Zeilen die Person sehen darf. Kehren Sie die Reihenfolge um. Benutzer authentifizieren, Mandanten auflösen, Rollen und Berechtigungen auflösen, Objekte autorisieren, Felder minimieren, genehmigte Datensätze abrufen und erst dann den nötigen Kontext weitergeben. Die Berechtigungsgrenze sollte deterministisch und auditierbar sein. Ein Sprachmodell sollte nicht entscheiden, ob ein Regionalleiter einen Standort sehen darf, ob ein Kunde die Standort-Historie eines anderen Kunden lesen darf oder ob ein Mitarbeiter eingeschränkte Arbeitsplatzdaten abrufen darf.
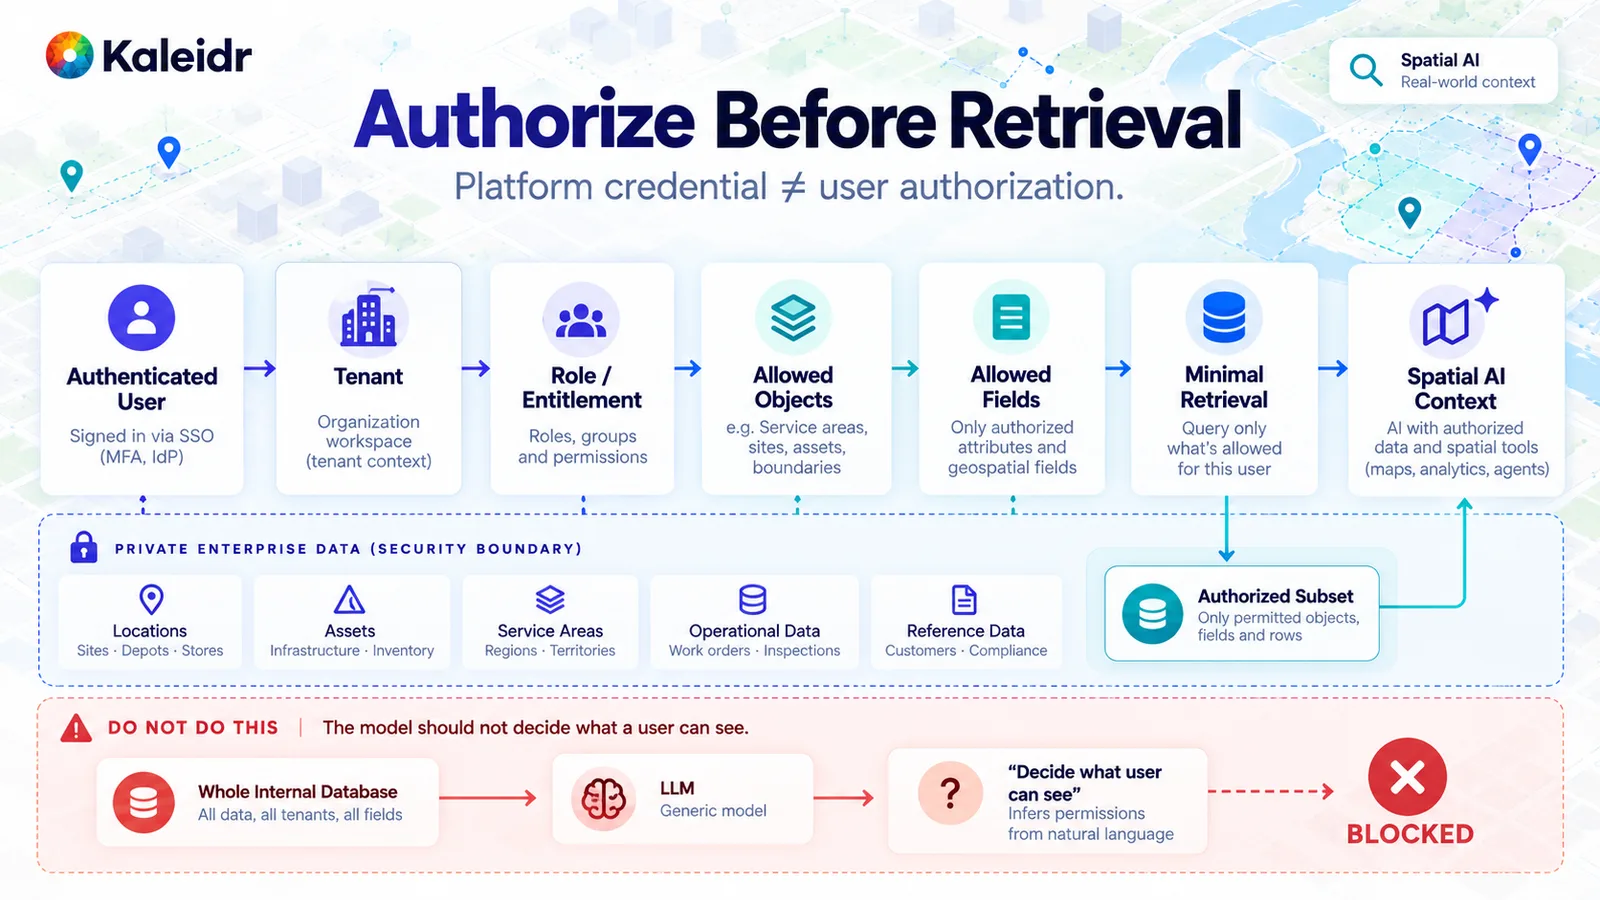
Private Datensätze überschreiten die Grenze erst nach Prüfungen von Mandant, Rolle, Objekt und Feld. Der untere Pfad, bei dem ein Modell Berechtigungen aus einer vollständigen Datenbank ableiten soll, bleibt blockiert. Plattform-Zugangsdaten und Endbenutzer-Autorisierung bleiben unterschiedliche Prüfungen.
Ein Plattform-Zugangsnachweis kann zeigen, dass eine Anwendung eine Funktion verwenden darf. Er entscheidet nicht, welcher Endbenutzer welche Zeilen lesen darf. CORS, Authentifizierung der Zugangsdaten, API-Funktionsbereiche und Autorisierung auf Anwendungsebene lösen unterschiedliche Probleme; ihre Vermischung erzeugt den falschen Fehlermodus (Kaleidr, 2026). Der Pfad für private Daten ist deshalb ein Stapel von Prüfungen, nicht ein einzelnes Token, das alles bedeutet.
Wie sollten Browser- und Server-Zugangsdaten getrennt bleiben?
Ein Browser ist inspizierbar; alles, was an ihn ausgeliefert wird, sollte daher als für die ausführende Person sichtbar behandelt werden. Ein Backend ist der richtige Ort für langlebige Geheimnisse, Zugriff auf private Geschäftsdaten, Richtliniendurchsetzung und Server-zu-Server-Aufrufe. Der Browser kann einen veröffentlichbaren, client-sicheren Zugangsnachweis für eine eingegrenzte Kartenfunktion enthalten. Authentifizierte Produktanfragen gehen an das Host-Backend, das den Benutzerkontext anwendet, auf private Daten zugreift und räumliche oder KI-Operationen mit Server-Zugangsdaten aufruft. Die beiden Laufzeitumgebungen sollten nicht dasselbe Geheimnis teilen.
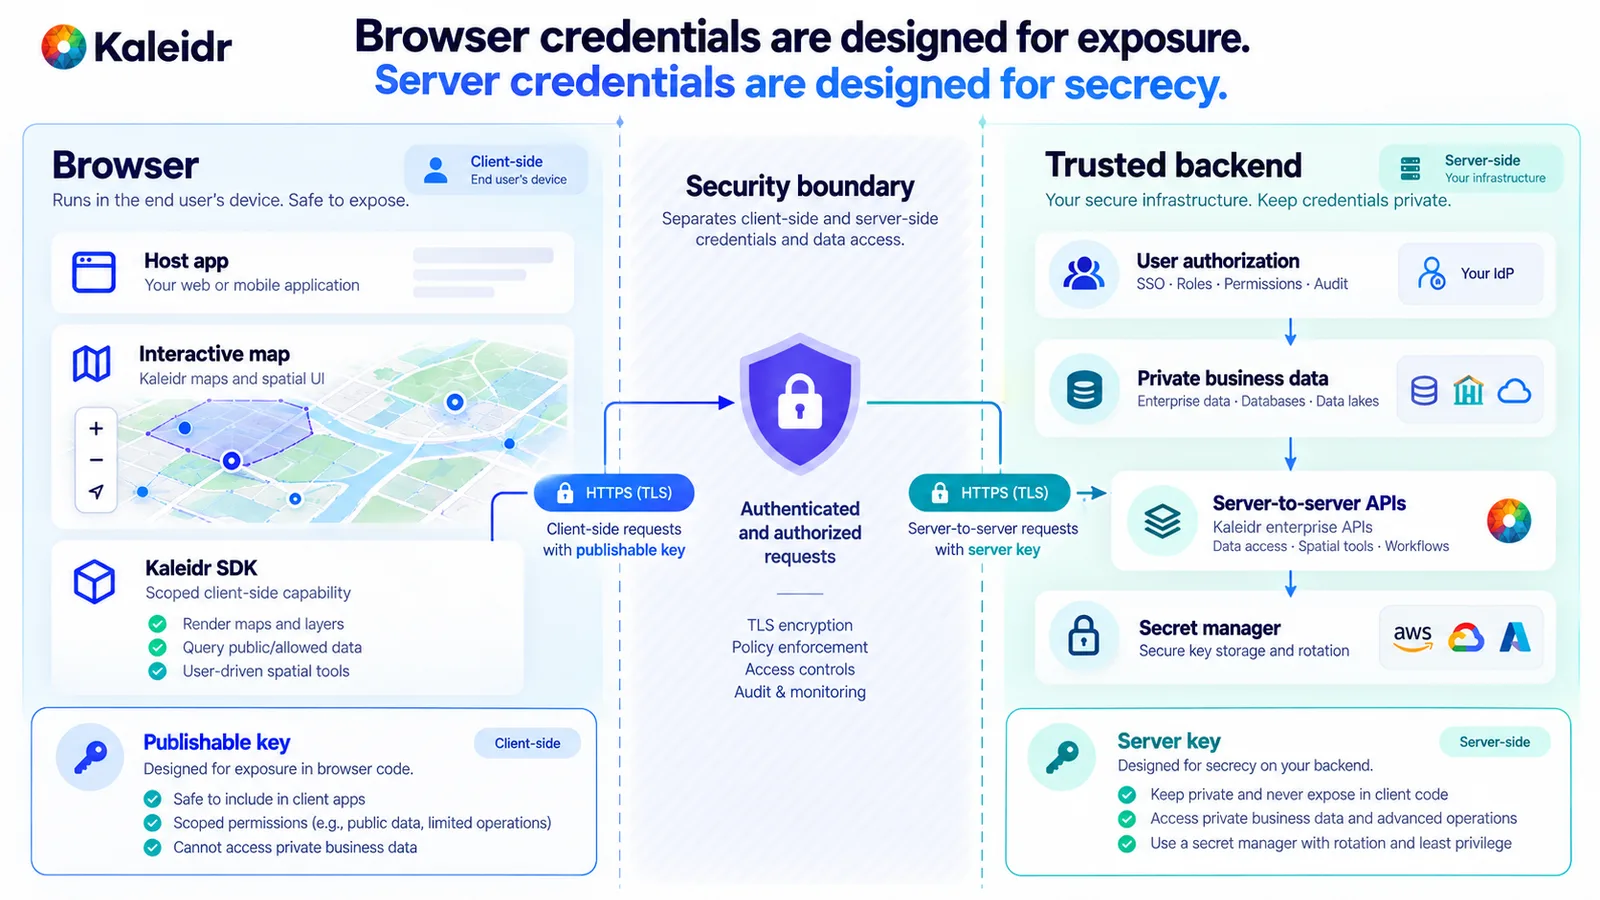
Die Browser-Seite ist für Sichtbarkeit ausgelegt und bleibt auf eingegrenzte Client-Funktionen beschränkt. Die Server-Seite hält Server-Zugangsdaten, private Datensätze und Benutzerautorisierung. Die Häkchen skizzieren eine Grenze und sind keine Sicherheitszertifizierung.
Kaleidrs aktuelle Key-Dokumentation definiert einen veröffentlichbaren Key für den Browser und einen Server-Key für Backend-Integrationen. Der veröffentlichbare Key ist an den Origin gebunden, und das SDK tauscht ihn zur Laufzeit gegen eine kurzlebige Sitzung aus, statt diese Zeichenfolge als dauerhaften Server-Bearer zu verwenden. Der Server-Key bleibt auf vertrauenswürdigen Servern (Kaleidr, 2026). Dieselbe Dokumentation beschreibt Chat, Editor, Tile und Viewer als getrennte Oberflächen mit unterschiedlichen Attach-, Embed- und Tile-Einstiegspunkten, die nicht alle auf dieselbe Weise eingebunden werden (Kaleidr, 2026). Folgen Sie dem aktuellen Vertrag jeder Oberfläche, statt anzunehmen, dass ein Zugangsnachweis und eine Einbindung den gesamten Stack abdecken.
Wo sollten Geschäftsfakten und Geografie liegen?
Enterprise Spatial AI ist nützlich, wenn es über Fakten schlussfolgern kann, die ein öffentliches Modell nicht kennt: aktuellen Bestand, Partnerberechtigung, Standortfähigkeiten, Vertragsabdeckung, vorübergehende Schließungen und Live-Verfügbarkeit. Diese Fakten gehören in Systems of Record. Bitten Sie ein Modell nicht, sich einen Wert zu merken, der sich noch heute Nachmittag ändern kann. Fine-tunen Sie ein Modell nicht auf ein operatives Feld, das eine Abfrage liefern kann. Fügen Sie keine breite interne Datenbank in einen System-Prompt ein. Interpretieren Sie die Anfrage, bestimmen Sie die benötigten autorisierten Datensätze, rufen Sie nur das Minimum ab, behalten Sie stabile IDs und typisierte Felder, wenden Sie harte Filter an, berechnen Sie die Geografie und erklären Sie erst dann das verankerte Ergebnis.
{
  "branch_id": "b_1042",
  "open_now": true,
  "inventory_status": "in_stock",
  "service_eligible": true,
  "lat": 38.91,
  "lng": -77.22
}
Ein typisierter Datensatz kann gefiltert, protokolliert, auf Berechtigungen geprüft und an eine spätere Aktion übergeben werden. Ein Satz, eine Filiale „scheint geöffnet“ zu sein und habe den Artikel „wahrscheinlich“, kann das nicht. Natürliche Sprache gehört weiterhin in die Erklärung. Sie sollte keine Felder ersetzen, die die Anwendung direkt speichern kann.
Räumliche Berechnungen verdienen aus demselben Grund eine eigene Ebene. Punkt-in-Polygon, Routendistanz, Fahrzeit, Gehzeit, Zugehörigkeit zu einem Servicegebiet, Routenabweichung und Erreichbarkeit innerhalb einer Zeitgrenze sollten von einem Geodienst kommen, wenn das Produkt sie berechnen kann. Die KI-Ebene kann feststellen, dass eine Berechnung nötig ist. Der räumliche Dienst führt sie aus. Die Erklärung erläutert anschließend, warum diese Beziehung für die Anfrage relevant ist. Ein Wechsel des Sprachmodells zwingt das Team nicht dazu, neu zu lernen, wie die Anwendung Fahrzeit oder Einschluss misst.
Harte Einschränkungen und weiche Präferenzen sollten getrennt bleiben. Eine Klinikanfrage könnte einen akzeptierten Tarif, Öffnungszeiten nach 18 Uhr, einen aktiven Standort und einen Datensatz verlangen, auf den der Benutzer zugreifen darf. Nur Kandidaten, die diese Regeln erfüllen, sollten nach Fahrzeit, Routenabweichung oder einer angegebenen Präferenz gerankt werden. Die Reihenfolge lautet Retrieval, Autorisierung, Eignungsprüfung, räumliche Berechnung, Ranking und Erklärung. Zuerst zu ranken und darauf zu hoffen, dass das Modell jede Einschränkung erinnert, versteckt eine ungültige Option in einer flüssig formulierten Shortlist. Einzelhandel, Immobilien, Buchung, Arbeitsplätze und Netzwerke mit vielen Standorten können dieselbe Reihenfolge verwenden, weil es bei der Einschränkung um Gültigkeit und nicht um Branchenvokabular geht.
Wie sollten Tools und Aktionen begrenzt werden?
Agentische Spatial AI macht den Tool-Katalog zu einer der wichtigen Grenzen. Offene Tools wie ein beliebiger SQL-String, ein Shell-Befehl oder eine frei formulierte interne URL sind eine Ausführungsumgebung und keine Geschäftsfunktion. Bevorzugen Sie eng gefasste Tools mit bekannten Ein- und Ausgaben: geeignete Standorte suchen, Fahrzeit berechnen, Filialverfügbarkeit lesen, Orte anzeigen, eine Route anfordern oder einen Buchungsentwurf erstellen. Jedes Tool kann eine eigene Berechtigungsprüfung, Validierung, Rate-Limitierung, Protokollzeile und einen eigenen Fehlermodus tragen.
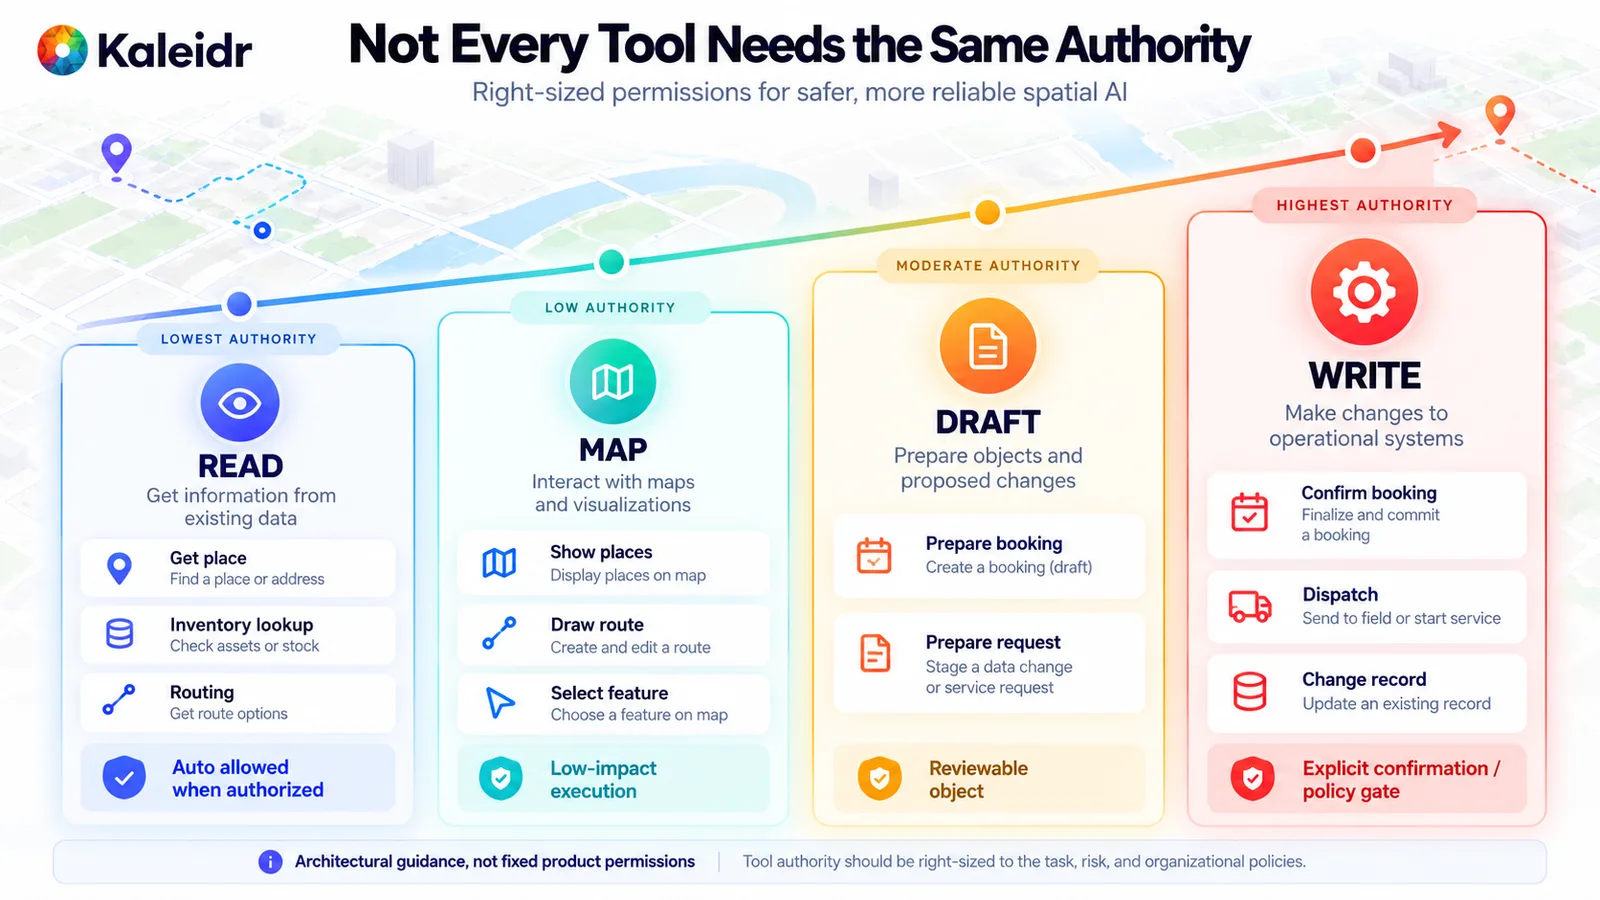
Lese- und Karten-Tools können laufen, wenn der Aufrufer bereits autorisiert ist. Entwürfe erzeugen ein überprüfbares Objekt. Schreibvorgänge, die eine Buchung bestätigen, Arbeit disponieren oder einen Datensatz ändern, warten auf ein ausdrückliches Richtlinien-Gate. Die Stufen sind Architekturleitlinien und keine feste Kaleidr-Berechtigungsliste.
Das Lesen eines Datensatzes und das Ändern von Geschäftszustand gehören zu unterschiedlichen Risikoklassen. Ein Produktionskatalog kann Funktionen in Lesen, Karte, Entwurf und Schreiben gruppieren. Lese- und risikoarme Kartenaktionen können automatisch ausgeführt werden, sobald die Autorisierung bestanden ist. Ein Entwurf kann eine Buchung oder Serviceanfrage zur Prüfung vorbereiten. Ein Schreibvorgang, der eine Reservierung bestätigt, ein Fahrzeug disponiert oder eine Änderung veröffentlicht, kann eine Bestätigung, eine zweite Richtlinienprüfung und manchmal einen Menschen erfordern. Ein Konfidenzwert ist kein Berechtigungssystem.
OWASPs Leitfaden von 2025 zu Excessive Agency behandelt übermäßige Funktionalität, übermäßige Berechtigungen und übermäßige Autonomie als getrennte Ursachen. Er empfiehlt, die Erweiterungen, die ein Agent aufrufen darf, auf das notwendige Minimum zu begrenzen, granulare Funktionen gegenüber offenen zu bevorzugen, für folgenschwere Aktionen eine Freigabe zu verlangen und die Autorisierung in nachgelagerten Systemen durchzusetzen, statt sich darauf zu verlassen, dass das Modell den Aufruf zulässt (OWASP, 2025). Die Anwendung sollte dennoch jeden vorgeschlagenen Aufruf validieren. Bei einer Kartenaktion ist zu prüfen, ob die Aktion erlaubt ist, ob die Orts-IDs zur autorisierten Ergebnismenge gehören, ob der Benutzer darauf zugreifen darf und ob die Argumente korrekt geformt sind. Für einen Schreibvorgang gilt eine strengere Prüfung. Ein Prompt, ein abgerufenes Dokument oder ein fehlerhaftes Tool-Ergebnis darf nicht zu einer Umgehung der Autorisierung werden.
OWASPs Leitfaden zu System-Prompts zieht dieselbe Grenze von der anderen Seite. Der System-Prompt ist kein Geheimnis und keine Sicherheitskontrolle. Privilegientrennung und Autorisierungsprüfungen dürfen weder über den Prompt noch auf andere Weise an das Modell delegiert werden (OWASP, 2025). Kartenaktionen sollten ein semantisches Vokabular verwenden, etwa Orte anzeigen, Orte einpassen, einen Ort auswählen, eine Route zeichnen oder eine Route löschen; ein deterministischer Adapter übersetzt diese Aktionen für Mapbox, MapLibre, Google Maps oder einen anderen Renderer. Das Modell sollte nicht in jedem Turn Renderer-Code ausgeben.
Wie sollte der Kartenstatus in die Anfrage einfließen?
Der Kartenstatus verändert, was eine Person mit „diesen“, „nördlich von hier“ oder „der zweiten Option“ meint. Ein nützlicher Snapshot kann die Grenzen des Viewports, die ID des ausgewählten Orts, sichtbare Ergebnis-IDs, aktive Filter, eine aktuelle Routen-ID und einen genehmigten Standort in der für die Aufgabe nötigen Genauigkeit enthalten. Kennzeichnen Sie, welche Felder immer verfügbar, optional, privat, vom Benutzer genehmigt, veraltet, maßgeblich oder abgeleitet sind. Senden Sie nicht bei jeder Anfrage den präzisen Gerätestandort, nur weil die Karte ihn lesen kann. Die stärkste Referenz für „welcher davon hat später geöffnet“ sind die stabilen IDs der aktuellen Ergebnismenge, nicht ein Screenshot. Kaleidrs Leitfaden für map-aware Assistants zieht diese Grenze: Viewport, Auswahl, Filter und Ergebnis-IDs teilen und das Modell nicht bitten, die Anwendung aus Pixeln abzuleiten (Kaleidr, 2026).
Eine Orchestrierungsebene kann entscheiden, ob die Anfrage Geschäftsdaten-Retrieval, Routing, eine Kartenaktion, eine Rückfrage oder eine Zusammenfassung der Evidenz braucht. Diese Ebene kann modellgetrieben, regelgetrieben oder gemischt sein. Sie sollte nicht die einzige Sicherheitsgrenze sein. Die Orchestrierung kann fragen, ob Verfügbarkeit abgerufen werden soll. Die Autorisierung entscheidet, ob dieser Aufrufer für diese Datensätze Verfügbarkeit abrufen darf. Die Orchestrierung kann fragen, ob eine Buchung gestartet werden soll. Die Transaktionsebene entscheidet, ob die Person bestätigt hat und ob die Operation gültig ist. Diese Trennung übersteht auch einen Modellfehler.
Mandantentrennung gehört auf denselben Pfad. Lösen Sie authentifizierte Identität, Mandant, Rolle und erlaubte Objekte vor der Abfrage auf und begrenzen Sie die Abfrage auf diesen Mandanten. Verlassen Sie sich nicht auf einen Prompt, der dem Modell angeblich verbietet, andere Mandanten zu erwähnen. Das Modell sollte niemals Daten eines anderen Mandanten erhalten, außer die Anwendung hat einen ausdrücklichen mandantenübergreifenden Zweck und eine entsprechende Richtlinie. Mandantengebundene Abfragen, Objektprüfungen, Feldminimierung und redigierte Protokolle sind die Kontrollen. Ein Satz im Prompt gehört nicht dazu.
Wie bewegt sich eine Produktionsanfrage durch den Stack?
Eine vollständige Anfrage lässt sich als zwölf Stufen darstellen, und nicht jede Anfrage benötigt alle davon. Erfassen Sie den authentifizierten Benutzer, den Mandanten, den Kartenstatus und den Workflow-Status. Interpretieren Sie die Aufgabe, die geografischen Einschränkungen, die geschäftlichen Einschränkungen und die beabsichtigte Aktion. Klären Sie zulässige Quellen, Datensätze, Felder, Tools und Aktionen vor jedem privaten Abruf.
Rufen Sie autorisierte Fakten und kanonische Orts-IDs ab und berechnen Sie anschließend Entfernung, Fahrzeit, Einschluss oder Zugehörigkeit zu einem Servicegebiet. Entfernen Sie nicht autorisierte, nicht verfügbare, geschlossene oder außerhalb des Gebiets liegende Kandidaten und ranken Sie den Rest. Erklären Sie das verankerte Ergebnis, schlagen Sie eine semantische Karten- oder Workflow-Aktion vor und validieren Sie diese Aktion außerhalb des Modells. Führen Sie die Aktion aus und protokollieren Sie anschließend die Entscheidung und das Ergebnis.
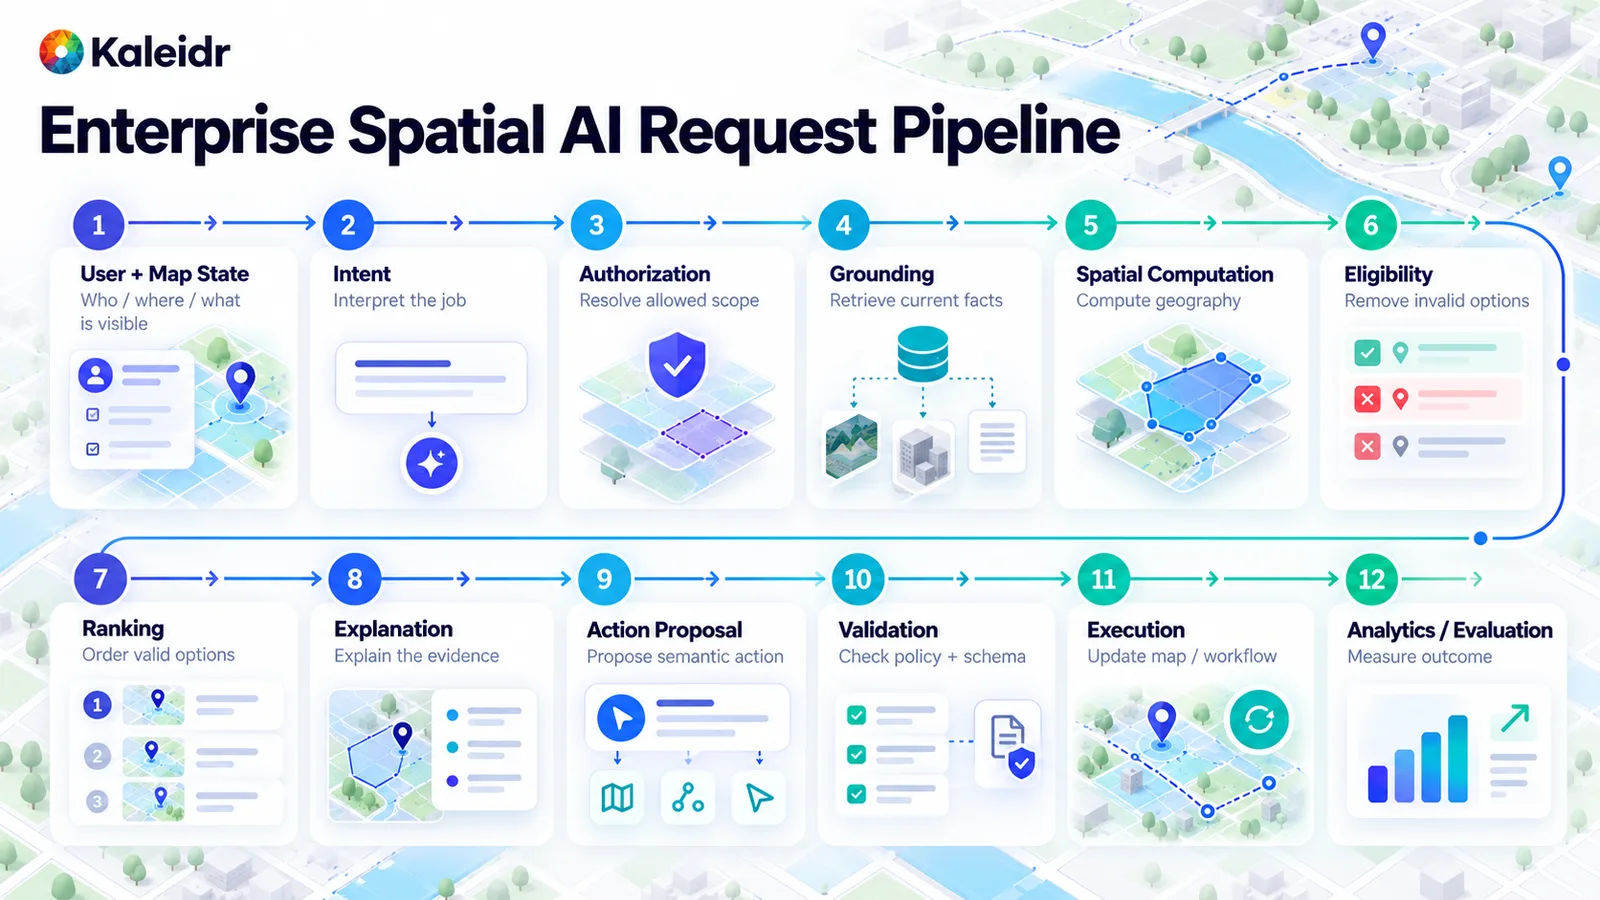
Die Stufen verlaufen von Kartenstatus und Intent über Autorisierung, Grounding, Geografie, Eignung und Ranking hin zu Erklärung, vorgeschlagener Aktion, Validierung, Ausführung und Messung. Eine einfache Anfrage wie „diesen Ort anzeigen“ kann Retrieval und Ranking überspringen. Eine Serviceempfehlung kann nahezu den gesamten Pfad verwenden.
Fehlerverhalten ist Teil desselben Pfads. Wenn Geschäftsdaten nicht verfügbar sind, erfinden Sie keine Verfügbarkeit. Sagen Sie, dass die Verfügbarkeit derzeit nicht verifiziert werden kann. Wenn Routing ausfällt, behaupten Sie kein Ranking nach Fahrzeit und kennzeichnen Sie jede Luftlinien-Alternative als Fallback. Wenn kein Kandidat die harten Regeln erfüllt, geben Sie kein Ergebnis zurück, statt stillschweigend eine kritische Einschränkung zu lockern. Wenn die Autorisierung fehlschlägt, bitten Sie das Modell nicht, private Informationen zu erklären, die es nie erhalten hat. Wenn das Modell nicht verfügbar ist, können deterministische Suche und Filter die Karte weiterhin bedienen. Wenn ein Tool-Ergebnis fehlerhaft ist, verwerfen Sie es bei der Validierung. Hat ein Produkt keinen ausdrücklichen Degradationsmodus, wird das Sprachmodell zum unbeabsichtigten Fallback für fehlende Infrastruktur.
Menschliche Freigabe richtet sich nach der Auswirkung, nicht nach einer einzigen Regel für jede Schaltfläche. Drei öffentliche Orte anzuzeigen hat geringe Auswirkungen. Einen Termin zu bestätigen, ein Fahrzeug zu disponieren, einen Standortdatensatz zu ändern oder eine kostenpflichtige Buchung abzusenden, nicht. Klassifizieren Sie Suche, Retrieval und Routenvorschau als geringe Auswirkung. Eine gespeicherte Präferenz oder einen Entwurf als mittlere Auswirkung. Einen Kauf, eine Disposition, einen operativen Schreibvorgang oder eine Berechtigungsänderung als hohe Auswirkung. Automatische Ausführung, Benutzerbestätigung und separate Freigabe können dann zur jeweiligen Klasse passen. Das AI Risk Management Framework des NIST ist freiwillig und soll Vertrauenswürdigkeit in Design, Entwicklung, Nutzung und Bewertung von KI-Produkten einbringen. Dieselbe NIST-Seite weist darauf hin, dass AI RMF 1.0 überarbeitet wird (NIST, 2023). Das Framework liefert Kontext für die eigenen Risikoentscheidungen des Produkts und ist keine Kaleidr-Kontrollliste.
Wo sitzt die Control Plane?
Der Anfragepfad bearbeitet die Live-Arbeit: Benutzer, Autorisierung, Retrieval, räumliche Tools, Modell, Aktion und Antwort. Die Control Plane entscheidet, wie dieser Pfad ausgeführt werden darf. Zugangsdaten, Scopes, Modellauswahl, Prompts, Tool-Richtlinien, Datenquellenkonfiguration, Rate Limits, Umgebungen, Evaluationssuiten, Feature Flags und Audit-Einstellungen liegen dort. Die Trennung beider Ebenen erlaubt es einem Team, Richtlinien zu ändern, ohne jeden Conversational Flow neu zu schreiben. Das Deaktivieren eines Schreib-Tools sollte keine neue Oberfläche erfordern. Die Control Plane ist ein Architekturmuster für diese Einstellungen; das Diagramm behauptet nicht, dass ein Produkt jedes Kästchen ausliefert.
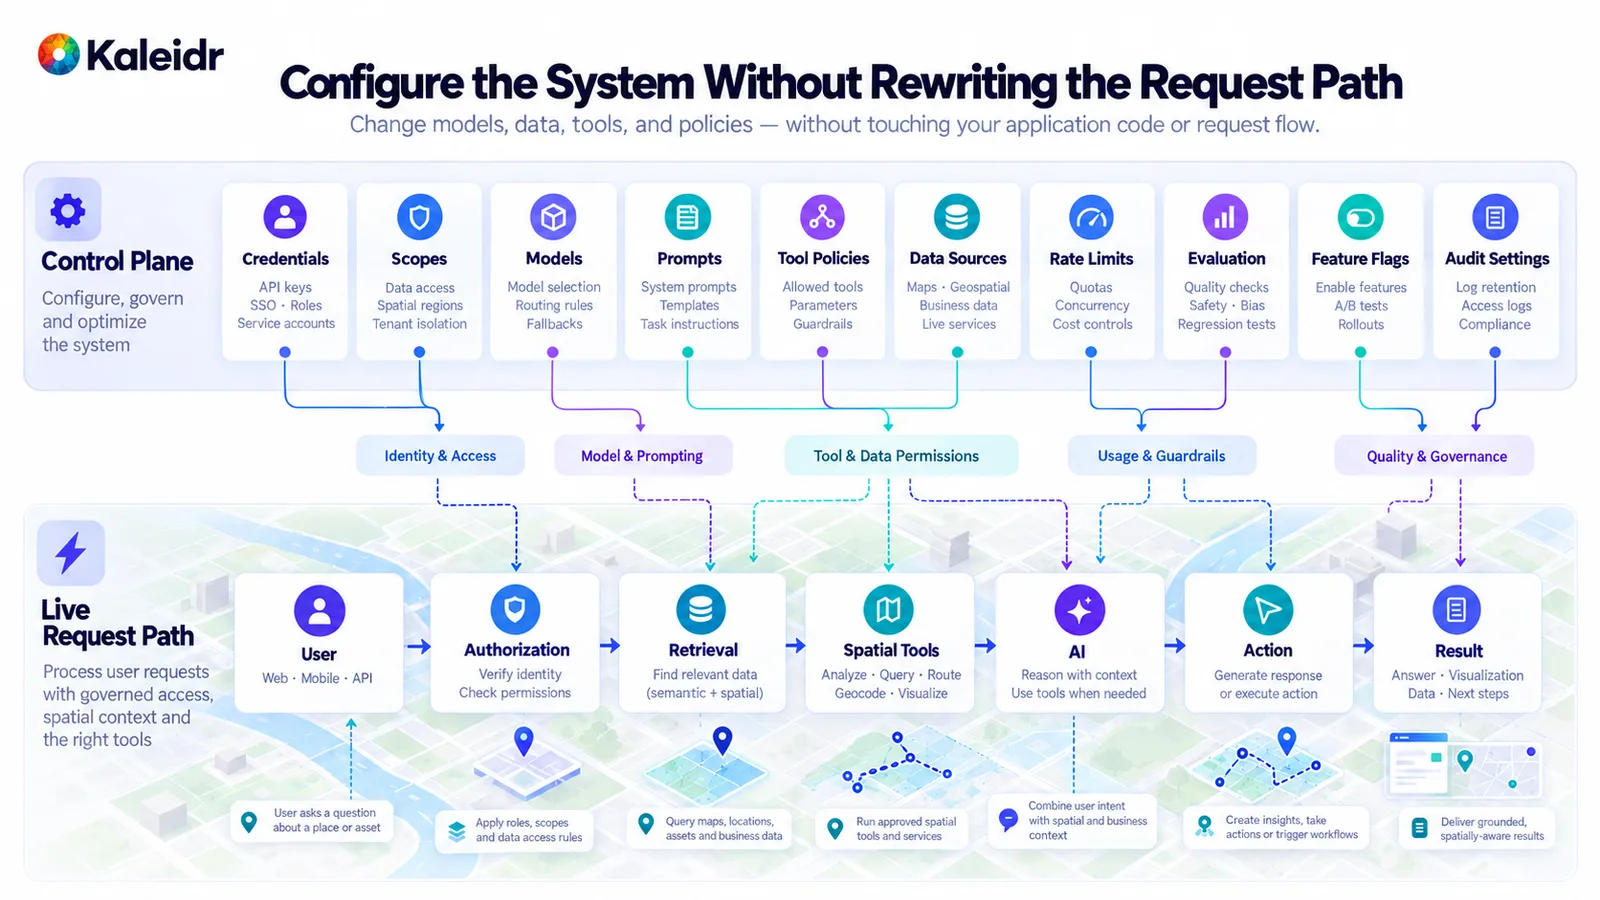
Die obere Zeile enthält Konfiguration: Zugangsdaten, Scopes, Modelle, Prompts, Tool-Richtlinien, Datenquellen, Limits, Evaluation, Flags und Audit-Einstellungen. Die untere Zeile ist die Live-Anfrage. Richtlinien zeigen auf die Stufen, die sie steuern, sodass ein Team eine Regel ändern kann, ohne den Pfad neu zu schreiben.
Observability sollte der Entscheidung folgen, nicht nur der Token-Rechnung. Nützliche Ereignisse sind unter anderem Intent aufgelöst, Autorisierung bestanden oder abgelehnt, Retrieval abgeschlossen, Kandidaten durch Eignungsprüfung entfernt, räumliche Berechnung abgeschlossen, Ranking abgeschlossen, No-Result-Antwort, Tool vorgeschlagen, Tool abgelehnt, Kartenaktion ausgeführt, Ort ausgewählt und Workflow abgeschlossen. Diese Namen sind ein zu entwerfendes Muster und keine Liste, die eine Plattform automatisch ausgibt. Die Fragen dahinter sind praktisch: Entstehen Fehler bei der Ortsauflösung oder beim Ranking? Lehnen Menschen eine gültige Shortlist ab? Erzeugt ein Markt mehr leere Ergebnisse? Scheitern Tool-Aufrufe an Berechtigungen oder an fehlerhaften Argumenten? Hat die Person die Host-Aufgabe nach der Auswahl eines Orts abgeschlossen? Der AI-RMF-Core des NIST sagt, dass Testmengen, Metriken und Details zu den bei Test, Evaluation, Verifikation und Validierung verwendeten Tools dokumentiert werden (NIST, 2023). Bei Spatial AI sollten die dokumentierten Tests die geografische und geschäftliche Entscheidung abdecken, nicht nur den generierten Satz.
Räumliche Analytics und Host-Ergebnisse beantworten unterschiedliche Fragen; die Architektur sollte sie mit stabilen IDs verbinden. Kaleidr Analytics beschreibt derzeit Dashboards für Reichweite, Aufrufe und Engagement, Standort und Aktivität des Publikums, Sitzungen, Aufrufe und Interaktionen pro Karte sowie räumliche Muster (Kaleidr, 2026). Buchungen, Käufe, qualifizierte Leads, Dispositionen und abgeschlossene Services bleiben in den Host-Systemen, die sie besitzen. Eine Empfehlungs-ID kann auf eine ausgewählte Orts-ID, dann auf eine Host-Workflow-ID und schließlich auf das Ergebnis verweisen. Öffentliches Analytics-Material sagt nicht, dass jede Geschäftskonversion automatisch erfasst wird.
Welche drei Bereitstellungsmuster gibt es?
Drei Muster decken die meisten Enterprise-Bereitstellungen ab, und keines ist universell das beste. Ein öffentlicher Kartenassistent passt zu Tourismus, Discovery, redaktionellen Karten und Event-Erkundung. Die Browser-Karte nutzt eine veröffentlichbare Client-Funktion, kartenbewusste KI, öffentliche oder genehmigte Ortsdaten und räumliche Tools und gibt anschließend eine Kartenaktion zurück. Die Datengrenze ist einfacher, weil der Workflow überwiegend öffentlich ist. Ein authentifizierter Business-Assistent passt zu Kundenportalen, bestandsbewusster Filialauswahl, Immobilien, Partnernetzwerken und privaten Einrichtungen. Der Browser erreicht einen Host-Login und ein Host-Backend, das Mandanten- und Objekt-Autorisierung anwendet, bevor private Daten, räumliche Tools und die Erklärung zur Karte zurückkehren. Ein räumlicher Agent mit Geschäftsaktionen passt zu Buchungs-, Dispositions- und operativen Workflows. Der Pfad ergänzt einen typisierten Tool-Vorschlag, deterministische Validierung, Bestätigung dort, wo die Auswirkung sie verlangt, das Transaktionssystem und ein Audit des Ergebnisses. Dieses dritte Muster verändert Geschäftszustand und unterliegt daher der strengsten Governance.
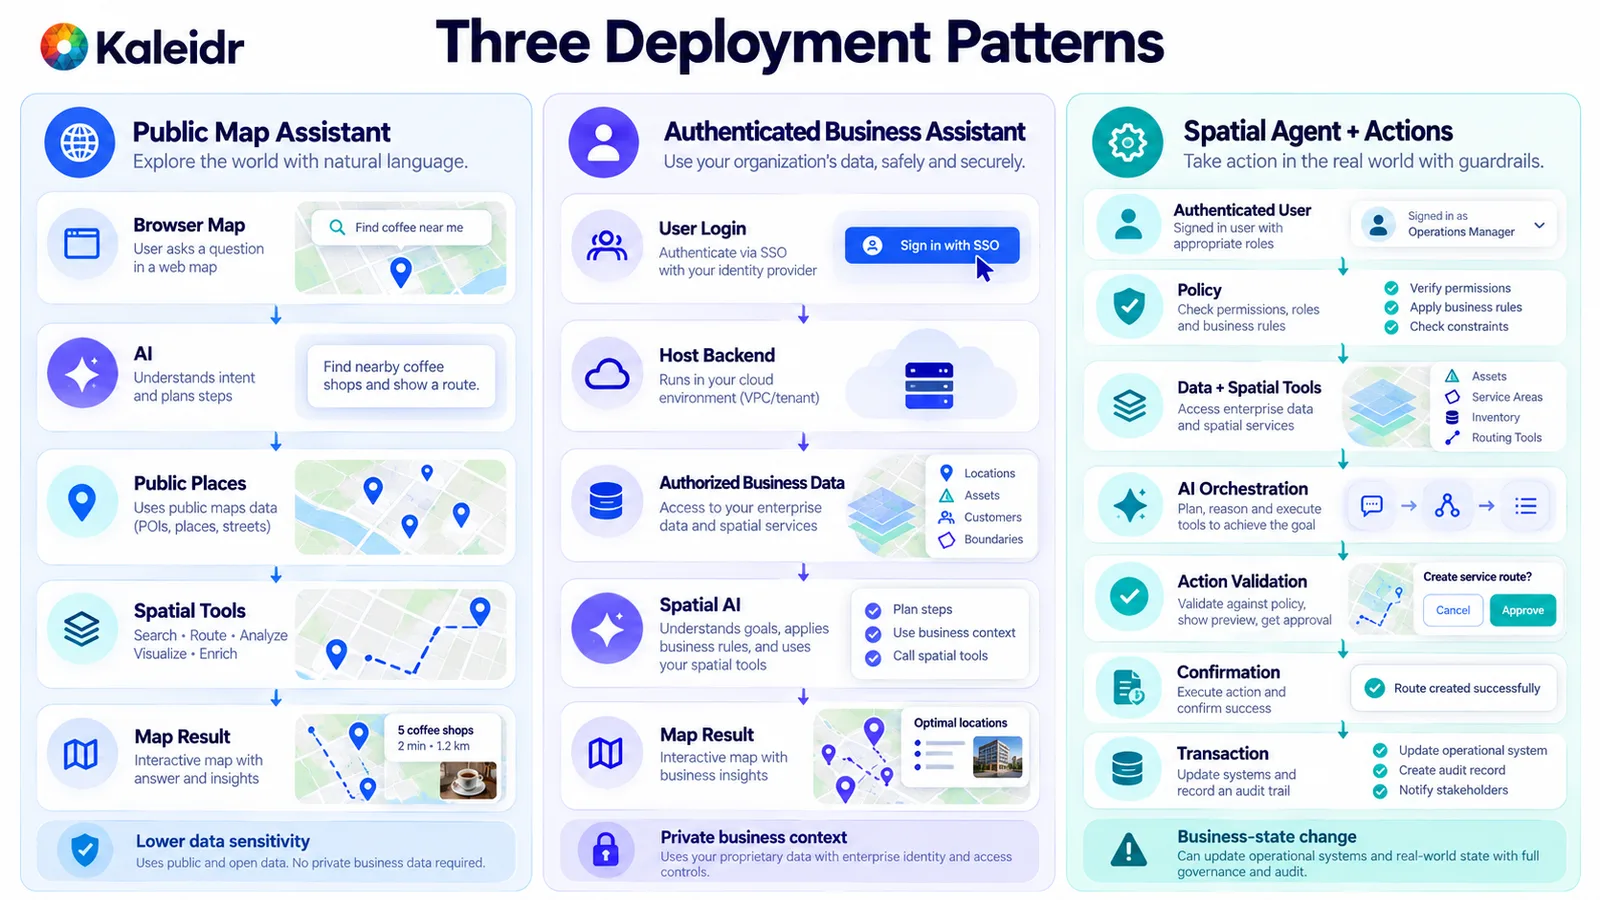
Das öffentliche Muster bleibt bei genehmigten öffentlichen Orten. Das authentifizierte Muster hält private Datensätze hinter dem Host. Das Aktionsmuster ergänzt Validierung und Bestätigung vor einer Transaktion. Beispiel-Ortskarten in der Abbildung sind illustrativ und keine gemessenen Kaleidr-Ergebnisse.
Wo passt Kaleidr in diese Architektur?
Kaleidr beschreibt Enterprise derzeit als Location-Intelligence-Infrastruktur für Produktteams, mit Inference APIs, Ranking, Analytics und SDK-Oberflächen, die ein Host ergänzen kann (Kaleidr, 2026). Die Entwicklerdokumentation nennt vier Oberflächen in einem SDK. Chat fügt KI-Interaktion zu einer Karte hinzu, die der Host bereits betreibt. Editor bindet Kartenbearbeitung in ein Produkt ein. Tile liefert eine gestaltete Basiskarte. Viewer veröffentlicht eine Karte zum Einbetten. Die aktuelle Chat-Dokumentation nennt Mapbox, MapLibre und Google Maps als Integrationspfade für diese Host-eigene Karte (Kaleidr, 2026). Der Host behält Endbenutzer, Authentifizierung, Mandantenautorisierung, private Geschäftssysteme, Workflow-Regeln, Transaktionen und Geschäftsergebnisse. Kaleidr ergänzt ausgewählte räumliche Oberflächen und ersetzt nicht die Systeme, die im Host-Stack maßgeblich bleiben.
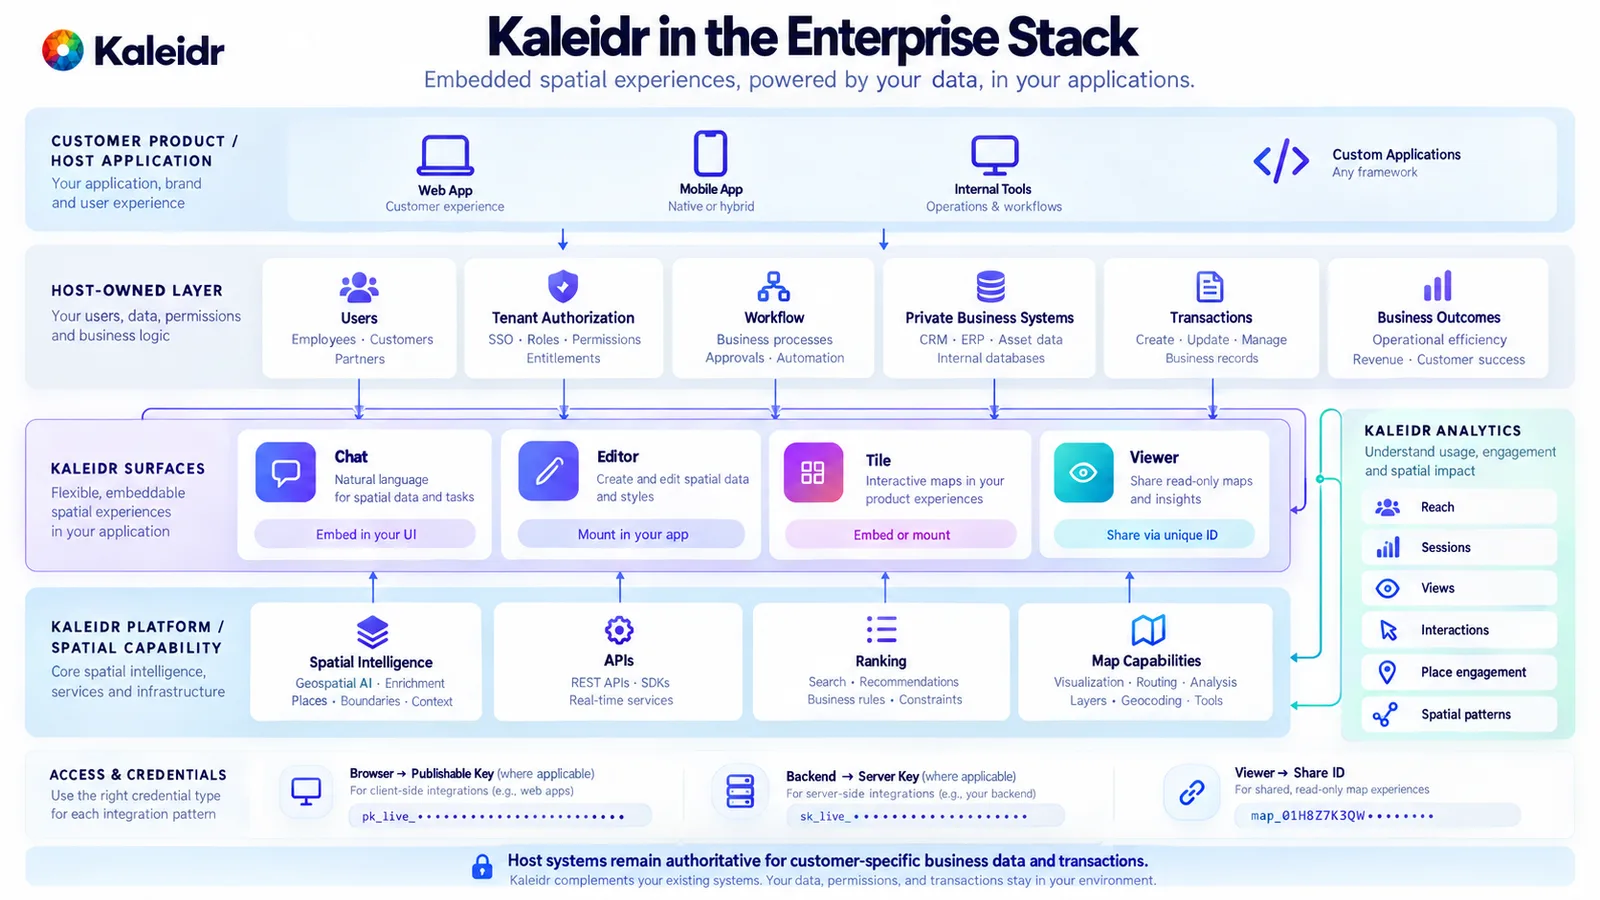
Die Host-Zeile behält Benutzer, Mandantenautorisierung, Workflows, private Systeme, Transaktionen und Ergebnisse. Chat, Editor, Tile und Viewer stehen neben Plattform-APIs und Analytics. Die Zugangsdaten-Beschriftungen folgen der öffentlichen Browser-/Server-Trennung, und die Abbildung zeigt kein echtes Geheimnis.
Welche Fehler zeigen sich erst in Produktion?
Das Modell direkt mit jedem System zu verbinden, erzeugt übermäßige Privilegien und erschwert es, die fehlerhafte Ebene zu finden. Einen Prompt als Autorisierungsebene zu behandeln, scheitert aus demselben Grund: Ein Prompt kann Formulierungen lenken, aber einen Datensatz nicht deterministisch erlauben oder verweigern. Die gesamte interne Datenbank in den Kontext zu senden, verletzt das Minimierungsprinzip. Harte Filter mit Ranking zu vermischen, lässt einen ungeeigneten Ort innerhalb eines Durchschnitts überleben. Das Modell eine Distanz schätzen zu lassen, die der räumliche Dienst berechnen kann, ersetzt eine Berechnung durch Sprachflüssigkeit. Ein einziges unbeschränktes Tool oder ein Schreib-Tool, das die Richtlinie eines Lese-Tools erbt, verleiht einer Empfehlung die Autorität einer Transaktion. Die Karte als Bild zu behandeln, verliert die stabilen IDs, die der nächste Turn braucht. Nur Latenz und Token-Kosten zu überwachen, übersieht Ortsauflösung, Eignung, Routing, Ranking, Tool-Fehler und das Host-Ergebnis. Ein Modell-Benchmark allein kann nicht zeigen, dass der zusammengesetzte Workflow bereit ist.
Der erste öffentliche Entwurf des NIST-Frameworks TEVV-Athlon, NIST AI 200-2, wurde am 7. August 2026 angekündigt; Kommentare sind bis 6. Oktober 2026 möglich. Er beschreibt Evaluation als Evidenz dafür, dass ein System individuelle oder organisatorische Ziele erfüllt, wobei die Messung an Anwendung und reale Auswirkungen angepasst wird, einschließlich agentischer Systeme (NIST, 2026). Das Dokument ist ein Entwurf zur Kommentierung. Der Entwurf ist keine Kaleidr-Kontrollliste. Für diese Architektur ist der Evaluationskontext die standortabhängige Entscheidung: Intent, Autorisierung, Grounding, Geografie, Eignung, Ranking, Tools, Aktionen, Fehlerbehandlung und Host-Ergebnis.
Wie wird Enterprise-Spatial-AI-Architektur zu einem Release-Gate?
Bevor ein Pilot in Richtung Produktion geht, bestätigen Sie die Eigentümer. Der Benutzer ist dort authentifiziert, wo es der Workflow verlangt, und die Mandantenmitgliedschaft wird außerhalb des Modells aufgelöst. Jedes kritische Feld hat eine maßgebliche Quelle, privates Retrieval erfolgt vor der Inferenz, Felder werden minimiert, und stabile IDs überleben die Übergabe. Geografische Dienste führen die vom Produkt behaupteten Berechnungen aus, und die in der Evaluation verwendeten Toleranzen sind dokumentiert. Tools sind eng gefasst, Lesen und Schreiben sind getrennt, Argumente werden validiert, und folgenschwere Aktionen können bestätigt und auditiert werden. Browser- und Server-Zugangsdaten bleiben getrennt, Scopes begrenzt und Umgebungen separat. Das Team kann die Entscheidungskette sehen und eine Ortsauswahl mit einem Host-Ergebnis verbinden. Nicht verfügbare Daten, leere Kandidatenmengen und Degradationsmodi sind explizit; kritische Operationen scheitern geschlossen, statt eine Tatsache zu erfinden. Kaleidr Enterprise erkunden für Spatial-Intelligence-APIs, Ranking, Analytics und SDK-Oberflächen neben dem Stack, den ein Produkt bereits betreibt. Kaleidr-Entwicklerdokumentation lesen für die aktuellen Verträge zu Chat, Editor, Tile, Viewer, Keys und Scopes vor der Implementierung.
Häufig gestellte Fragen
Was ist Enterprise-Spatial-AI-Architektur?
Enterprise-Spatial-AI-Architektur ist das Systemdesign, das Sprachmodelle, Karten, geografische Dienste, Geschäftsdaten, Berechtigungen, Tools, Aktionen und Analytics verbindet und jede Verantwortung in der Ebene hält, die sie durchsetzen kann.
Sollte ein Sprachmodell direkten Zugriff auf eine Geschäftsdatenbank haben?
In der Regel nicht als unbeschränkte Schnittstelle. Autorisieren Sie den aktuellen Benutzer, rufen Sie nur die minimalen Datensätze ab, die die Aufgabe benötigt, halten Sie Felder strukturiert und stellen Sie eng gefasste Tools bereit. Offener Datenbankzugriff macht das Modell zur Berechtigungs-Engine.
Wofür sollte das Sprachmodell zuständig sein?
Das Modell eignet sich für natürlichsprachlichen Intent, Orchestrierung zwischen genehmigten Funktionen und die Erklärung eines verankerten Ergebnisses. Autorisierung, Transaktionen, geschäftliche Wahrheit und geografische Berechnungen bleiben in den dafür ausgelegten Systemen.
Was ist der Unterschied zwischen Plattform-Authentifizierung und Benutzerautorisierung?
Plattform-Authentifizierung stellt fest, dass eine Anwendung eine Plattformfunktion nutzen darf. Benutzerautorisierung entscheidet, welche Person oder welcher Mandant auf einen Datensatz zugreifen oder eine Geschäftsaktion ausführen darf. Eine Prüfung ersetzt die andere nicht.
Sollte Spatial AI Retrieval-Augmented Generation verwenden?
Retrieval kann relevante Dokumente oder Datensätze bereitstellen. Retrieval allein begründet keine Autorität. Bestand, Verfügbarkeit, Preis, Berechtigungen und Zugehörigkeit zu Servicegebieten sollten an ihre Systems of Record und an deterministische Regeln gebunden bleiben.
Wie sollten Spatial-AI-Tools abgesichert werden?
Verwenden Sie eng gefasste Funktionen, minimale Berechtigungen, Autorisierung im Benutzerkontext, Argumentvalidierung, Rate Limits, Monitoring und eine unabhängige Freigabe für folgenschwere Aktionen. Behandeln Sie weder das Modell noch den System-Prompt als Autorisierungsmechanismus.
Sollten Spatial-AI-Aktionen eine menschliche Freigabe erfordern?
Die Freigabe richtet sich nach der Auswirkung. Risikoarme Kartenaktionen, etwa das Anzeigen von Orten, können automatisch laufen. Käufe, Buchungen, Dispositionen, administrative Schreibvorgänge und Berechtigungsänderungen können eine ausdrückliche Bestätigung oder eine separate Freigabe benötigen.
Wie sollte ein Kartenassistent die aktuelle Karte verwenden?
Übergeben Sie strukturierten Zustand wie Viewport-Grenzen, IDs ausgewählter Orte, aktive Filter, sichtbare Ergebnis-IDs, Routen-IDs und einen Standort in der für die Aufgabe nötigen Genauigkeit. Verlangen Sie vom Modell nicht, den Anwendungszustand aus einem Screenshot abzuleiten, wenn strukturierter Zustand vorhanden ist.
Kann Spatial AI mit einer bestehenden Karte arbeiten?
Ja. Eine Spatial-AI-Ebene kann an eine Karte und Anwendung angefügt werden, die der Host bereits betreibt. Kaleidrs aktuelle Chat-Dokumentation beschreibt, wie konversationelle Spatial AI an Host-betriebene Mapbox-, MapLibre- oder Google-Maps-Instanzen angefügt wird.
Wie sollte ein Team die Architektur vor der Skalierung bewerten?
Bewerten Sie den zusammengesetzten Workflow: Intent, Autorisierung, Grounding, geografische Berechnungen, Eignung, Ranking, Erklärung, Tools, Aktionen, Fehlerbehandlung und Geschäftsergebnisse. Ein allgemeiner Sprachmodell-Benchmark ersetzt diesen Test nicht.
Quellen
- Kaleidr. Grounded Spatial AI for Business Data. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- Kaleidr. Map API Authentication. https://kaleidr.com/blog/map-api-authentication
- Kaleidr. Get an API Key. Publishable browser keys and server keys. Accessed September 30, 2026. https://docs.kaleidr.com/get-an-api-key
- Kaleidr. Introduction. Chat, Editor, Tile, and Viewer in one SDK. Accessed September 30, 2026. https://docs.kaleidr.com/
- OWASP Gen AI Security Project. LLM06:2025 Excessive Agency. Accessed September 30, 2026. https://genai.owasp.org/llmrisk/llm062025-excessive-agency/
- OWASP Gen AI Security Project. LLM07:2025 System Prompt Leakage. Accessed September 30, 2026. https://genai.owasp.org/llmrisk/llm072025-system-prompt-leakage/
- Kaleidr. How to Build a Map-Aware AI Assistant. https://kaleidr.com/blog/how-to-build-a-map-aware-ai-assistant
- National Institute of Standards and Technology. AI Risk Management Framework. Voluntary framework for trustworthiness in design, development, use, and evaluation. Released January 26, 2023. Page states that AI RMF 1.0 is being revised. Accessed September 30, 2026. https://www.nist.gov/itl/ai-risk-management-framework
- National Institute of Standards and Technology. AI RMF Core. Measure 2.1: test sets, metrics, and details about the tools used during TEVV are documented. Accessed September 30, 2026. https://airc.nist.gov/airmf-resources/airmf/5-sec-core/
- Kaleidr. Map Engagement and Location Analytics. Accessed September 30, 2026. https://kaleidr.com/analytics
- Kaleidr. Location Intelligence APIs and Map SDK. Accessed September 30, 2026. https://kaleidr.com/enterprise
- Kaleidr. Chat. Attach AI to a host-run Mapbox, MapLibre, or Google Maps instance. Accessed September 30, 2026. https://docs.kaleidr.com/chat
- National Institute of Standards and Technology. The TEVV-Athlon Framework for Evaluating AI Systems. NIST AI 200-2, initial public draft. Announced August 7, 2026; comments through October 6, 2026. https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems
- Kaleidr. Spatial AI Accuracy Evaluation. https://kaleidr.com/blog/spatial-ai-accuracy-evaluation
- Kaleidr. An Enterprise Spatial AI Pilot Before Scaling. https://kaleidr.com/blog/enterprise-spatial-ai-pilot-before-scaling
@misc{kaleidr_grounded_architecture_2026,
  title  = {Grounded Spatial AI for Business Data},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/grounded-spatial-ai-business-data}
}

@misc{kaleidr_map_api_auth_2026,
  title  = {Map API Authentication},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/map-api-authentication}
}

@misc{kaleidr_get_api_key_2026,
  title  = {Get an API Key},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 30, 2026},
  url    = {https://docs.kaleidr.com/get-an-api-key}
}

@misc{kaleidr_docs_intro_2026,
  title  = {Introduction},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 30, 2026. Chat, Editor, Tile, and Viewer},
  url    = {https://docs.kaleidr.com/}
}

@misc{owasp_llm06_2025,
  title  = {LLM06:2025 Excessive Agency},
  author = {{OWASP Gen AI Security Project}},
  year   = {2025},
  note   = {Accessed September 30, 2026},
  url    = {https://genai.owasp.org/llmrisk/llm062025-excessive-agency/}
}

@misc{owasp_llm07_2025,
  title  = {LLM07:2025 System Prompt Leakage},
  author = {{OWASP Gen AI Security Project}},
  year   = {2025},
  note   = {Accessed September 30, 2026},
  url    = {https://genai.owasp.org/llmrisk/llm072025-system-prompt-leakage/}
}

@misc{kaleidr_map_aware_2026,
  title  = {How to Build a Map-Aware AI Assistant},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/how-to-build-a-map-aware-ai-assistant}
}

@misc{nist_ai_rmf_2023,
  title  = {AI Risk Management Framework},
  author = {{National Institute of Standards and Technology}},
  year   = {2023},
  note   = {Released January 26, 2023. Accessed September 30, 2026. Page states AI RMF 1.0 is being revised},
  url    = {https://www.nist.gov/itl/ai-risk-management-framework}
}

@misc{nist_ai_rmf_core_2023,
  title  = {AI RMF Core},
  author = {{National Institute of Standards and Technology}},
  year   = {2023},
  note   = {Measure 2.1. Accessed September 30, 2026},
  url    = {https://airc.nist.gov/airmf-resources/airmf/5-sec-core/}
}

@misc{kaleidr_analytics_architecture_2026,
  title  = {Map Engagement and Location Analytics},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 30, 2026},
  url    = {https://kaleidr.com/analytics}
}

@misc{kaleidr_enterprise_architecture_2026,
  title  = {Location Intelligence APIs and Map SDK},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 30, 2026},
  url    = {https://kaleidr.com/enterprise}
}

@misc{kaleidr_chat_docs_2026,
  title  = {Chat},
  author = {{Kaleidr}},
  year   = {2026},
  note   = {Accessed September 30, 2026},
  url    = {https://docs.kaleidr.com/chat}
}

@techreport{nist_ai_200_2_2026,
  title       = {The TEVV-Athlon Framework for Evaluating AI Systems},
  author      = {{National Institute of Standards and Technology}},
  institution = {National Institute of Standards and Technology},
  number      = {NIST AI 200-2},
  year        = {2026},
  note        = {Initial public draft, announced August 7, 2026},
  url         = {https://www.nist.gov/artificial-intelligence/ai-research/tevv-athlon-framework-evaluating-ai-systems}
}