
La latencia de Spatial AI es el tiempo desde una pregunta de ubicación hasta la primera respuesta útil en el mapa, y no es un único temporizador del modelo. La espera puede incluir autorización, recuperación, una ruta y los tokens que genera un modelo de lenguaje. Un modelo rápido puede seguir detrás de una ruta lenta. Un párrafo final más lento todavía puede sentirse ágil si primero aparece un lugar elegible o una ruta.
¿Qué incluye la latencia de Spatial AI?
Una pregunta de ubicación atraviesa varios relojes, y promediarlos en una sola “latencia de AI” oculta la etapa que el usuario realmente está esperando. La capacidad de respuesta del navegador indica qué tan rápido reacciona la página a un clic. Time to first progress es cuando la interfaz muestra que el trabajo comenzó. Time to first token es cuando la generación produce su primer token. Time to first spatial action es cuando un lugar elegible o una ruta se vuelve visible. Time to last token es cuando termina la generación. Time to completed action es cuando el usuario puede confiar en el resultado.
Time to first progress, time to first spatial action y time to completed action son nombres que Kaleidr usa para la experiencia del producto. Esos tres nombres no son estándares web. Time to first token y time to last token son métricas establecidas de los modelos.
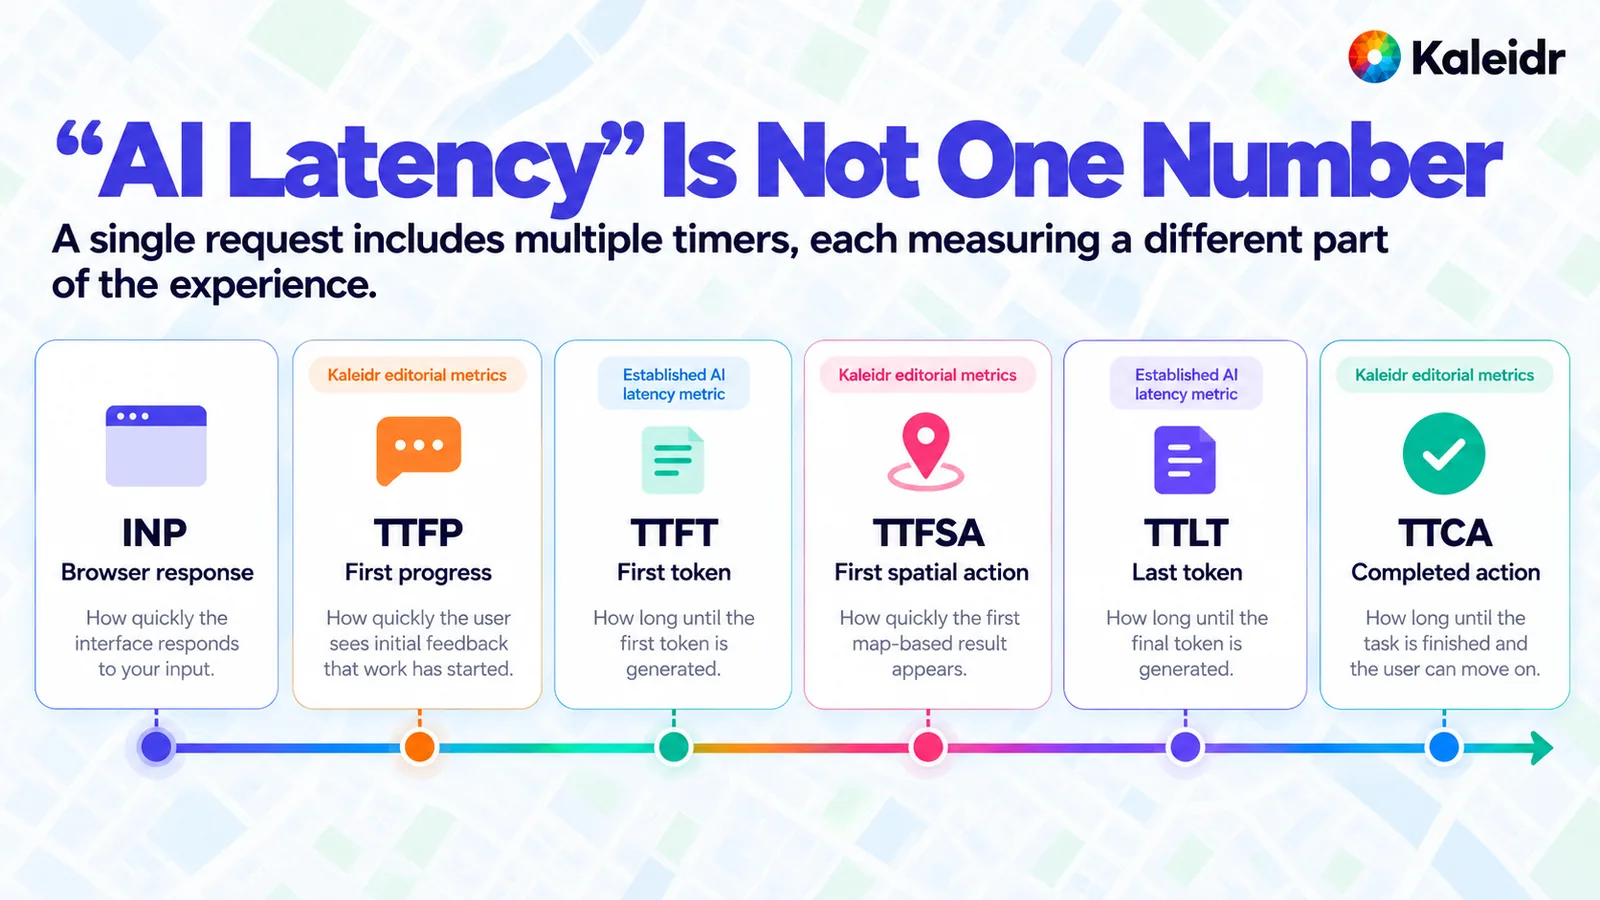
Las seis tarjetas separan la respuesta del navegador del resto de la solicitud. Time to first progress, time to first spatial action y time to completed action están marcadas como métricas editoriales de Kaleidr. Time to first token y time to last token aparecen como métricas establecidas de latencia del modelo. Interaction to Next Paint es la métrica del navegador. Ninguna tarjeta informa una medición de Kaleidr.
La guía de rendimiento web de Google trata Interaction to Next Paint como una medida de capacidad de respuesta en campo y considera bueno un INP de 200 milisegundos o menos en el percentil 75 de las cargas de página (web.dev, 2025). Ese umbral se refiere al siguiente renderizado después de un clic, no a una ruta ni a un párrafo generado. Una página puede cumplirlo y aun así dejar al usuario esperando la recuperación. Una llamada lenta al modelo no vuelve malo el INP por sí sola. Los dos presupuestos deben graficarse por separado, o un equipo terminará “corrigiendo la latencia de AI” al ajustar un manejador de clic que nunca estuvo en la ruta crítica.
¿Por qué importa la ruta crítica?
La ruta crítica es la cadena más larga de pasos que deben terminar en orden. Las consultas independientes pueden superponerse. Una ruta que necesita tanto un lugar resuelto como un dato de negocio no puede comenzar hasta que ambos existan. Serializar esas consultas suma sus tiempos. Ejecutarlas a la vez elimina solo la superposición y no hace que la ruta en sí sea más rápida. La autorización sigue ocurriendo antes de mostrar cualquier registro privado.
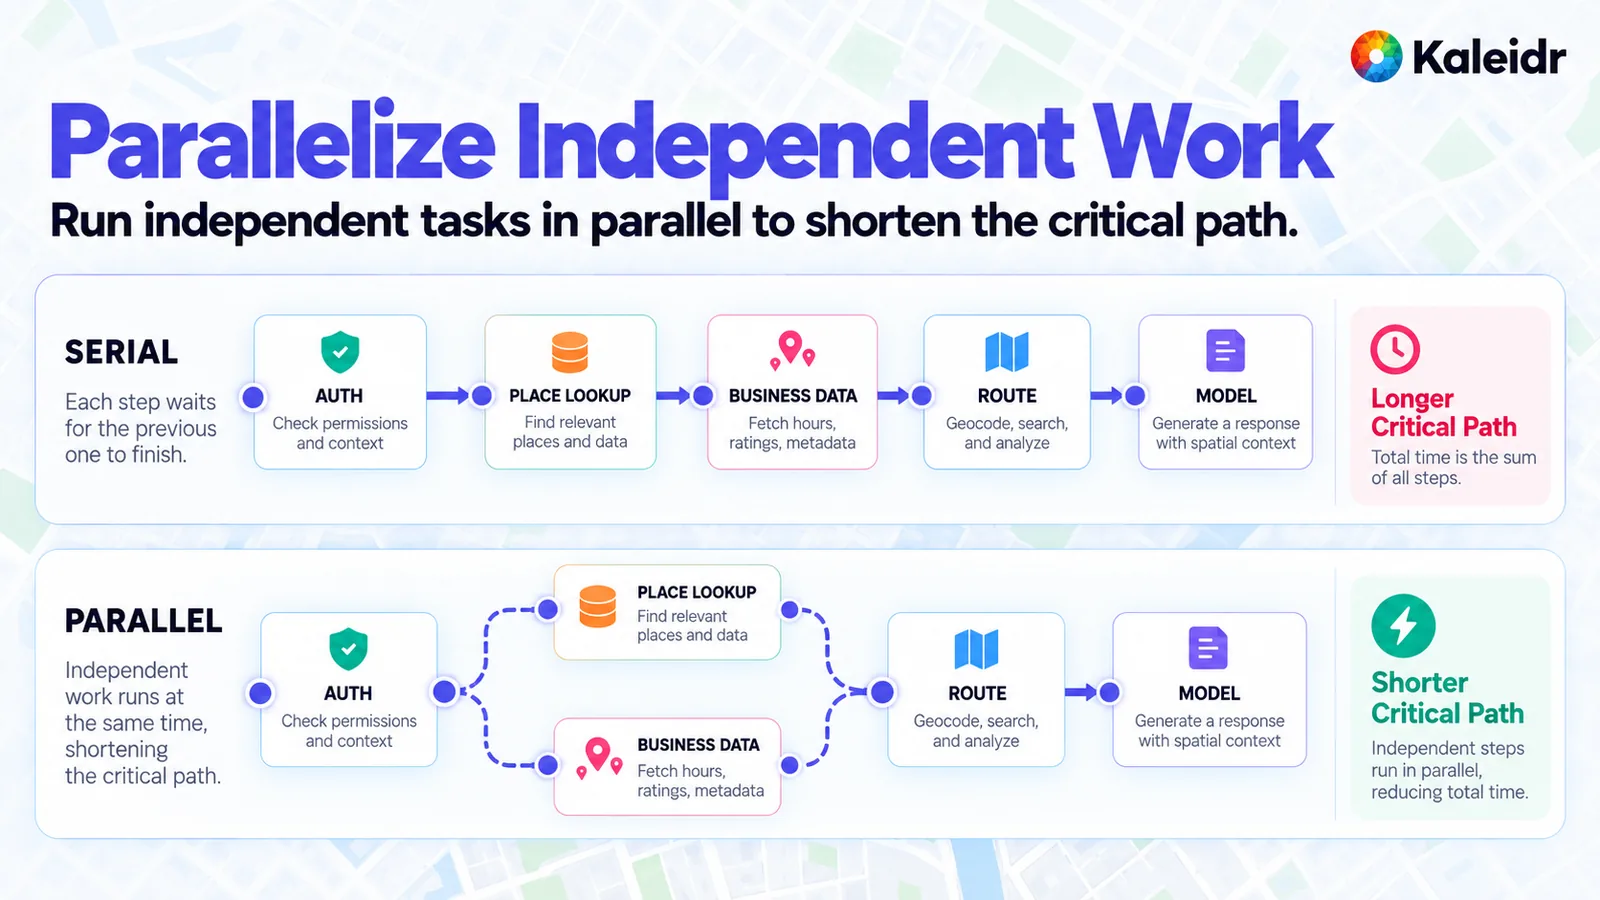
La fila superior espera a que cada paso termine antes de empezar el siguiente. La fila inferior ejecuta la consulta de lugar y los datos de negocio al mismo tiempo y luego los une para la ruta y el modelo. La figura describe la forma de la espera. El dibujo no informa una mejora de velocidad medida, y la ruta sigue dependiendo de ambas consultas.
Una traza útil nombra el span, no el producto. La geocodificación, una lectura de negocio, una ruta, el ranking y la generación pueden ser, cada uno, el span lento según la pregunta. Observabilidad de Spatial AI es la guía complementaria para registrar esos spans por separado, incluido un motivo estructurado cuando el resultado está vacío. Sin esa separación, una tarde lenta parece que “el modelo empeoró” cuando en realidad fue el servicio de rutas la etapa que cambió.
¿Por qué el primer token no es el primer resultado del mapa?
Time to first token y time to last token responden preguntas distintas, y ninguno marca el momento en que el mapa se vuelve útil. Azure OpenAI documenta la relación como: time to last token equivale a time to first token más el tiempo entre tokens multiplicado por la cantidad de tokens generados (Microsoft, 2026). El mismo artículo dice que cada token del prompt añade poco tiempo en comparación con cada token generado y que el streaming devuelve tokens cuando están listos sin cambiar el tiempo necesario para producirlos todos. La guía de latencia de OpenAI ofrece una heurística relacionada: reducir aproximadamente a la mitad los tokens de salida puede reducir aproximadamente a la mitad la latencia (OpenAI, 2026). Por eso una explicación corta puede terminar antes. La tarjeta del mapa, no el párrafo, debería llevar el lugar, los horarios y la ruta.
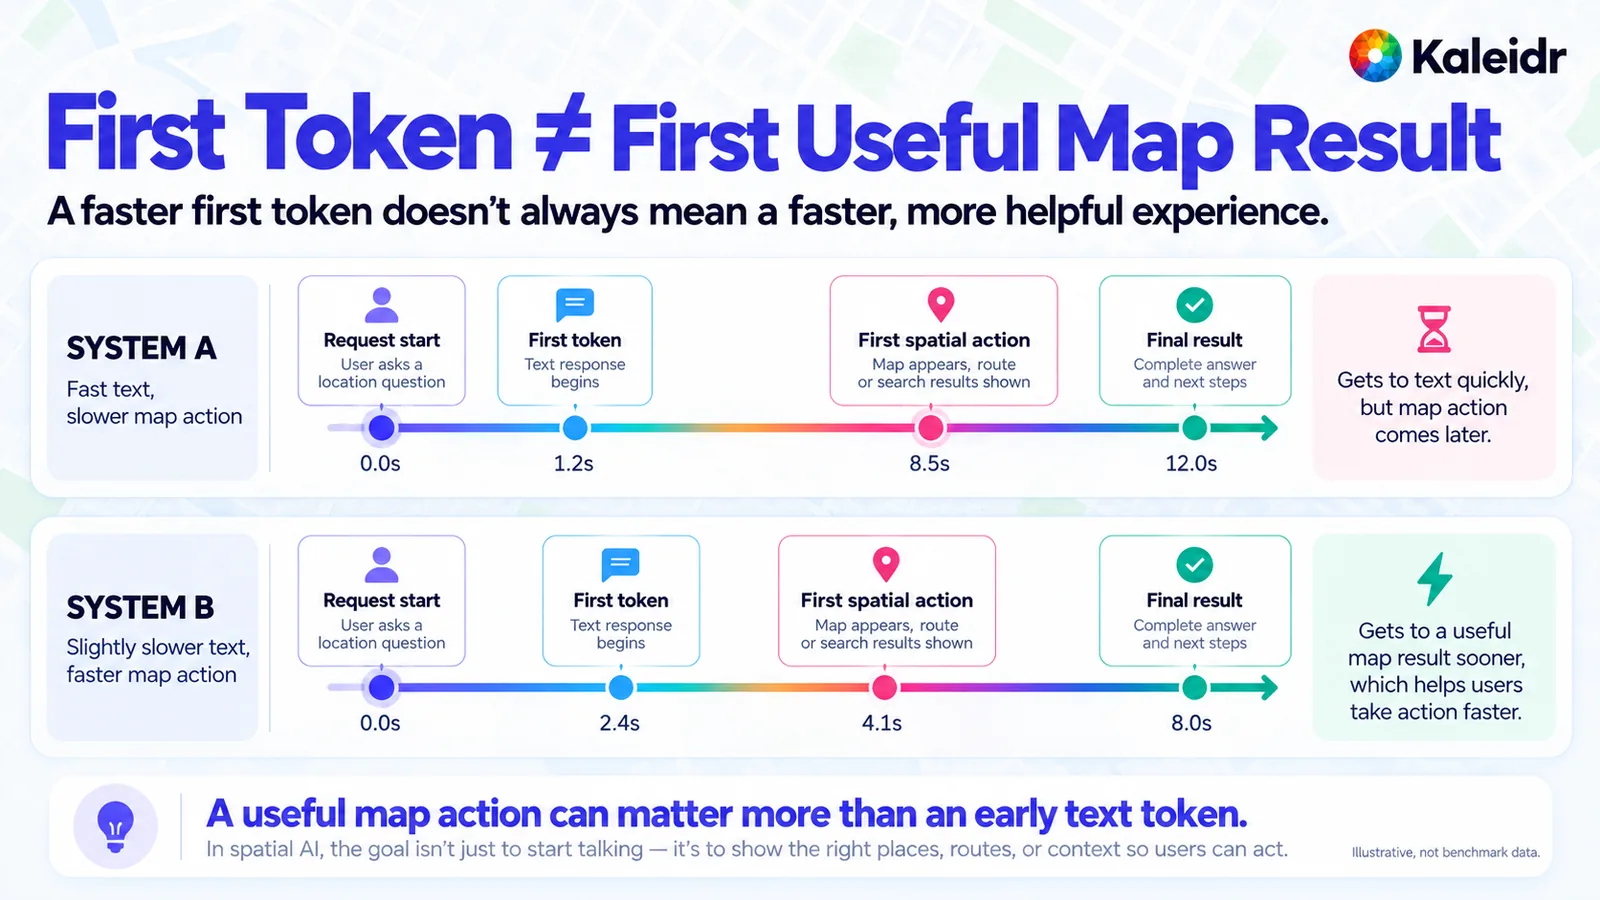
El sistema A muestra texto pronto y una acción del mapa tarde. El sistema B muestra texto más tarde y una acción del mapa antes. Las marcas de segundos y los totales de la figura son ilustrativos, y la propia gráfica indica que no son datos de benchmark. Las marcas no son una traza de Kaleidr ni un resultado de los artículos de Azure u OpenAI. La comparación trata solo del orden: un token anterior no significa un mapa anterior.
La diferencia importa para lo que el producto celebra. Un panel que clasifique solo por time to first token preferirá al sistema que habla primero y dibuja tarde. Un producto de mapas también debería registrar time to first spatial action, y solo debería registrar esa acción después de que se haya superado la elegibilidad. Un pin temprano para un lugar cerrado o no autorizado es un error rápido. Spatial Context Engineering es la regla relacionada para decidir qué hechos pueden llegar al modelo una vez que existe el conjunto elegible.
¿Qué se puede almacenar en caché y qué debe revalidarse?
Una caché ahorra un viaje de ida y vuelta solo cuando el valor guardado sigue siendo el correcto. Los identificadores estables y las coordenadas de un lugar conocido cambian rara vez, por lo que suelen ser candidatos a una caché de larga duración. Los horarios, una ruta calculada y el texto descriptivo cambian con suficiente frecuencia como para que un tiempo de vida corto sea la política honesta. El inventario, la posición de un vehículo, la autorización y el estado de una transacción deben volver a leerse en el momento de la decisión. Un “en stock” almacenado esta mañana no es evidencia para esta tarde.
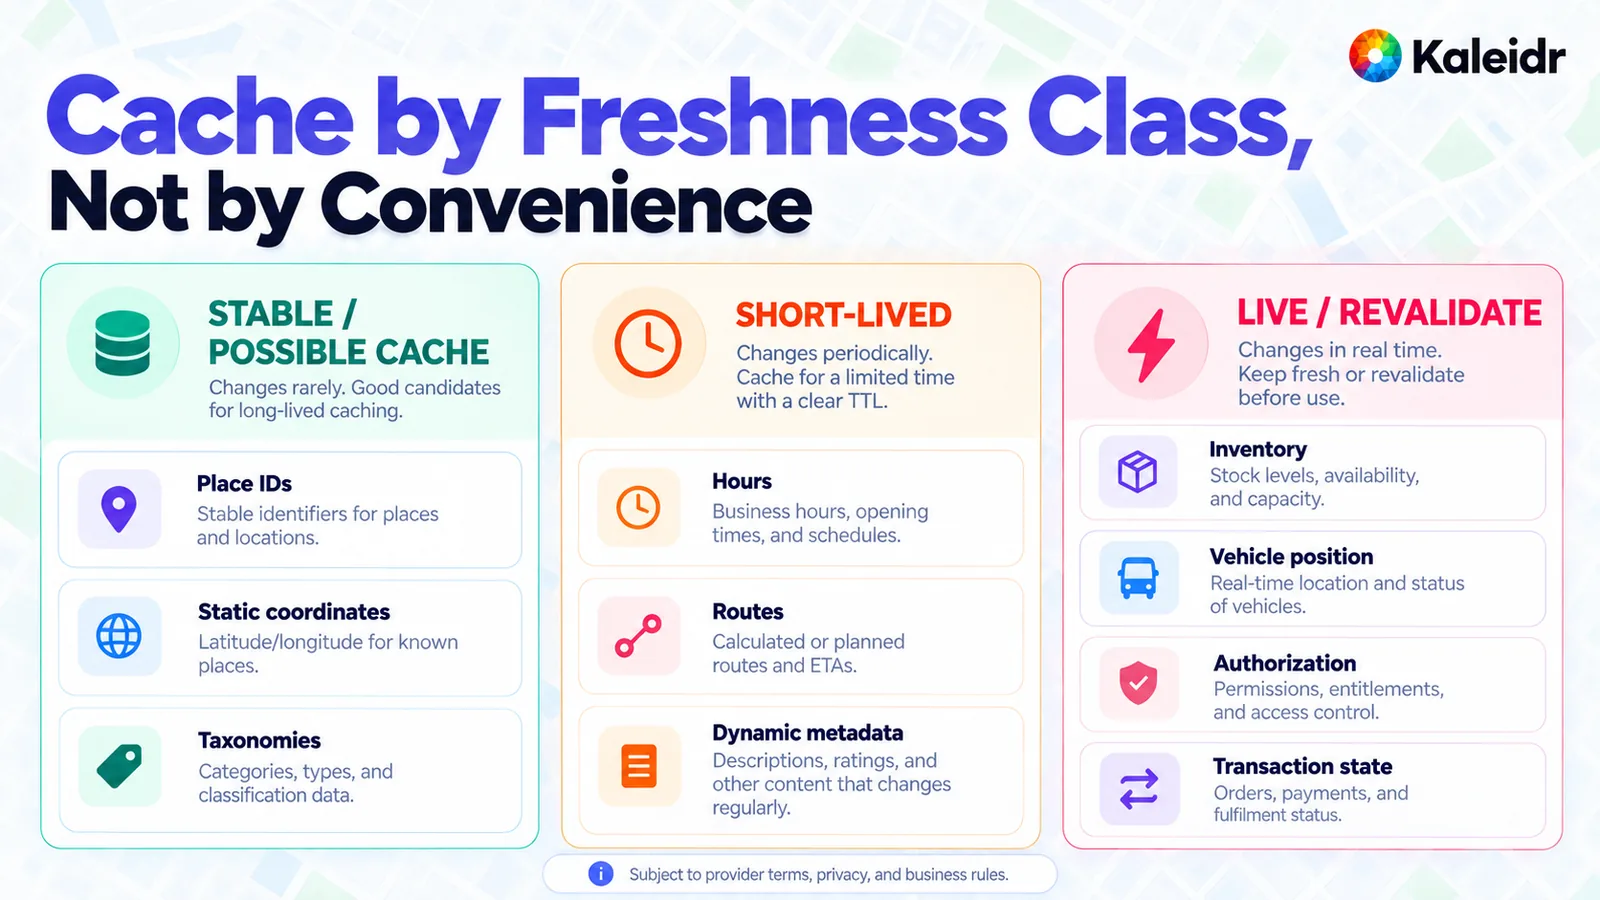
La columna izquierda contiene lo que rara vez cambia. La columna central necesita una vida útil corta. La derecha debe revalidarse antes de usarse. El pie de la figura dice que las clases están sujetas a las condiciones del proveedor, la privacidad y las reglas de negocio. Una ruta en la columna central es un cálculo almacenado en caché, no una promesa de que la carretera siga abierta. Nada de la figura representa una política de caché de Kaleidr.
Los datos de lugares de un proveedor añaden una segunda restricción. Las condiciones que acompañaban al registro siguen aplicándose a una copia, incluida la atribución y cualquier limitación de uso. Los registros privados añaden una tercera: una caché compartida entre usuarios no debe convertirse en una vía para saltarse la autorización. Lo desconocido sigue siendo desconocido. Un timeout de inventario no autoriza a mostrar “agotado”, y un timeout de una ruta no autoriza a inventar los minutos.
¿Cuándo puede moverse el mapa antes de que termine la explicación?
El orden útil en un mapa suele ser lugar, luego ruta y después la frase que los explica. El usuario puede revisar un candidato elegible mientras el modelo de lenguaje todavía escribe. Ese patrón no hace más rápida la recuperación ni el enrutamiento. Solo revela trabajo que ya terminó. El texto en streaming tiene el mismo límite. La guía de Azure indica que el streaming cambia cuándo se ve el primer token, no el tiempo necesario para producir la secuencia completa.
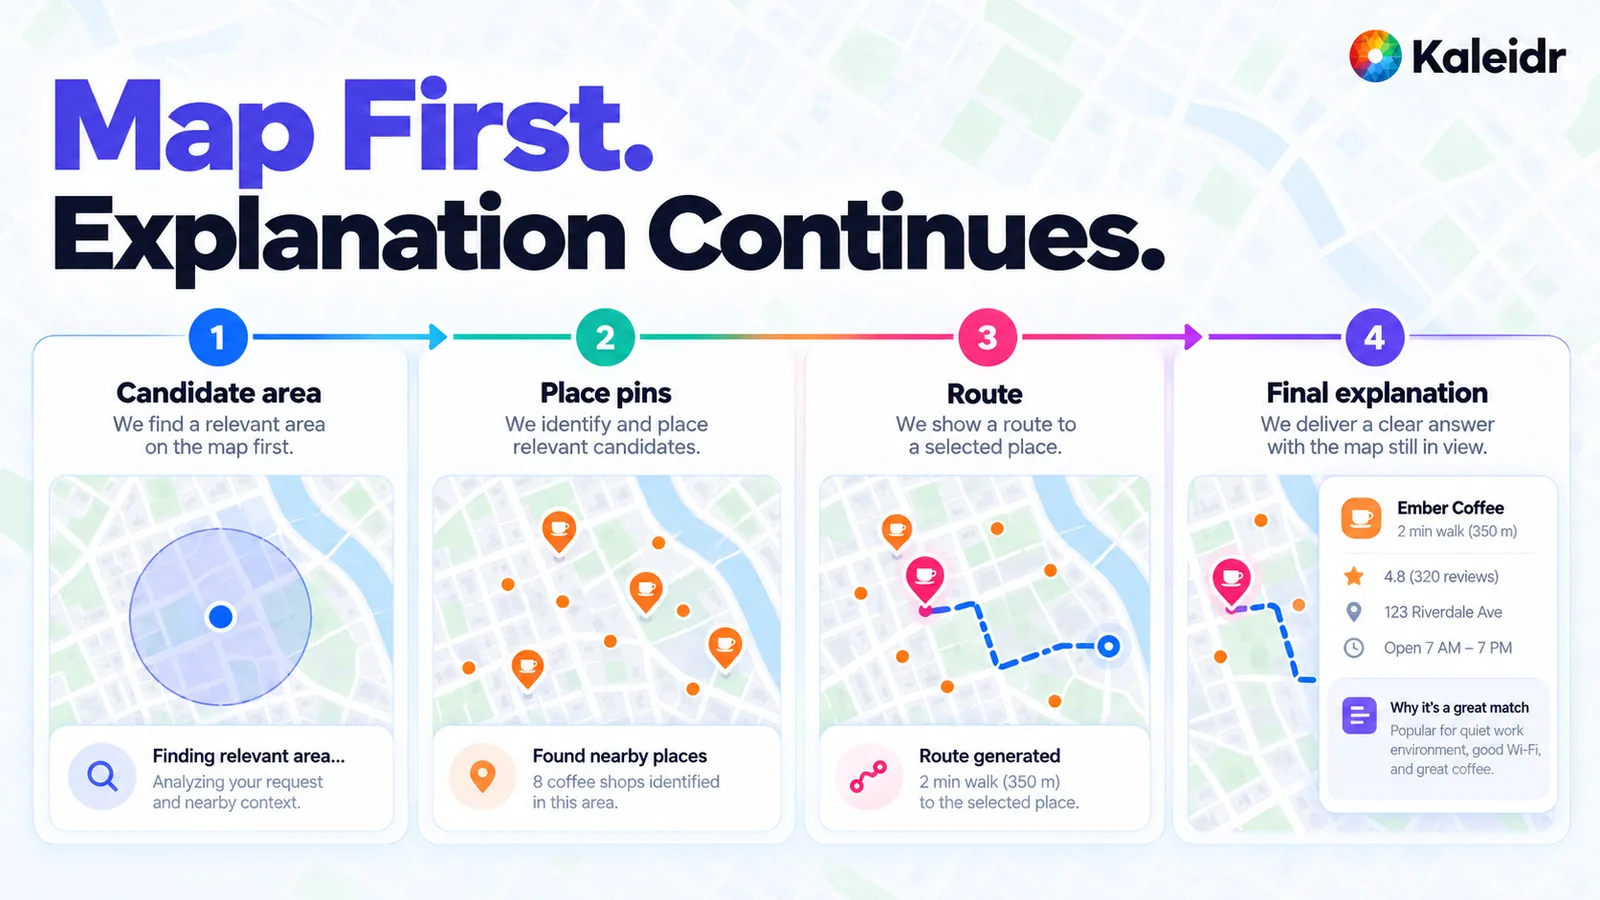
La secuencia es un área candidata, luego pines, después una ruta y finalmente una explicación breve. El número de tiendas, la caminata de dos minutos, la valoración, la dirección y los horarios son etiquetas de ejemplo en la ilustración, no una consulta en vivo. Los pines y la ruta de este patrón corresponden a lugares que ya superaron la elegibilidad. Un marcador temprano no sustituye esa comprobación.
El stream público de Kaleidr usa Server-Sent Events, text/event-stream, y el contrato especifica qué puede llegar antes de que termine el texto (Kaleidr, 2026). El evento phase significa que la solicitud fue aceptada y que el trabajo comenzó, y su valor de fase siempre es thinking. Un comentario : keep-alive llega después de 10 segundos de silencio. En una pregunta difícil, el primer texto puede tardar decenas de segundos; por eso existen el evento phase y el heartbeat. En una pregunta de direcciones, una route puede llegar antes del texto, de modo que la línea puede dibujarse mientras el texto se transmite. early_actions transporta acciones del mapa que pueden aplicarse antes de terminar la respuesta y se envía cuando dos o más lugares tienen coordenadas. El evento end es el resultado autoritativo y sus acciones reemplazan esas acciones tempranas. No todos los eventos aparecen en todas las solicitudes.
¿Cómo debe dibujarse el grafo de la solicitud?
Dibuja las dependencias y después elimina los pasos que no cambien la respuesta. La resolución del lugar y una lectura de negocio pueden ejecutarse en paralelo después de la autorización. La elegibilidad es la unión. El enrutamiento y otros trabajos espaciales usan esa unión. El ranking ordena a los supervivientes. La generación los explica. El mapa muestra los mismos identificadores. Generar antes de la elegibilidad gasta tokens en lugares que el producto no puede recomendar. Grounded Spatial AI for Business Data mantiene esa elegibilidad en los sistemas que son dueños de los hechos.
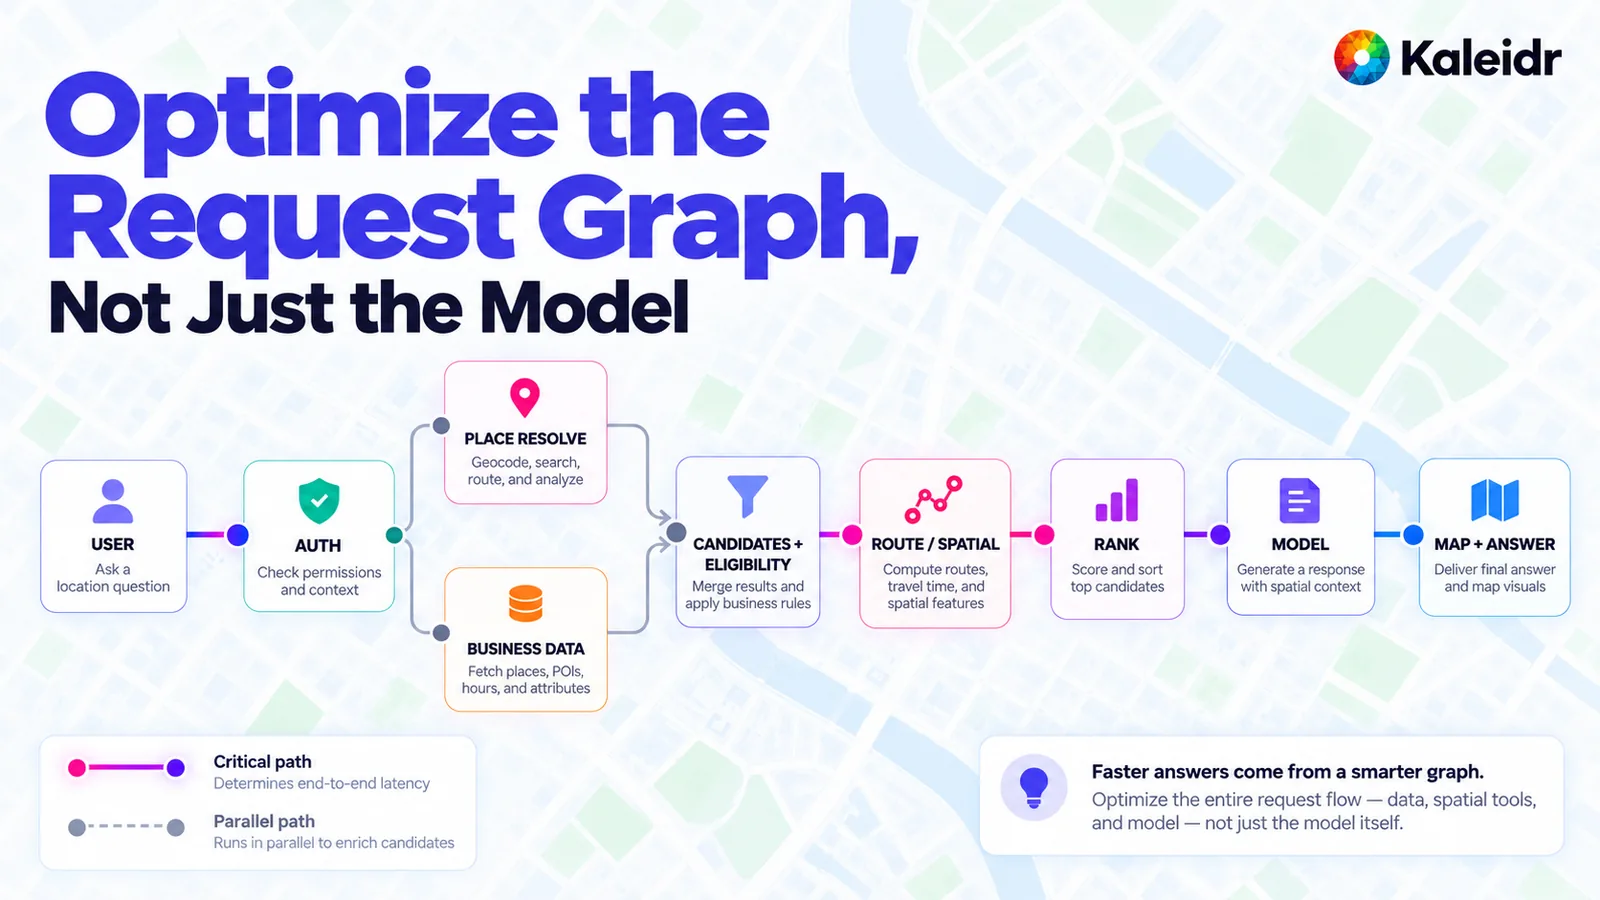
La autorización va primero. La resolución del lugar y la lectura de negocio forman el par paralelo. Después siguen elegibilidad, ruta, ranking, generación y mapa. La línea continua es la ruta crítica y la discontinua es la lectura superpuesta. La figura defiende dibujar todo el grafo. No informa un ahorro medido ni muestra un registro privado cruzando la autorización.
El mismo grafo muestra dónde un modelo de lenguaje es la herramienta equivocada. Una prueba de contención, una comprobación de autorización, un filtro de “abierto ahora” y un umbral de distancia son deterministas. El modelo sirve para leer la solicitud, explicar un resultado que los servicios ya calcularon y clasificar preferencias blandas entre lugares elegibles. La guía de latencia de OpenAI hace el mismo corte en términos generales: un método clásico es más rápido cuando la tarea no necesita razonamiento lingüístico. Un solo prompt que devuelva todos los pasos lingüísticos también puede superar a una cadena de llamadas al modelo, porque cada llamada adicional paga otro viaje de ida y vuelta. La ruta, el stock y el permiso siguen viniendo de sus propios servicios.
¿Por qué el promedio puede ocultar las solicitudes lentas?
La media resume mal una espera porque unas pocas solicitudes lentas dominan lo que la gente recuerda. Informa la mediana, el percentil 95 y el percentil 99 de cada span, separados por clase de solicitud. Una pregunta de direcciones y una pregunta corta sobre un lugar no deben estar en el mismo grupo. La cola puede deberse a un fan-out entre herramientas, un reintento, un prompt grande, una diferencia entre proveedores o una respuesta generada larga. La fórmula de Azure ya dice que el último caso crece con los tokens de salida. Los demás no aparecerán en el conteo de tokens, por eso los spans deben mantenerse separados.
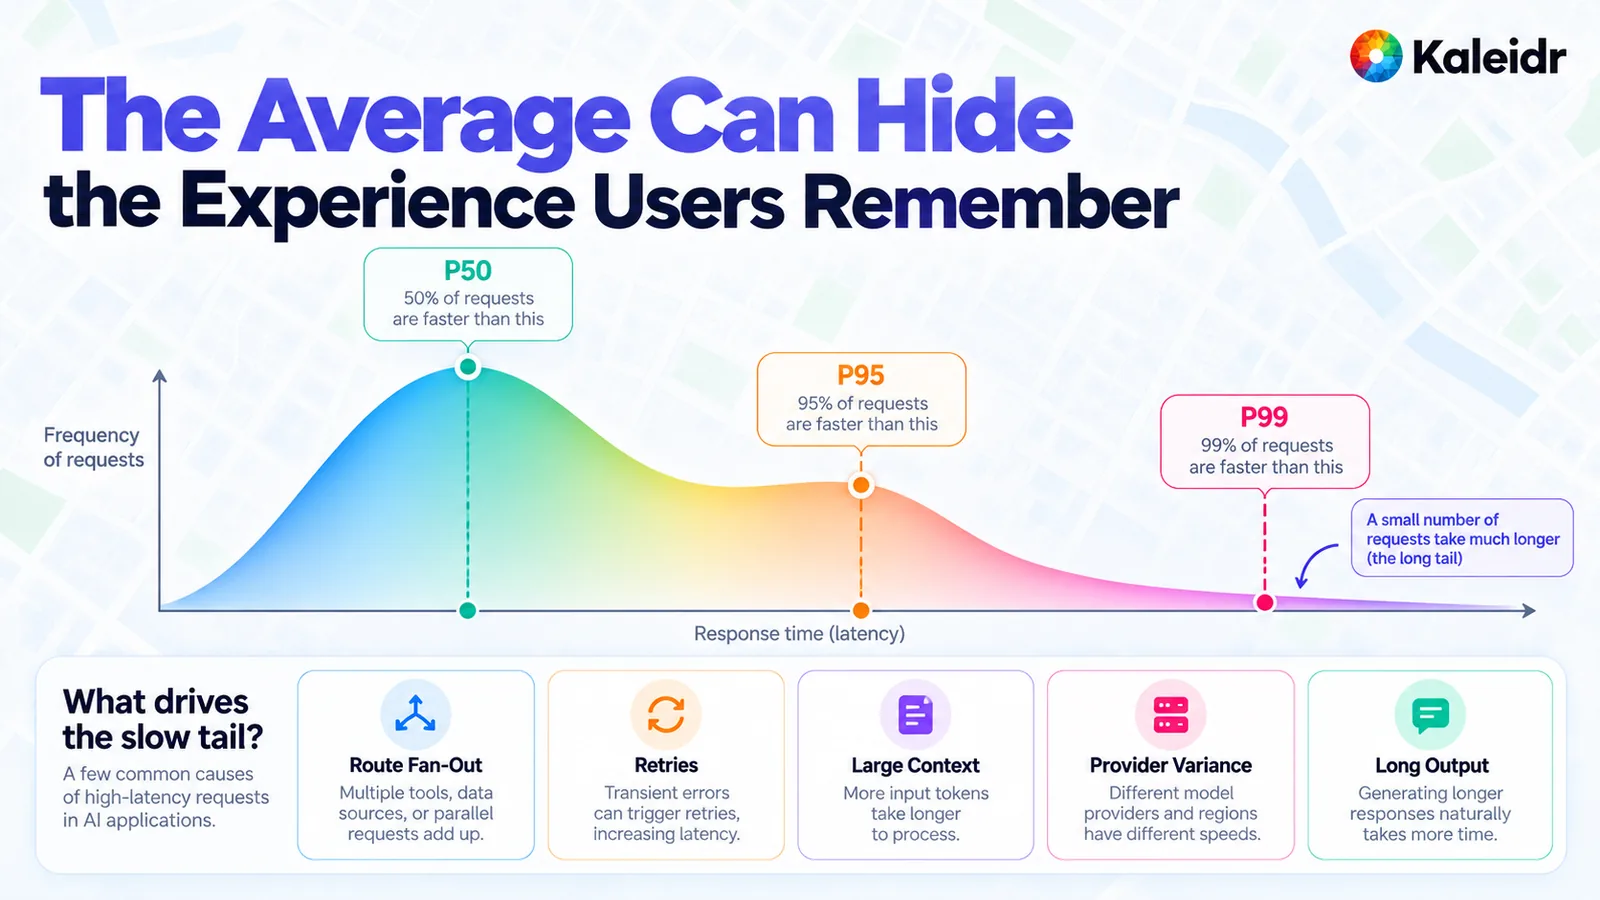
La curva representa una forma, no una traza de Kaleidr ni una muestra de un panel de proveedor. Las etiquetas usan la lectura habitual de esos percentiles: la mitad de las solicitudes está en la mediana o por debajo, la mayoría en el percentil 95 o por debajo y casi todas en el percentil 99 o por debajo. Las cinco causas bajo el gráfico son una lista de lugares donde mirar. No son porcentajes medidos del tráfico de Kaleidr.
Una política para la cola debe decir qué hace el producto cuando un span supera su presupuesto. Un timeout de ruta sigue siendo desconocido, y la explicación indica que la ruta no estaba disponible. Un timeout de inventario sigue siendo desconocido en lugar de convertirse en “agotado”. Un reintento debe quedar en la traza para que un fallo transitorio no se confunda con un modelo lento. Optimizar la mediana mientras el percentil 99 mantiene al usuario frente a un spinner no es un programa de rendimiento terminado.
¿Qué etapas pertenecen al presupuesto?
Nombra las etapas antes de asignar un objetivo. Un presupuesto práctico tiene siete líneas: admitir la solicitud en la interfaz, comprobar identidad y autorización, recuperar contexto, calcular la ruta o la distancia, generar la explicación, aplicar la acción del mapa y completar la acción de negocio. Algunas líneas se superponen, como muestra el grafo de solicitud. Algunas solicitudes nunca llegan a una reserva o a una transferencia. La lista sirve para ver qué línea se movió, no para afirmar que todas las preguntas ejecutan las siete en serie ni para fijar objetivos en milisegundos.
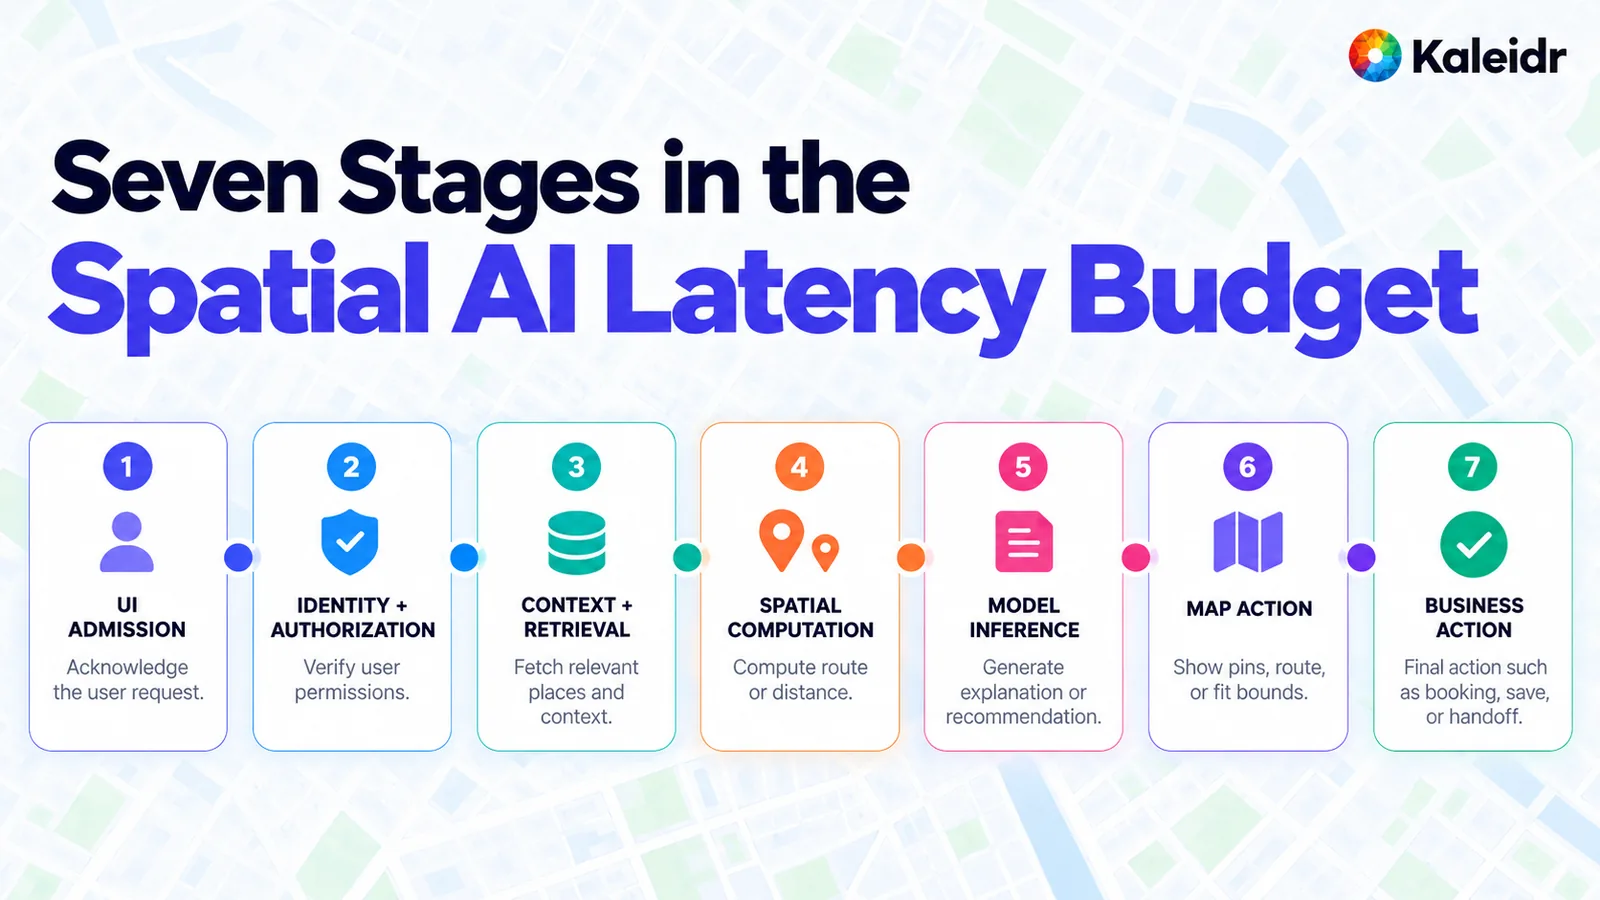
Cada etapa tiene un trabajo y ninguna duración. Admitir la solicitud es trabajo del navegador. La autorización precede a los datos privados. La recuperación, el cálculo espacial y la generación son líneas separadas. La acción del mapa muestra un pin, una ruta o una vista ajustada. La acción de negocio es la transferencia y no aparece cuando la pregunta no la requiere. La figura no fija ningún objetivo numérico.
Pon un objetivo a una etapa solo después de que la traza muestre que esa etapa es la que hace esperar a los usuarios. Un número universal como “respuestas en dos segundos” mezclaría el clic, la ruta y el párrafo, y este artículo no cita uno. El umbral de INP anterior es un objetivo del navegador. La fórmula de tokens anterior describe el tiempo del modelo. Time to first spatial action es el objetivo del mapa y sigue siendo una métrica editorial hasta que un equipo la defina en sus propias trazas.
¿Por dónde debería empezar un equipo?
Empieza separando la espera. Registra Interaction to Next Paint para la página, time to first progress, time to first token, time to first spatial action, time to last token y time to completed action. Mantén los tres nombres editoriales etiquetados como métricas de producto. Lee p50, p95 y p99 por clase de solicitud. Acorta la respuesta generada cuando el mapa ya muestra el detalle. Superpone solo las consultas que no dependen entre sí. Revalida todo lo que pueda cambiar la decisión. Deja que el evento end, y no el primer pin, sea el resultado sobre el que el usuario puede actuar.
Explora Kaleidr Enterprise cuando esa ruta deba incluir los lugares y reglas propios de la organización. El SSE wire contract es el orden de eventos citado arriba, incluidos el evento phase, el keep-alive, las acciones tempranas del mapa y el resultado final.
Nota: Kaleidr utiliza herramientas asistidas por IA para la creación de imágenes, el refinamiento de contenido y la investigación en sus flujos creativos y de desarrollo.
Preguntas frecuentes
¿Qué es la latencia de Spatial AI?
La latencia de Spatial AI es el tiempo desde una pregunta de ubicación hasta una respuesta útil en el mapa. Incluye la interfaz, autorización, recuperación, cálculo espacial, generación, acción del mapa y cualquier transferencia de negocio. No es el mismo número que el tiempo del modelo.
¿Interaction to Next Paint es lo mismo que la latencia del modelo?
No. Interaction to Next Paint mide qué tan rápido responde la página a un clic. Un buen valor, de 200 milisegundos o menos en el percentil 75 de las cargas de página, no dice nada sobre cuándo terminará una ruta o un párrafo.
¿Qué es time to first token?
Time to first token es el tiempo desde que se envía un prompt hasta que regresa el primer token generado. Azure OpenAI lo usa, junto con el tiempo entre tokens y la cantidad de tokens generados, para describir time to last token.
¿Por qué el primer token no es suficiente para un mapa?
Un mapa es útil cuando se ve un lugar elegible o una ruta. Ese momento puede llegar antes del primer token o mucho después. Time to first spatial action registra el momento del mapa. Time to first token registra el momento del texto.
¿El streaming hace más rápido el enrutamiento?
No. El streaming cambia cuándo se vuelve visible el trabajo terminado. No reduce el tiempo de una ruta, una recuperación ni la generación completa. El artículo de latencia de Azure dice que el streaming no cambia el tiempo necesario para producir todos los tokens.
¿Qué envía Kaleidr antes de que termine la respuesta?
El stream público puede enviar un evento phase cuyo valor es thinking, un keep-alive durante el silencio, una route antes del texto en una pregunta de direcciones y early_actions cuando dos o más lugares tienen coordenadas. El evento end es autoritativo y reemplaza las acciones tempranas. No todos los eventos aparecen en todas las solicitudes.
¿Debe almacenarse en caché el inventario privado para reducir la latencia?
No. El inventario, la autorización, una posición en vivo y el estado de una transacción deben revalidarse en el momento de la decisión. Un timeout sigue siendo desconocido. Los identificadores estables de lugares son los candidatos habituales para una caché de larga duración, y solo dentro de las condiciones del proveedor.
¿Qué percentil debería vigilar un equipo?
Vigila la mediana, el percentil 95 y el percentil 99 de cada span, separados por clase de solicitud. La mediana puede mejorar mientras la cola lenta que recuerdan los usuarios sigue igual.
References
- web.dev. Interaction to Next Paint (INP). A good INP is at or below 200 milliseconds at the 75th percentile of page loads recorded in the field. An INP above 200 milliseconds and at or below 500 milliseconds needs improvement. Updated September 2, 2025. https://web.dev/articles/inp
- Microsoft. Azure OpenAI in Microsoft Foundry Models performance & latency. Time to last token equals time to first token plus the time between tokens multiplied by tokens generated. Streaming returns tokens as they are ready and does not change the time required to produce all of them. Accessed October 31, 2026. https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/latency
- OpenAI. Latency optimization. A stated heuristic: cutting about half of the output tokens may cut about half of the latency. Accessed October 31, 2026. https://developers.openai.com/api/docs/guides/latency-optimization
- Kaleidr Developer Docs. SSE wire contract. Documents
text/event-stream, aphaseevent that is alwaysthinking, a keep-alive after 10 seconds of silence, tens of seconds before first prose on a hard question,early_actionsonce two or more places have coordinates, aroutebefore the prose on a directions question, andendas the authoritative result. Accessed October 31, 2026. https://docs.kaleidr.com/platform-api/sse-wire-contract - Kaleidr. Spatial AI Observability. A related guide for recording each stage, including a structured reason when the result is empty. Accessed October 31, 2026. https://kaleidr.com/blog/spatial-ai-observability
- Kaleidr. Spatial Context Engineering for Map-Aware AI. A related guide for which facts reach the model after eligibility. Accessed October 31, 2026. https://kaleidr.com/blog/spatial-context-engineering
- Kaleidr. Grounded Spatial AI for Business Data. A related guide for keeping business facts in the systems that own them. Accessed October 31, 2026. https://kaleidr.com/blog/grounded-spatial-ai-business-data
References in BibTeX
@misc{webdev_inp_2025,
  title  = {Interaction to Next Paint (INP)},
  author = {{web.dev}},
  year   = {2025},
  url    = {https://web.dev/articles/inp}
}

@misc{microsoft_azure_openai_latency_2026,
  title  = {Azure OpenAI in Microsoft Foundry Models performance \& latency},
  author = {{Microsoft}},
  year   = {2026},
  url    = {https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/latency}
}

@misc{openai_latency_optimization_2026,
  title  = {Latency optimization},
  author = {{OpenAI}},
  year   = {2026},
  url    = {https://developers.openai.com/api/docs/guides/latency-optimization}
}

@misc{kaleidr_sse_wire_contract_2026,
  title  = {SSE wire contract},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://docs.kaleidr.com/platform-api/sse-wire-contract}
}

@misc{kaleidr_spatial_ai_observability_2026,
  title  = {Spatial AI Observability},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-ai-observability}
}

@misc{kaleidr_spatial_context_engineering_2026,
  title  = {Spatial Context Engineering for Map-Aware AI},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-context-engineering}
}

@misc{kaleidr_grounded_spatial_ai_2026,
  title  = {Grounded Spatial AI for Business Data},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/grounded-spatial-ai-business-data}
}