
Spatial-AI-Latenz ist die Zeit von einer Standortfrage bis zum ersten nützlichen Kartenfeedback und nicht einfach ein einzelner Modell-Timer. Die Wartezeit kann Autorisierung, Retrieval, eine Route und die von einem Sprachmodell erzeugten Tokens umfassen. Auch ein schnelles Modell kann hinter einer langsamen Route warten. Ein langsamerer Schlussabsatz kann sich trotzdem reaktionsschnell anfühlen, wenn zuerst ein geeigneter Ort oder eine Route erscheint.
Was umfasst Spatial-AI-Latenz?
Eine Standortfrage durchläuft mehrere Zeitmesser. Wer sie zu einer einzigen „AI-Latenz“ mittelt, verdeckt die Phase, auf die der Nutzer tatsächlich wartet. Browser-Reaktionsfähigkeit beschreibt, wie schnell die Seite auf einen Klick reagiert. Time to first progress ist der Zeitpunkt, an dem die Oberfläche zeigt, dass die Arbeit begonnen hat. Time to first token ist der Zeitpunkt, an dem die Generierung das erste Token liefert. Time to first spatial action ist der Zeitpunkt, an dem ein geeigneter Ort oder eine Route sichtbar wird. Time to last token ist der Zeitpunkt, an dem die Generierung endet. Time to completed action ist der Zeitpunkt, an dem sich der Nutzer auf das Ergebnis verlassen kann.
Time to first progress, time to first spatial action und time to completed action sind Kaleidr-Bezeichnungen für das Produkterlebnis. Diese drei Begriffe sind keine Webstandards. Time to first token und time to last token sind etablierte Modellmetriken.
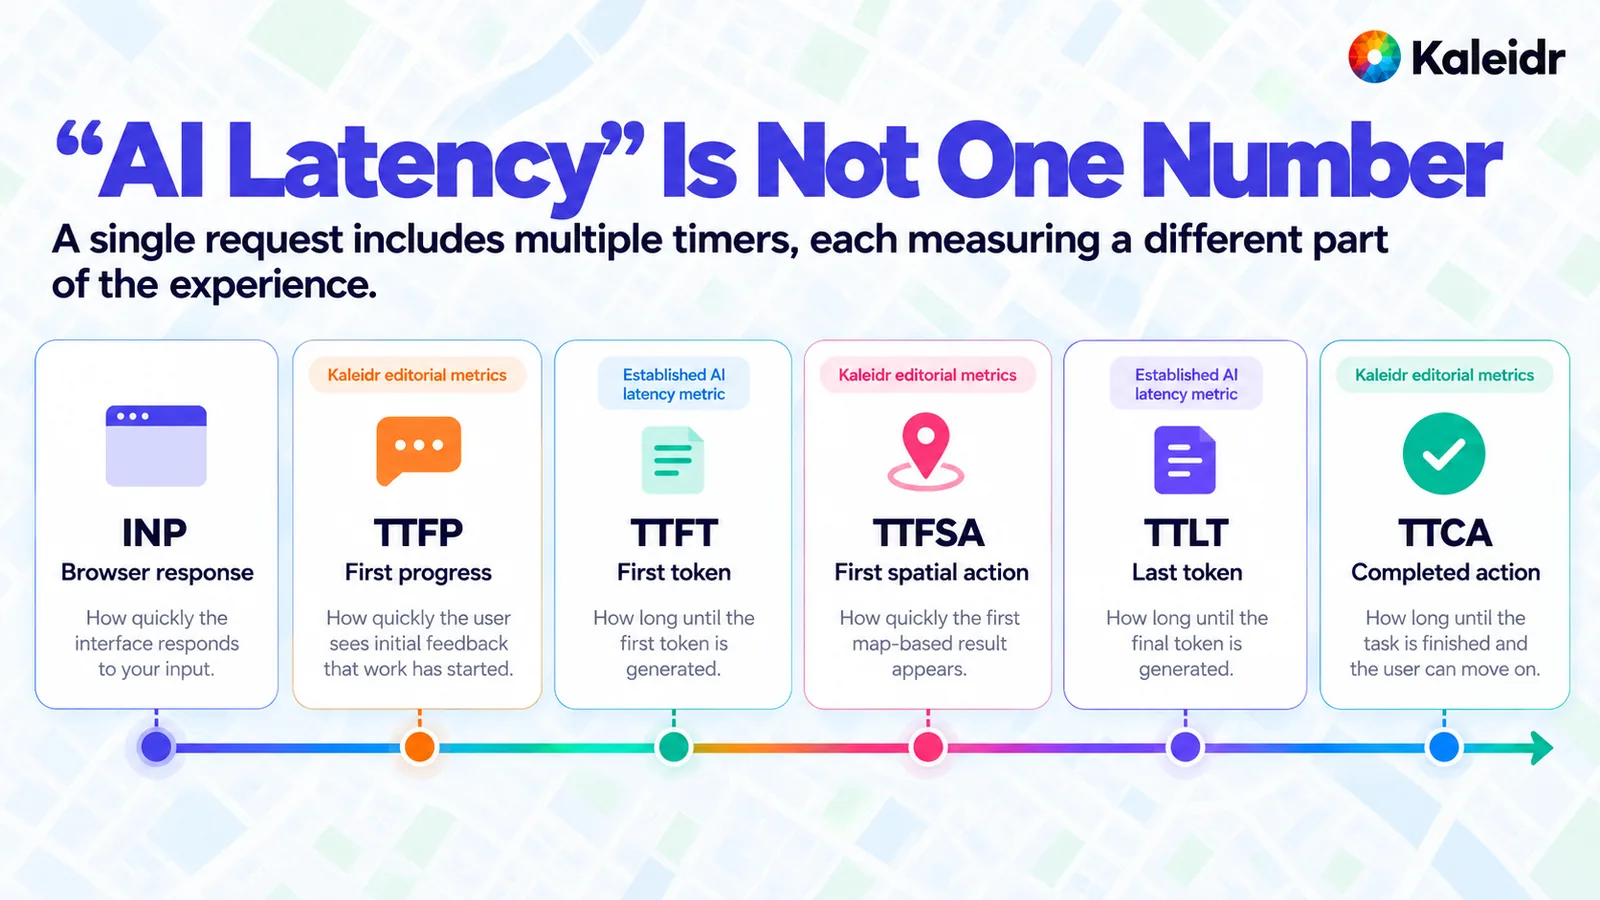
Die sechs Karten trennen die Browserreaktion vom Rest der Anfrage. Time to first progress, time to first spatial action und time to completed action sind als redaktionelle Kaleidr-Metriken gekennzeichnet. Time to first token und time to last token sind als etablierte Modell-Latenzmetriken gekennzeichnet. Interaction to Next Paint ist die Browsermetrik. Keine der Karten berichtet eine Kaleidr-Messung.
Googles Web-Performance-Leitfaden behandelt Interaction to Next Paint als Feldmetrik für Reaktionsfähigkeit und bezeichnet einen INP von höchstens 200 Millisekunden beim 75. Perzentil der Seitenaufrufe als gut (web.dev, 2025). Dieser Schwellenwert betrifft den nächsten Paint nach einem Klick, nicht eine Route oder einen generierten Absatz. Eine Seite kann ihn erfüllen und den Nutzer trotzdem auf Retrieval warten lassen. Ein langsamer Modellaufruf macht den INP für sich genommen nicht schlecht. Die beiden Budgets sollten getrennt dargestellt werden, sonst „behebt“ ein Team die „AI-Latenz“, indem es einen Klick-Handler optimiert, der nie auf dem kritischen Pfad lag.
Warum ist der kritische Pfad wichtig?
Der kritische Pfad ist die längste Kette von Schritten, die in einer bestimmten Reihenfolge abgeschlossen werden müssen. Unabhängige Lookups können sich überlappen. Eine Route, die sowohl einen aufgelösten Ort als auch eine Geschäftsinformation benötigt, kann erst starten, wenn beides vorliegt. Werden diese Lookups serialisiert, addieren sich ihre Zeiten. Parallele Ausführung entfernt nur die Überlappung; sie macht die Route selbst nicht schneller. Autorisierung findet weiterhin statt, bevor ein privater Datensatz angezeigt wird.
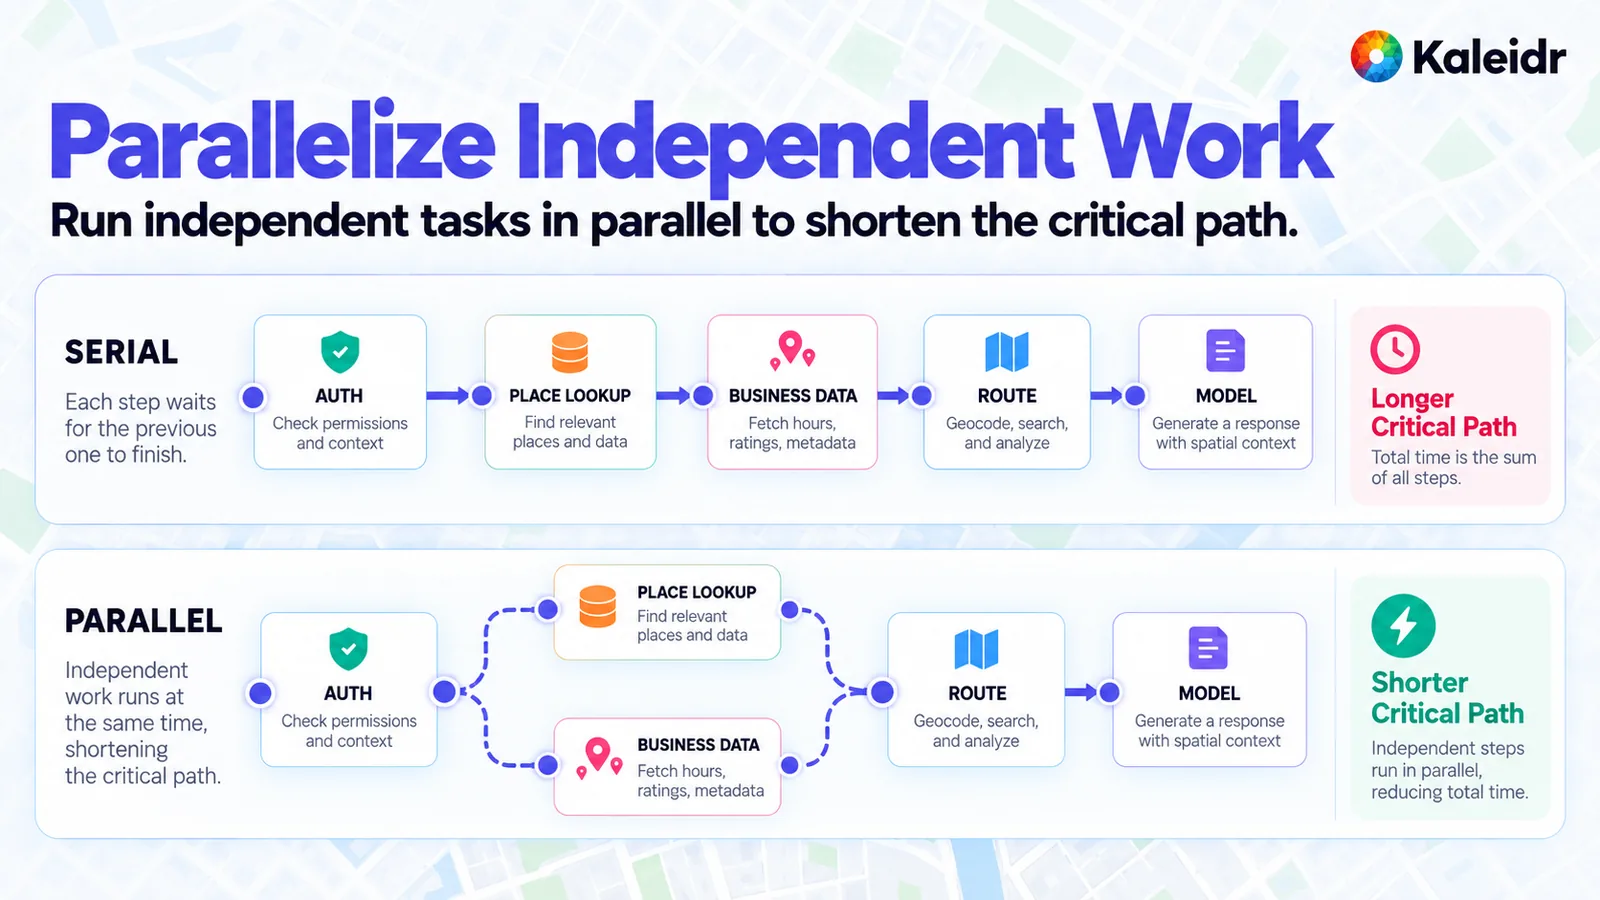
Die obere Zeile wartet darauf, dass jeder Schritt abgeschlossen ist, bevor der nächste beginnt. Die untere Zeile führt Ortssuche und Geschäftsdaten gleichzeitig aus und verbindet sie anschließend für Route und Modell. Die Abbildung beschreibt die Form der Wartezeit. Sie berichtet keinen gemessenen Geschwindigkeitsgewinn, und die Route hängt weiterhin von beiden Lookups ab.
Ein nützlicher Trace benennt den Span und nicht das Produkt. Geocoding, ein Geschäfts-Lesevorgang, eine Route, Ranking und Generierung können je nach Frage jeweils der langsame Span sein. Spatial AI Observability ist der begleitende Leitfaden, um diese Spans getrennt aufzuzeichnen, einschließlich eines strukturierten Grundes, wenn das Ergebnis leer ist. Ohne diese Trennung sieht ein langsamer Nachmittag so aus, als sei „das Modell schlechter geworden“, obwohl tatsächlich der Routing-Dienst langsamer war.
Warum ist das erste Token nicht das erste Kartenergebnis?
Time to first token und time to last token beantworten unterschiedliche Fragen, und keiner der beiden Zeitpunkte ist der Moment, in dem eine Karte nützlich wird. Azure OpenAI dokumentiert die Beziehung als: Time to last token entspricht Time to first token plus der Zeit zwischen Tokens multipliziert mit der Anzahl erzeugter Tokens (Microsoft, 2026). Derselbe Artikel sagt, dass jedes Prompt-Token im Vergleich zu jedem generierten Token nur wenig Zeit hinzufügt und dass Streaming Tokens zurückgibt, sobald sie verfügbar sind, ohne die Gesamtzeit zur Erzeugung aller Tokens zu verändern. OpenAIs Latenzleitfaden nennt eine verwandte Faustregel: Werden die Ausgabetokens ungefähr halbiert, kann sich auch die Latenz ungefähr halbieren (OpenAI, 2026). Eine kurze Erklärung kann deshalb früher fertig sein. Die Kartenkarte, nicht der Absatz, sollte Ort, Öffnungszeiten und Route tragen.
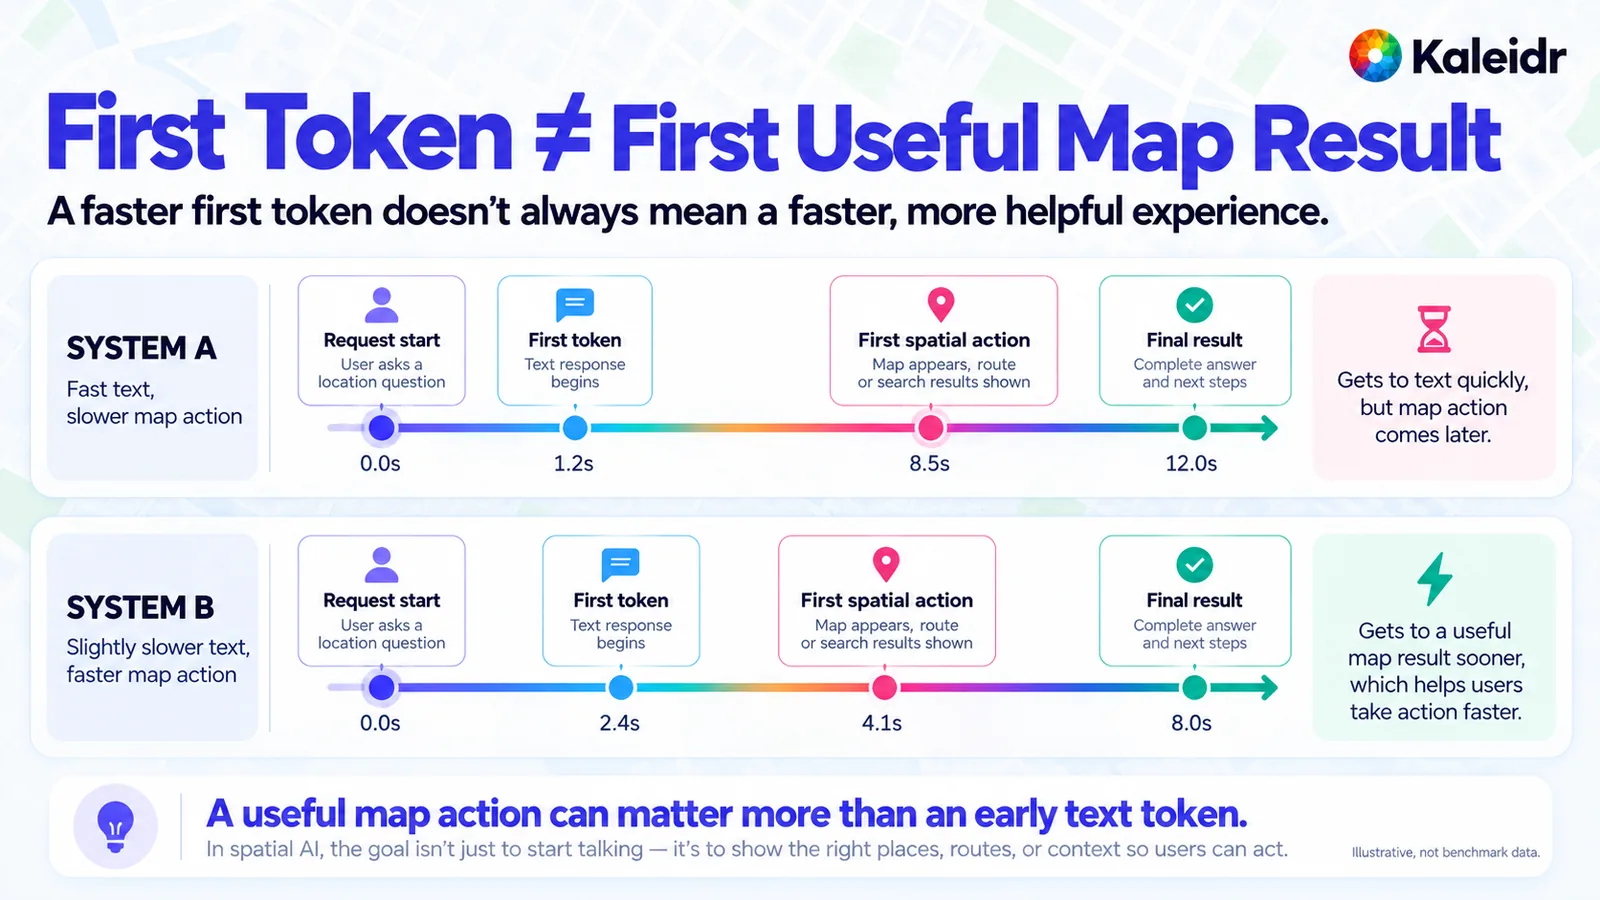
System A zeigt Text früh und eine Kartenaktion spät. System B zeigt Text später und eine Kartenaktion früher. Die Sekundenmarken und Summen in der Abbildung sind Illustrationen, und die Grafik weist darauf hin, dass es sich nicht um Benchmark-Daten handelt. Die Markierungen sind weder ein Kaleidr-Trace noch ein Ergebnis aus den Azure- oder OpenAI-Artikeln. Der Vergleich betrifft nur die Reihenfolge: Ein früheres Token ist keine frühere Karte.
Die Unterscheidung beeinflusst, was das Produkt als Erfolg wertet. Ein Dashboard, das nur nach Time to first token rankt, bevorzugt das System, das zuerst spricht und spät zeichnet. Ein Kartenprodukt sollte zusätzlich Time to first spatial action aufzeichnen und diese Aktion erst dann zählen, wenn die Eignungsprüfung bestanden ist. Ein früher Pin für einen geschlossenen oder nicht autorisierten Ort ist ein schneller Fehler. Spatial Context Engineering beschreibt die verwandte Regel dafür, welche Fakten das Modell erreichen dürfen, sobald die geeignete Menge feststeht.
Was darf gecacht werden, und was muss erneut validiert werden?
Ein Cache spart nur dann einen Roundtrip, wenn der gespeicherte Wert noch der richtige Wert ist. Stabile Kennungen und Koordinaten eines bekannten Orts ändern sich selten und sind daher typische Kandidaten für einen langlebigen Cache. Öffnungszeiten, eine berechnete Route und beschreibender Text ändern sich oft genug, dass eine kurze Time-to-live die ehrliche Richtlinie ist. Bestand, Fahrzeugposition, Autorisierung und Transaktionsstatus sollten zum Entscheidungszeitpunkt erneut gelesen werden. Ein gecachtes „auf Lager“ von heute Morgen ist kein Beleg für heute Nachmittag.
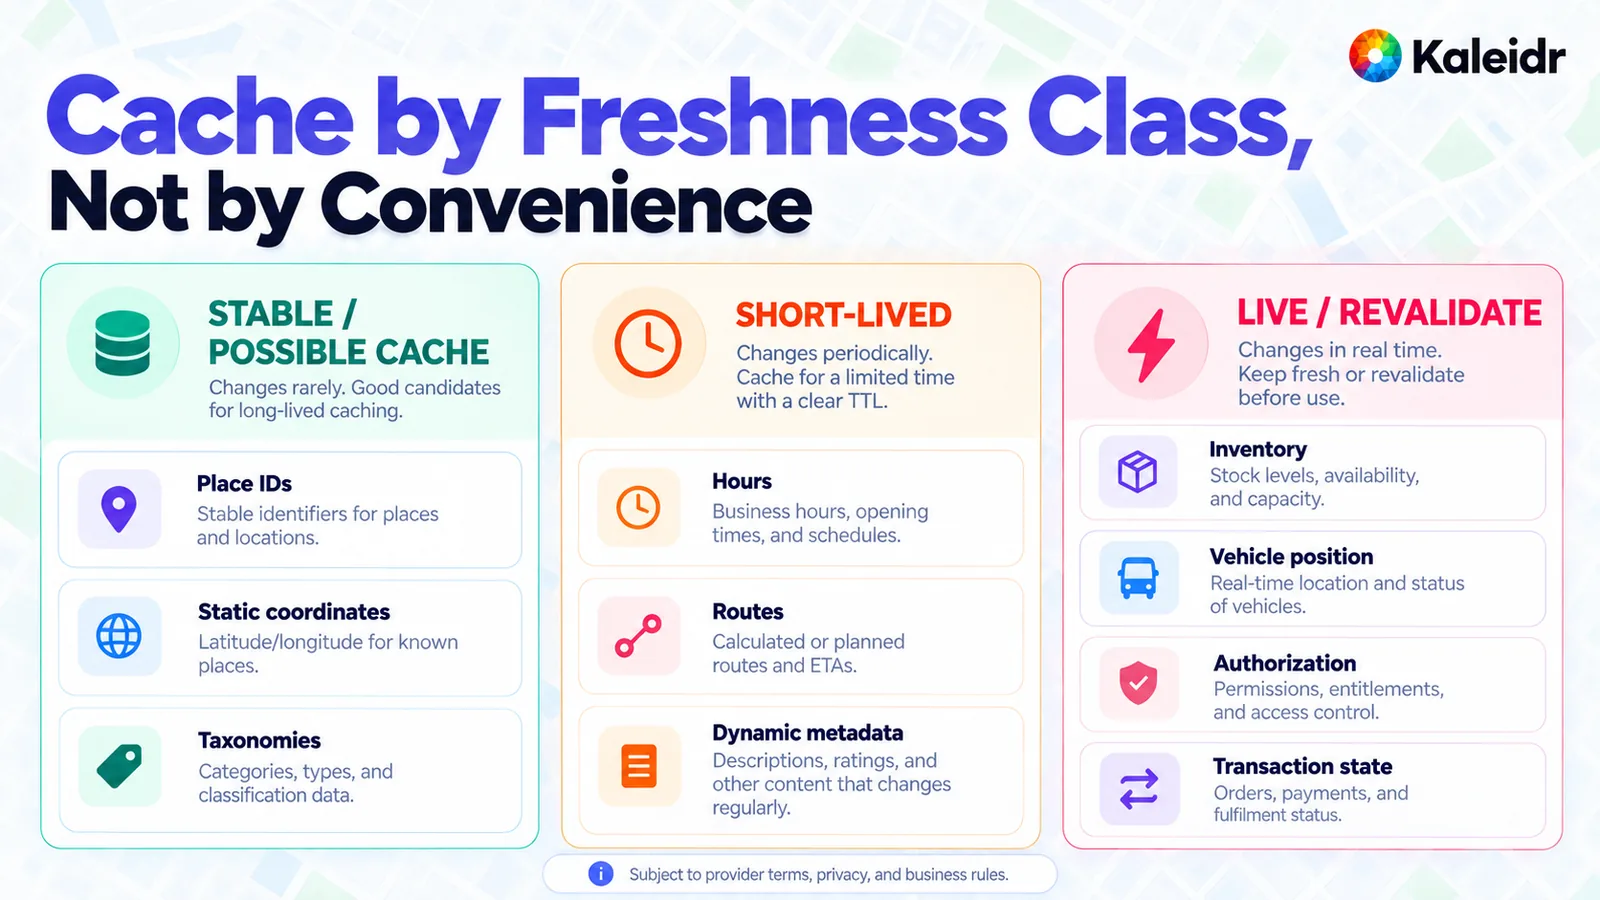
Die linke Spalte enthält Dinge, die sich selten ändern. Die mittlere braucht eine kurze Lebensdauer. Die rechte sollte vor der Nutzung erneut validiert werden. Die Fußnote der Abbildung sagt, dass die Klassen den Bedingungen des Anbieters sowie Datenschutz- und Geschäftsregeln unterliegen. Eine Route in der mittleren Spalte ist eine gecachte Berechnung und kein Versprechen, dass die Straße noch offen ist. Nichts in der Abbildung ist eine Kaleidr-Cache-Richtlinie.
Ortsdaten eines Anbieters bringen eine zweite Einschränkung mit sich. Die Bedingungen des ursprünglichen Datensatzes gelten auch für eine Kopie weiter, einschließlich Attribution und Nutzungsbeschränkungen. Private Datensätze bringen eine dritte hinzu: Ein zwischen Nutzern geteilter Cache darf nicht zum Umgehen der Autorisierung werden. Unbekannt bleibt unbekannt. Ein Timeout beim Bestand ist keine Erlaubnis, „nicht auf Lager“ anzuzeigen, und ein Timeout bei einer Route ist keine Erlaubnis, Minuten zu erfinden.
Wann kann sich die Karte bewegen, bevor die Erklärung fertig ist?
Die nützliche Reihenfolge auf einer Karte lautet oft: Ort, dann Route, dann der erklärende Satz. Der Nutzer kann einen geeigneten Kandidaten prüfen, während das Sprachmodell noch schreibt. Dieses Muster macht Retrieval oder Routing nicht schneller. Es zeigt lediglich bereits abgeschlossene Arbeit früher. Für Streaming-Text gilt dieselbe Grenze. Laut Azure ändert Streaming den Zeitpunkt, zu dem das erste Token sichtbar wird, nicht aber die Zeit, die für die vollständige Sequenz benötigt wird.
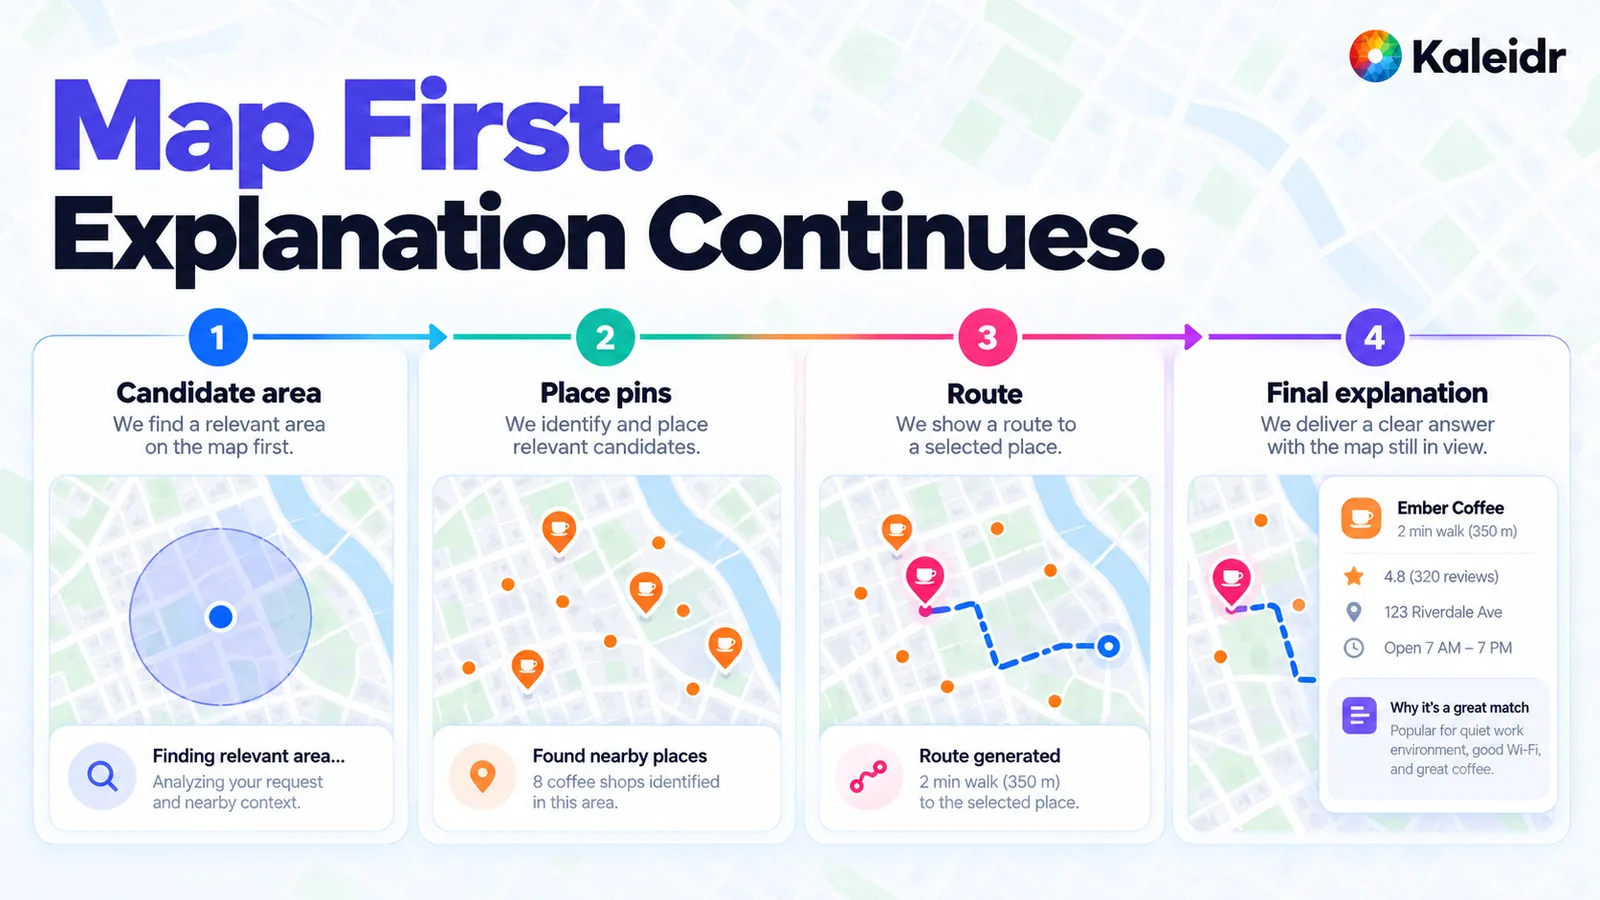
Die Sequenz besteht aus einem Kandidatengebiet, dann Pins, dann einer Route und schließlich einer kurzen Erklärung. Die Anzahl der Geschäfte, der Zwei-Minuten-Fußweg, die Bewertung, die Adresse und die Öffnungszeiten sind Beispielbeschriftungen in der Grafik und keine Live-Abfrage. Pins und Route in diesem Muster gehören zu Orten, die die Eignungsprüfung bereits bestanden haben. Ein früher Marker ersetzt diese Prüfung nicht.
Kaleidrs öffentlicher Stream verwendet Server-Sent Events, text/event-stream, und der Vertrag benennt, was vor Ende des Fließtexts eintreffen kann (Kaleidr, 2026). Das phase-Event bedeutet, dass die Anfrage angenommen wurde und die Arbeit begonnen hat; sein Phasenwert ist immer thinking. Nach 10 Sekunden Stille trifft ein : keep-alive-Kommentar ein. Bei einer schwierigen Frage können bis zum ersten Fließtext mehrere zehn Sekunden vergehen, weshalb das Phase-Event und der Heartbeat existieren. Bei einer Richtungsfrage kann eine route vor dem Fließtext eintreffen, sodass die Linie gezeichnet werden kann, während der Text streamt. early_actions enthält Kartenaktionen, die vor Abschluss der Antwort angewendet werden können, und wird gesendet, sobald mindestens zwei Orte Koordinaten haben. Das end-Event ist das maßgebliche Ergebnis, und seine Aktionen ersetzen diese frühen Aktionen. Nicht jedes Event erscheint bei jeder Anfrage.
Wie sollte der Anfragegraph gezeichnet werden?
Zeichne zuerst die Abhängigkeiten und entferne dann Schritte, die die Antwort nicht verändern. Ortsauflösung und ein Geschäfts-Lesevorgang können nach der Autorisierung parallel laufen. Die Eignungsprüfung ist der Join. Routing und andere räumliche Arbeiten nutzen diesen Join. Ranking ordnet die verbleibenden Kandidaten. Die Generierung erklärt sie. Die Karte zeigt dieselben Kennungen. Generierung vor der Eignungsprüfung verschwendet Tokens für Orte, die das Produkt nicht empfehlen darf. Grounded Spatial AI for Business Data hält diese Eignungsprüfung in den Systemen, denen die Fakten gehören.
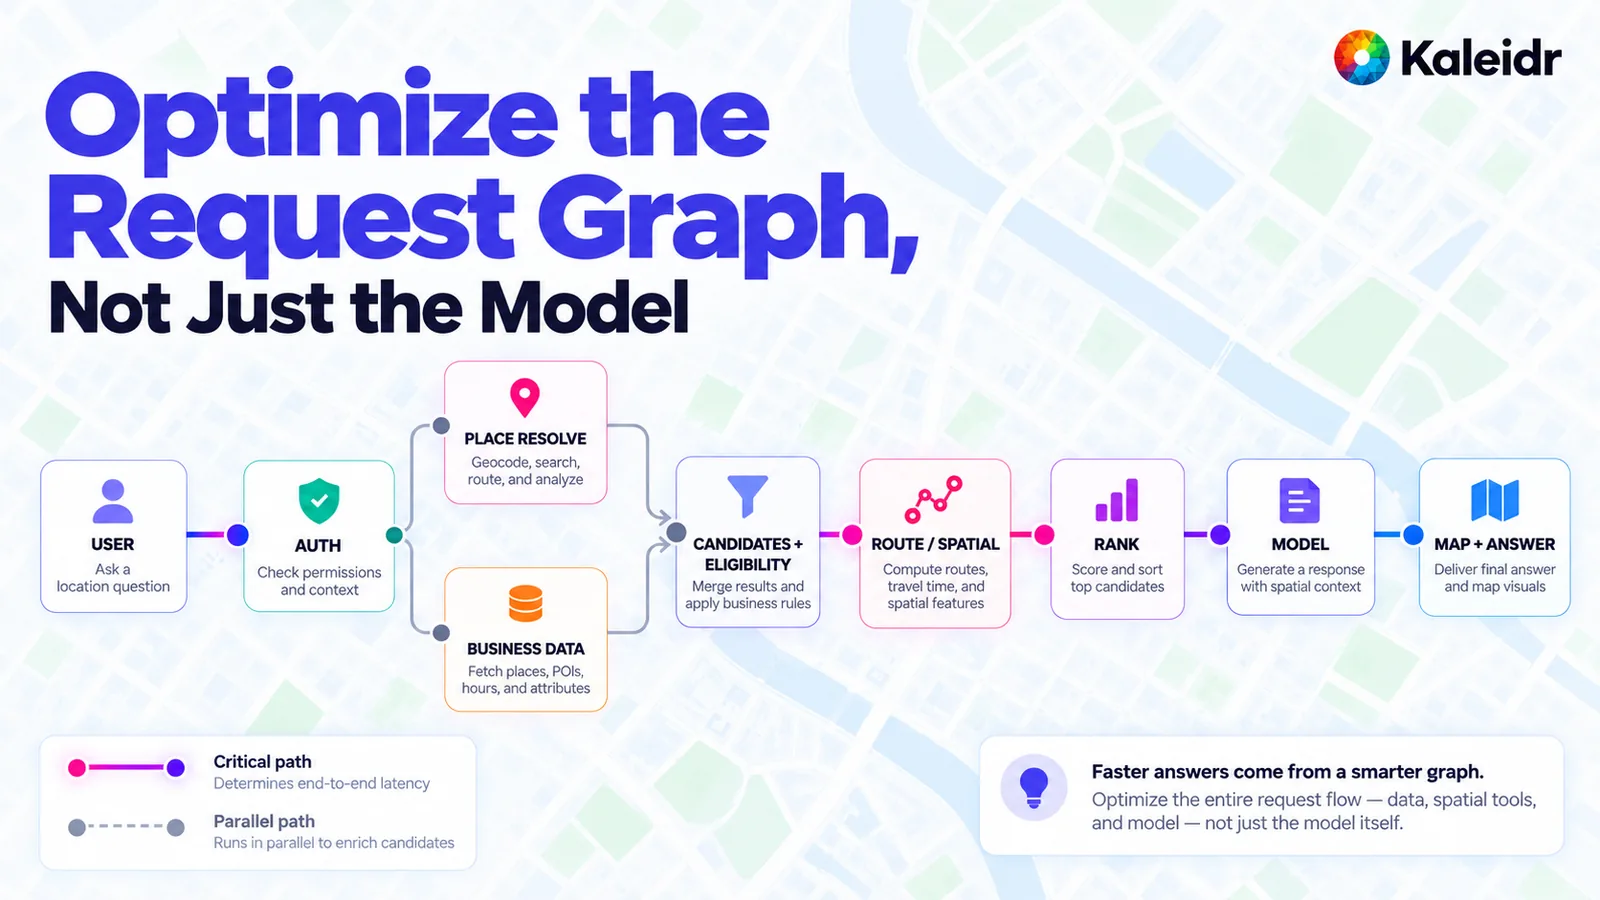
Die Autorisierung kommt zuerst. Ortsauflösung und Geschäfts-Lesevorgang sind das parallele Paar. Danach folgen Eignungsprüfung, Route, Ranking, Generierung und Karte. Die durchgezogene Linie ist der kritische Pfad, die gestrichelte Linie der überlappende Lesevorgang. Die Abbildung plädiert dafür, den gesamten Graphen zu zeichnen. Sie berichtet keine gemessene Einsparung und zeigt keinen privaten Datensatz, der die Autorisierung umgeht.
Derselbe Graph zeigt, wo ein Sprachmodell das falsche Werkzeug ist. Ein Containment-Test, eine Autorisierungsprüfung, ein „jetzt geöffnet“-Filter und ein Distanzschwellenwert sind deterministisch. Das Modell ist nützlich, um die Anfrage zu lesen, ein von den Diensten bereits berechnetes Ergebnis zu erklären und weiche Präferenzen unter geeigneten Orten zu ranken. OpenAIs Latenzleitfaden zieht dieselbe Grenze allgemein: Eine klassische Methode ist die schnellere Wahl, wenn die Aufgabe kein sprachliches Schlussfolgern benötigt. Ein Prompt, der alle sprachlichen Schritte zurückgibt, kann auch schneller sein als eine Kette von Modellaufrufen, weil jeder zusätzliche Aufruf einen weiteren Roundtrip bezahlt. Route, Bestand und Berechtigung stammen weiterhin aus ihren eigenen Diensten.
Warum kann der Durchschnitt langsame Anfragen verbergen?
Der Mittelwert fasst Wartezeit schlecht zusammen, weil wenige langsame Anfragen das prägen, woran sich Menschen erinnern. Berichte für jeden Span Median, 95. Perzentil und 99. Perzentil, aufgeschlüsselt nach Anfrageklasse. Eine Richtungsfrage und eine kurze Ortsfrage gehören nicht in denselben Topf. Der lange Rand kann durch Fan-out über Tools, einen Retry, einen großen Prompt, Unterschiede zwischen Anbietern oder eine lange generierte Antwort entstehen. Azures Formel sagt bereits, dass der letzte Punkt mit der Anzahl der Ausgabetokens wächst. Die anderen Ursachen erscheinen nicht in der Tokenzahl, deshalb müssen die Spans getrennt bleiben.
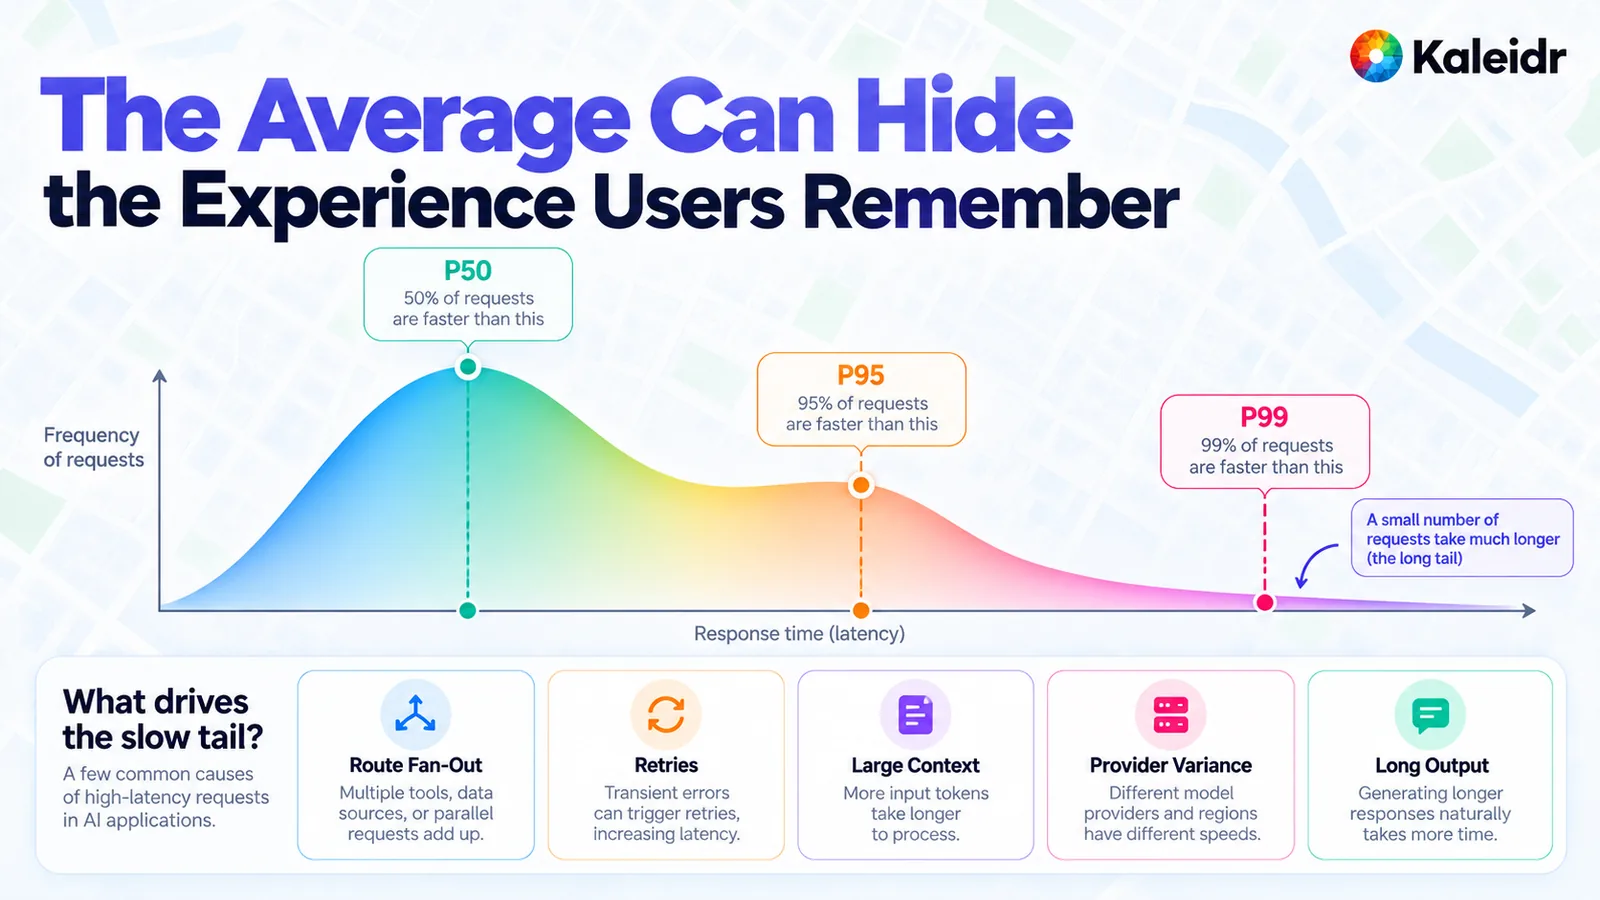
Die Kurve zeigt eine Form und ist weder ein Kaleidr-Trace noch eine Stichprobe aus einem Anbieter-Dashboard. Die Beschriftungen verwenden die übliche Interpretation der Perzentile: die Hälfte der Anfragen liegt höchstens beim Median, die meisten höchstens beim 95. und nahezu alle höchstens beim 99. Perzentil. Die fünf Ursachen unter dem Diagramm sind eine Checkliste möglicher Untersuchungsstellen. Sie sind keine gemessenen Anteile des Kaleidr-Traffics.
Eine Tail-Policy sollte festlegen, was das Produkt tut, wenn ein Span sein Budget verfehlt. Ein Routing-Timeout bleibt unbekannt, und die Erklärung sagt, dass die Route nicht verfügbar war. Ein Inventory-Timeout bleibt unbekannt, statt zu „nicht auf Lager“ zu werden. Ein Retry gehört in den Trace, damit ein vorübergehender Fehler nicht mit einem langsamen Modell verwechselt wird. Den Median zu optimieren, während das 99. Perzentil den Nutzer weiter vor einem Spinner warten lässt, ist kein abgeschlossenes Performance-Programm.
Welche Phasen gehören ins Budget?
Benenne die Phasen, bevor du jemandem ein Ziel zuweist. Ein praktisches Budget hat sieben Zeilen: Anfrage in der Oberfläche annehmen, Identität und Autorisierung prüfen, Kontext abrufen, Route oder Distanz berechnen, Erklärung erzeugen, Kartenaktion anwenden und Geschäftsaktion abschließen. Einige Zeilen überlappen sich, wie der Anfragegraph zeigt. Manche Anfragen erreichen nie eine Buchung oder Übergabe. Die Liste dient dazu zu sehen, welche Zeile sich verändert hat; sie behauptet weder, dass jede Frage alle sieben Schritte seriell durchläuft, noch setzt sie Millisekunden-Ziele.
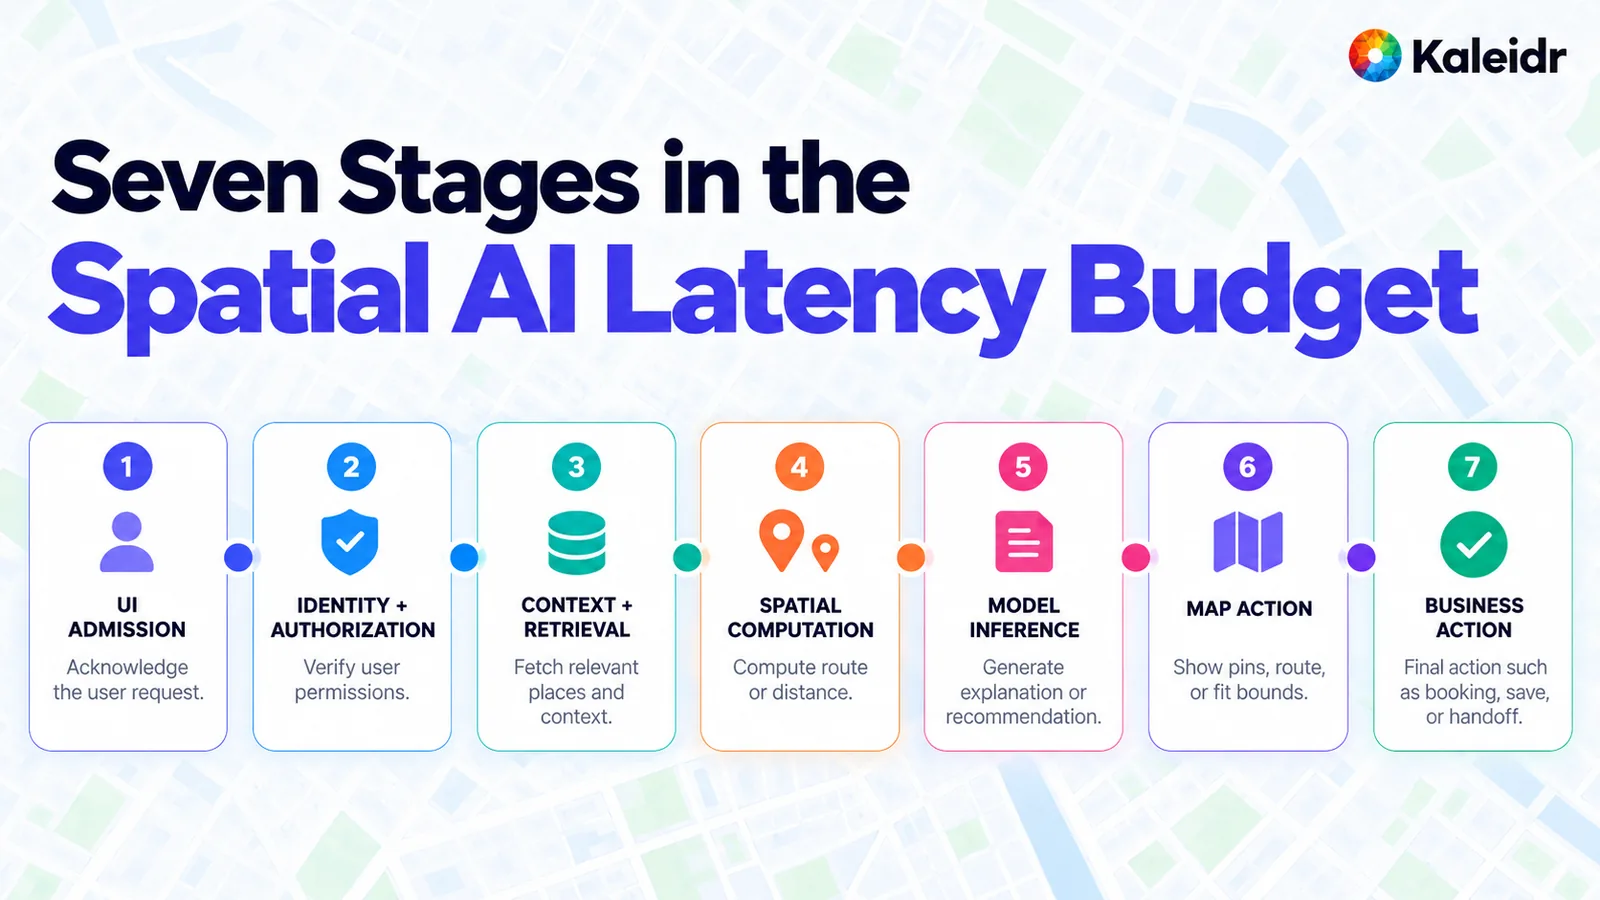
Jede Phase hat eine Aufgabe und keine Dauer. Die Annahme der Anfrage ist Arbeit des Browsers. Autorisierung kommt vor privaten Daten. Retrieval, räumliche Berechnung und Generierung sind getrennte Zeilen. Die Kartenaktion zeigt einen Pin, eine Route oder eine angepasste Ansicht. Die Geschäftsaktion ist die Übergabe und entfällt, wenn die Frage keine verlangt. Die Abbildung setzt kein numerisches Ziel.
Setze für eine Phase erst dann ein Ziel, wenn der Trace zeigt, dass Nutzer genau auf diese Phase warten. Eine universelle Zahl wie „Antworten in zwei Sekunden“ würde Klick, Route und Absatz vermischen, und dieser Artikel zitiert keine solche Zahl. Der oben genannte INP-Schwellenwert ist ein Browserziel. Die obige Tokenformel beschreibt die Modellzeit. Time to first spatial action ist das Kartenziel und bleibt eine redaktionelle Metrik, bis ein Team sie in eigenen Traces definiert.
Wo sollte ein Team anfangen?
Beginne damit, die Wartezeit aufzuteilen. Erfasse Interaction to Next Paint für die Seite, Time to first progress, Time to first token, Time to first spatial action, Time to last token und Time to completed action. Kennzeichne die drei redaktionellen Begriffe weiterhin als Produktmetriken. Lies p50, p95 und p99 nach Anfrageklasse. Kürze die generierte Antwort, wenn die Karte die Details bereits zeigt. Überlappe nur Lookups, die nicht voneinander abhängen. Validiere erneut alles, was die Entscheidung verändern kann. Lass das end-Event und nicht den ersten Pin das Ergebnis sein, auf das der Nutzer handeln darf.
Erkunde Kaleidr Enterprise, wenn dieser Pfad die eigenen Orte und Regeln der Organisation einbeziehen muss. Der SSE wire contract ist die oben zitierte Event-Reihenfolge einschließlich Phase-Event, Keep-alive, frühen Kartenaktionen und Endergebnis.
Hinweis: Kaleidr verwendet KI-gestützte Werkzeuge für Bilderstellung, Inhaltsverfeinerung und Recherche in seinen kreativen und Entwicklungs-Workflows.
FAQs
Was ist Spatial-AI-Latenz?
Spatial-AI-Latenz ist die Zeit von einer Standortfrage bis zu nützlichem Kartenfeedback. Sie umfasst Oberfläche, Autorisierung, Retrieval, räumliche Berechnung, Generierung, Kartenaktion und jede geschäftliche Übergabe. Sie ist nicht dieselbe Zahl wie die Modellzeit.
Ist Interaction to Next Paint dasselbe wie Modelllatenz?
Nein. Interaction to Next Paint misst, wie schnell die Seite auf einen Klick reagiert. Ein guter Wert von höchstens 200 Millisekunden beim 75. Perzentil der Seitenaufrufe sagt nichts darüber aus, wann eine Route oder ein Absatz fertig sein wird.
Was ist Time to first token?
Time to first token ist die Zeit vom Absenden eines Prompts bis zur Rückgabe des ersten generierten Tokens. Azure OpenAI verwendet sie zusammen mit der Zeit zwischen Tokens und der Anzahl generierter Tokens, um Time to last token zu beschreiben.
Warum reicht das erste Token für eine Karte nicht aus?
Eine Karte ist nützlich, wenn ein geeigneter Ort oder eine Route sichtbar ist. Dieser Moment kann vor dem ersten Token oder lange danach eintreten. Time to first spatial action erfasst den Kartenmoment. Time to first token erfasst den Textmoment.
Macht Streaming das Routing schneller?
Nein. Streaming verändert, wann fertige Arbeit sichtbar wird. Es verkürzt nicht die Zeit für eine Route, ein Retrieval oder die vollständige Generierung. Azures Latenzartikel sagt, dass Streaming die Zeit zur Erzeugung aller Tokens nicht verändert.
Was sendet Kaleidr, bevor die Antwort endet?
Der öffentliche Stream kann ein phase-Event mit dem Wert thinking, ein Keep-alive während Stille, eine route vor dem Fließtext bei einer Richtungsfrage und early_actions senden, sobald mindestens zwei Orte Koordinaten haben. Das end-Event ist maßgeblich und ersetzt die frühen Aktionen. Nicht jedes Event erscheint bei jeder Anfrage.
Sollte privater Bestand zur Latenzreduzierung gecacht werden?
Nein. Bestand, Autorisierung, eine Live-Position und Transaktionsstatus sollten zum Entscheidungszeitpunkt erneut validiert werden. Ein Timeout bleibt unbekannt. Stabile Ortskennungen sind die üblichen Kandidaten für langlebiges Caching, und auch das nur innerhalb der Anbieterbedingungen.
Welches Perzentil sollte ein Team beobachten?
Beobachte Median, 95. Perzentil und 99. Perzentil für jeden Span, getrennt nach Anfrageklasse. Der Median kann sich verbessern, während der langsame Rand, an den sich Nutzer erinnern, unverändert bleibt.
References
- web.dev. Interaction to Next Paint (INP). A good INP is at or below 200 milliseconds at the 75th percentile of page loads recorded in the field. An INP above 200 milliseconds and at or below 500 milliseconds needs improvement. Updated September 2, 2025. https://web.dev/articles/inp
- Microsoft. Azure OpenAI in Microsoft Foundry Models performance & latency. Time to last token equals time to first token plus the time between tokens multiplied by tokens generated. Streaming returns tokens as they are ready and does not change the time required to produce all of them. Accessed October 31, 2026. https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/latency
- OpenAI. Latency optimization. A stated heuristic: cutting about half of the output tokens may cut about half of the latency. Accessed October 31, 2026. https://developers.openai.com/api/docs/guides/latency-optimization
- Kaleidr Developer Docs. SSE wire contract. Documents
text/event-stream, aphaseevent that is alwaysthinking, a keep-alive after 10 seconds of silence, tens of seconds before first prose on a hard question,early_actionsonce two or more places have coordinates, aroutebefore the prose on a directions question, andendas the authoritative result. Accessed October 31, 2026. https://docs.kaleidr.com/platform-api/sse-wire-contract - Kaleidr. Spatial AI Observability. A related guide for recording each stage, including a structured reason when the result is empty. Accessed October 31, 2026. https://kaleidr.com/blog/spatial-ai-observability
- Kaleidr. Spatial Context Engineering for Map-Aware AI. A related guide for which facts reach the model after eligibility. Accessed October 31, 2026. https://kaleidr.com/blog/spatial-context-engineering
- Kaleidr. Grounded Spatial AI for Business Data. A related guide for keeping business facts in the systems that own them. Accessed October 31, 2026. https://kaleidr.com/blog/grounded-spatial-ai-business-data
References in BibTeX
@misc{webdev_inp_2025,
  title  = {Interaction to Next Paint (INP)},
  author = {{web.dev}},
  year   = {2025},
  url    = {https://web.dev/articles/inp}
}

@misc{microsoft_azure_openai_latency_2026,
  title  = {Azure OpenAI in Microsoft Foundry Models performance \& latency},
  author = {{Microsoft}},
  year   = {2026},
  url    = {https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/latency}
}

@misc{openai_latency_optimization_2026,
  title  = {Latency optimization},
  author = {{OpenAI}},
  year   = {2026},
  url    = {https://developers.openai.com/api/docs/guides/latency-optimization}
}

@misc{kaleidr_sse_wire_contract_2026,
  title  = {SSE wire contract},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://docs.kaleidr.com/platform-api/sse-wire-contract}
}

@misc{kaleidr_spatial_ai_observability_2026,
  title  = {Spatial AI Observability},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-ai-observability}
}

@misc{kaleidr_spatial_context_engineering_2026,
  title  = {Spatial Context Engineering for Map-Aware AI},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-context-engineering}
}

@misc{kaleidr_grounded_spatial_ai_2026,
  title  = {Grounded Spatial AI for Business Data},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/grounded-spatial-ai-business-data}
}