
A latência de Spatial AI é o tempo entre uma pergunta de localização e o primeiro retorno útil no mapa, e não é um único cronômetro do modelo. A espera pode incluir autorização, recuperação, uma rota e os tokens gerados por um modelo de linguagem. Um modelo rápido ainda pode ficar atrás de uma rota lenta. Um parágrafo final mais demorado ainda pode parecer responsivo quando um local elegível ou uma rota aparece primeiro.
O que a latência de Spatial AI inclui?
Uma pergunta de localização atravessa vários relógios, e reduzi-los a uma única “latência de AI” esconde a etapa que o usuário realmente está esperando. A responsividade do navegador é a rapidez com que a página reage a um clique. Time to first progress é quando a interface mostra que o trabalho começou. Time to first token é quando a geração produz seu primeiro token. Time to first spatial action é quando um local elegível ou uma rota se torna visível. Time to last token é quando a geração termina. Time to completed action é quando o usuário pode confiar no resultado.
Time to first progress, time to first spatial action e time to completed action são nomes da Kaleidr para a experiência do produto. Esses três nomes não são padrões da Web. Time to first token e time to last token são métricas estabelecidas de modelos.
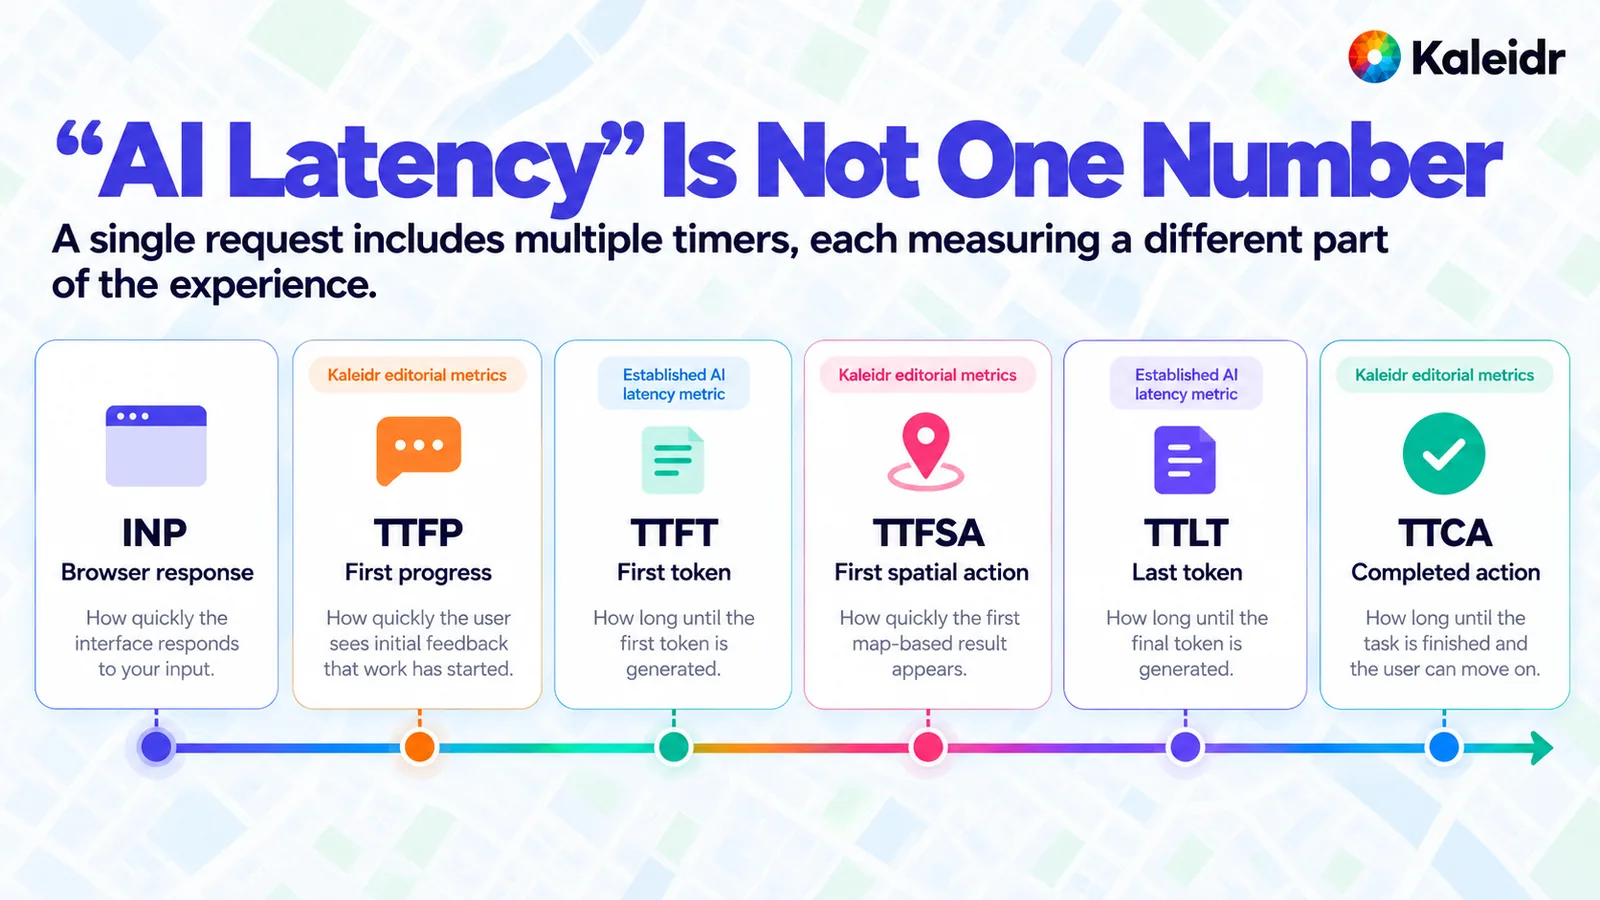
Os seis cartões separam a resposta do navegador do restante da solicitação. Time to first progress, time to first spatial action e time to completed action aparecem como métricas editoriais da Kaleidr. Time to first token e time to last token aparecem como métricas estabelecidas de latência do modelo. Interaction to Next Paint é a métrica do navegador. Nenhum dos cartões relata uma medição da Kaleidr.
As orientações de desempenho Web do Google tratam Interaction to Next Paint como responsividade em campo e consideram bom um INP de 200 milissegundos ou menos no 75º percentil dos carregamentos de página (web.dev, 2025). Esse limite diz respeito à próxima pintura após um clique, não a uma rota ou a um parágrafo gerado. Uma página pode passar nesse teste e ainda deixar o usuário esperando pela recuperação. Uma chamada lenta ao modelo, sozinha, não torna o INP ruim. Os dois orçamentos devem ser acompanhados separadamente, ou uma equipe pode “corrigir a latência de AI” ajustando um manipulador de clique que nunca esteve no caminho crítico.
Por que o caminho crítico importa?
O caminho crítico é a cadeia mais longa de etapas que precisam terminar em ordem. Consultas independentes podem se sobrepor. Uma rota que precisa tanto de um local resolvido quanto de um fato de negócio não pode começar até que os dois existam. Serializar essas consultas soma seus tempos. Executá-las juntas remove apenas a sobreposição e não torna a rota em si mais rápida. A autorização ainda vem antes de qualquer registro privado ser mostrado.
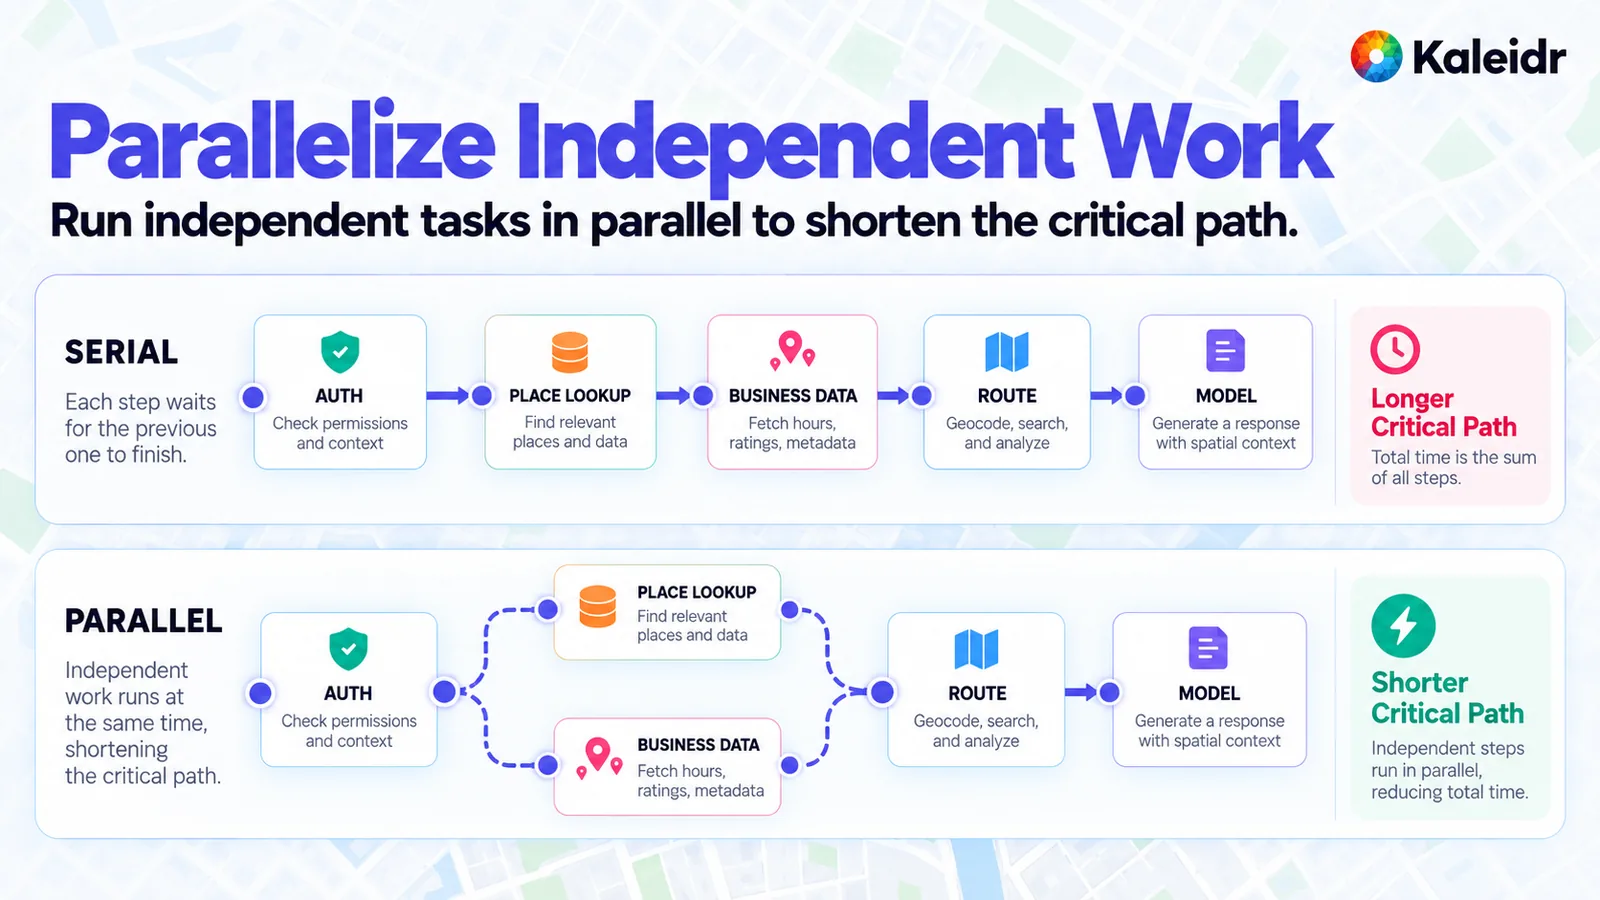
A linha superior espera cada etapa terminar antes de iniciar a próxima. A linha inferior executa a consulta de local e os dados de negócio ao mesmo tempo e depois os une para a rota e o modelo. A figura descreve a forma da espera. O desenho não relata um ganho de velocidade medido, e a rota ainda depende das duas consultas.
Um trace útil nomeia o span, não o produto. Geocodificação, uma leitura de negócio, uma rota, ranking e geração podem ser, cada um, o span lento em perguntas diferentes. Spatial AI Observability é o guia complementar para registrar esses spans separadamente, incluindo um motivo estruturado quando o resultado está vazio. Sem essa separação, uma tarde lenta parece que “o modelo piorou” quando, na verdade, foi o serviço de rotas que mudou.
Por que o primeiro token não é o primeiro resultado do mapa?
Time to first token e time to last token respondem a perguntas diferentes, e nenhum deles é o momento em que o mapa se torna útil. O Azure OpenAI documenta a relação assim: time to last token é igual a time to first token mais o tempo entre tokens multiplicado pelo número de tokens gerados (Microsoft, 2026). O mesmo artigo diz que cada token do prompt acrescenta pouco tempo em comparação com cada token gerado e que o streaming devolve tokens à medida que ficam prontos sem alterar o tempo necessário para produzir todos eles. O guia de latência da OpenAI apresenta uma heurística relacionada: reduzir aproximadamente pela metade os tokens de saída pode reduzir aproximadamente pela metade a latência (OpenAI, 2026). Assim, uma explicação curta pode terminar mais cedo. O cartão do mapa, e não o parágrafo, deve carregar o local, os horários e a rota.
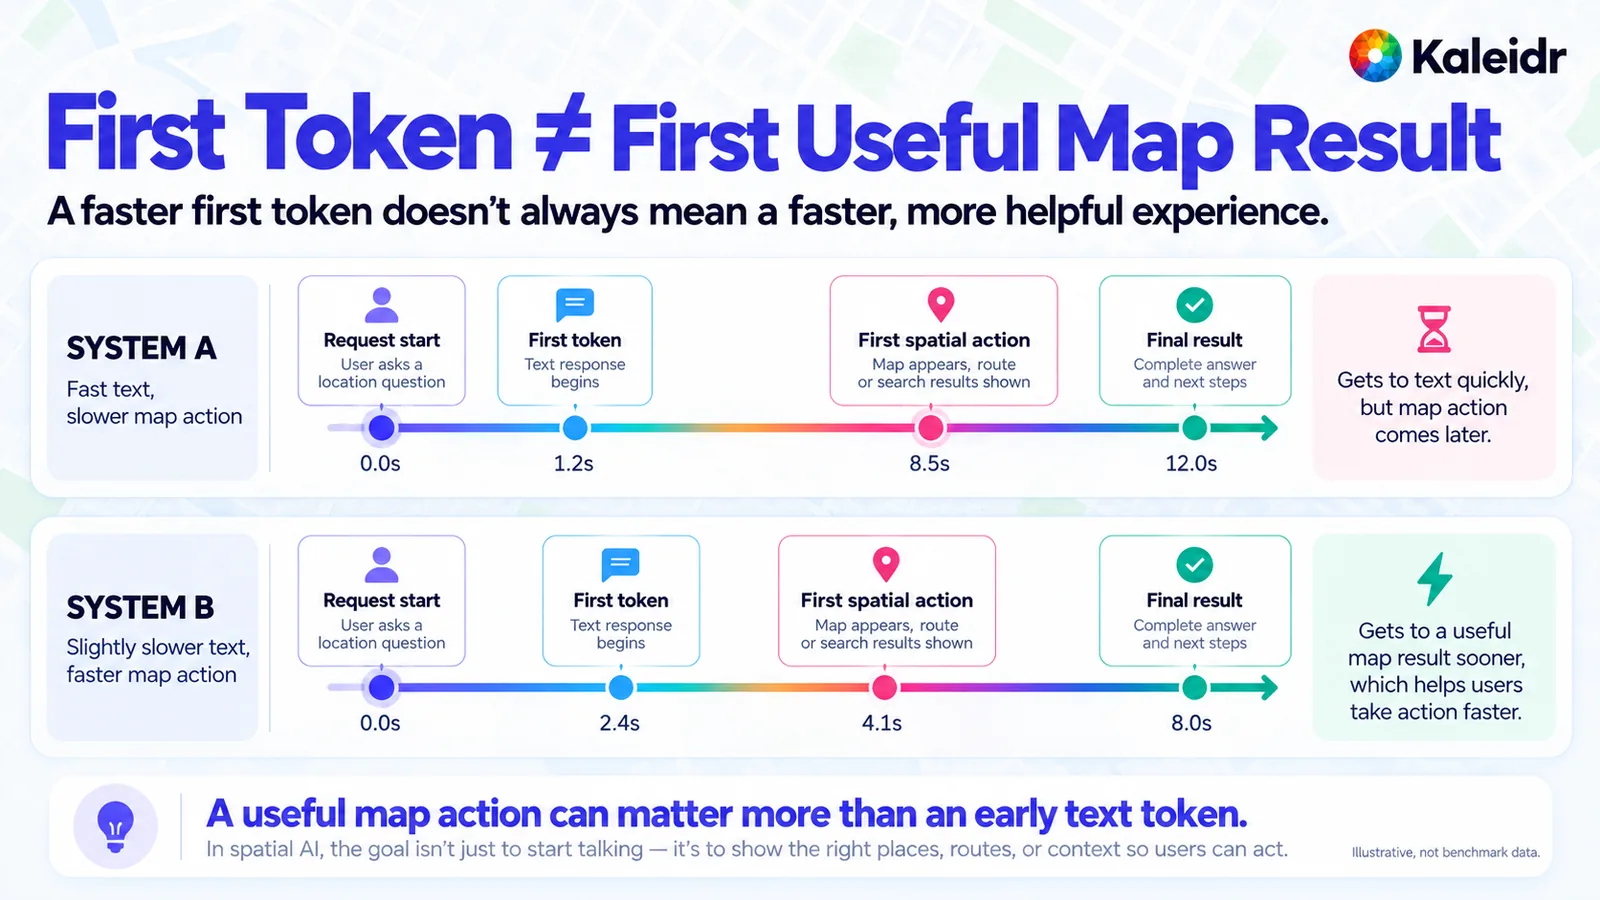
O sistema A mostra texto cedo e uma ação no mapa tarde. O sistema B mostra texto mais tarde e uma ação no mapa mais cedo. As marcações em segundos e os totais da figura são ilustrativos, e a arte informa que não são dados de benchmark. As marcações não são um trace da Kaleidr nem um resultado dos artigos do Azure ou da OpenAI. A comparação trata apenas da ordem: um token mais cedo não significa um mapa mais cedo.
A distinção importa para o que o produto valoriza. Um painel que classifique apenas por time to first token vai preferir o sistema que fala primeiro e desenha tarde. Um produto de mapas também deve registrar time to first spatial action, e só deve registrar essa ação depois que a elegibilidade tiver sido aprovada. Um pin antecipado para um local fechado ou não autorizado é um erro rápido. Spatial Context Engineering é a regra relacionada para definir quais fatos podem chegar ao modelo depois que o conjunto elegível existe.
O que pode ser armazenado em cache e o que deve ser revalidado?
Um cache economiza uma ida e volta apenas quando o valor salvo ainda é o valor correto. Identificadores estáveis e coordenadas de um local conhecido mudam raramente, por isso são candidatos comuns a um cache de longa duração. Horários, uma rota calculada e texto descritivo mudam com frequência suficiente para que um tempo de vida curto seja a política honesta. Inventário, posição de veículo, autorização e estado de transação devem ser lidos novamente no momento da decisão. Um “em estoque” armazenado de manhã não é evidência para a tarde.
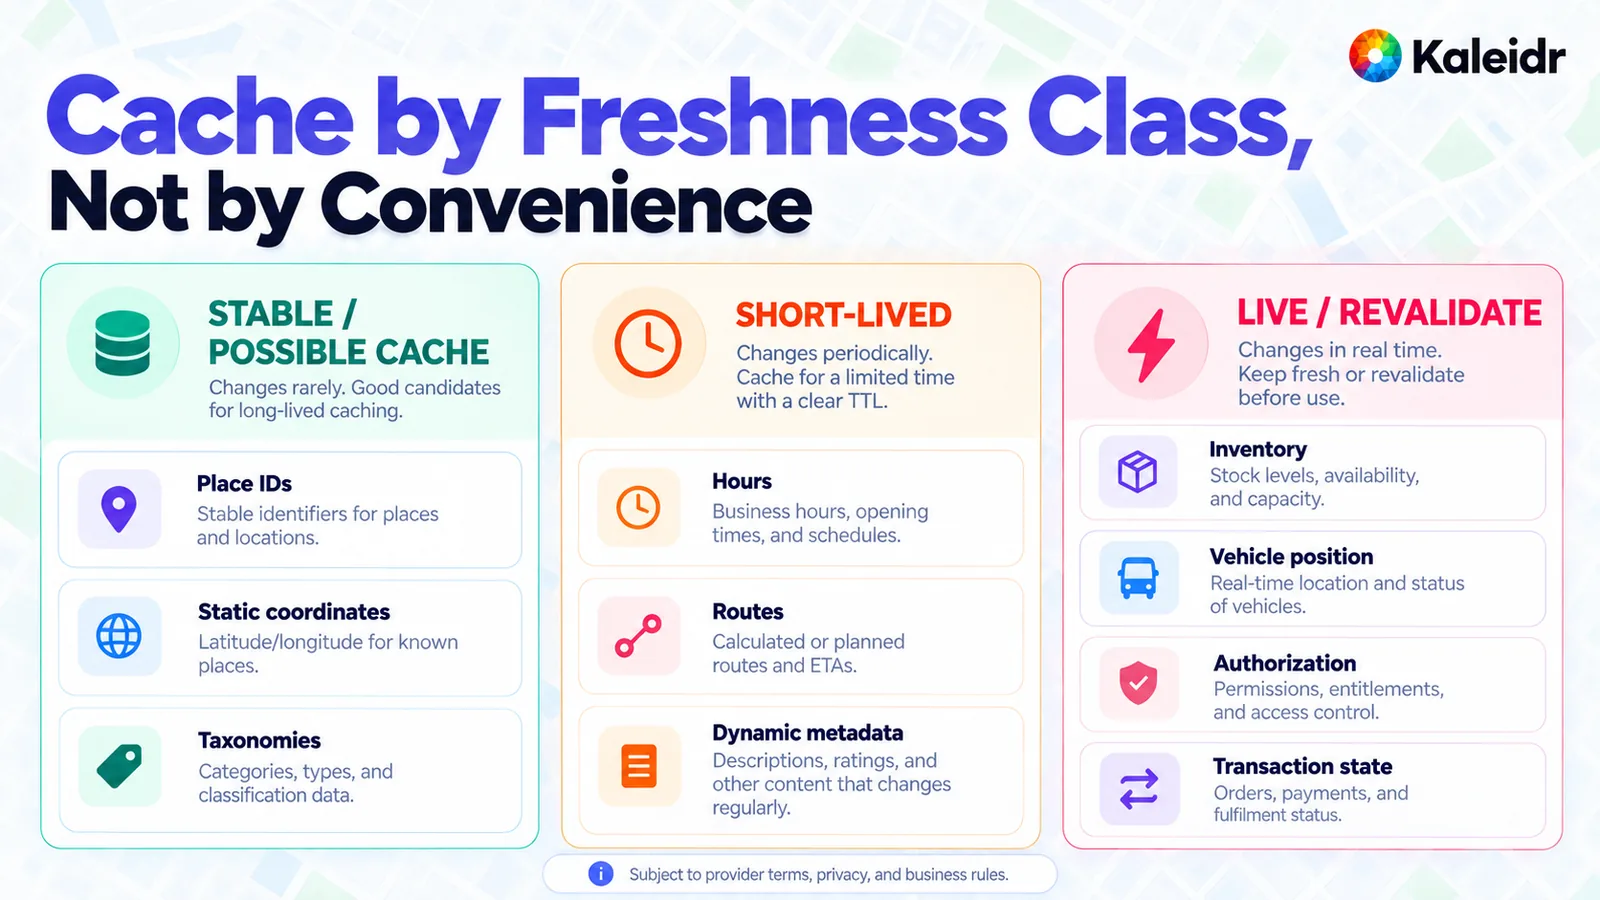
A coluna esquerda contém o que raramente muda. A coluna do meio precisa de uma vida curta. A coluna direita deve ser revalidada antes do uso. O rodapé da figura diz que as classes estão sujeitas aos termos do provedor, à privacidade e às regras de negócio. Uma rota na coluna do meio é um cálculo em cache, não uma promessa de que a estrada continua aberta. Nada na figura é uma política de cache da Kaleidr.
Dados de lugares de um provedor acrescentam uma segunda restrição. Os termos que vieram com o registro continuam valendo para uma cópia, incluindo atribuição e qualquer restrição de uso. Registros privados acrescentam uma terceira: um cache compartilhado entre usuários não pode virar uma forma de contornar a autorização. Desconhecido continua desconhecido. Um timeout de inventário não autoriza a mostrar “sem estoque”, e um timeout de rota não autoriza a inventar os minutos.
Quando o mapa pode se mover antes de a explicação terminar?
A ordem útil em um mapa costuma ser local, depois rota e então a frase que os explica. O usuário pode examinar um candidato elegível enquanto o modelo de linguagem ainda está escrevendo. Esse padrão não torna a recuperação nem o roteamento mais rápidos. Ele apenas revela trabalho que já terminou. O texto em streaming tem o mesmo limite. A orientação do Azure é que o streaming muda quando o primeiro token fica visível, não o tempo necessário para gerar a sequência completa.
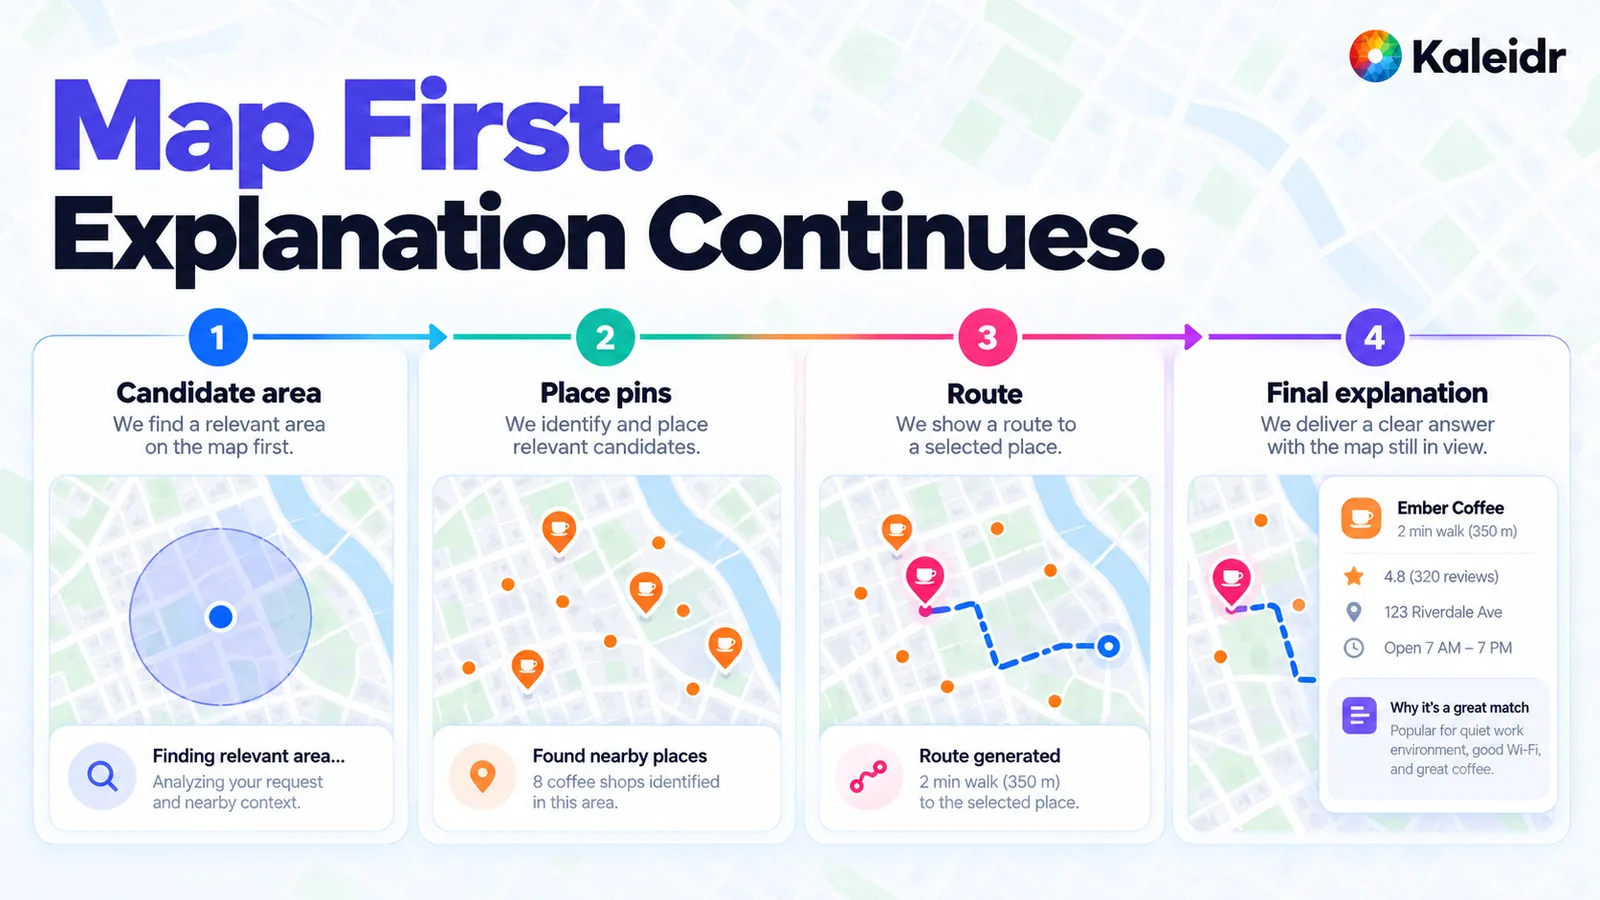
A sequência é uma área candidata, depois pins, depois uma rota e, por fim, uma explicação curta. A quantidade de lojas, a caminhada de dois minutos, a avaliação, o endereço e os horários são rótulos de exemplo na arte, não uma consulta ao vivo. Os pins e a rota desse padrão correspondem a locais que já passaram pela elegibilidade. Um marcador antecipado não substitui essa verificação.
O stream público da Kaleidr usa Server-Sent Events, text/event-stream, e o contrato define o que pode chegar antes de o texto terminar (Kaleidr, 2026). O evento phase significa que a solicitação foi aceita e que o trabalho começou, e seu valor de fase é sempre thinking. Um comentário : keep-alive chega após 10 segundos de silêncio. Em uma pergunta difícil, o primeiro texto pode levar dezenas de segundos, por isso o evento phase e o heartbeat existem. Em uma pergunta de direções, uma route pode chegar antes do texto, permitindo desenhar a linha enquanto o texto é transmitido. early_actions transporta ações de mapa que podem ser aplicadas antes de a resposta terminar e é enviado quando dois ou mais locais têm coordenadas. O evento end é o resultado autoritativo, e suas ações substituem essas ações iniciais. Nem todos os eventos aparecem em todas as solicitações.
Como o grafo da solicitação deve ser desenhado?
Desenhe as dependências e depois remova as etapas que não mudam a resposta. A resolução do local e uma leitura de negócio podem rodar juntas após a autorização. A elegibilidade é a junção. O roteamento e outros trabalhos espaciais usam essa junção. O ranking ordena os sobreviventes. A geração os explica. O mapa mostra os mesmos identificadores. Colocar a geração antes da elegibilidade gasta tokens em locais que o produto não pode recomendar. Grounded Spatial AI for Business Data mantém essa elegibilidade nos sistemas que são donos dos fatos.
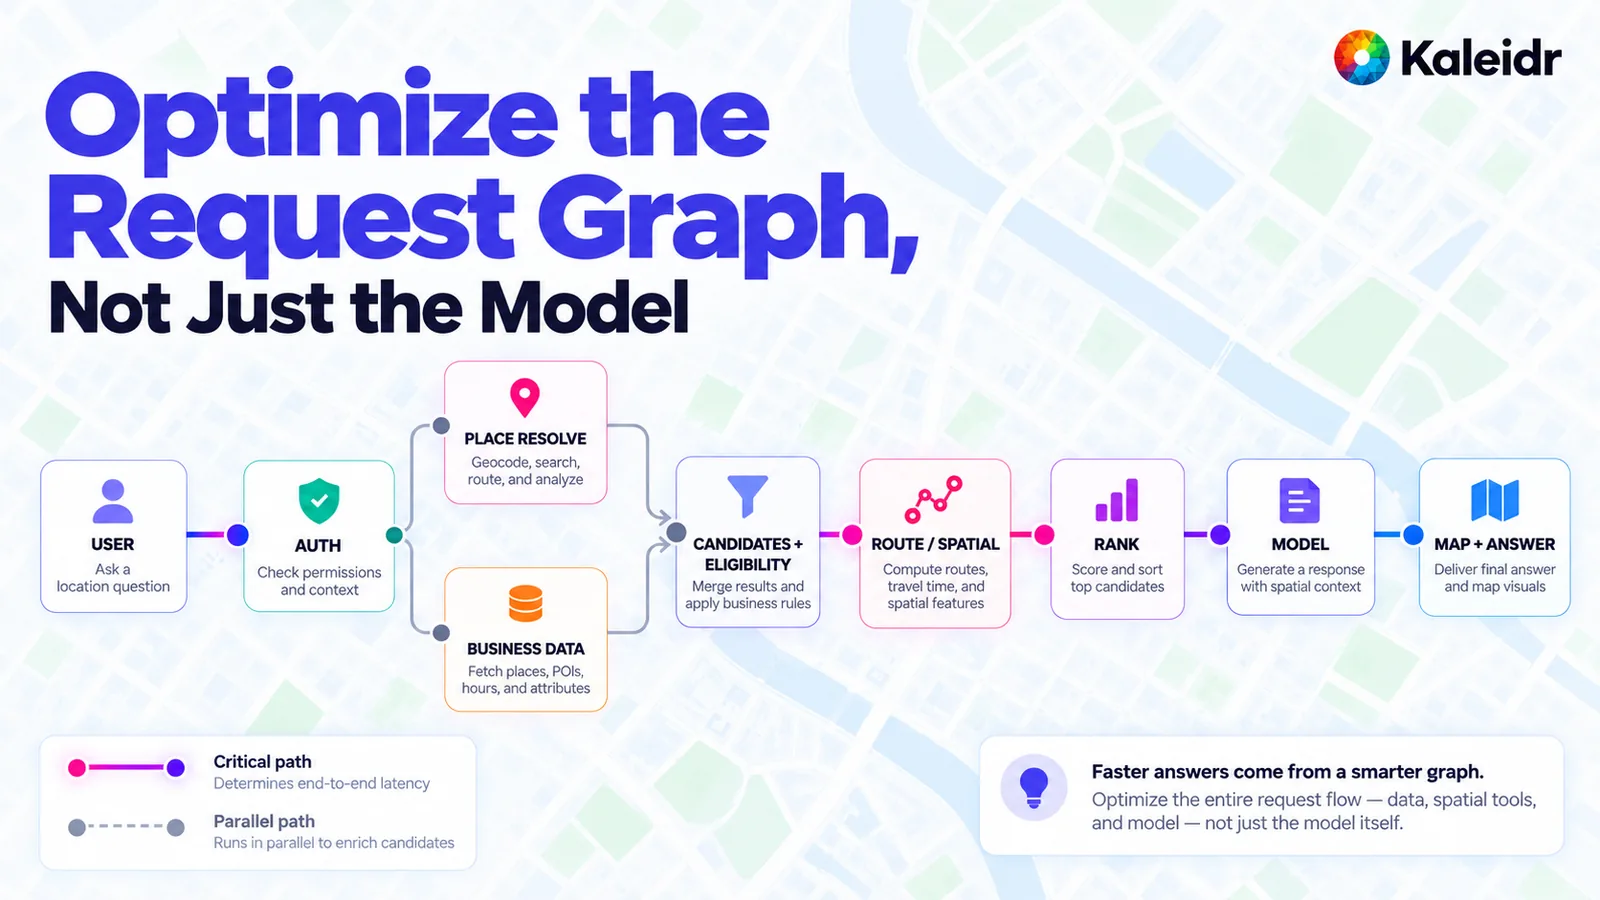
A autorização vem primeiro. A resolução do local e a leitura de negócio formam o par paralelo. Depois vêm elegibilidade, rota, ranking, geração e mapa. A linha contínua é o caminho crítico e a linha tracejada é a leitura sobreposta. A figura defende desenhar o grafo inteiro. Ela não relata uma economia medida e não mostra um registro privado atravessando a autorização.
O mesmo grafo mostra onde um modelo de linguagem é a ferramenta errada. Um teste de contenção, uma verificação de autorização, um filtro “aberto agora” e um limite de distância são determinísticos. O modelo é útil para ler a solicitação, explicar um resultado que os serviços já calcularam e classificar preferências flexíveis entre locais elegíveis. O guia de latência da OpenAI faz a mesma separação em termos gerais: um método clássico é a opção mais rápida quando a tarefa não precisa de raciocínio linguístico. Um único prompt que devolve todas as etapas de linguagem também pode superar uma cadeia de chamadas ao modelo, porque cada chamada extra paga outra ida e volta. A rota, o estoque e a permissão continuam vindo de seus próprios serviços.
Por que a média pode esconder solicitações lentas?
A média resume mal uma espera porque algumas solicitações lentas dominam o que as pessoas lembram. Relate a mediana, o 95º percentil e o 99º percentil de cada span, separados por classe de solicitação. Uma pergunta de direções e uma pergunta curta sobre um local não pertencem ao mesmo grupo. A cauda pode vir de fan-out entre ferramentas, uma nova tentativa, um prompt grande, uma diferença entre provedores ou uma resposta gerada longa. A fórmula do Azure já diz que o último caso cresce com os tokens de saída. Os outros não aparecerão em uma contagem de tokens, por isso os spans precisam ficar separados.
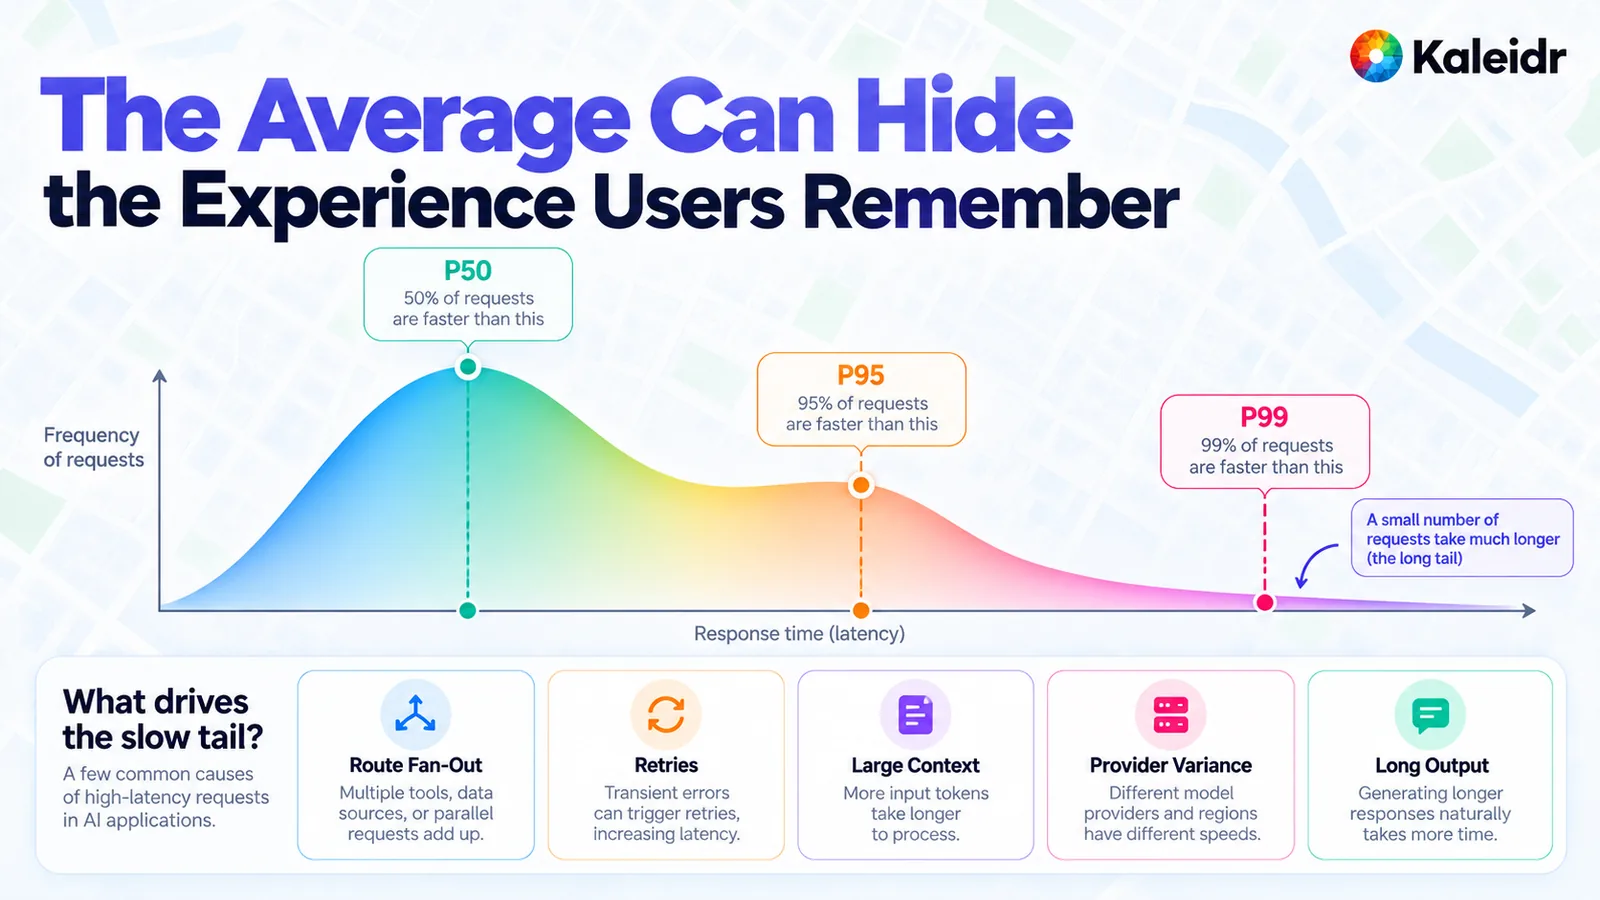
A curva é uma forma, não um trace da Kaleidr nem uma amostra de um painel de provedor. Os rótulos usam a leitura comum desses percentis: metade das solicitações na mediana ou abaixo, a maioria no 95º percentil ou abaixo e quase todas no 99º percentil ou abaixo. As cinco causas abaixo do gráfico são uma lista de lugares a investigar. Elas não são participações medidas do tráfego da Kaleidr.
Uma política de cauda deve dizer o que o produto faz quando um span perde seu orçamento. Um timeout de rota continua desconhecido, e a explicação diz que a rota estava indisponível. Um timeout de inventário continua desconhecido, em vez de virar “sem estoque”. Uma nova tentativa pertence ao trace para que uma falha transitória não seja confundida com um modelo lento. Otimizar a mediana enquanto o 99º percentil continua deixando o usuário diante de um spinner não é um programa de desempenho concluído.
Quais etapas pertencem ao orçamento?
Nomeie as etapas antes de atribuir uma meta. Um orçamento prático tem sete linhas: admitir a solicitação na interface, verificar identidade e autorização, recuperar contexto, calcular a rota ou a distância, gerar a explicação, aplicar a ação do mapa e concluir a ação de negócio. Algumas linhas se sobrepõem, como mostra o grafo da solicitação. Algumas solicitações nunca chegam a uma reserva ou a um handoff. A lista serve para ver qual linha mudou, não para afirmar que toda pergunta executa as sete em série nem para definir metas em milissegundos.
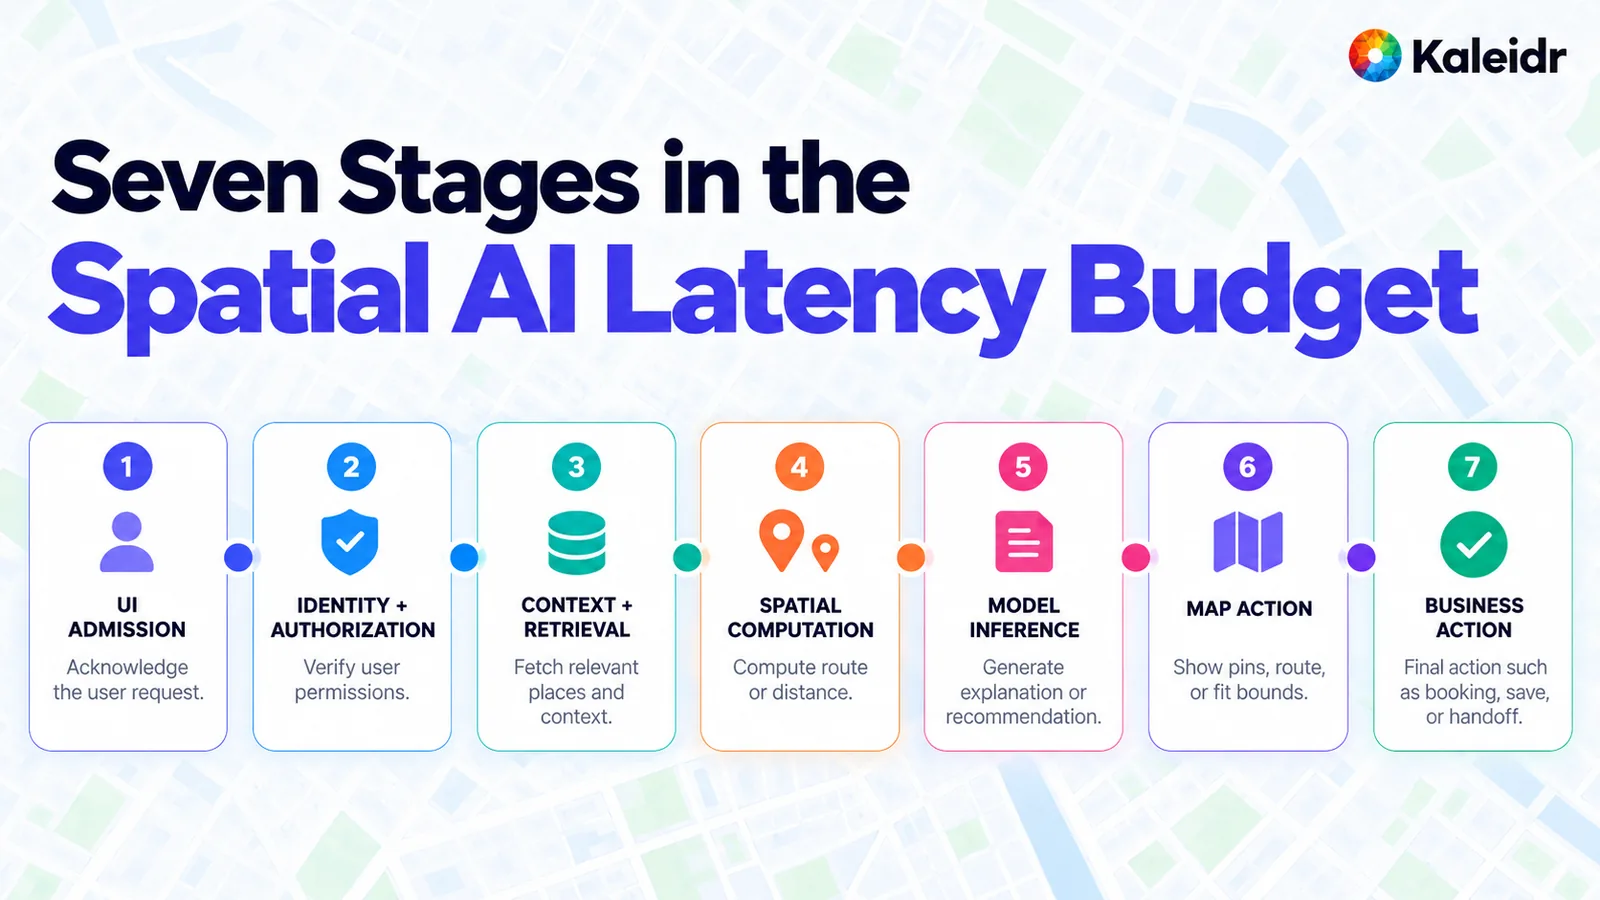
Cada etapa tem um trabalho e nenhuma duração. Admitir a solicitação é trabalho do navegador. A autorização precede os dados privados. Recuperação, cálculo espacial e geração são linhas separadas. A ação do mapa mostra um pin, uma rota ou uma vista ajustada. A ação de negócio é o handoff e não aparece quando a pergunta não pede um. A figura não define nenhuma meta numérica.
Só coloque uma meta em uma etapa depois que o trace mostrar que é nessa etapa que os usuários esperam. Um número universal como “respostas em dois segundos” misturaria o clique, a rota e o parágrafo, e este artigo não cita um valor assim. O limite de INP acima é uma meta do navegador. A fórmula de tokens acima descreve o tempo do modelo. Time to first spatial action é a meta do mapa e continua sendo uma métrica editorial até que uma equipe a defina em seus próprios traces.
Por onde uma equipe deve começar?
Comece separando a espera. Registre Interaction to Next Paint para a página, time to first progress, time to first token, time to first spatial action, time to last token e time to completed action. Mantenha os três nomes editoriais identificados como métricas de produto. Leia p50, p95 e p99 por classe de solicitação. Encurte a resposta gerada quando o mapa já mostrar o detalhe. Sobreponha apenas as consultas que não dependem umas das outras. Revalide tudo o que possa mudar a decisão. Deixe o evento end, e não o primeiro pin, ser o resultado em que o usuário pode agir.
Explore Kaleidr Enterprise quando esse caminho precisar incluir os próprios locais e regras da organização. O SSE wire contract é a ordem de eventos citada acima, incluindo o evento phase, o keep-alive, as ações iniciais do mapa e o resultado final.
Observação: a Kaleidr usa ferramentas assistidas por IA para criação de imagens, refinamento de conteúdo e pesquisa em seus fluxos criativos e de desenvolvimento.
Perguntas frequentes
O que é latência de Spatial AI?
A latência de Spatial AI é o tempo entre uma pergunta de localização e um retorno útil no mapa. Ela inclui a interface, autorização, recuperação, cálculo espacial, geração, ação do mapa e qualquer handoff de negócio. Não é o mesmo número que o tempo do modelo.
Interaction to Next Paint é o mesmo que latência do modelo?
Não. Interaction to Next Paint mede a rapidez com que a página responde a um clique. Um bom valor, de 200 milissegundos ou menos no 75º percentil dos carregamentos de página, não diz nada sobre quando uma rota ou um parágrafo terminará.
O que é time to first token?
Time to first token é o tempo entre o envio de um prompt e o retorno do primeiro token gerado. O Azure OpenAI usa essa métrica, junto com o tempo entre tokens e o número de tokens gerados, para descrever time to last token.
Por que o primeiro token não é suficiente para um mapa?
Um mapa é útil quando um local elegível ou uma rota está visível. Esse momento pode chegar antes do primeiro token ou muito depois. Time to first spatial action registra o momento do mapa. Time to first token registra o momento do texto.
O streaming deixa o roteamento mais rápido?
Não. O streaming muda quando o trabalho concluído se torna visível. Ele não reduz o tempo de uma rota, de uma recuperação ou da geração completa. O artigo de latência do Azure diz que o streaming não altera o tempo necessário para produzir todos os tokens.
O que a Kaleidr envia antes de a resposta terminar?
O stream público pode enviar um evento phase cujo valor é thinking, um keep-alive durante o silêncio, uma route antes do texto em uma pergunta de direções e early_actions quando dois ou mais locais têm coordenadas. O evento end é autoritativo e substitui as ações iniciais. Nem todos os eventos aparecem em todas as solicitações.
O inventário privado deve ser armazenado em cache para reduzir a latência?
Não. Inventário, autorização, uma posição ao vivo e o estado de transação devem ser revalidados no momento da decisão. Um timeout continua desconhecido. Identificadores estáveis de local são os candidatos comuns para cache de longa duração, e somente dentro dos termos do provedor.
Qual percentil uma equipe deve acompanhar?
Acompanhe a mediana, o 95º percentil e o 99º percentil de cada span, separados por classe de solicitação. A mediana pode melhorar enquanto a cauda lenta de que os usuários se lembram continua igual.
References
- web.dev. Interaction to Next Paint (INP). A good INP is at or below 200 milliseconds at the 75th percentile of page loads recorded in the field. An INP above 200 milliseconds and at or below 500 milliseconds needs improvement. Updated September 2, 2025. https://web.dev/articles/inp
- Microsoft. Azure OpenAI in Microsoft Foundry Models performance & latency. Time to last token equals time to first token plus the time between tokens multiplied by tokens generated. Streaming returns tokens as they are ready and does not change the time required to produce all of them. Accessed October 31, 2026. https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/latency
- OpenAI. Latency optimization. A stated heuristic: cutting about half of the output tokens may cut about half of the latency. Accessed October 31, 2026. https://developers.openai.com/api/docs/guides/latency-optimization
- Kaleidr Developer Docs. SSE wire contract. Documents
text/event-stream, aphaseevent that is alwaysthinking, a keep-alive after 10 seconds of silence, tens of seconds before first prose on a hard question,early_actionsonce two or more places have coordinates, aroutebefore the prose on a directions question, andendas the authoritative result. Accessed October 31, 2026. https://docs.kaleidr.com/platform-api/sse-wire-contract - Kaleidr. Spatial AI Observability. A related guide for recording each stage, including a structured reason when the result is empty. Accessed October 31, 2026. https://kaleidr.com/blog/spatial-ai-observability
- Kaleidr. Spatial Context Engineering for Map-Aware AI. A related guide for which facts reach the model after eligibility. Accessed October 31, 2026. https://kaleidr.com/blog/spatial-context-engineering
- Kaleidr. Grounded Spatial AI for Business Data. A related guide for keeping business facts in the systems that own them. Accessed October 31, 2026. https://kaleidr.com/blog/grounded-spatial-ai-business-data
References in BibTeX
@misc{webdev_inp_2025,
  title  = {Interaction to Next Paint (INP)},
  author = {{web.dev}},
  year   = {2025},
  url    = {https://web.dev/articles/inp}
}

@misc{microsoft_azure_openai_latency_2026,
  title  = {Azure OpenAI in Microsoft Foundry Models performance \& latency},
  author = {{Microsoft}},
  year   = {2026},
  url    = {https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/latency}
}

@misc{openai_latency_optimization_2026,
  title  = {Latency optimization},
  author = {{OpenAI}},
  year   = {2026},
  url    = {https://developers.openai.com/api/docs/guides/latency-optimization}
}

@misc{kaleidr_sse_wire_contract_2026,
  title  = {SSE wire contract},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://docs.kaleidr.com/platform-api/sse-wire-contract}
}

@misc{kaleidr_spatial_ai_observability_2026,
  title  = {Spatial AI Observability},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-ai-observability}
}

@misc{kaleidr_spatial_context_engineering_2026,
  title  = {Spatial Context Engineering for Map-Aware AI},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-context-engineering}
}

@misc{kaleidr_grounded_spatial_ai_2026,
  title  = {Grounded Spatial AI for Business Data},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/grounded-spatial-ai-business-data}
}