
La latence de la Spatial AI est le temps entre une question de localisation et le premier retour utile sur la carte, et ce n'est pas un simple chronomètre du modèle. L'attente peut inclure l'autorisation, la récupération, un itinéraire et les tokens générés par un modèle de langage. Un modèle rapide peut encore se trouver derrière un itinéraire lent. Un paragraphe final plus lent peut néanmoins sembler réactif si un lieu éligible ou un itinéraire apparaît d'abord.
Que comprend la latence de la Spatial AI ?
Une question de localisation traverse plusieurs horloges, et les moyenner en une seule « latence AI » masque l'étape que l'utilisateur attend réellement. La réactivité du navigateur mesure la vitesse à laquelle la page réagit à un clic. Time to first progress est le moment où l'interface indique que le travail a commencé. Time to first token est le moment où la génération produit son premier token. Time to first spatial action est le moment où un lieu éligible ou un itinéraire devient visible. Time to last token est le moment où la génération se termine. Time to completed action est le moment où l'utilisateur peut se fier au résultat.
Time to first progress, time to first spatial action et time to completed action sont des noms utilisés par Kaleidr pour l'expérience produit. Ces trois noms ne sont pas des standards du Web. Time to first token et time to last token sont des métriques établies pour les modèles.
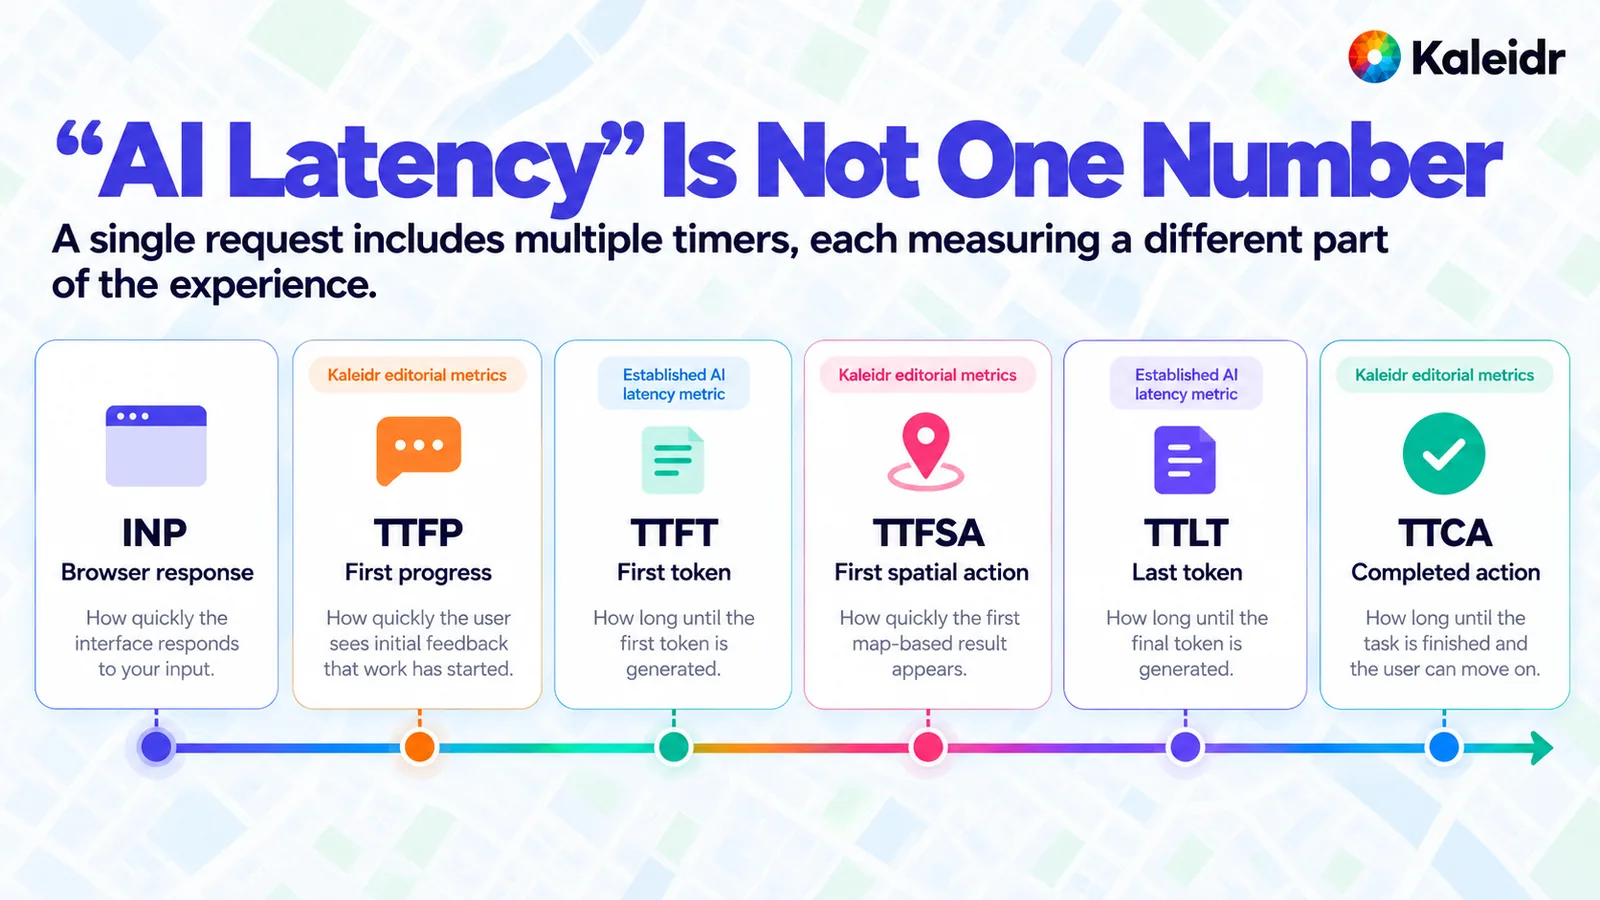
Les six cartes séparent la réponse du navigateur du reste de la requête. Time to first progress, time to first spatial action et time to completed action sont indiquées comme des métriques éditoriales de Kaleidr. Time to first token et time to last token sont indiquées comme des métriques établies de latence du modèle. Interaction to Next Paint est la métrique du navigateur. Aucune carte ne rapporte une mesure Kaleidr.
Les recommandations de Google sur les performances Web traitent Interaction to Next Paint comme une mesure de réactivité en conditions réelles et considèrent comme bon un INP inférieur ou égal à 200 millisecondes au 75e percentile des chargements de page (web.dev, 2025). Ce seuil concerne le rendu suivant un clic, pas un itinéraire ni un paragraphe généré. Une page peut le respecter tout en laissant l'utilisateur attendre la récupération. Un appel de modèle lent ne rend pas à lui seul l'INP mauvais. Les deux budgets doivent être suivis séparément, sinon une équipe risque de « corriger la latence AI » en optimisant un gestionnaire de clic qui n'était jamais sur le chemin critique.
Pourquoi le chemin critique est-il important ?
Le chemin critique est la plus longue chaîne d'étapes qui doivent se terminer dans un ordre donné. Les recherches indépendantes peuvent se chevaucher. Un itinéraire qui a besoin à la fois d'un lieu résolu et d'un fait métier ne peut commencer tant que les deux n'existent pas. Sérialiser ces recherches additionne leurs durées. Les exécuter ensemble ne retire que le chevauchement et ne rend pas l'itinéraire lui-même plus rapide. L'autorisation intervient toujours avant l'affichage d'un enregistrement privé.
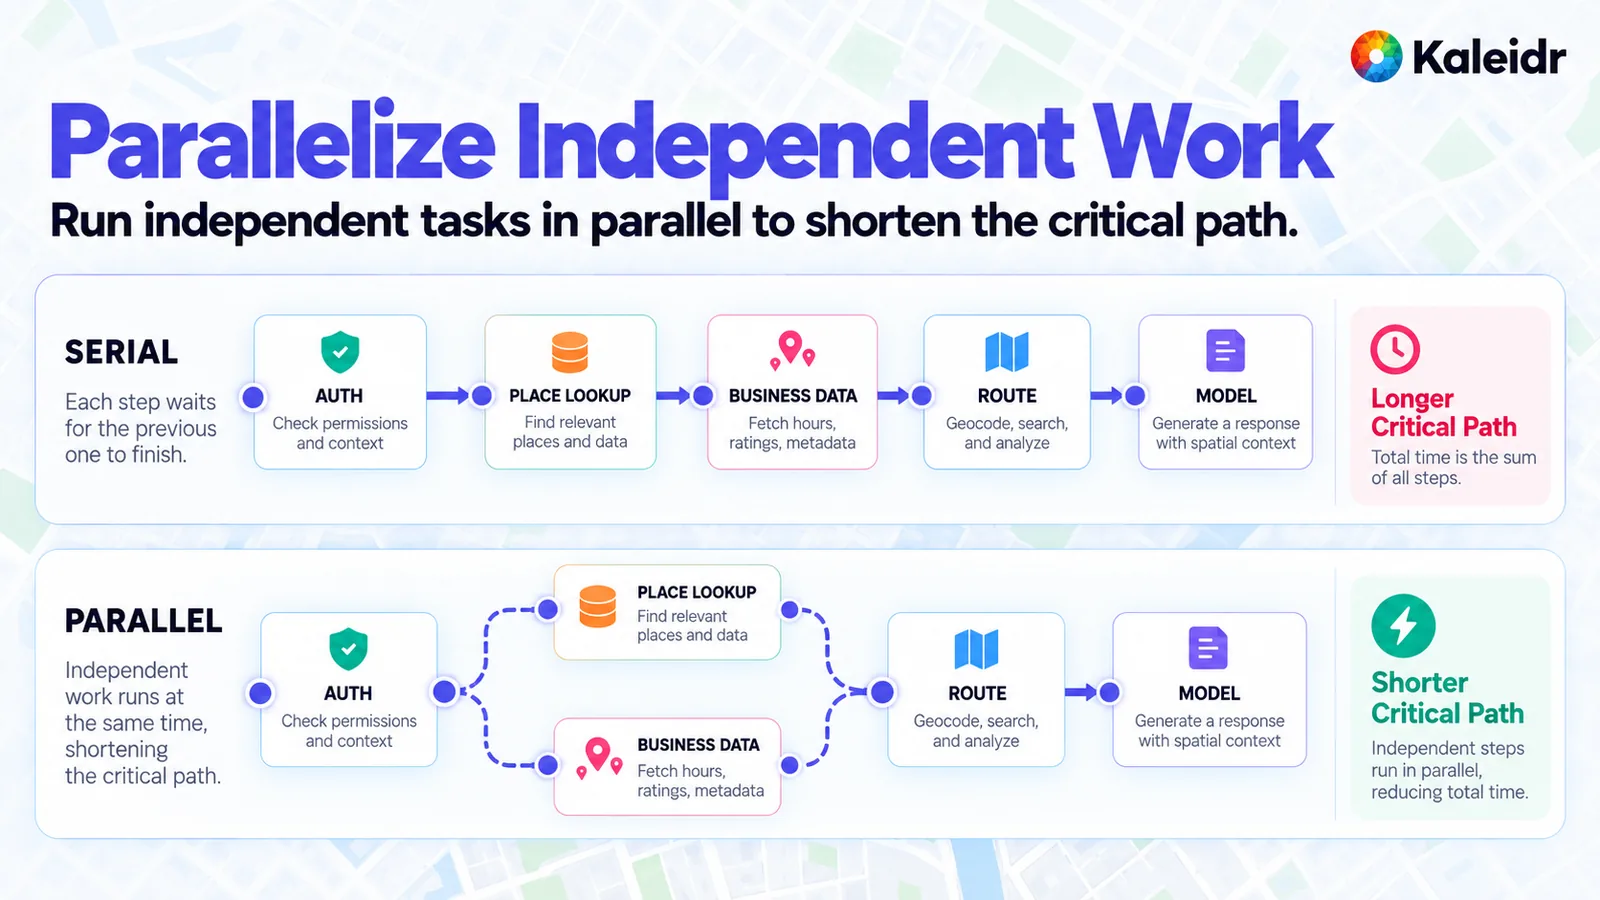
La ligne du haut attend la fin de chaque étape avant de commencer la suivante. La ligne du bas exécute simultanément la recherche de lieu et les données métier, puis les réunit pour l'itinéraire et le modèle. La figure décrit la forme de l'attente. Le dessin ne rapporte aucun gain de vitesse mesuré, et l'itinéraire dépend toujours des deux recherches.
Une trace utile nomme le span, pas le produit. Le géocodage, une lecture métier, un itinéraire, le classement et la génération peuvent chacun être le span lent selon la question. Spatial AI Observability est le guide associé pour enregistrer ces spans séparément, y compris une raison structurée lorsque le résultat est vide. Sans cette séparation, un après-midi lent ressemble à « le modèle s'est dégradé » alors que c'est le service d'itinéraire qui a ralenti.
Pourquoi le premier token n'est-il pas le premier résultat cartographique ?
Time to first token et time to last token répondent à des questions différentes, et aucun des deux ne correspond au moment où la carte devient utile. Azure OpenAI documente la relation ainsi : time to last token est égal à time to first token plus le temps entre les tokens multiplié par le nombre de tokens générés (Microsoft, 2026). Le même article indique que chaque token du prompt ajoute peu de temps par rapport à chaque token généré et que le streaming renvoie les tokens dès qu'ils sont prêts sans modifier le temps nécessaire pour tous les produire. Le guide de latence d'OpenAI donne une heuristique proche : réduire d'environ moitié les tokens de sortie peut réduire d'environ moitié la latence (OpenAI, 2026). Une explication courte peut donc finir plus tôt. La carte, et non le paragraphe, doit porter le lieu, les horaires et l'itinéraire.
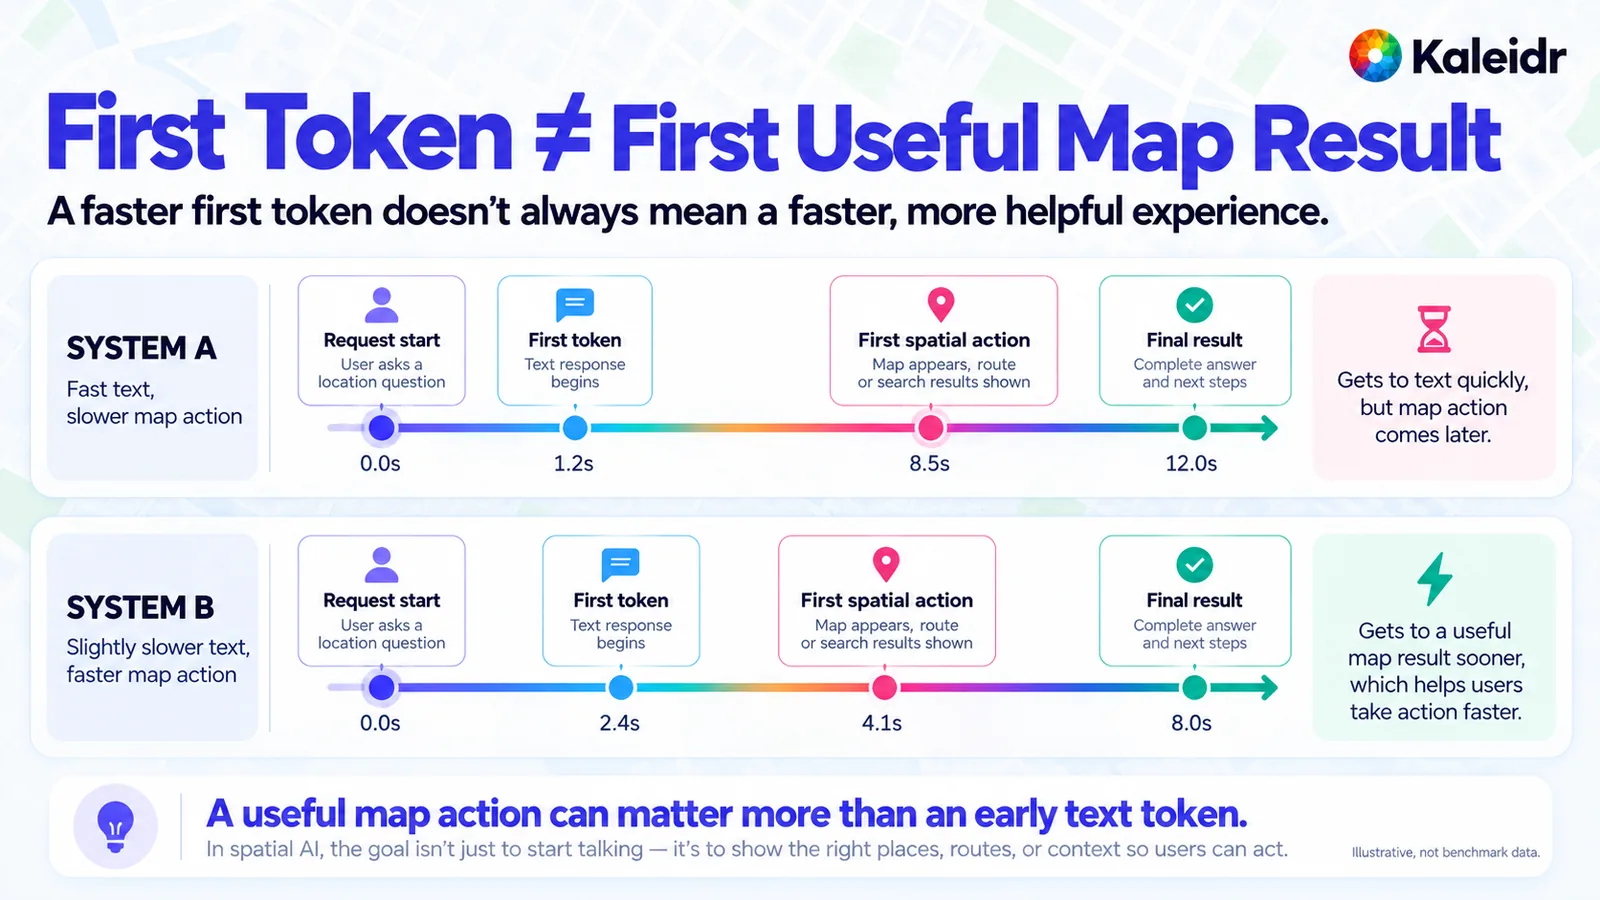
Le système A affiche du texte tôt et une action cartographique tard. Le système B affiche le texte plus tard et l'action cartographique plus tôt. Les repères en secondes et les totaux de la figure sont illustratifs, et l'illustration précise qu'il ne s'agit pas de données de benchmark. Les repères ne sont ni une trace Kaleidr ni un résultat des articles Azure ou OpenAI. La comparaison porte uniquement sur l'ordre : un token plus tôt ne signifie pas une carte plus tôt.
La distinction compte pour ce que le produit valorise. Un tableau de bord qui classe uniquement selon time to first token favorisera le système qui parle d'abord et dessine tard. Un produit cartographique doit aussi enregistrer time to first spatial action, et ne compter cette action qu'après validation de l'éligibilité. Un pin précoce pour un lieu fermé ou non autorisé est une erreur rapide. Spatial Context Engineering décrit la règle associée pour les faits autorisés à atteindre le modèle une fois l'ensemble éligible établi.
Qu'est-ce qui peut être mis en cache, et qu'est-ce qui doit être revalidé ?
Un cache économise un aller-retour uniquement si la valeur enregistrée est toujours la bonne. Les identifiants stables et les coordonnées d'un lieu connu changent rarement et sont donc des candidats habituels à un cache de longue durée. Les horaires, un itinéraire calculé et le texte descriptif changent assez souvent pour qu'une durée de vie courte soit la politique honnête. Le stock, la position d'un véhicule, l'autorisation et l'état d'une transaction doivent être relus au moment de la décision. Un « en stock » mis en cache ce matin n'est pas une preuve pour cet après-midi.
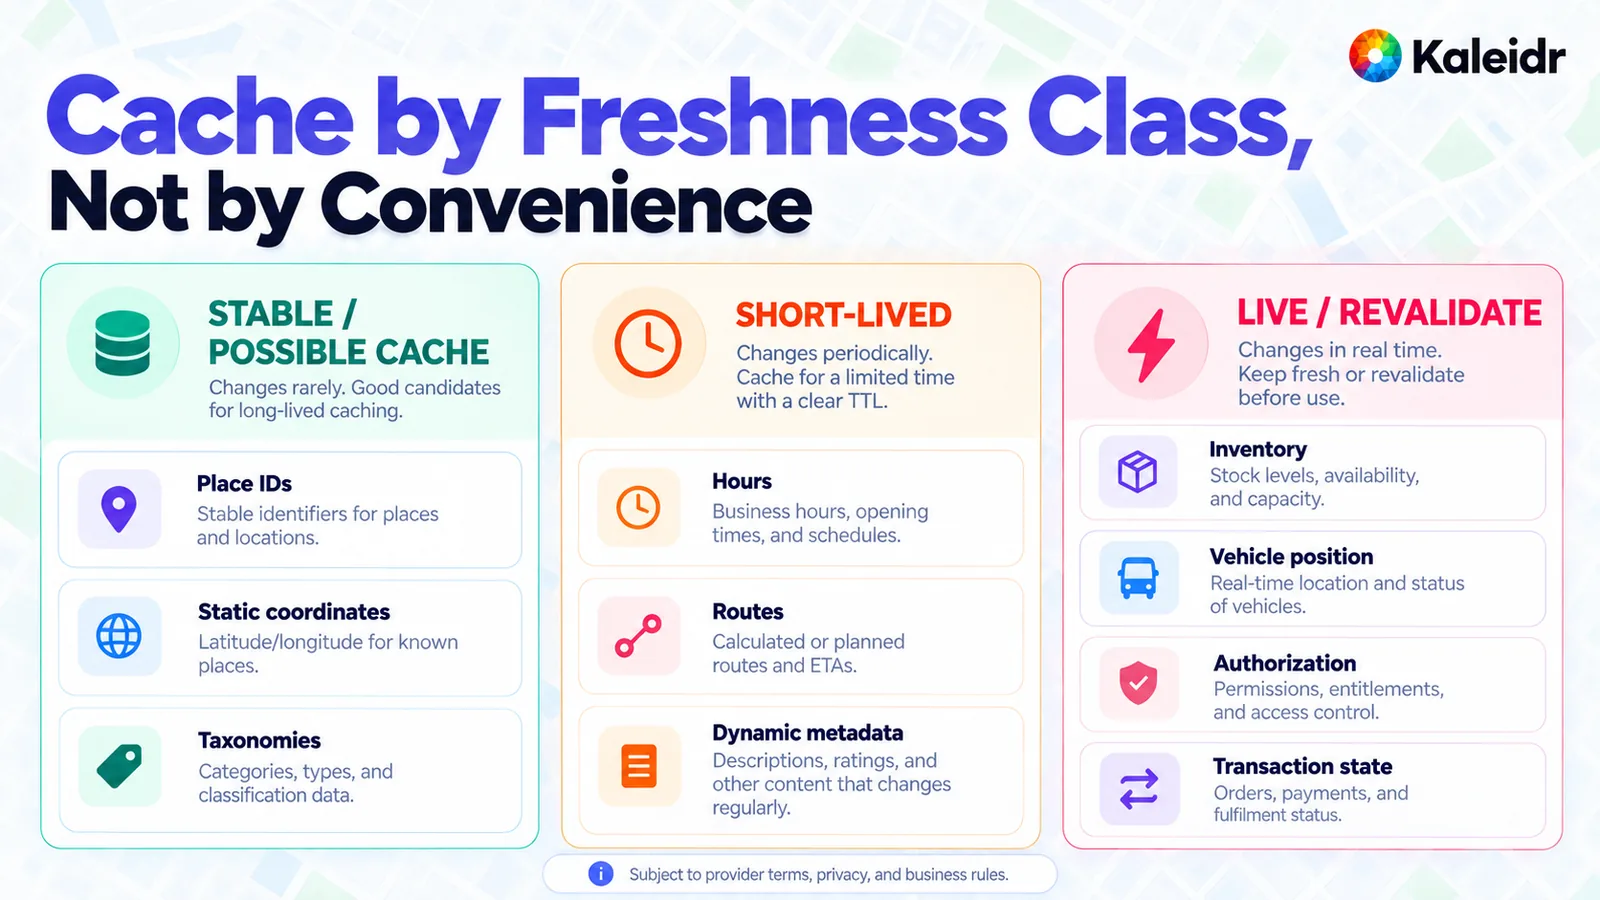
La colonne de gauche contient ce qui change rarement. La colonne du milieu nécessite une courte durée de vie. La colonne de droite doit être revalidée avant utilisation. Le pied de la figure indique que ces classes restent soumises aux conditions du fournisseur, à la confidentialité et aux règles métier. Un itinéraire dans la colonne centrale est un calcul mis en cache, pas une promesse que la route est encore ouverte. Rien dans la figure ne constitue une politique de cache Kaleidr.
Les données de lieux d'un fournisseur ajoutent une deuxième contrainte. Les conditions associées à l'enregistrement continuent de s'appliquer à une copie, notamment l'attribution et toute restriction d'usage. Les enregistrements privés en ajoutent une troisième : un cache partagé entre utilisateurs ne doit pas devenir un moyen de contourner l'autorisation. Inconnu reste inconnu. Un timeout sur le stock n'autorise pas à afficher « rupture de stock », et un timeout sur un itinéraire n'autorise pas à inventer des minutes.
Quand la carte peut-elle bouger avant la fin de l'explication ?
L'ordre utile sur une carte est souvent : lieu, puis itinéraire, puis phrase d'explication. L'utilisateur peut examiner un candidat éligible pendant que le modèle de langage écrit encore. Ce schéma ne rend ni la récupération ni le routage plus rapides. Il ne fait que révéler un travail déjà terminé. Le texte en streaming a la même limite. Selon Azure, le streaming change le moment où le premier token devient visible, pas le temps nécessaire pour produire toute la séquence.
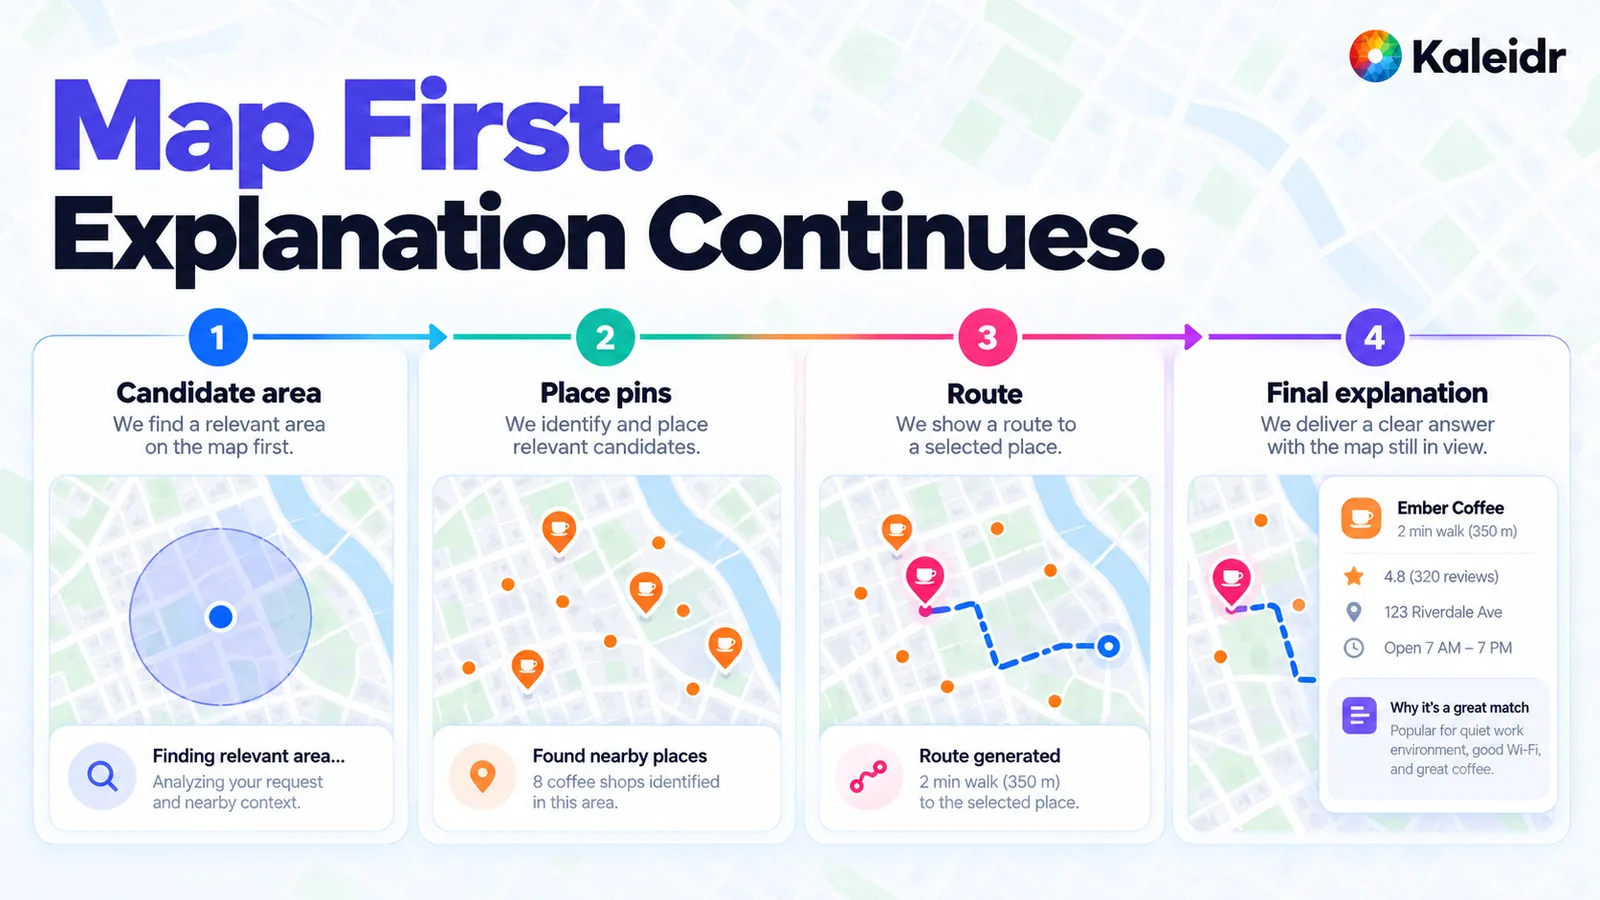
La séquence est une zone candidate, puis des pins, puis un itinéraire, puis une courte explication. Le nombre de boutiques, la marche de deux minutes, la note, l'adresse et les horaires sont des exemples sur l'illustration, pas une requête en direct. Les pins et l'itinéraire de ce schéma concernent des lieux qui ont déjà passé l'éligibilité. Un marqueur précoce ne remplace pas ce contrôle.
Le flux public de Kaleidr utilise Server-Sent Events, text/event-stream, et le contrat précise ce qui peut arriver avant la fin du texte (Kaleidr, 2026). L'événement phase signifie que la requête a été acceptée et que le travail a commencé, et sa valeur de phase est toujours thinking. Un commentaire : keep-alive arrive après 10 secondes de silence. Sur une question difficile, le premier texte peut prendre plusieurs dizaines de secondes, d'où l'existence de l'événement phase et du heartbeat. Sur une question d'itinéraire, une route peut arriver avant le texte, ce qui permet de dessiner la ligne pendant que le texte est diffusé. early_actions transporte des actions cartographiques pouvant être appliquées avant la fin de la réponse et est envoyé dès que deux lieux ou plus ont des coordonnées. L'événement end est le résultat faisant autorité et ses actions remplacent les actions précoces. Tous les événements n'apparaissent pas à chaque requête.
Comment dessiner le graphe de requête ?
Dessinez les dépendances, puis supprimez les étapes qui ne changent pas la réponse. La résolution de lieu et une lecture métier peuvent s'exécuter ensemble après l'autorisation. L'éligibilité est la jointure. Le routage et les autres travaux spatiaux utilisent cette jointure. Le classement ordonne les survivants. La génération les explique. La carte montre les mêmes identifiants. Générer avant l'éligibilité dépense des tokens sur des lieux que le produit ne peut pas recommander. Grounded Spatial AI for Business Data maintient cette éligibilité dans les systèmes qui possèdent les faits.
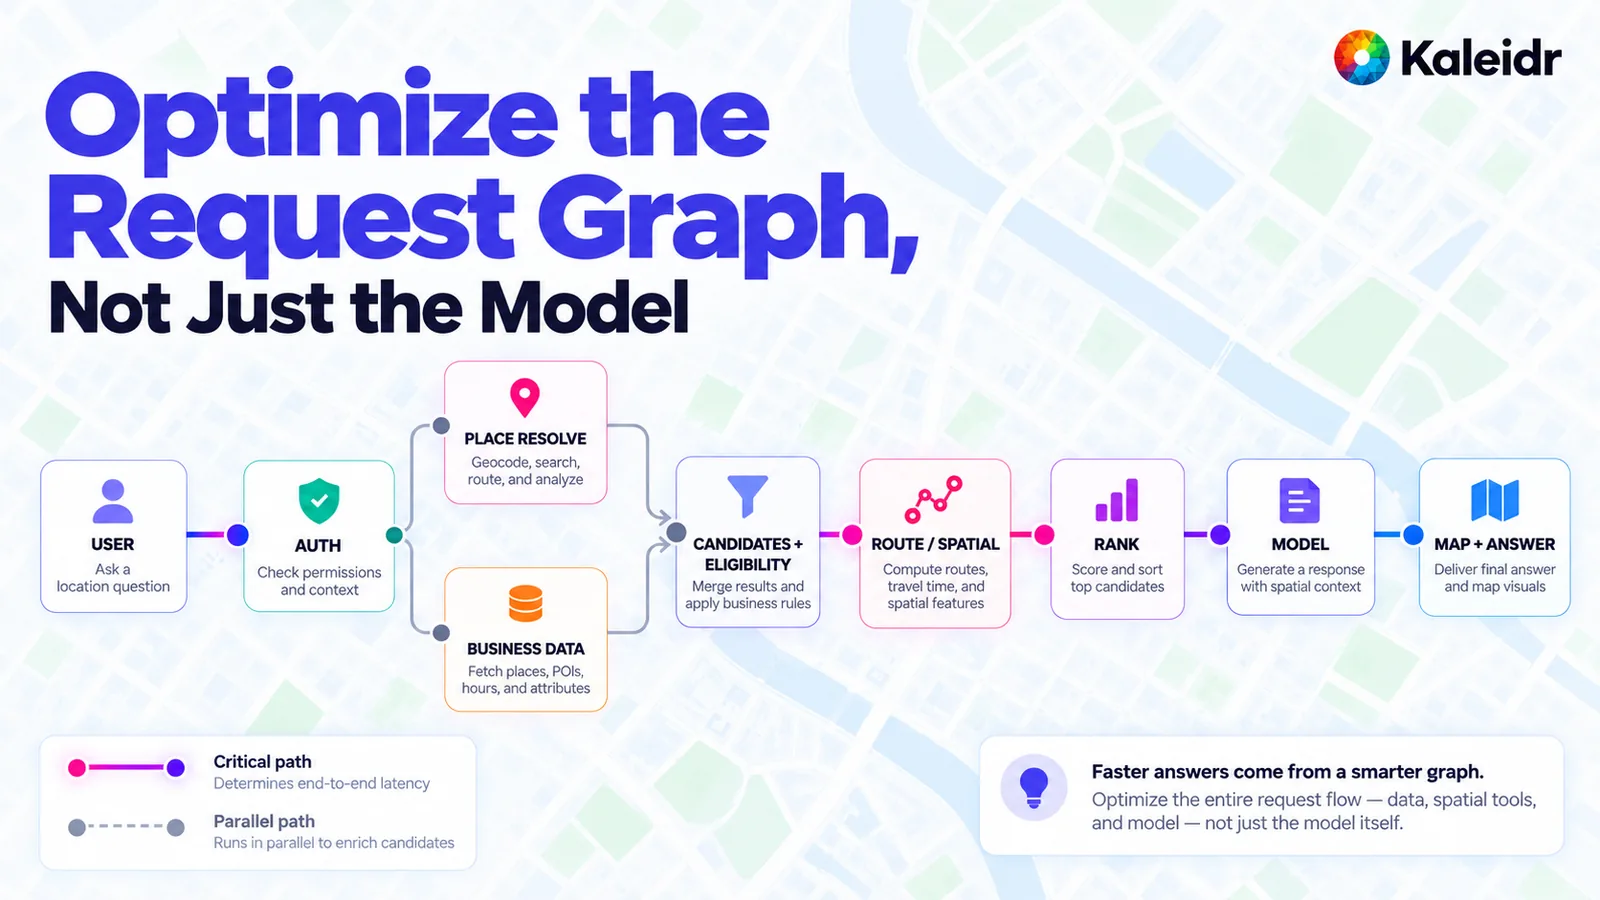
L'autorisation vient d'abord. La résolution de lieu et la lecture métier forment la paire parallèle. Viennent ensuite l'éligibilité, l'itinéraire, le classement, la génération et la carte. La ligne pleine est le chemin critique et la ligne pointillée la lecture qui se chevauche. La figure défend le fait de dessiner l'ensemble du graphe. Elle ne rapporte aucun gain mesuré et ne montre aucun enregistrement privé franchissant l'autorisation.
Le même graphe montre où un modèle de langage est le mauvais outil. Un test de contenance, un contrôle d'autorisation, un filtre « ouvert maintenant » et un seuil de distance sont déterministes. Le modèle est utile pour lire la requête, expliquer un résultat déjà calculé par les services et classer des préférences souples parmi les lieux éligibles. Le guide de latence d'OpenAI fait la même séparation en termes généraux : une méthode classique est plus rapide lorsque la tâche ne nécessite pas de raisonnement linguistique. Un seul prompt qui renvoie toutes les étapes linguistiques peut aussi être plus rapide qu'une chaîne d'appels de modèle, car chaque appel supplémentaire paie un autre aller-retour. L'itinéraire, le stock et l'autorisation proviennent toujours de leurs propres services.
Pourquoi la moyenne peut-elle masquer les requêtes lentes ?
La moyenne résume mal une attente, car quelques requêtes lentes dominent ce dont les utilisateurs se souviennent. Rapportez la médiane, le 95e percentile et le 99e percentile pour chaque span, ventilés par classe de requête. Une question d'itinéraire et une courte question de lieu n'appartiennent pas au même groupe. La longue traîne peut venir d'un fan-out entre outils, d'une nouvelle tentative, d'un prompt volumineux, d'une différence entre fournisseurs ou d'une longue réponse générée. La formule d'Azure dit déjà que la dernière cause augmente avec les tokens de sortie. Les autres n'apparaîtront pas dans un comptage de tokens, d'où la nécessité de séparer les spans.
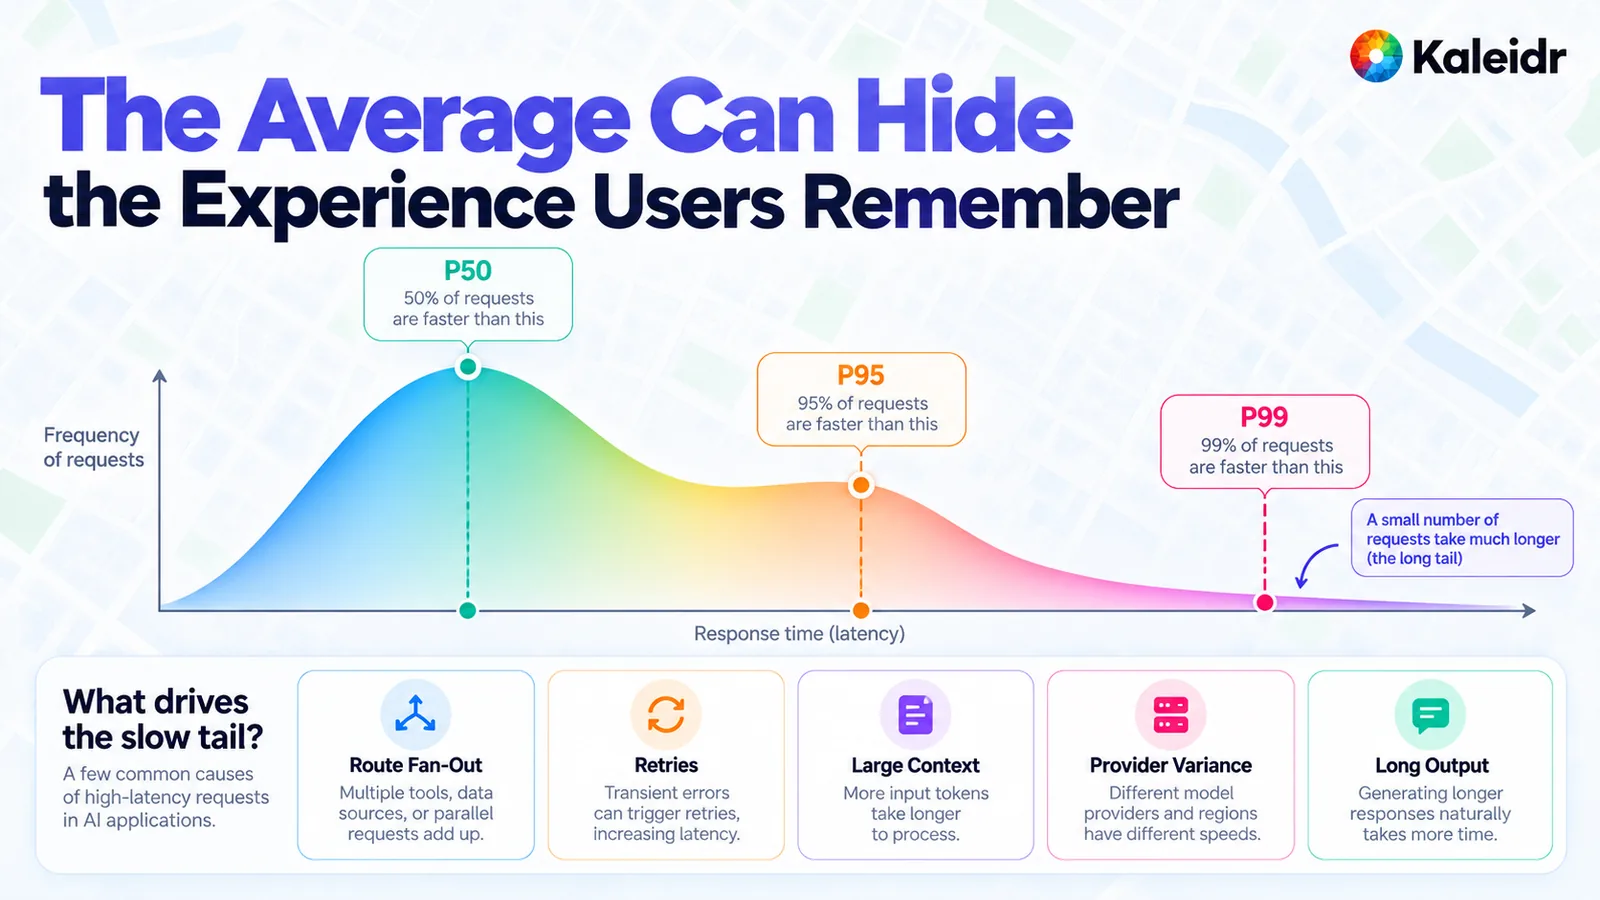
La courbe représente une forme, pas une trace Kaleidr ni un échantillon d'un tableau de bord fournisseur. Les libellés utilisent l'interprétation ordinaire de ces percentiles : la moitié des requêtes sont à la médiane ou en dessous, la plupart au 95e percentile ou en dessous, et presque toutes au 99e percentile ou en dessous. Les cinq causes sous le graphique forment une liste de pistes à examiner. Elles ne représentent pas des parts mesurées du trafic Kaleidr.
Une politique de traîne doit dire ce que fait le produit lorsqu'un span dépasse son budget. Un timeout d'itinéraire reste inconnu, et l'explication indique que l'itinéraire était indisponible. Un timeout de stock reste inconnu au lieu de devenir « rupture de stock ». Une nouvelle tentative doit apparaître dans la trace afin qu'une panne transitoire ne soit pas prise pour un modèle lent. Optimiser la médiane alors que le 99e percentile laisse toujours un utilisateur devant un indicateur de chargement n'est pas un programme de performance achevé.
Quelles étapes doivent entrer dans le budget ?
Nommez les étapes avant d'attribuer un objectif. Un budget pratique comporte sept lignes : accepter la requête dans l'interface, vérifier l'identité et l'autorisation, récupérer le contexte, calculer l'itinéraire ou la distance, générer l'explication, appliquer l'action cartographique et terminer l'action métier. Certaines lignes se chevauchent, comme le montre le graphe de requête. Certaines requêtes n'atteignent jamais une réservation ou un transfert. La liste sert à voir quelle ligne a bougé, pas à affirmer que chaque question exécute les sept en série, et elle ne fixe pas de cibles en millisecondes.
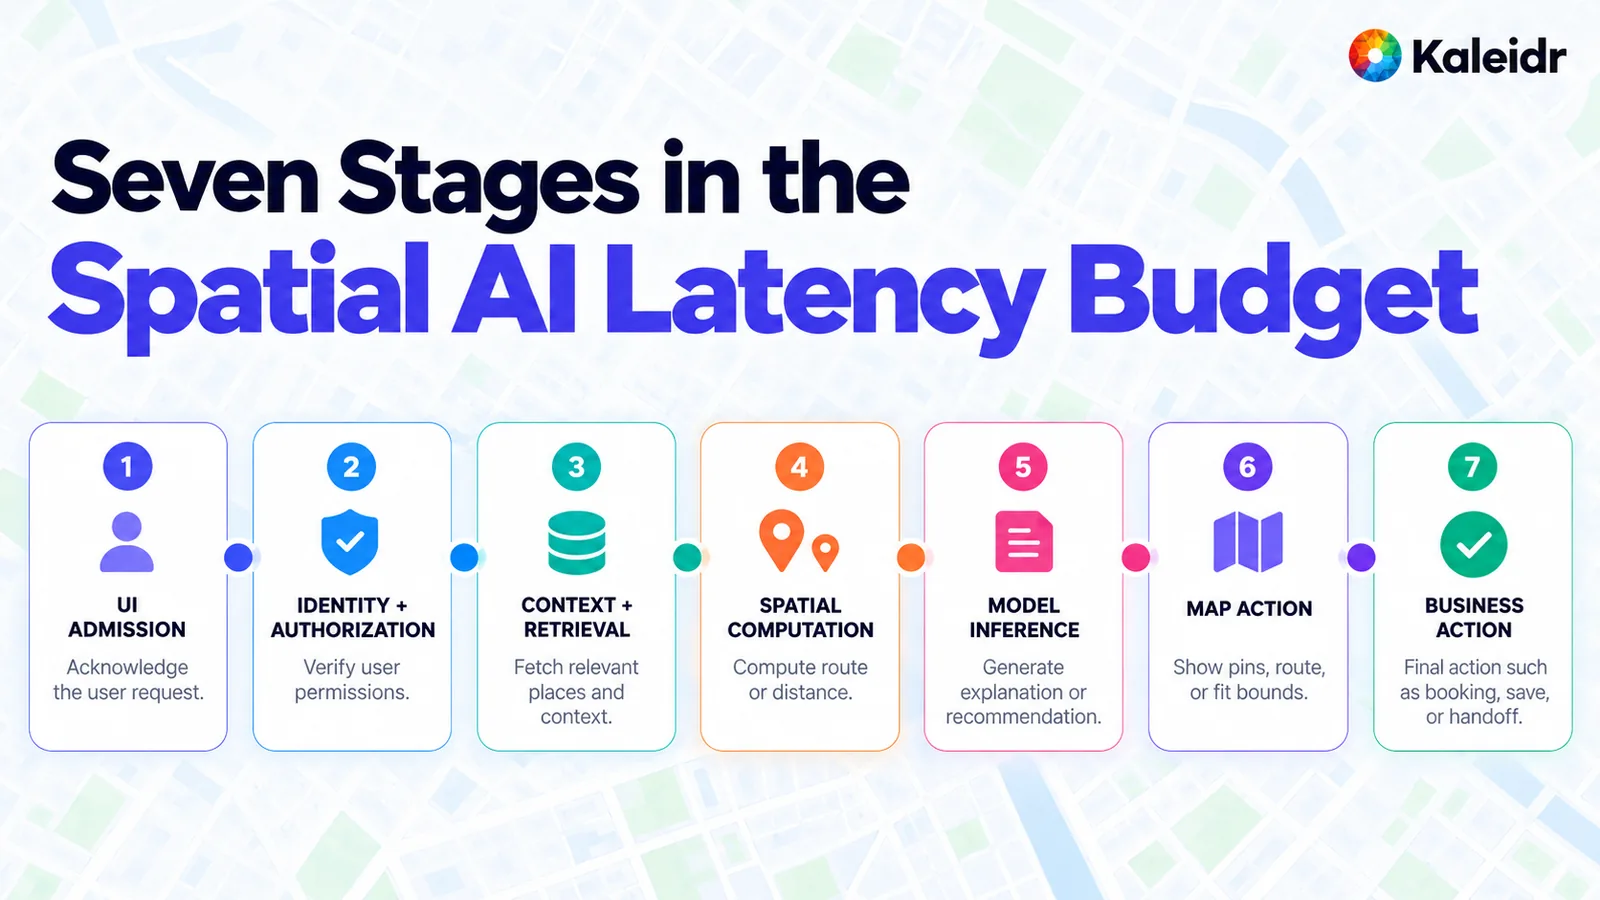
Chaque étape a un rôle et aucune durée. Accepter la requête relève du navigateur. L'autorisation précède les données privées. La récupération, le calcul spatial et la génération sont des lignes distinctes. L'action cartographique affiche un pin, un itinéraire ou une vue ajustée. L'action métier est le transfert et n'existe pas lorsque la question n'en demande pas. La figure ne fixe aucun objectif numérique.
N'attribuez une cible à une étape qu'après que la trace montre que c'est bien cette étape que les utilisateurs attendent. Un chiffre universel comme « réponses en deux secondes » mélangerait le clic, l'itinéraire et le paragraphe, et cet article n'en cite aucun. Le seuil INP ci-dessus est une cible navigateur. La formule de tokens ci-dessus décrit le temps du modèle. Time to first spatial action est la cible carte et reste une métrique éditoriale jusqu'à ce qu'une équipe la définisse sur ses propres traces.
Par où une équipe devrait-elle commencer ?
Commencez par découper l'attente. Enregistrez Interaction to Next Paint pour la page, time to first progress, time to first token, time to first spatial action, time to last token et time to completed action. Conservez les trois noms éditoriaux étiquetés comme métriques produit. Lisez p50, p95 et p99 par classe de requête. Raccourcissez la réponse générée lorsque la carte montre déjà le détail. Ne superposez que les recherches qui ne dépendent pas les unes des autres. Revalidez tout ce qui peut changer la décision. Laissez l'événement end, et non le premier pin, être le résultat sur lequel l'utilisateur peut agir.
Explorez Kaleidr Enterprise lorsque ce chemin doit inclure les lieux et règles propres à l'organisation. Le SSE wire contract est l'ordre des événements cité ci-dessus, y compris l'événement phase, le keep-alive, les actions cartographiques précoces et le résultat final.
Remarque : Kaleidr utilise des outils assistés par IA pour la création d'images, l'affinage du contenu et la recherche dans ses workflows créatifs et de développement.
FAQ
Qu'est-ce que la latence de la Spatial AI ?
La latence de la Spatial AI est le temps entre une question de localisation et un retour utile sur la carte. Elle inclut l'interface, l'autorisation, la récupération, le calcul spatial, la génération, l'action cartographique et tout transfert métier. Ce n'est pas le même nombre que le temps du modèle.
Interaction to Next Paint est-il identique à la latence du modèle ?
Non. Interaction to Next Paint mesure la vitesse à laquelle la page répond à un clic. Un bon score, inférieur ou égal à 200 millisecondes au 75e percentile des chargements de page, ne dit rien sur le moment où un itinéraire ou un paragraphe sera terminé.
Qu'est-ce que time to first token ?
Time to first token est le temps entre l'envoi d'un prompt et le retour du premier token généré. Azure OpenAI l'utilise, avec le temps entre les tokens et le nombre de tokens générés, pour décrire time to last token.
Pourquoi le premier token ne suffit-il pas pour une carte ?
Une carte devient utile lorsqu'un lieu éligible ou un itinéraire est visible. Ce moment peut arriver avant le premier token, ou longtemps après. Time to first spatial action enregistre le moment de la carte. Time to first token enregistre le moment du texte.
Le streaming rend-il le routage plus rapide ?
Non. Le streaming change le moment où un travail terminé devient visible. Il ne réduit pas le temps nécessaire à un itinéraire, une récupération ou la génération complète. L'article d'Azure sur la latence indique que le streaming ne change pas le temps requis pour produire tous les tokens.
Qu'envoie Kaleidr avant la fin de la réponse ?
Le flux public peut envoyer un événement phase dont la valeur est thinking, un keep-alive pendant le silence, une route avant le texte pour une question d'itinéraire et early_actions dès que deux lieux ou plus ont des coordonnées. L'événement end fait autorité et remplace les actions précoces. Tous les événements n'apparaissent pas sur chaque requête.
Faut-il mettre le stock privé en cache pour réduire la latence ?
Non. Le stock, l'autorisation, une position en temps réel et l'état d'une transaction doivent être revalidés au moment de la décision. Un timeout reste inconnu. Les identifiants de lieu stables sont les candidats habituels à un cache de longue durée, uniquement dans le respect des conditions du fournisseur.
Quel percentile une équipe doit-elle surveiller ?
Surveillez la médiane, le 95e percentile et le 99e percentile de chaque span, séparés par classe de requête. La médiane peut s'améliorer tandis que la traîne lente dont les utilisateurs se souviennent reste inchangée.
References
- web.dev. Interaction to Next Paint (INP). A good INP is at or below 200 milliseconds at the 75th percentile of page loads recorded in the field. An INP above 200 milliseconds and at or below 500 milliseconds needs improvement. Updated September 2, 2025. https://web.dev/articles/inp
- Microsoft. Azure OpenAI in Microsoft Foundry Models performance & latency. Time to last token equals time to first token plus the time between tokens multiplied by tokens generated. Streaming returns tokens as they are ready and does not change the time required to produce all of them. Accessed October 31, 2026. https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/latency
- OpenAI. Latency optimization. A stated heuristic: cutting about half of the output tokens may cut about half of the latency. Accessed October 31, 2026. https://developers.openai.com/api/docs/guides/latency-optimization
- Kaleidr Developer Docs. SSE wire contract. Documents
text/event-stream, aphaseevent that is alwaysthinking, a keep-alive after 10 seconds of silence, tens of seconds before first prose on a hard question,early_actionsonce two or more places have coordinates, aroutebefore the prose on a directions question, andendas the authoritative result. Accessed October 31, 2026. https://docs.kaleidr.com/platform-api/sse-wire-contract - Kaleidr. Spatial AI Observability. A related guide for recording each stage, including a structured reason when the result is empty. Accessed October 31, 2026. https://kaleidr.com/blog/spatial-ai-observability
- Kaleidr. Spatial Context Engineering for Map-Aware AI. A related guide for which facts reach the model after eligibility. Accessed October 31, 2026. https://kaleidr.com/blog/spatial-context-engineering
- Kaleidr. Grounded Spatial AI for Business Data. A related guide for keeping business facts in the systems that own them. Accessed October 31, 2026. https://kaleidr.com/blog/grounded-spatial-ai-business-data
References in BibTeX
@misc{webdev_inp_2025,
  title  = {Interaction to Next Paint (INP)},
  author = {{web.dev}},
  year   = {2025},
  url    = {https://web.dev/articles/inp}
}

@misc{microsoft_azure_openai_latency_2026,
  title  = {Azure OpenAI in Microsoft Foundry Models performance \& latency},
  author = {{Microsoft}},
  year   = {2026},
  url    = {https://learn.microsoft.com/en-us/azure/foundry/openai/how-to/latency}
}

@misc{openai_latency_optimization_2026,
  title  = {Latency optimization},
  author = {{OpenAI}},
  year   = {2026},
  url    = {https://developers.openai.com/api/docs/guides/latency-optimization}
}

@misc{kaleidr_sse_wire_contract_2026,
  title  = {SSE wire contract},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://docs.kaleidr.com/platform-api/sse-wire-contract}
}

@misc{kaleidr_spatial_ai_observability_2026,
  title  = {Spatial AI Observability},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-ai-observability}
}

@misc{kaleidr_spatial_context_engineering_2026,
  title  = {Spatial Context Engineering for Map-Aware AI},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/spatial-context-engineering}
}

@misc{kaleidr_grounded_spatial_ai_2026,
  title  = {Grounded Spatial AI for Business Data},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/grounded-spatial-ai-business-data}
}