
Géocodage vs recherche de lieux constitue la première séparation dans une requête de localisation : un appel résout un sujet géographique, tandis que l'autre découvre des lieux candidats. Une adresse, une coordonnée ou un identifiant de lieu relève du géocodage. Une demande portant sur des commerces, des points de repère ou d'autres lieux nommés relève de la recherche de lieux. Une requête spatiale teste ensuite la géométrie déjà détenue par l'application, et la recherche vectorielle rapproche le sens sans prouver qu'un enregistrement est proche ou éligible.
À quelle question répond chaque requête de localisation ?
Chaque méthode répond à une question différente, et le fait qu'un fournisseur les regroupe dans une même famille de produits n'efface pas cette différence. Le géocodage résout une identité. La recherche de lieux découvre des candidats dans l'index d'un fournisseur ou dans un index privé. Une requête spatiale applique une relation géométrique à des enregistrements que l'application stocke déjà. La recherche vectorielle récupère des enregistrements dont les embeddings sont proches par le sens. Une décision en production a souvent besoin de plusieurs de ces réponses, dans un ordre dicté par la question elle-même.
| Requête | Le rôle | Entrée typique | Sortie typique |
|---|---|---|---|
| Géocodage | Résoudre un emplacement | Une adresse postale ou une coordonnée | Une coordonnée, une adresse normalisée ou un identifiant stable |
| Recherche de lieux | Découvrir des lieux nommés | Texte, catégorie et zone | Un ensemble de lieux candidats |
| Requête spatiale | Tester la géométrie | Dans une distance, dans un polygone, intersecte, plus proche | Des enregistrements qui satisfont la relation |
| Recherche vectorielle | Rapprocher le sens | Une phrase telle que « un endroit calme pour un premier rendez-vous » | Des enregistrements aux descriptions similaires |
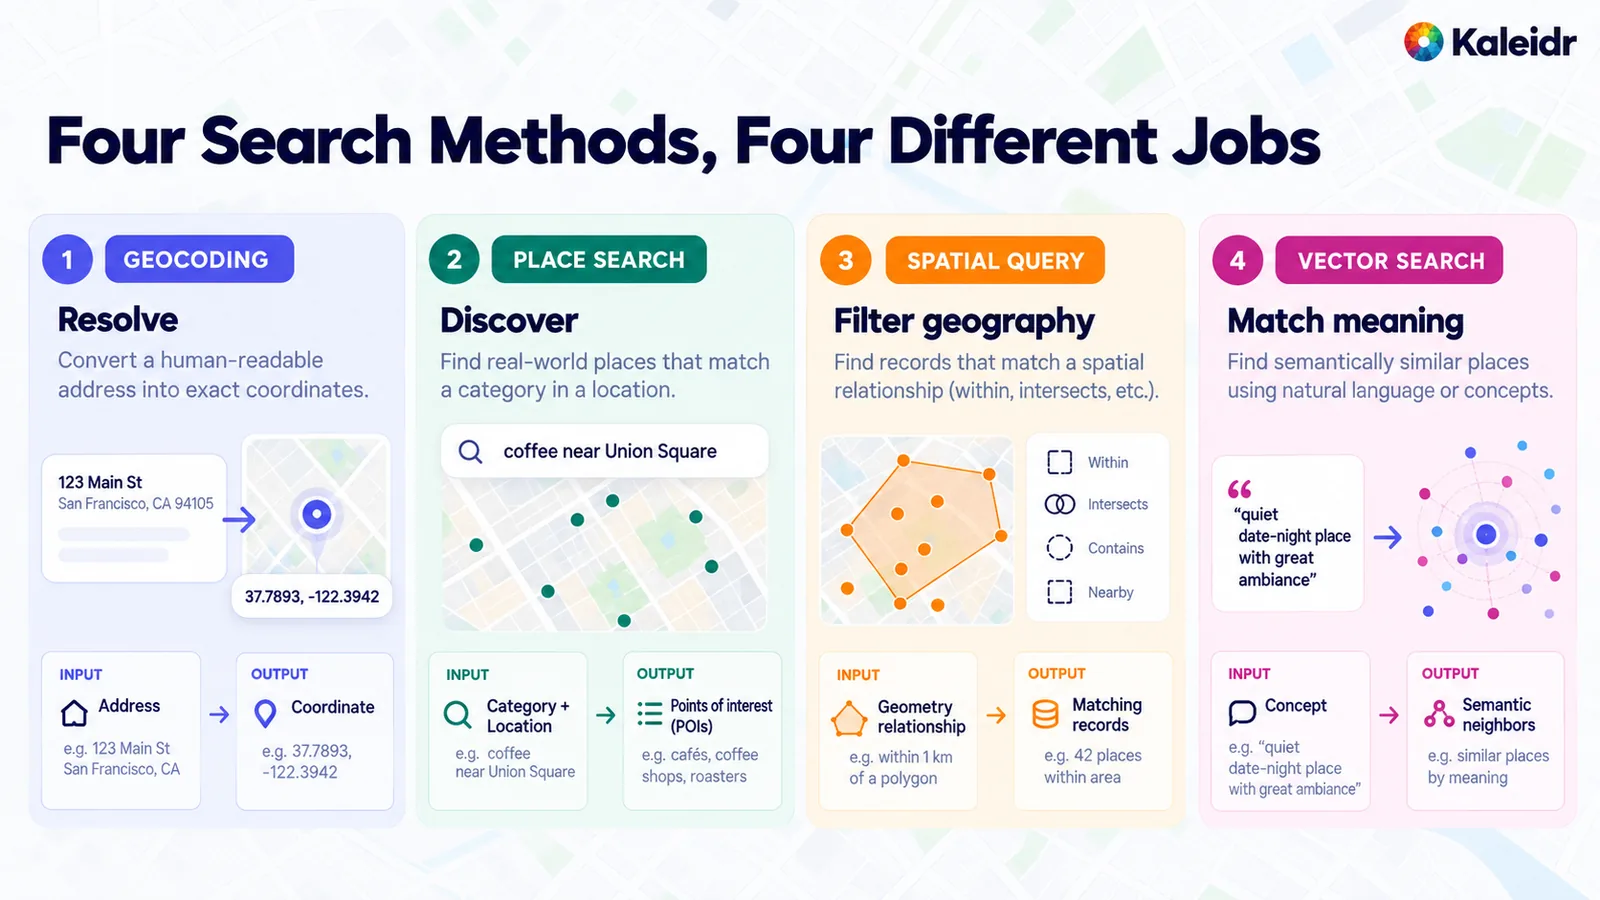
Les quatre cartes séparent résoudre, découvrir, filtrer la géographie et rapprocher le sens. Chaque carte associe une entrée à une sortie : une adresse à une coordonnée, une catégorie à des points d'intérêt, une relation géométrique à des enregistrements correspondants et un concept à des voisins sémantiques. L'adresse postale, la coordonnée, la requête sur un café et le nombre de lieux dans le polygone sont des libellés d'exemple dans la figure. Ces libellés ne proviennent pas d'une requête en direct sur un index Kaleidr.
Le tableau est la règle de sélection. Une équipe qui part du nom de l'endpoint plutôt que de la question demandera à un géocodeur une recommandation ou à un index vectoriel un test de contenance. Les deux erreurs produisent une réponse assurée à une question que le système n'a jamais exécutée. La suite de ce guide maintient les quatre rôles séparés, puis montre où un pipeline doit les réunir.
Quelle requête correspond à la question ?
Les premiers mots de la demande indiquent généralement la méthode. « Où se trouve cette adresse ? » commence par le géocodage. « Quels lieux correspondent à ce texte ou à cette catégorie ? » commence par la recherche de lieux. « Lesquels de nos enregistrements satisfont cette relation géographique ? » commence par une requête spatiale. « Quels enregistrements signifient quelque chose de similaire à ceci ? » relève de la recherche vectorielle, et seulement après la mise en place des limites géographiques et métier strictes. Une demande qui mélange ces questions a besoin d'un hybride, pas d'un gagnant unique.
| La question | Commencer ici |
|---|---|
| Où se trouve cette adresse, ou quelle adresse correspond à cette coordonnée ? | Géocodage, y compris géocodage inverse |
| Quels lieux nommés correspondent à ce texte, cette catégorie ou cette intention de proximité ? | Recherche de lieux |
| Lesquels de nos enregistrements se trouvent dans cette distance, ce polygone ou ce corridor ? | Requête spatiale |
| Quelles descriptions ressemblent à cette phrase ? | Recherche vectorielle, dans un ensemble éligible |
| Quel lieu approuvé possède l'article et ajoute peu de détour ? | Filtres métier, puis spatial ou routing, puis classement |
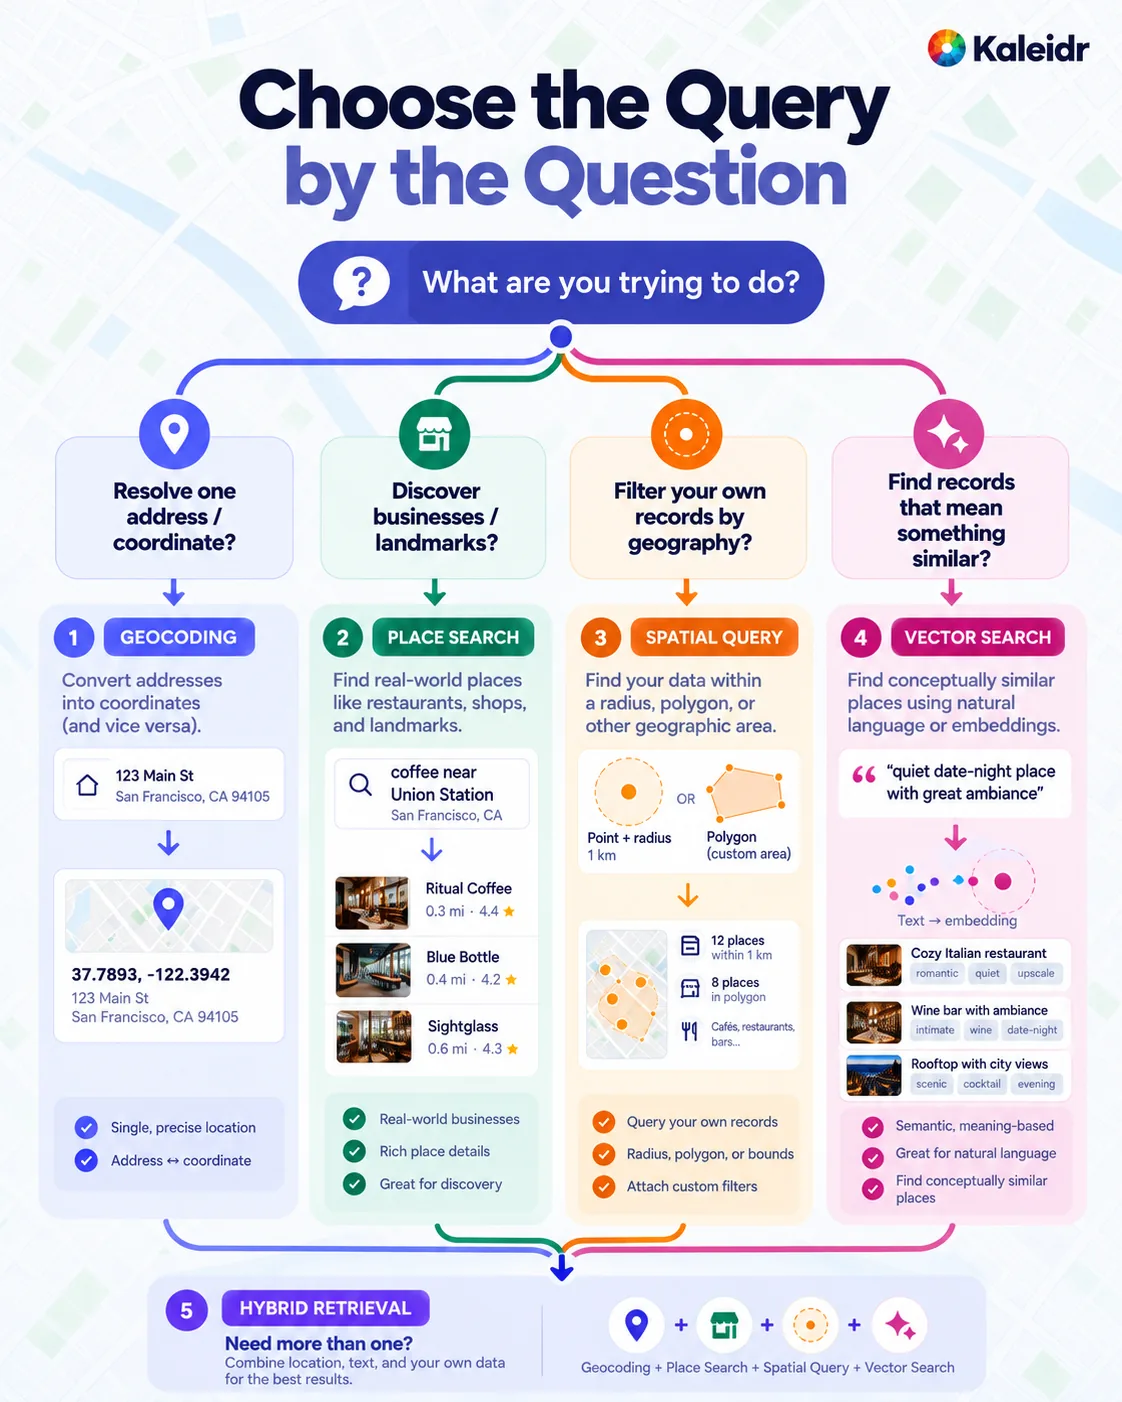
L'arbre commence par la question à laquelle l'appelant cherche à répondre, puis bifurque vers la résolution d'une adresse, la découverte de commerces, le filtrage géographique des propres enregistrements de l'appelant ou la recherche d'enregistrements au sens similaire. Une cinquième bande en bas combine les quatre méthodes lorsqu'une seule requête ne suffit pas. L'adresse d'exemple, les cartes de cafés, le rayon d'un kilomètre et la phrase citée sur un rendez-vous sont des libellés de figure. Les coches décrivent le rôle de chaque méthode, pas un score de qualité mesuré.
Un hybride est le cas habituel pour un assistant cartographique IA, et non une exception réservée à une version ultérieure. « Café près de 20 W 34th St » exige toujours que l'adresse soit d'abord résolue avant qu'une recherche de proximité puisse s'exécuter. « Un café calme près de l'hôtel, ouvert après neuf heures » ajoute à cette résolution un filtre métier et une préférence sémantique. Les sections ci-dessous gardent ces étapes dans un ordre qu'un évaluateur peut tester.
Que résout le géocodage ?
Le géocodage convertit une localisation textuelle en représentation géographique, et le géocodage inverse reconvertit une coordonnée ou un identifiant de lieu en adresse lisible. La présentation de Geocoding API de Google définit le service comme acceptant une adresse, une latitude et une longitude ou un Place ID, et convertissant une adresse en coordonnées et en Place ID, ou des coordonnées ou un Place ID en adresse (Google, 2026). La même présentation utilise « 1600 Amphitheatre Parkway, Mountain View, CA » comme exemple de géocodage direct et cite les livraisons et retraits parmi les usages du géocodage inverse. La sortie d'un appel réussi est un sujet que la carte peut positionner, pas un ensemble classé de commerces.
La frontière du produit évolue, mais c'est toujours le rôle de récupération qu'il faut nommer. La présentation de Geocoding API v4 de Google énumère le géocodage direct, le géocodage inverse, le géocodage de lieux et une méthode de recherche de destination qui accepte une adresse, un Place ID ou des coordonnées (Google, 2026). Elle distingue également les canaux generally available, preview et experimental, et demande aux appelants d'utiliser le canal expérimental pour les fonctions de destination absentes du chemin généralement disponible. Une recherche de destination peut enrichir un emplacement que l'application a déjà résolu. Elle ne devient pas pour autant un index de découverte de lieux, et un canal expérimental ne garantit pas que chaque champ est prêt pour un contrat de production.
Le géocodage est l'outil adapté lorsque l'application doit afficher une adresse, la normaliser avant stockage, centrer une carte, faire le géocodage inverse d'une position d'appareil ou résoudre un point de livraison avant une requête ultérieure. Le géocodage ne choisit pas le meilleur restaurant proche, ne lit pas un inventaire privé, ne teste pas un polygone privé de zone de service et ne classe pas les résultats selon l'intention client. Ces rôles commencent seulement après l'existence d'un sujet. Placer des lieux sur une carte couvre l'étape de l'adresse au marqueur après une résolution réussie.
Géocodage vs recherche de lieux : en quoi diffèrent-ils ?
La recherche de lieux découvre des entités géographiques nommées : restaurants, magasins, gares, points de repère et autres points d'intérêt. Mapbox trace explicitement la frontière produit dans l'actuelle Geocoding API. Cette API effectue du géocodage direct et inverse, et Geocoding v6 API ne fournit plus de données de points d'intérêt (Mapbox, 2026). Mapbox oriente la recherche de points d'intérêt vers Search Box API, qui prend en charge des requêtes interactives et autonomes pour les adresses, lieux et points d'intérêt, y compris la recherche par catégorie (Mapbox, 2026). La famille d'endpoints appartient à un fournisseur. Les rôles restent au nombre de deux.
L'actuelle Places API de Google opère la même séparation au sein de la recherche de lieux. Text Search (New) renvoie des lieux pour une chaîne de texte, et les exemples documentés incluent « shoe stores near Ottawa » et « 123 Main Street », de sorte qu'une chaîne ressemblant à une adresse peut entrer dans un appel de recherche de lieux (Google, 2026). Nearby Search (New) reçoit un ou plusieurs types de lieux et renvoie les lieux correspondants à l'intérieur d'une zone définie (Google, 2026). Text Search peut donc ressembler à du géocodage lorsque la chaîne est une adresse, et Nearby Search à une requête spatiale lorsque la zone est un cercle. Le résultat reste un ensemble de candidats provenant de l'index de ce fournisseur. Le statut d'ouverture, l'inventaire, l'autorisation et le temps de trajet restent des tests ultérieurs. La même page Text Search précise aussi que le service n'est pas destiné aux requêtes ambiguës, notamment aux formes d'adresses postales qui ne sont pas représentées comme lieux.
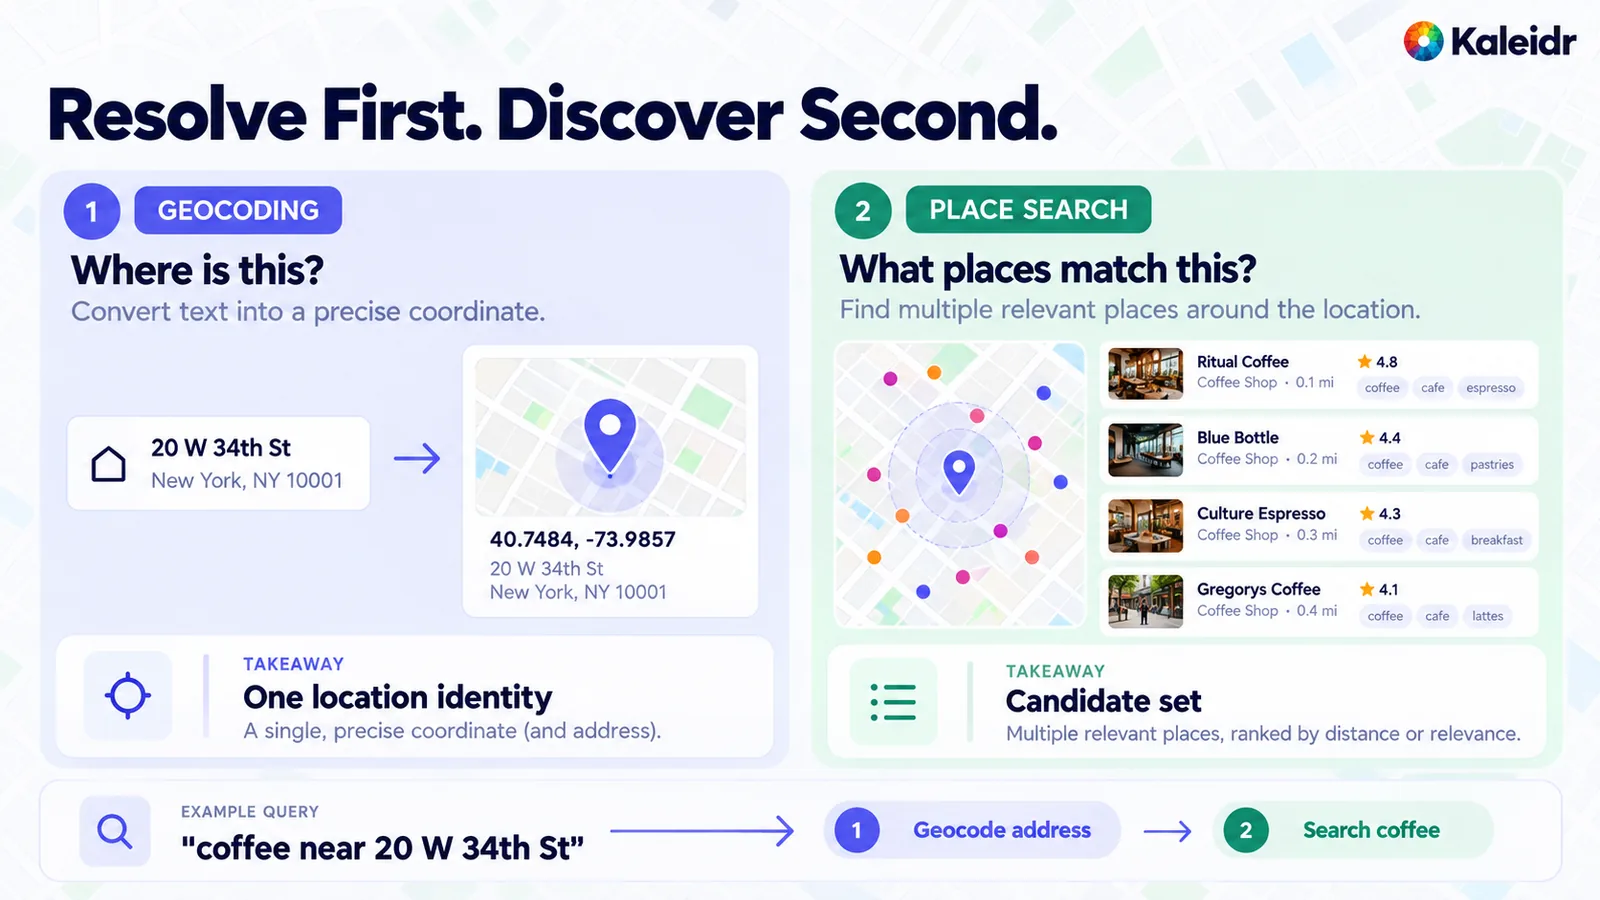
Le panneau gauche demande où se trouve une adresse et montre une seule identité de lieu. L'adresse et la coordonnée de ce panneau correspondent à l'exemple de la référence de forward geocode de Kaleidr, tandis que les noms de cafés, distances et notes étoilées à droite sont des libellés d'exemple et non une réponse de recherche de lieux en direct. Le pied de figure fait passer « coffee near 20 W 34th St » par le géocodage de l'adresse puis la recherche de café. Le point clé à droite appelle le résultat un ensemble de candidats, ce qui est le bon point d'arrêt avant l'éligibilité et le classement.
| Géocodage | Recherche de lieux | |
|---|---|---|
| Rôle principal | Résoudre un emplacement | Découvrir des lieux candidats |
| Entrée courante | Adresse, coordonnée, identifiant de lieu | Texte, catégorie, zone proche |
| Sortie courante | Une ou plusieurs interprétations de cet emplacement | Une liste classée de candidats provenant d'un index |
| Étape suivante | Carte, requête spatiale ou route | Filtrer, enrichir, classer ou calculer une route |
| Inventaire privé | Non | Non |
Une application robuste utilise les deux lorsque l'ancre est une adresse et la cible une catégorie. Géocodez « 20 W 34th St », recherchez ensuite du café près du point résolu, calculez le temps de marche puis ne classez que les lieux qui restent éligibles. Une carte des lieux à proximité est la surface de découverte pour cette deuxième étape. L'ordre du fournisseur est une commodité de récupération. L'ordre du produit est une décision ultérieure.
Que teste une requête spatiale ?
Une requête spatiale filtre des enregistrements que l'application possède déjà, à l'aide d'une relation entre géométries. Les relations courantes sont à l'intérieur d'une distance, dans un polygone, intersecte, contient et plus proche voisin. Les enregistrements et leur géométrie existent avant la requête. Celle-ci demande lesquels satisfont la relation. Une API de recherche de lieux répond à une autre question, car l'ensemble de candidats provient de l'index du fournisseur et non de la table de l'appelant.
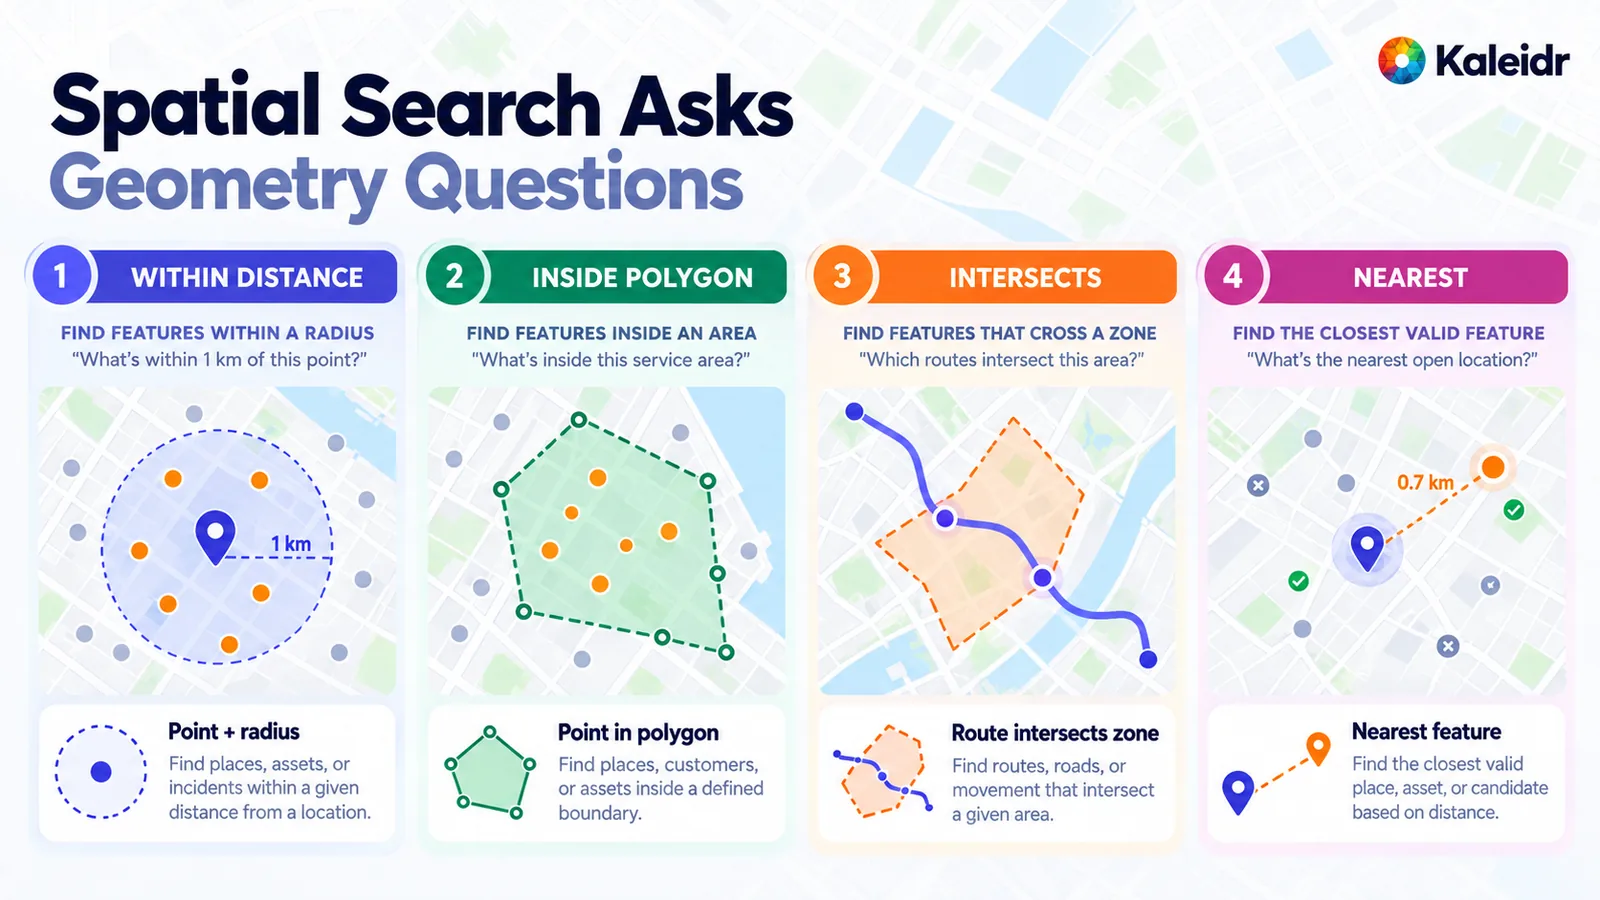
Les panneaux montrent à l'intérieur d'une distance, dans un polygone, une route qui intersecte une zone et l'entité la plus proche. Le rayon d'un kilomètre, le contour de la zone de service et le badge de distance sont des géométries d'exemple, pas une zone de service mesurée. Le panneau du plus proche marque également une entité comme exclue. Cette exclusion est un exemple d'un contrôle d'éligibilité ultérieur. Le prédicat de distance ne teste pas à lui seul si un lieu est ouvert.
PostGIS définit ST_DWithin comme un test permettant de savoir si deux géométries se trouvent à une distance donnée, et l'appel inclut une comparaison de bounding box utilisant les index spatiaux disponibles sur les géométries (PostGIS, 2026). Pour le type geography, la distance est exprimée en mètres. Une table de magasins avec une colonne geography peut donc conserver « à moins de cinq kilomètres » comme prédicat plutôt que comme phrase qu'un modèle de langage doit interpréter.
SELECT store_id, name
FROM stores
WHERE ST_DWithin(stores.geog, user_location, 5000);
La contenance appartient à la même classe de prédicats. ST_Within renvoie true lorsque chaque point de la première géométrie se trouve dans la seconde et que les intérieurs partagent un point ; la fonction utilise elle aussi les index spatiaux disponibles (PostGIS, 2026). ST_Within(A, B) est l'inverse de ST_Contains(B, A). Une question de livraison comme « cette adresse est-elle dans la zone de service ? » consiste en un géocodage, puis un test de contenance, puis la règle opérationnelle. Un index vectoriel ne remplace pas le polygone, et une recherche publique de lieux ne remplace pas la géométrie de zone de service dessinée par l'entreprise.
La note sur l'index est une contrainte d'architecture, pas une note de réglage. Une expression de distance qui ne peut pas utiliser d'index comparera bien plus de lignes que ST_DWithin sur la même table. La règle pratique pour un assistant sensible à la localisation consiste à filtrer géographiquement avant qu'un modèle voie l'ensemble. Si seule une faible part d'un grand catalogue peut satisfaire la géométrie, le modèle de langage devrait recevoir cette part, ainsi que la raison pour laquelle les autres éléments ont été écartés. Envoyer le reste consomme du contexte pour des enregistrements déjà exclus par le prédicat.
Que rapproche la recherche vectorielle ?
La recherche vectorielle récupère les enregistrements dont les embeddings sont proches de la requête dans un espace vectoriel. pgvector, l'extension Postgres couramment utilisée pour ce rôle, effectue par défaut une recherche exacte des plus proches voisins et peut ajouter un index HNSW ou IVFFlat pour une recherche approximative (pgvector, 2026). La même documentation énumère la distance L2, le produit scalaire, la distance cosinus et d'autres mesures. La recherche exacte sert de référence de rappel. Un index approximatif échange une partie de ce rappel contre de la vitesse, et les requêtes peuvent renvoyer des voisins différents une fois l'index créé. Cette propriété compte lorsqu'une équipe compare un prototype utilisant la recherche exacte à une requête de production utilisant l'index.
La recherche vectorielle vaut son coût lorsque les mots de la demande ne sont pas ceux du registre. Une description telle que « bar à vin intime à l'éclairage tamisé » peut être un voisin utile de « endroit calme pour un premier rendez-vous », même si les chaînes ne correspondent pas. Les descriptions de lieux, notes sur les équipements et textes de destination sont les entrées habituelles, lorsque la licence autorise l'intégration du texte en embedding. Une marque connue, un numéro de magasin, un code d'aéroport ou une catégorie explicite relèvent généralement mieux d'une recherche par mots-clés ou structurée. Les embeddings ajoutent un système à exploiter et doivent être ajoutés lorsque l'écart sémantique est réel.
La similarité vectorielle ne consigne ni la distance géographique, ni le temps de trajet, ni la contenance dans une zone de service, ni l'inventaire actuel, ni les horaires, ni l'autorisation, ni le fait que le texte vectorisé soit toujours vrai. Un voisin proche dans l'espace des embeddings peut se trouver à des centaines de kilomètres de l'appelant. Un lieu de l'autre côté de la rue peut être une mauvaise correspondance sémantique tout en restant la bonne réponse opérationnelle. Les deux résultats ne se contredisent pas. Ils proviennent d'espaces différents, et le pipeline doit préciser quel espace est autorisé à rejeter un candidat.
Pourquoi la distance géographique et la distance vectorielle sont-elles différentes ?
Les deux systèmes utilisent le mot distance, qui masque un changement de sujet. La distance géographique est une séparation sur la Terre ou le long d'un trajet : longueur à vol d'oiseau, marche, trajet en voiture ou résultat de contenance. La distance vectorielle est une séparation dans un espace d'embeddings : distance cosinus, distance euclidienne ou score de produit scalaire. Une faible distance vectorielle ne place pas deux lieux à proximité géographique. Une courte marche ne fait pas que deux descriptions signifient la même chose.
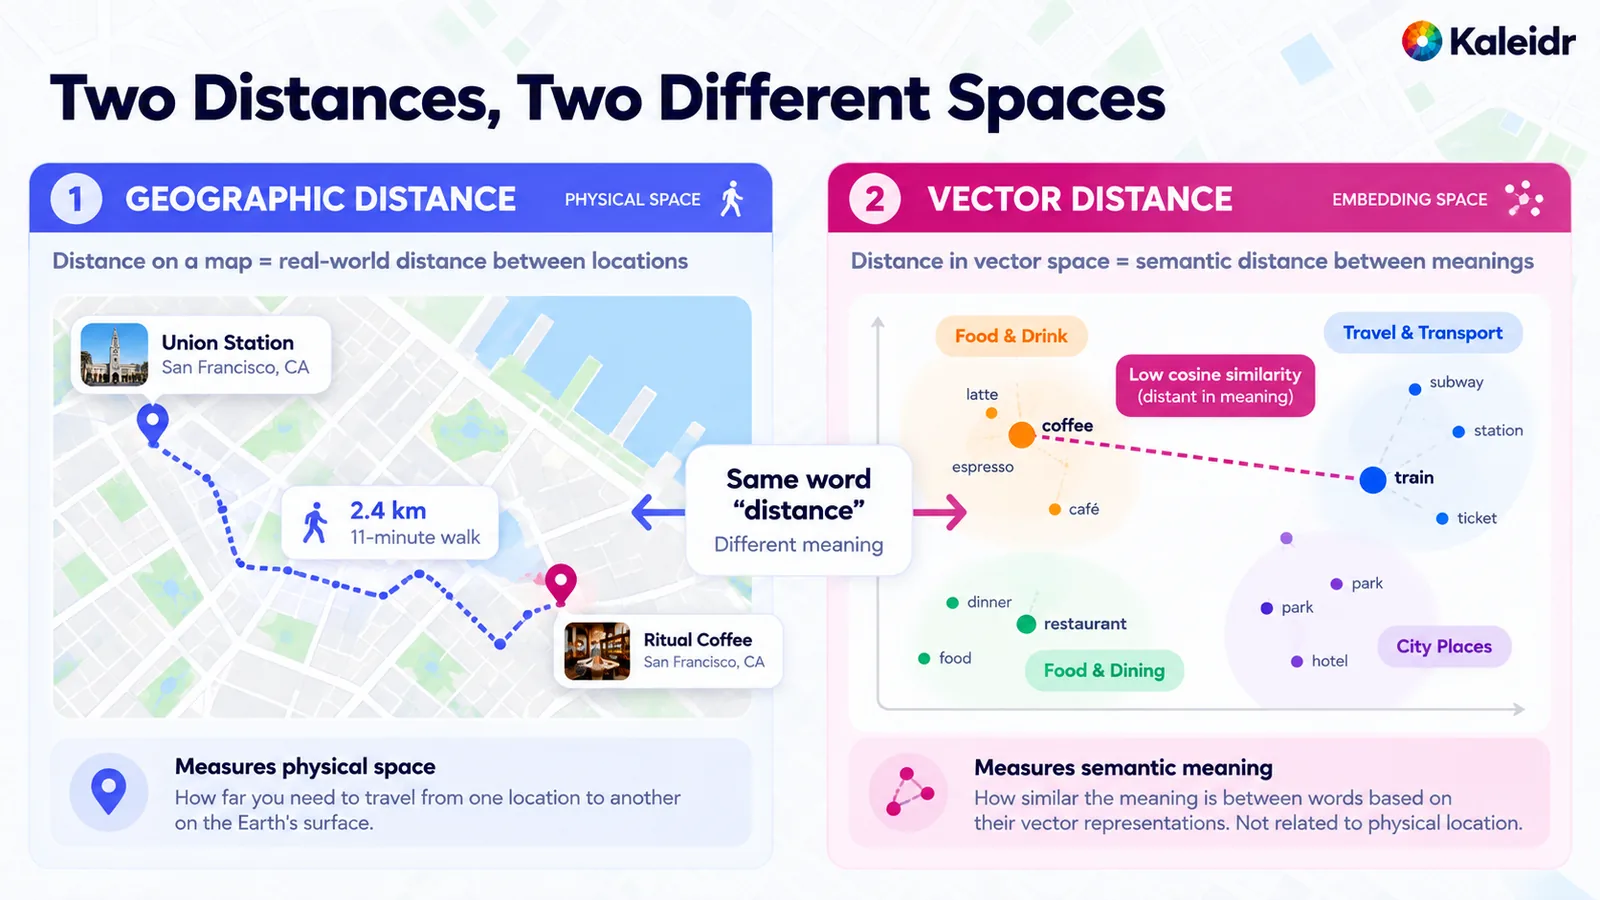
Le panneau gauche mesure la séparation physique et montre une marche d'exemple entre deux lieux étiquetés. Les badges de kilomètres et de minutes sont des exemples, pas un trajet routé. Le panneau droit place des mots dans un diagramme d'embeddings et marque coffee comme éloigné de train en termes de sens. Cette mention de cosinus illustre les deux espaces et n'est pas un embedding mesuré à partir d'un index Kaleidr. Le libellé central résume le point de la figure : le même mot, distance, désigne les deux quantités.
La collision de vocabulaire apparaît dans le texte produit. Un écran qui indique « le plus proche » peut vouloir dire le plus proche dans l'index d'embeddings, le plus proche en mètres à vol d'oiseau ou celui qui ajoute le moins de minutes de détour. Ces trois ordres divergent assez souvent pour que l'interface nomme la quantité. Un moteur de classement peut en utiliser plusieurs. Il ne doit pas additionner un score cosinus à une valeur en kilomètres et traiter la somme comme une seule distance.
Comment un pipeline hybride doit-il ordonner le travail ?
Une recherche de localisation en production est généralement un pipeline, car la demande combine un sujet, une catégorie, une limite géographique, une règle métier et une préférence. Un ordre possible consiste à interpréter la demande, résoudre l'ancre, récupérer des candidats, appliquer le filtre spatial, appliquer l'éligibilité métier, puis utiliser la similarité sémantique uniquement dans l'ensemble éligible. Le routing et les autres enrichissements s'exécutent sur les survivants. Le classement ordonne ces survivants. L'explication et l'action cartographique utilisent les mêmes identifiants que les filtres. L'ingénierie du contexte spatial est la question complémentaire qui détermine ce qui, dans ce pipeline, peut atteindre le modèle de langage.
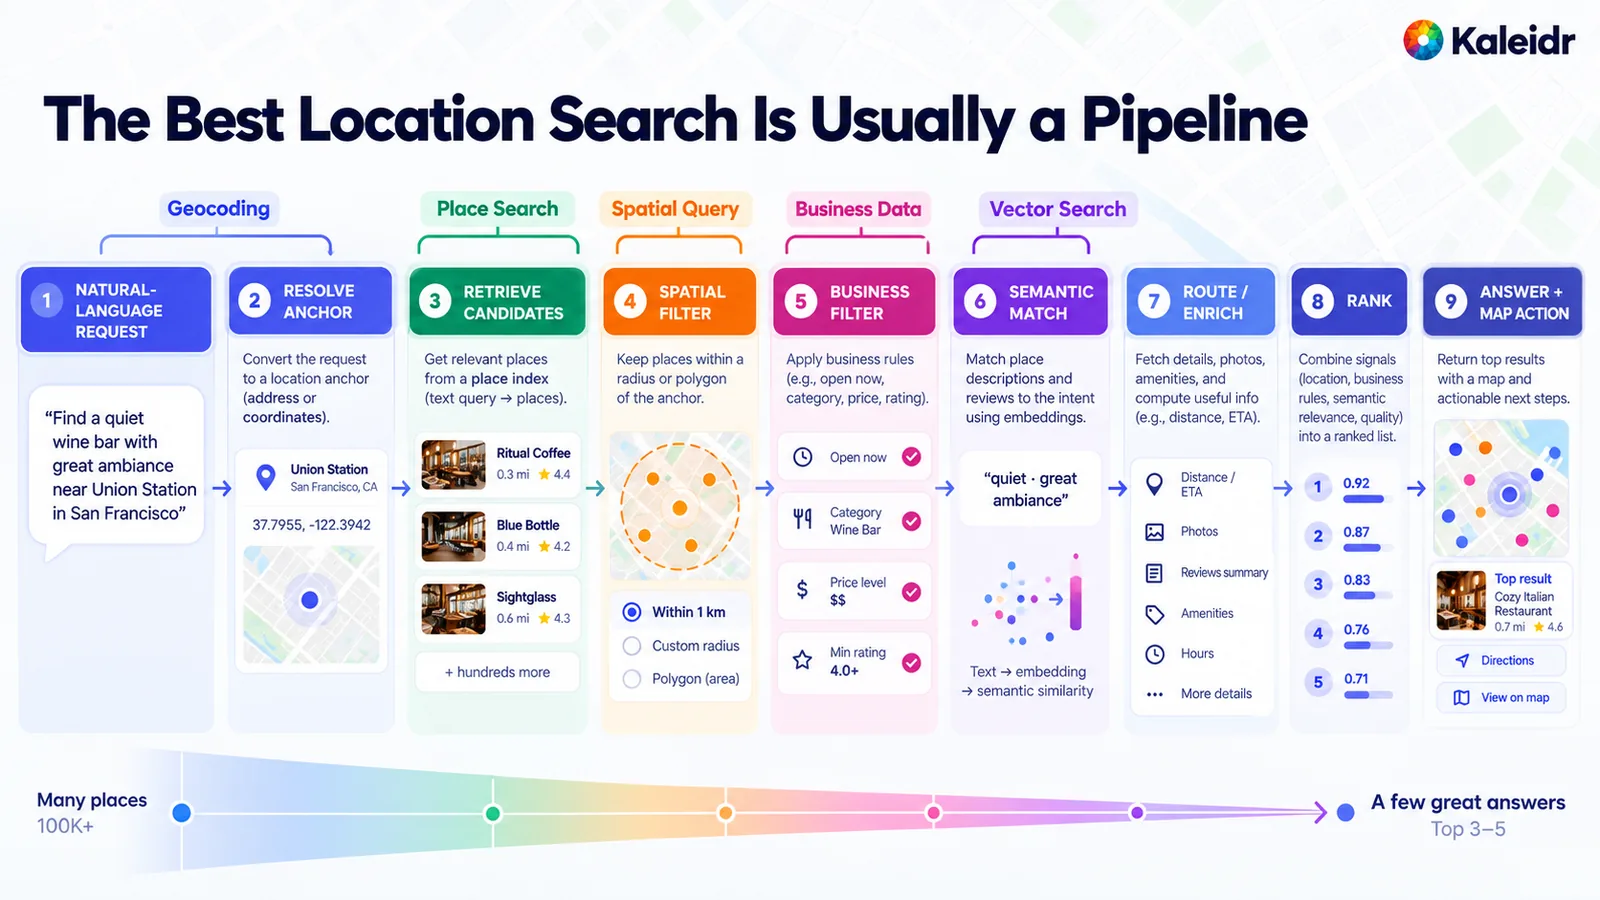
Les étapes sont étiquetées selon la méthode qui en est responsable : géocodage, recherche de lieux, requête spatiale, données métier et recherche vectorielle, suivis de l'enrichissement, du classement et de l'action cartographique. Les noms de lieux, notes étoilées, barres de score, l'entonnoir « 100K+ » et l'affirmation « top 3–5 » sont des libellés illustratifs. La figure est une esquisse de référence de l'ordre du travail, pas un benchmark Kaleidr ni un format de requête. La colonne des filtres métier montre des règles d'exemple telles qu'ouvert maintenant et une note minimale, qui appartiennent aux données de l'hôte et non à l'index public de lieux.
L'ordre modifie le rappel. Rechercher d'abord dans tout l'index d'embeddings puis tester la géographie sur une courte liste sémantique peut faire manquer un lieu local valide qui n'est jamais entré dans cette liste. Restreindre d'abord l'ensemble de candidats avec les limites géographiques strictes et les règles métier strictes, puis classer par sens à l'intérieur de cet ensemble, préserve la frontière. Lorsque la base de données peut appliquer les deux filtres dans une même requête, le même principe vaut : la similarité sémantique ne peut pas effacer une limite géographique obligatoire.
Les notes de filtrage de pgvector constituent l'avertissement pratique. Avec un index approximatif, le filtre est appliqué après le scan de l'index, et l'exemple de la documentation porte sur une condition qui correspond à 10 % des lignes avec le ef_search HNSW par défaut de 40, ce qui laisse environ quatre lignes en moyenne. Les scans d'index itératifs, que la documentation introduit pour cette insuffisance, se poursuivent jusqu'à ce qu'il reste assez de lignes. Une équipe doit tester le rappel filtré sur des données réalistes au lieu de supposer que la requête élégante est la requête de production.
Pourquoi les filtres stricts doivent-ils précéder la similarité ?
La récupération demande quels candidats peuvent entrer en considération. Le classement demande dans quel ordre les candidats valides doivent apparaître. Mélanger les deux permet à un lieu fermé, non autorisé ou en rupture de stock de gagner parce qu'il est pratique ou sémantiquement proche. Le guide de classement des lieux de Kaleidr garde l'autorisation, la disponibilité, la capacité requise et la zone de service comme filtres avant le scoring, plutôt que comme faibles pénalités (Kaleidr, 2026). Une pénalité peut perdre face à un important terme de commodité. Un filtre, non.
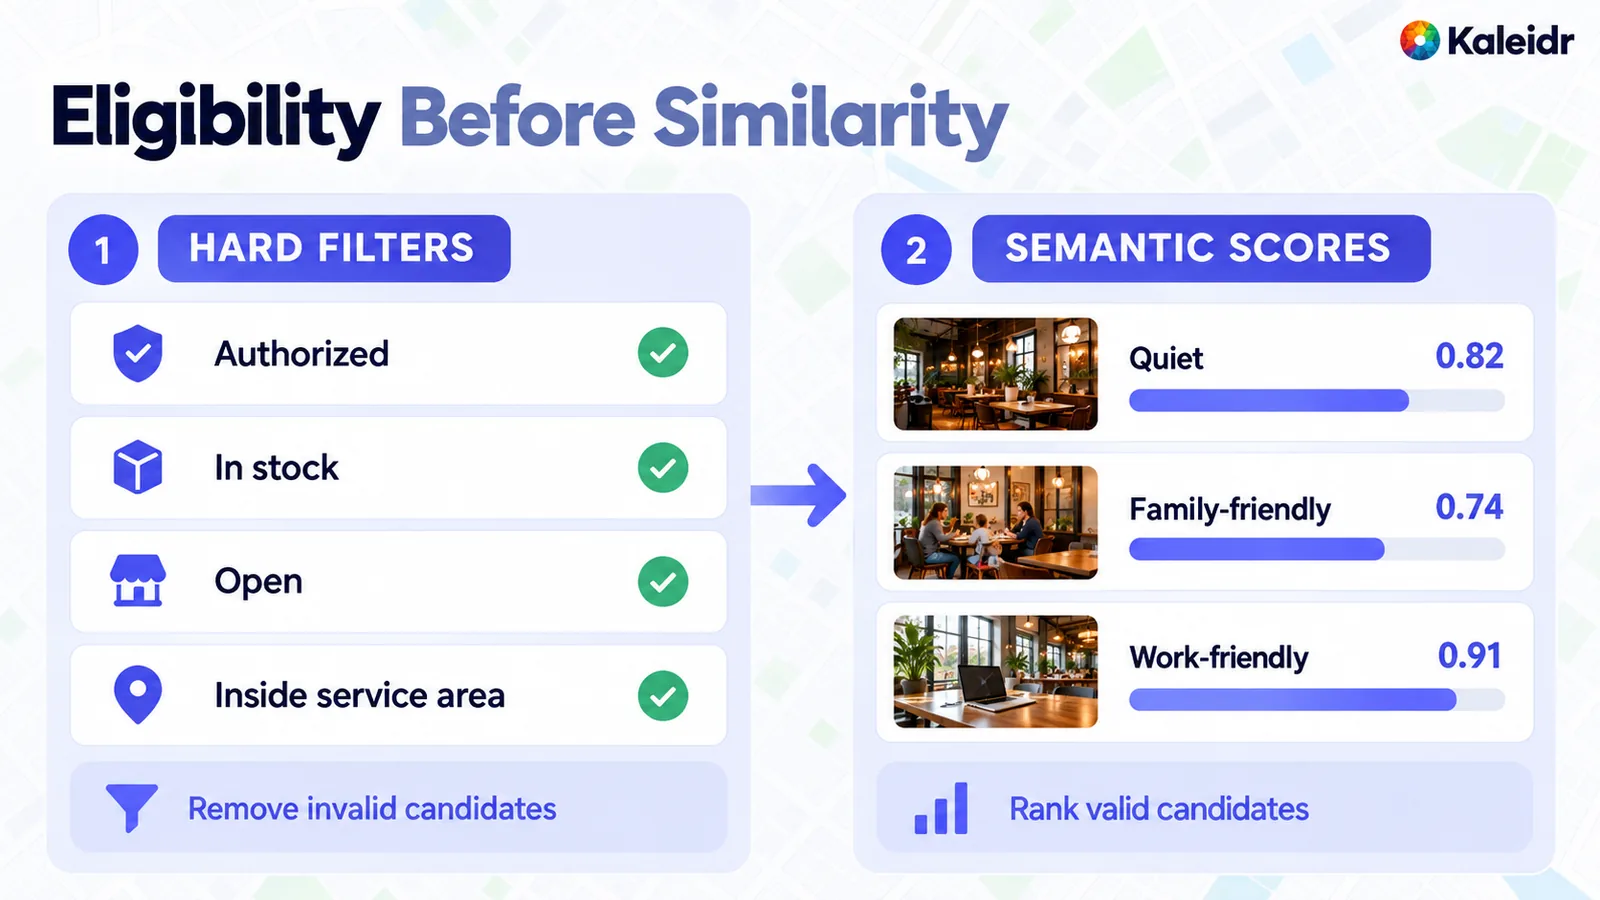
La colonne de gauche énumère quatre portes booléennes et se termine par la suppression des candidats invalides. La colonne de droite montre des scores de similarité d'exemple pour calme, adapté aux familles et adapté au travail, et ne classe que les lieux qui ont réussi. Les photographies et les trois scores sont des libellés d'exemple, pas des évaluations mesurées ni un score Kaleidr. La flèche indique l'ordre : éligibilité, puis similarité.
Les portes strictes restent booléennes. Autorisé, en stock, ouvert à l'arrivée et dans la zone de service sont des conditions, pas des poids. Les signaux sémantiques peuvent rester des scores et s'appliquent aux lieux conservés par les portes. La même séparation couvre une règle obligatoire d'accessibilité ou une frontière de tenant. Un fait obligatoire inconnu doit rester inconnu. Traiter une recherche indisponible comme false transforme une lecture d'inventaire manquante en un « rupture de stock » assuré, ce qui constitue une autre erreur, plus grave.
Pourquoi une recherche « sur le chemin » n'est-elle pas un rayon ?
« Près de moi » et « sur mon chemin du retour » décrivent des géométries différentes. Un rayon autour de l'origine renvoie les lieux à une distance du point de départ, y compris ceux situés dans la mauvaise direction. Une requête de corridor de route renvoie les lieux qui ajoutent peu de détour à un trajet déjà planifié par le service de routing. La distance à vol d'oiseau est un filtre légitime lorsque la question est réellement radiale. C'est la mauvaise quantité lorsque la décision dépend du trajet. Deux kilomètres à vol d'oiseau peuvent représenter un long trajet en voiture, et une plus grande distance à vol d'oiseau peut correspondre au trajet le plus court.
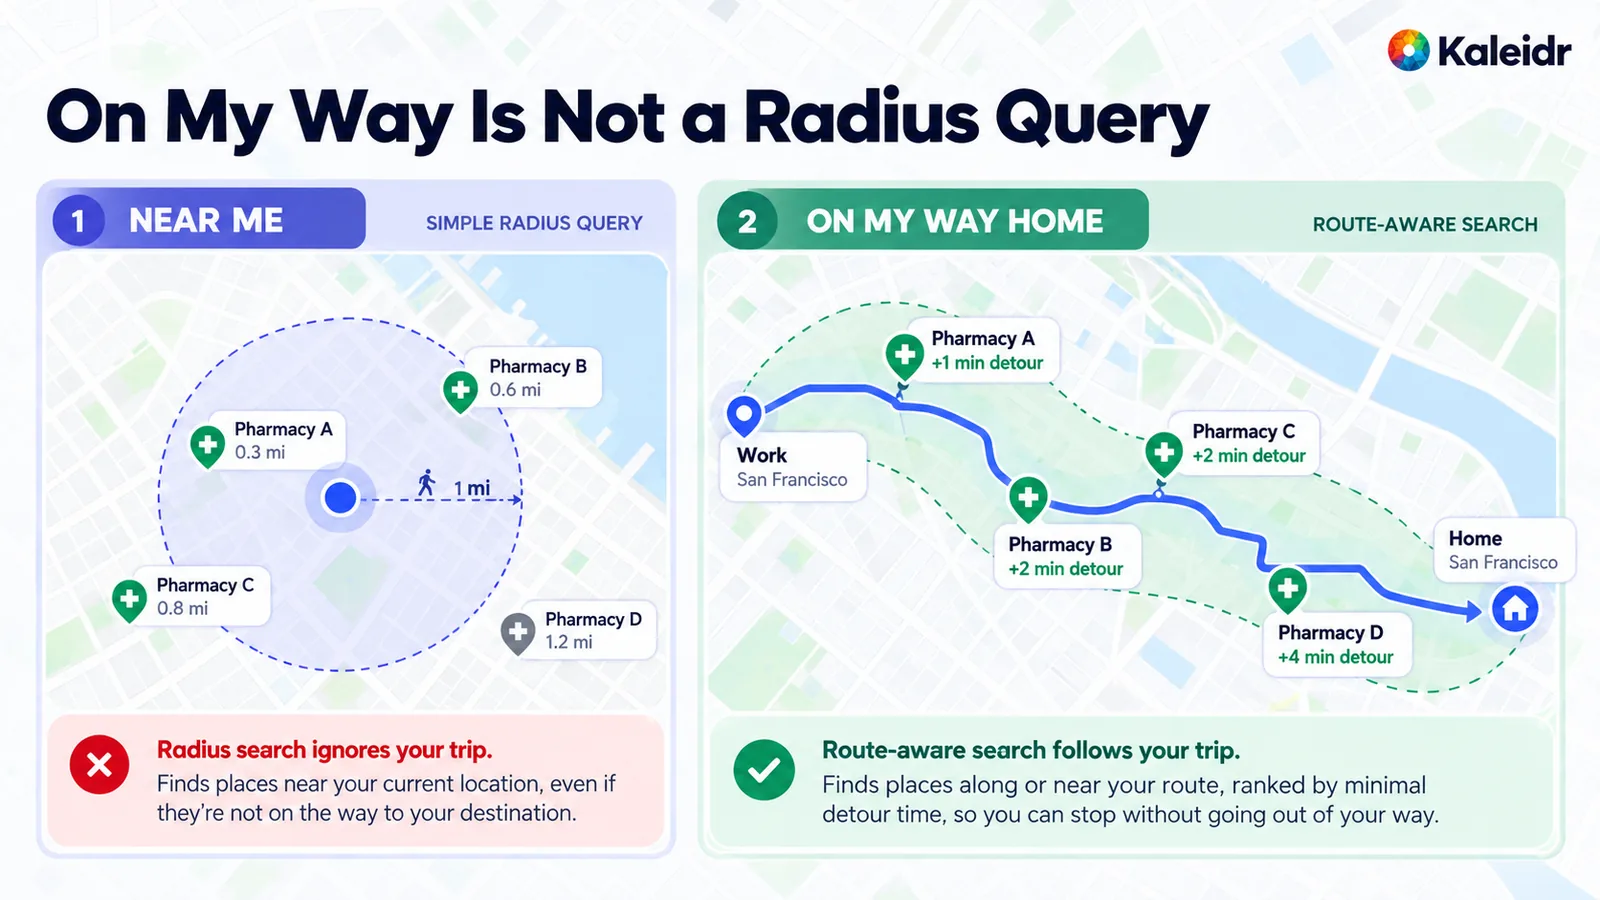
Le panneau gauche montre un rayon simple et des pharmacies d'exemple à l'intérieur et à l'extérieur d'un anneau d'un mile. Le panneau droit suit une route d'exemple du travail au domicile et étiquette les pharmacies avec des minutes de détour. Les valeurs en miles, les minutes de détour et les noms de lieux sont des exemples, pas une route en direct. Le point de la figure est la relation : un faible détour par rapport à la route n'est pas le même prédicat qu'un cercle autour de l'origine.
Le service de routing doit calculer le détour, et le moteur de classement doit recevoir ce résultat. Un modèle de langage qui estime les minutes contredira parfois la route que le service vient de renvoyer. L'appel de route intervient après la résolution et la sélection des candidats. Il ne s'agit pas d'une recherche de lieux, et l'absence de chemin doit rester un échec visible plutôt qu'une ligne devinée sur la carte.
Où Kaleidr s'insère-t-il dans ce pipeline ?
La Platform API publique de Kaleidr expose un endpoint de forward geocoding conçu pour un champ de recherche ou From/To, et non pour un index métier privé. GET /retrieval/geocode/forward accepte q comme nom de lieu, adresse postale avec numéro ou latitude et longitude saisies, ainsi que near_lat et near_lng facultatifs utilisés ensemble, limit et un mode de déplacement (Kaleidr, 2026). La même référence documente une route entre des coordonnées que l'appelant possède déjà, avec des profils voiture, marche, vélo et transport, et une route impossible à planifier revient avec un statut HTTP réussi et une erreur dans le corps plutôt qu'un trajet. Les résultats contiennent une attribution que l'appelant doit transmettre, et un résultat d'adresse postale peut inclure un identifiant stable à travers les mises à jour de données. Une liste results vide signifie qu'il n'y a rien à afficher, y compris en cas d'échec interne de recherche ; elle ne prouve donc pas que l'adresse est invalide.
Les paramètres documentés n'incluent pas le catalogue privé d'un client. Le géocodage public ne devient pas un système d'inventaire parce qu'il est monté sur la même carte. Un appelant qui a besoin de magasins privés ou d'inventaire doit lire directement ces systèmes, puis les relier à un lieu résolu au moyen d'un identifiant stable. La réponse de géocodage reste le sujet public, et l'enregistrement métier reste l'enregistrement métier.
Le détail de lieu dispose d'un successeur actuel, et l'ancien chemin ne doit pas servir de base à une nouvelle intégration. La référence des endpoints marque GET /retrieval/poi/enrich comme déprécié et oriente les nouveaux développements vers POST /spot, qui répond à ce qui se trouve en un point et peut ajouter du contenu descriptif et des photos. La route dépréciée peut être supprimée après le 2027-01-15.
L'enrichissement ne décide toujours pas de l'éligibilité privée. Les horaires, photos et une catégorie provenant d'une source publique sont des faits publics, avec l'attribution exigée par cette source. Le stock, l'autorisation de compte et une zone de service dessinée par le client restent dans les systèmes qui les possèdent. Spatial AI ancrée dans les données métier est le guide pour cette frontière.
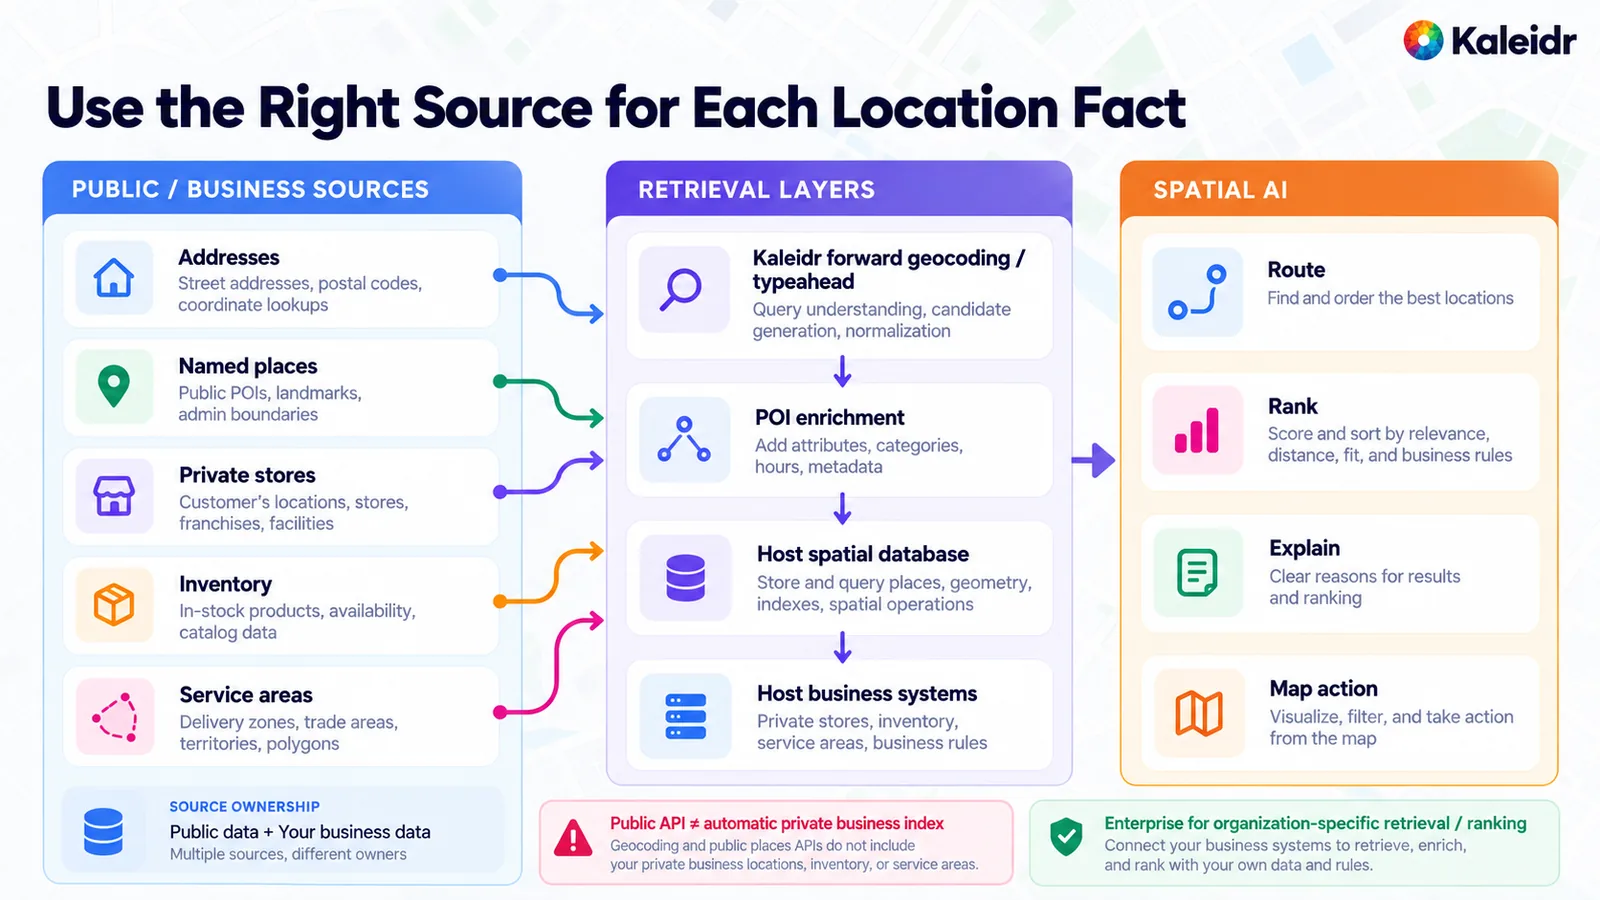
La colonne de gauche sépare les adresses et les lieux nommés des magasins privés, de l'inventaire et des zones de service. La colonne centrale nomme le forward geocoding de Kaleidr, une étape de détail de lieu, ainsi que la propre base de données spatiale et les systèmes métier de l'hôte. La boîte de détail de lieu correspond au rôle désormais documenté sous POST /spot. L'ancien endpoint enrich est le prédécesseur déprécié, pas l'intégration avec laquelle commencer. La colonne de droite montre ce qui arrive après la récupération : une route entre coordonnées connues, un classement des lieux éligibles, une explication et une action cartographique. L'avertissement de la figure correspond à la référence des endpoints. Une API publique de géocodage ou de lieux n'indexe pas les emplacements privés, l'inventaire ni les zones de service de l'appelant.
Les données propres à l'organisation suivent la frontière du plan, pas la carte. La documentation du compte Kaleidr indique que le téléchargement des propres données métier d'une organisation pour les réponses IA est réservé à Enterprise et que le scope de clé permettant aux réponses d'utiliser ces données téléchargées est également réservé à Enterprise (Kaleidr, 2026). La référence publique actuelle des endpoints ne documente pas d'endpoint générique de recherche vectorielle. Une équipe qui a besoin d'une récupération sémantique sur ses propres descriptions doit considérer cet index comme une partie du design de l'hôte ou d'Enterprise et confirmer le contrat actuel plutôt que d'appeler un chemin que cet article ne cite pas. Comment construire un assistant IA sensible à la carte couvre les actions cartographiques qui suivent un identifiant de lieu validé.
Que doit mesurer une équipe séparément ?
Chaque couche échoue à sa manière, et un score de pertinence unique masquera la couche défaillante. Le géocodage échoue sur une adresse ambiguë, une unité manquante, une coordonnée inversée ou une correspondance limitée au niveau de la rue. La recherche de lieux échoue lorsque la couverture, la catégorie ou la fraîcheur du fournisseur ne correspondent pas au produit. Une requête spatiale échoue sur une géométrie invalide, une référence de coordonnées incompatible ou un polygone qui ne correspond plus à l'opération.
La recherche vectorielle échoue sur un embedding faible, un texte périmé ou un index approximatif qui renvoie trop peu après un filtre. Les données métier échouent lorsque l'inventaire est inconnu, l'enregistrement non autorisé ou les horaires périmés. Un journal utile nomme la couche. « Search failed » ne le fait pas.
Évaluez la couche selon son rôle, puis la décision. Le géocodage demande une qualité de correspondance et des identifiants stables. La recherche de lieux demande le rappel des candidats, la précision de catégorie et un taux de lieux périmés. Les requêtes spatiales demandent une exactitude géométrique et une preuve que la requête a utilisé l'index. La recherche vectorielle demande une pertinence sémantique et un rappel filtré comparé à une référence de recherche exacte. Le contrôle de bout en bout demande si un lieu éligible a été récupéré, si l'absence de résultat était honnête et si l'action a utilisé l'identifiant approuvé par les filtres. Un échec d'autorisation ou de contenance ne doit pas disparaître dans un taux de clic moyen.
Par où le stack doit-il commencer ?
Choisissez la méthode capable de prouver la clause demandée par l'utilisateur. Le géocodage prouve où se trouve un sujet. La recherche de lieux prouve quels lieux connus correspondent à un texte, une catégorie ou une zone dans cet index. Une requête spatiale prouve une relation géométrique sur les enregistrements détenus par l'application. La recherche vectorielle prouve une similarité de sens, et seulement dans l'ensemble conservé par les filtres stricts. Les systèmes métier prouvent le fait actuel. Un service de routing prouve le trajet. Un moteur de classement ordonne ce qui reste. Le modèle de langage explique ce résultat et ne doit pas être la source de la distance, du test de contenance ou du niveau de stock.
Les données publiques de lieux sont la bonne source lorsque le travail consiste en une découverte publique. Les magasins privés, l'inventaire et l'éligibilité restent dans les systèmes qui les possèdent, avec des identifiants stables reliant le lieu du fournisseur, l'emplacement d'inventaire et le marqueur cartographique. La similarité sémantique n'efface pas une frontière géographique, et un rayon ne répond pas à une question « sur le chemin ». Explorez Kaleidr Enterprise lorsque la récupération doit s'exécuter sur des données propres à l'organisation, et consultez les endpoints Platform API pour les contrats de forward geocoding, spot et route cités plus haut.
Remarque : Kaleidr utilise des outils assistés par IA pour la création d'images, l'affinage de contenu et la recherche dans ses workflows créatifs et de développement.
FAQ
Quelle est la différence entre le géocodage et la recherche de lieux ?
Le géocodage résout une adresse, une coordonnée ou une référence de lieu connue en identité géographique. La recherche de lieux découvre des commerces, points de repère, gares et autres lieux nommés correspondant à un texte, une catégorie ou une zone proche. L'un renvoie un sujet. L'autre renvoie des candidats.
La recherche de points d'intérêt est-elle la même chose que le géocodage ?
Non. Certaines APIs de fournisseurs peuvent accepter à la fois une adresse et une requête de lieu. En revanche, la Geocoding v6 API de Mapbox ne fournit plus du tout de données de points d'intérêt. La recherche de points d'intérêt découvre des candidats. Le géocodage résout un emplacement.
Qu'est-ce qu'une requête spatiale ?
Une requête spatiale filtre des enregistrements géographiques selon une relation géométrique telle que dans une distance, dans un polygone, intersecte ou plus proche voisin. Les enregistrements et leur géométrie appartiennent déjà à l'application. Le prédicat est déterministe.
Qu'est-ce que la recherche vectorielle ?
La recherche vectorielle récupère les enregistrements dont les embeddings sont proches de l'embedding de la requête. La méthode est utile pour le sens et les formulations qui ne correspondent pas au texte source. Elle ne prouve ni distance, ni contenance, ni éligibilité.
La recherche vectorielle peut-elle remplacer une requête spatiale ?
Non. La similarité dans un espace d'embeddings ne prouve ni la distance géographique, ni la contenance, ni l'adéquation à une route, ni l'appartenance à une zone de service. Utilisez un prédicat spatial pour la vérité géographique et la recherche vectorielle pour la pertinence sémantique dans l'ensemble autorisé par ce prédicat.
La géographie doit-elle filtrer l'ensemble avant la recherche vectorielle ?
Oui lorsque la géographie est une limite stricte. Rechercher dans un index global d'embeddings puis vérifier l'emplacement sur une courte liste peut écarter des lieux locaux valides qui n'ont jamais intégré cette liste. La base de données et l'index déterminent l'implémentation. La frontière, elle, reste la même.
Une équipe doit-elle géocoder avant une recherche de proximité ?
Oui lorsque l'ancre est une adresse ou un autre emplacement non résolu. Résolvez l'ancre, puis exécutez une récupération de lieux ou une requête spatiale autour du point résolu. Une recherche par catégorie sans ancre est déjà une question de recherche de lieux.
Un produit doit-il utiliser une Places API ou sa propre base de données ?
Utilisez une Places API pour la découverte publique lorsque la couverture, la licence et l'attribution conviennent au produit. Utilisez la propre base de données du produit pour les magasins first-party, l'inventaire, les installations privées, l'éligibilité et l'état métier actuel. Un enregistrement public de lieu peut identifier un magasin. Il ne doit pas faire autorité sur ce que ce magasin détient aujourd'hui.
Qu'est-ce que la recherche de localisation hybride ?
La recherche de localisation hybride combine deux ou plusieurs de ces méthodes pour une décision. Une chaîne typique résout une ancre, récupère des lieux candidats, applique un prédicat spatial et une règle métier, puis classe toute préférence sémantique dans l'ensemble éligible. Le modèle de langage explique les survivants.
Kaleidr documente-t-il un endpoint public de recherche vectorielle ?
La référence des endpoints Platform API citée ici ne documente pas d'endpoint générique de recherche vectorielle. Les surfaces de récupération documentées utilisées dans cet article sont le forward geocoding, POST /spot pour ce qui se trouve à un point et l'appel de route entre des coordonnées déjà connues. Confirmez le contrat Enterprise actuel avant d'intégrer un index sémantique dans un plan produit.
References
- Google Maps Platform. Geocoding API overview. The service accepts an address, coordinates, or a Place ID, and converts an address into coordinates and a Place ID, or coordinates or a Place ID into an address. Accessed October 27, 2026. https://developers.google.com/maps/documentation/geocoding/overview
- Google Maps Platform. Geocoding API v4 overview. Documents forward geocoding, reverse geocoding, place geocoding, and destination search, and separates generally available, preview, and experimental channels. Accessed October 27, 2026. https://developers.google.com/maps/documentation/geocoding/geocoding-v4-overview
- Mapbox. Geocoding API. Forward and reverse geocoding. The Geocoding v6 API no longer provides point-of-interest data and directs that job to the Search Box API. Accessed October 27, 2026. https://docs.mapbox.com/api/search/geocoding/
- Mapbox. Search Box API. Interactive and stand-alone search for addresses, places, and points of interest, including category search. Accessed October 27, 2026. https://docs.mapbox.com/api/search/search-box/
- Google Maps Platform. Text Search (New). Returns places for a text string. Documented examples include "shoe stores near Ottawa" and "123 Main Street." Accessed October 27, 2026. https://developers.google.com/maps/documentation/places/web-service/text-search
- Google Maps Platform. Nearby Search (New). Takes one or more place types and returns matching places within a specified area. Accessed October 27, 2026. https://developers.google.com/maps/documentation/places/web-service/nearby-search
- PostGIS. ST_DWithin. Tests whether two geometries are within a given distance. The call includes a bounding-box comparison that uses available spatial indexes. Geography distance is in meters. Accessed October 27, 2026. https://postgis.net/docs/ST_DWithin.html
- PostGIS. ST_Within. Tests whether every point of one geometry lies in another and the interiors share a point. The function uses available spatial indexes. Accessed October 27, 2026. https://postgis.net/docs/ST_Within.html
- pgvector. pgvector. Exact and approximate nearest-neighbor search in Postgres, including HNSW and IVFFlat indexes, cosine and other distances, and iterative scans when a filter leaves too few approximate results. Accessed October 27, 2026. https://github.com/pgvector/pgvector
- Kaleidr Developer Docs. Platform API endpoints. Documents forward geocoding for a search box or From/To field,
POST /spotas the successor to the deprecated POI enrich endpoint, and a route call between known coordinates. Accessed October 27, 2026. https://docs.kaleidr.com/platform-api/endpoints - Kaleidr. Place Ranking API for Customer Intent. Hard filters such as authorization, availability, required capability, and service area run before scoring. Accessed October 27, 2026. https://kaleidr.com/blog/place-ranking-api
- Kaleidr Developer Docs. How Kaleidr works. Uploading an organization's own business data for AI answers is Enterprise only, as is the key scope that lets answers draw on that data. Accessed October 27, 2026. https://docs.kaleidr.com/concepts/how-kaleidr-works
- Kaleidr. Plot Places on a Map. A related guide for turning resolved places into markers. Accessed October 27, 2026. https://kaleidr.com/blog/plot-places-on-a-map
- Kaleidr. How to Build a Nearby Places Map for Near Me Search. A related guide for nearby discovery. Accessed October 27, 2026. https://kaleidr.com/blog/how-to-build-a-nearby-places-map-for-near-me-search
- Kaleidr. Spatial Context Engineering for Map-Aware AI. A related guide for what reaches the model after retrieval. Accessed October 27, 2026. https://kaleidr.com/blog/spatial-context-engineering
- Kaleidr. Grounded Spatial AI for Business Data. A related guide for keeping business facts in the systems that own them. Accessed October 27, 2026. https://kaleidr.com/blog/grounded-spatial-ai-business-data
- Kaleidr. Map-Aware AI Assistant: How to Build One. A related guide for map actions around a validated place. Accessed October 27, 2026. https://kaleidr.com/blog/how-to-build-a-map-aware-ai-assistant
References in BibTeX
@misc{google_geocoding_overview_2026,
  title  = {Geocoding API overview},
  author = {{Google Maps Platform}},
  year   = {2026},
  url    = {https://developers.google.com/maps/documentation/geocoding/overview}
}

@misc{google_geocoding_v4_overview_2026,
  title  = {Geocoding API v4 overview},
  author = {{Google Maps Platform}},
  year   = {2026},
  url    = {https://developers.google.com/maps/documentation/geocoding/geocoding-v4-overview}
}

@misc{mapbox_geocoding_api_2026,
  title  = {Geocoding API},
  author = {{Mapbox}},
  year   = {2026},
  url    = {https://docs.mapbox.com/api/search/geocoding/}
}

@misc{mapbox_search_box_api_2026,
  title  = {Search Box API},
  author = {{Mapbox}},
  year   = {2026},
  url    = {https://docs.mapbox.com/api/search/search-box/}
}

@misc{google_places_text_search_2026,
  title  = {Text Search (New)},
  author = {{Google Maps Platform}},
  year   = {2026},
  url    = {https://developers.google.com/maps/documentation/places/web-service/text-search}
}

@misc{google_places_nearby_search_2026,
  title  = {Nearby Search (New)},
  author = {{Google Maps Platform}},
  year   = {2026},
  url    = {https://developers.google.com/maps/documentation/places/web-service/nearby-search}
}

@misc{postgis_st_dwithin_2026,
  title  = {ST_DWithin},
  author = {{PostGIS}},
  year   = {2026},
  url    = {https://postgis.net/docs/ST_DWithin.html}
}

@misc{postgis_st_within_2026,
  title  = {ST_Within},
  author = {{PostGIS}},
  year   = {2026},
  url    = {https://postgis.net/docs/ST_Within.html}
}

@misc{pgvector_2026,
  title  = {pgvector},
  author = {{pgvector}},
  year   = {2026},
  url    = {https://github.com/pgvector/pgvector}
}

@misc{kaleidr_platform_api_endpoints_2026,
  title  = {Platform API endpoints},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://docs.kaleidr.com/platform-api/endpoints}
}

@misc{kaleidr_place_ranking_api_2026,
  title  = {Place Ranking API for Customer Intent},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://kaleidr.com/blog/place-ranking-api}
}

@misc{kaleidr_how_kaleidr_works_2026,
  title  = {How Kaleidr works},
  author = {{Kaleidr}},
  year   = {2026},
  url    = {https://docs.kaleidr.com/concepts/how-kaleidr-works}
}